この記事の結論
vLLMは、OpenAI SDKのコードを接続先の変更だけで使える推論エンジンです。同時接続数の上限は、vllm bench serveで同時接続数を変えて測り、スループットの伸びが止まる点と遅延が急に伸びる点の手前に決めます。
vLLMとは?OpenAI互換APIで使えるLLM推論エンジン
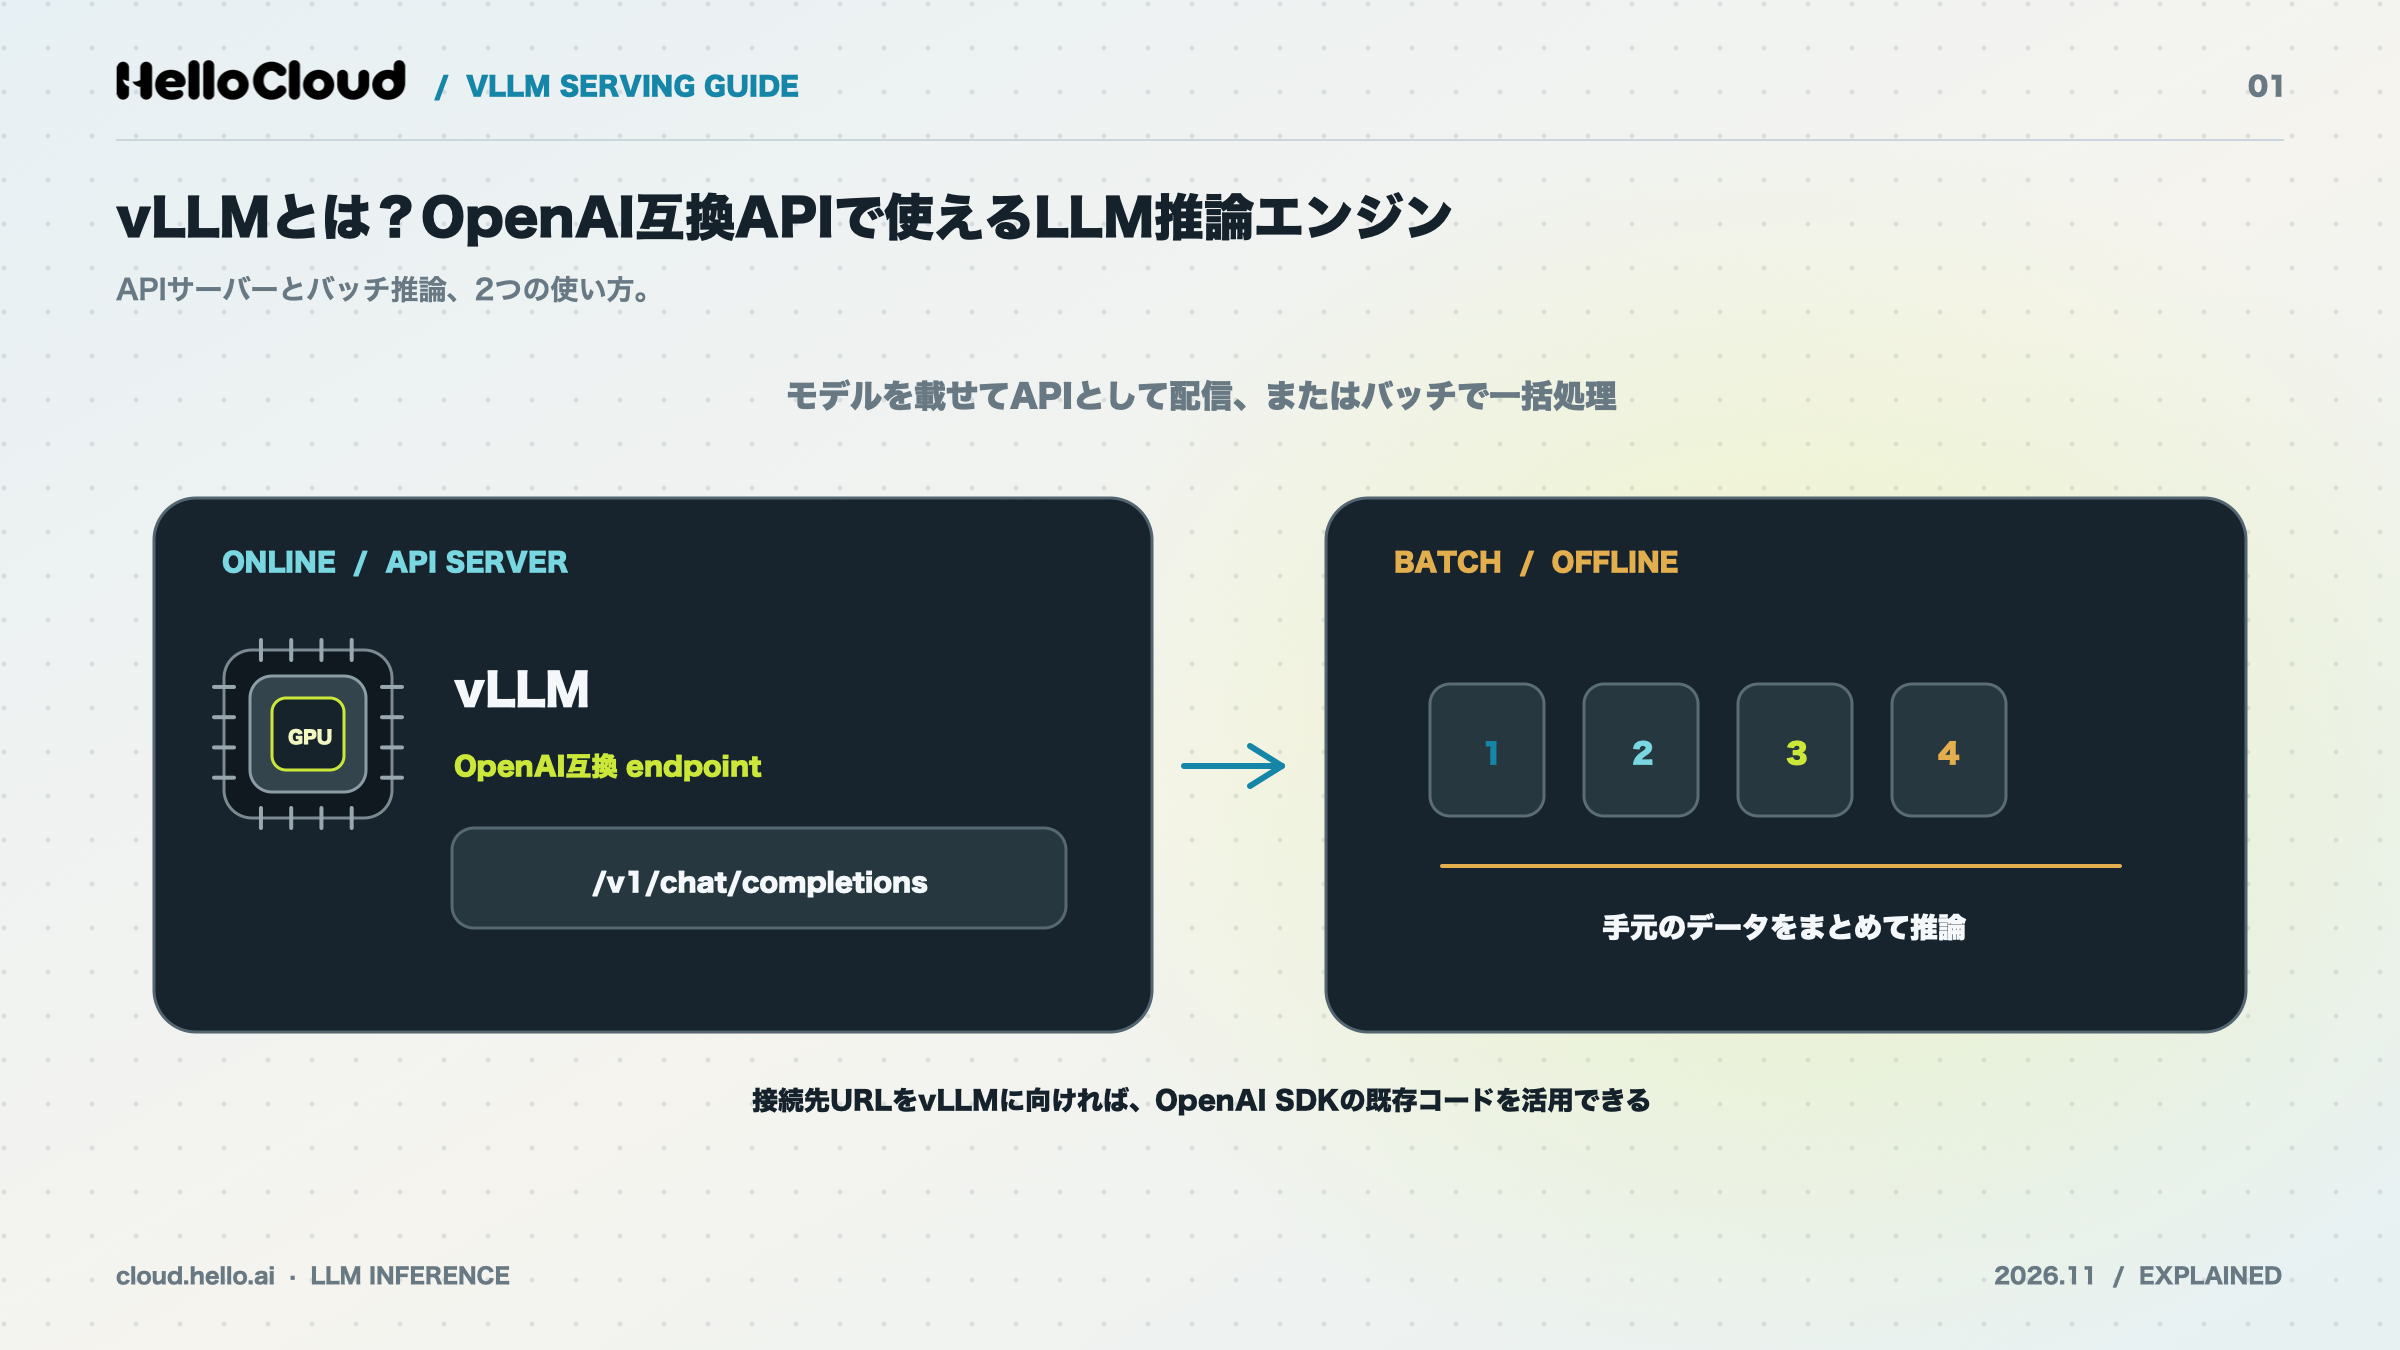
vLLMは、UC Berkeleyの研究者が2023年の論文で発表した方式をもとにした、LLMを配信するためのオープンソースの推論エンジンです。起動すると /v1/chat/completions などOpenAI互換のエンドポイントを持つAPIサーバーになり、既存のOpenAI SDKのコードは接続先のURLを変えるだけで動きます。
vLLMでできること:APIサーバーとバッチ推論
vLLMの使い方は、APIサーバーとして常時リクエストを受ける方法と、手元のデータをまとめて処理するバッチ推論の2つです。
APIサーバーとして使う場合は、vllm serve コマンドでモデルを読み込み、HTTPのエンドポイントを公開します。公式ドキュメントのOnline Servingのページには、/v1/chat/completions、/v1/completions、/v1/embeddings のほか、Anthropic形式の /v1/messages も載っています。社内チャットやRAG(社内文書を検索して回答する仕組み)のように、リクエストが絶えず届く用途に向く方法です。
要約や分類をまとめて流すバッチ推論では、APIサーバーを立てずに、Pythonのコードの中でvLLMの LLM クラスから推論できます(vLLM公式ドキュメント Offline Inference(v0.32.0))。
vLLMは誰が開発・運営しているか
vLLMの土台は、Kwonほかの論文「Efficient Memory Management for Large Language Model Serving with PagedAttention」(SOSP 2023、arXiv:2309.06180)です。著者はUC Berkeleyを中心とする研究者で、ソースコードは論文の発表時から公開されています。
2025年5月には、PyTorch FoundationがvLLMを同財団のホストするプロジェクトとして迎えたと発表しました(PyTorch Foundation、2025年5月)。発表によると、vLLMはUC Berkeleyから寄贈され、財団の中立で透明なガバナンスのもとで運営されます。特定の1社が方針を決めるOSSではない点は、本番で長く使うかを判断する材料の1つです。NVIDIAも、最適化済みのvLLMコンテナを毎月リリースしています(NVIDIA vLLM Release Notes、2026年10月30日更新)。
vLLMとOllamaの違い:同時接続の多さで選ぶ
vLLMとOllamaを選ぶときの分かれ目は、同時に届くリクエストの多さです。Ollamaの公式FAQでは、1つのモデルが同時に処理するリクエスト数の上限 OLLAMA_NUM_PARALLEL の既定値は1です。同じFAQには、並列数を増やすと、並列数×コンテキスト長に比例して必要なメモリが増えるとも書かれています。
次の表の「主な用途」と「向く場面」は、各公式ドキュメントの既定値をもとにした本記事での整理です。
観点 | vLLM | Ollama |
|---|---|---|
主な用途 | 多くの利用者に向けた推論APIの配信、バッチ推論 | 手元のPC・サーバーでのモデルの実行、開発・検証 |
同時処理の設定 | 起動時の引数で同時に処理するリクエスト数の上限などを調整 |
|
OpenAI互換API | あり( | あり( |
向く場面 | 同時接続が多い本番の推論API | 1人〜少人数での利用、モデルの試用 |
出典:vLLM公式ドキュメント Online Serving(v0.32.0)、Ollama FAQ、Ollama OpenAI compatibility(2026年11月9日確認)
どちらもOpenAI互換APIを持つため、Ollamaで試したアプリをvLLMに移す作業は、主に接続先のURLとモデル名の変更です。CPUや小さなGPUでの実行を重視するなら、llama.cppという選択肢もあります。
ポイント:
少人数での試用はOllama、同時接続の多い本番の推論APIはvLLM、と分けて選びます。
vLLMとllama.cpp・SGLang・TGIの違い
Ollama以外にも、LLMを動かす推論エンジンはいくつかあります。次の表は、本記事での使い分けの整理です。
エンジン | 向いている場面 |
|---|---|
vLLM | 同時接続の多い本番の推論API |
llama.cpp | CPUや小さなGPUでの実行 |
SGLang | LLMを配信する推論サーバー。新しく導入するときに、vLLMと比べる候補 |
TGI | 新しく導入する用途には向かない(メンテナンスモード) |
Hugging FaceのTGI(Text Generation Inference)は、公式ドキュメントでメンテナンスモードに入ったと案内されています。今後は小さなバグ修正やドキュメントの改善などの変更だけを受け付けます(TGI公式ドキュメント、2026年11月20日確認)。新しく推論サーバーを立てるなら、vLLMかSGLangを候補にします。
vLLMが同時接続でもスループットを出せる理由
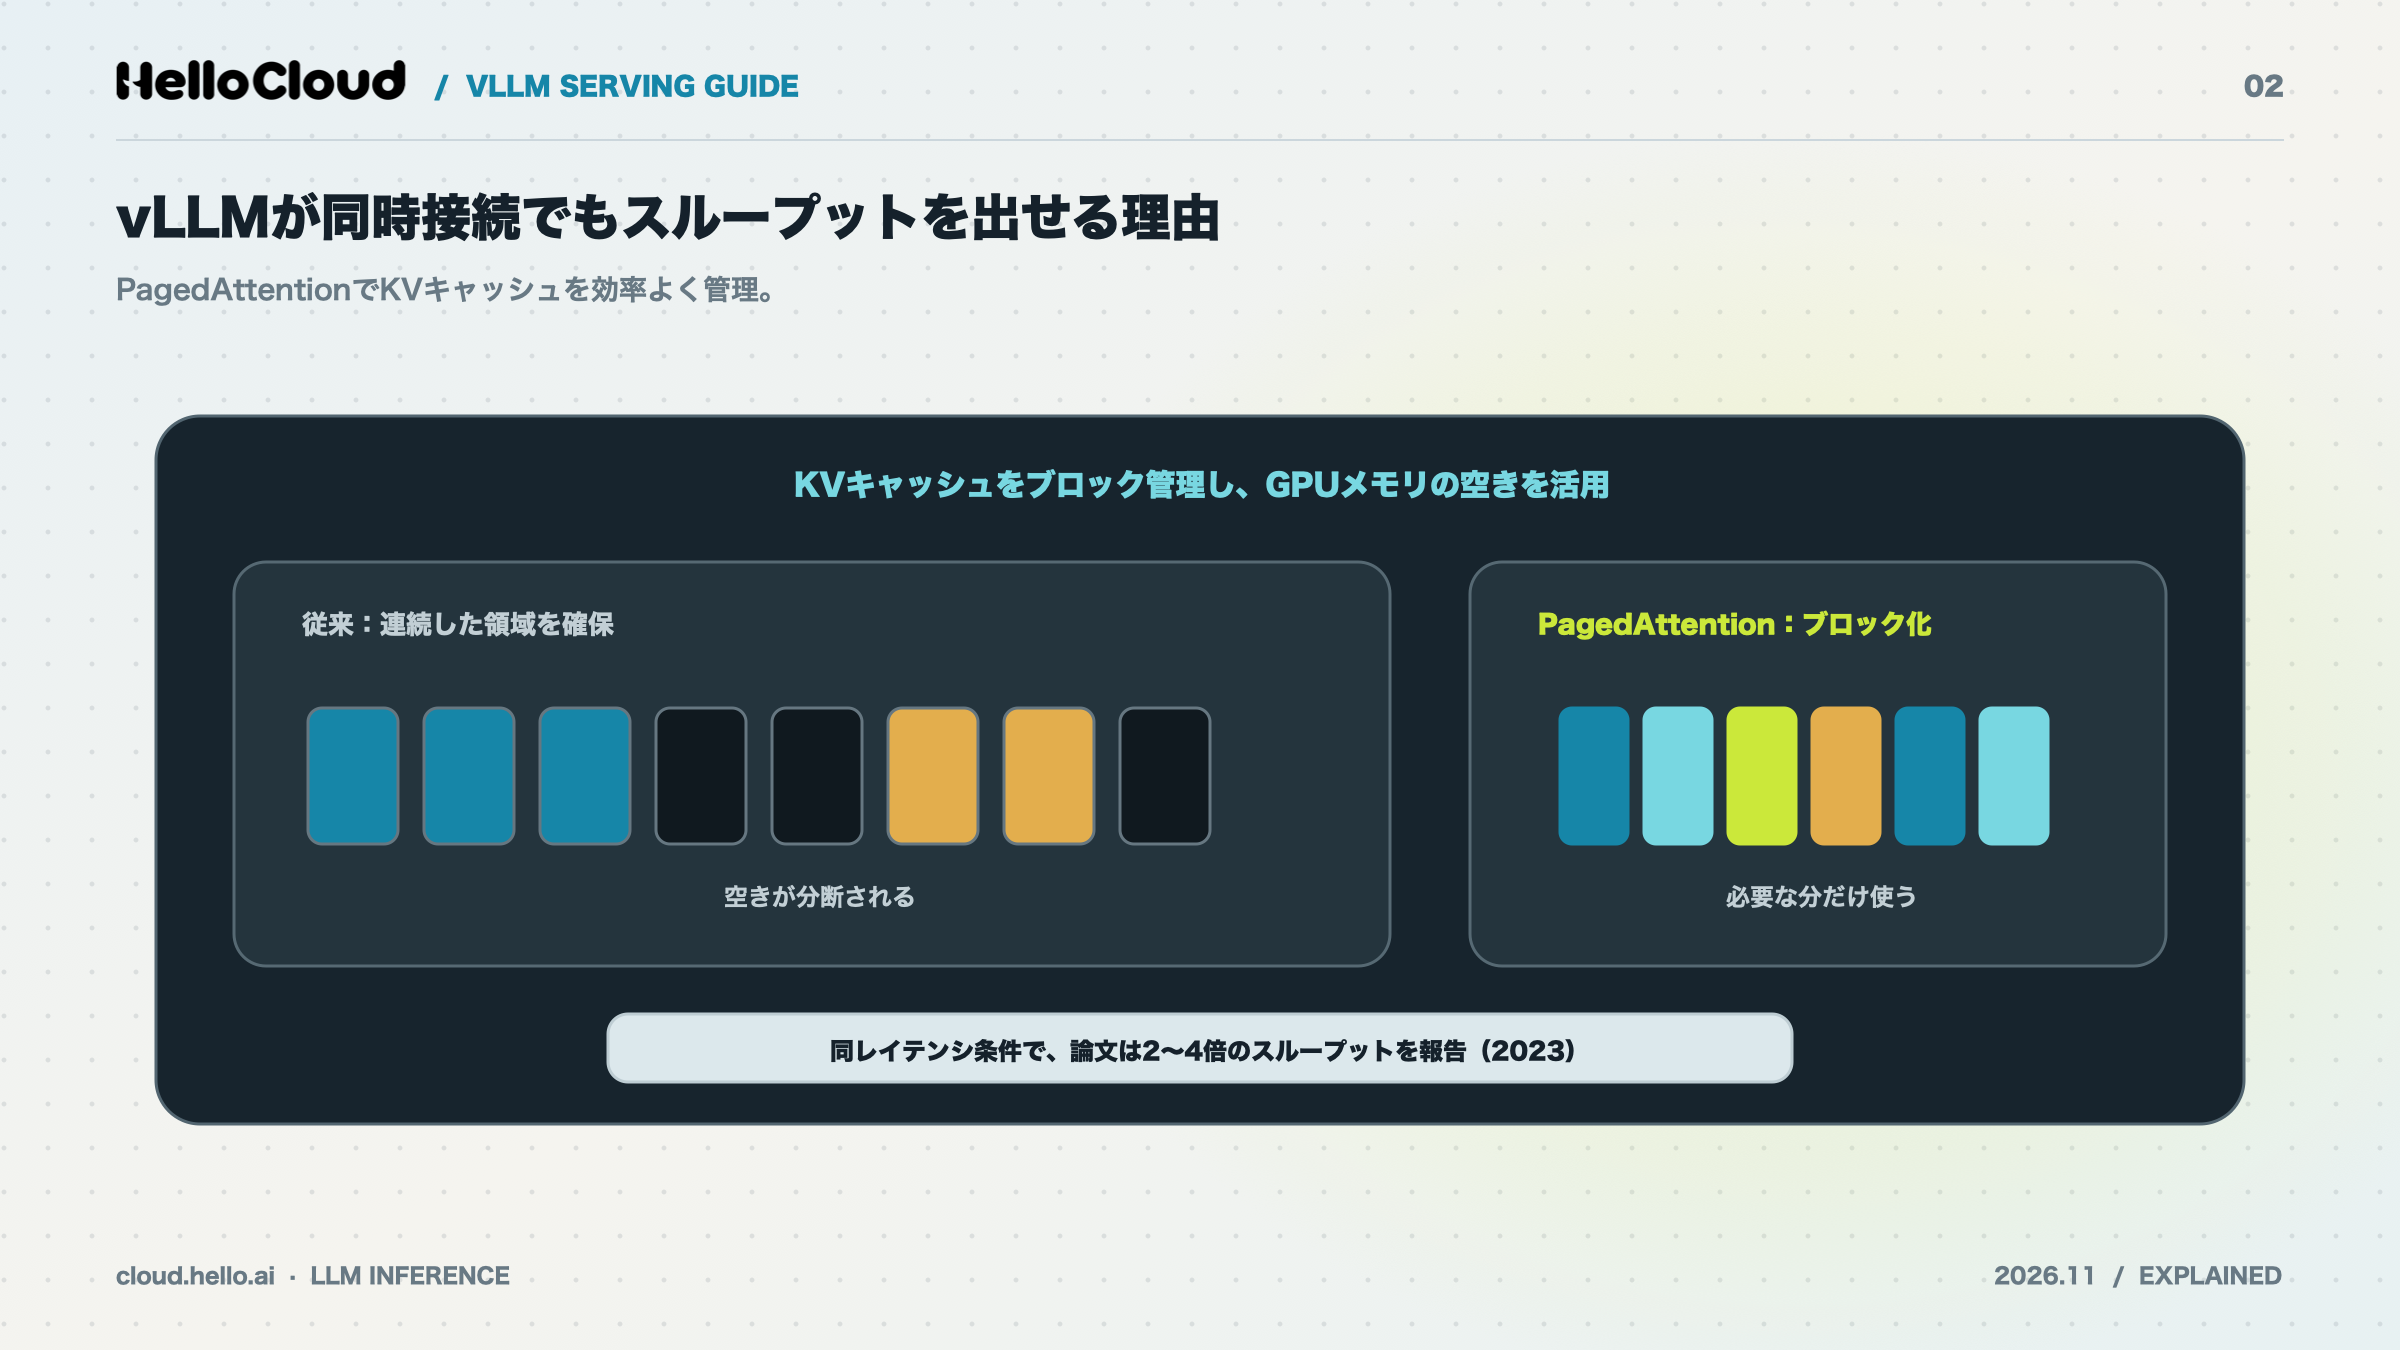
vLLMの論文では、同じレイテンシの条件で、既存の推論システム(FasterTransformer・Orca)よりスループットを2〜4倍に上げたと報告されています(2023年の論文発表時点)。理由は、同時接続数を縛っているGPUメモリの使い方を変えたことにあります。
KVキャッシュの大きさが同時接続数の上限を決める
LLMの同時接続数は、GPUメモリのうちモデルの重みを置いた残りに、KVキャッシュをどれだけ置けるかで決まります。KVキャッシュとは、生成中のリクエストごとに、それまでのトークンの計算結果を保存しておくメモリのことです。
PagedAttentionの論文には、40GBのNVIDIA A100で130億パラメータ(13B)のモデルを動かす例が載っています。論文の例では、GPUメモリの約65%をモデルの重みが占め、重みは推論中ずっと同じ場所に置かれたままです(同論文 HTML版、2023年9月)。残りのメモリにリクエストごとのKVキャッシュが置かれるため、論文はKVキャッシュの管理方法が最大のバッチサイズ(同時に処理できるリクエスト数)を決めると述べています。
KVキャッシュは、入力と出力が長いほど、同時に処理するリクエストが多いほど大きくなります。そのため、同じGPUとモデルでも、短い質問に答えるチャットと長い文書の要約とでは、同時に捌ける数は同じではありません。KVキャッシュに必要なメモリ量は、LLMの必要VRAMを計算する式で見積もれます。
PagedAttention:KVキャッシュを分割して無駄を減らす
PagedAttentionは、KVキャッシュを小さなブロックに分け、メモリ上の離れた場所にも置けるようにする方式です。OSがメモリをページ単位で管理する仕組み(仮想メモリ)から着想を得ています。
従来の推論システムは、リクエストごとに最大の長さ分のメモリを連続した領域で先に確保していました。実際の出力が短ければ、確保した領域の多くは使われずに残ってしまいます。PagedAttentionは必要になった分だけブロックを割り当てるため、論文はKVキャッシュのメモリの無駄が「ほぼゼロ」になったと報告しています(Kwonほか、SOSP 2023)。
無駄が減った分だけ、同じGPUメモリに多くのリクエストのKVキャッシュを置けるようになります。同時に処理できるリクエストが増えることが、スループットが上がる直接の理由です。
連続バッチング:空いた枠に次のリクエストを入れる
連続バッチング(continuous batching)は、処理が終わったリクエストの枠に、待っている次のリクエストをすぐ入れる処理の方式です。
複数のリクエストをひとまとめにして処理する方式では、一番長いリクエストが終わるまで次のまとまりを始められません。出力の長さはリクエストごとに違うので、短いリクエストが先に終わっても、その枠は空いたままです。PagedAttentionの論文によると、vLLMはデコードの1ステップごとに、バッチに入れるリクエストを選び直します(Kwonほか、SOSP 2023)。そのためGPUの空き時間が減り、後から届いたリクエストの待ち時間も短くなります。
利用者からのリクエストが不規則に届く推論APIでは、1ステップごとの入れ替えの細かさが、スループットと待ち時間の両方に効きます。
スループットと遅延は両立しにくい:chunked prefill
同時接続数を増やすとスループットは上がる一方、1件ごとの応答の遅れも大きくなりやすいのが、LLMの推論の難しいところです。
LLMの推論は、入力をまとめて読み込むprefill(プリフィル)と、出力を1トークンずつ作るdecode(デコード)の2段階で進みます。prefillは計算が重い処理です。長い入力のprefillが割り込むと、生成中のほかのリクエストのdecodeが止まり、トークンが返ってくる間隔が乱れます。
長い入力のprefillが割り込む問題に対し、Agrawalほかの論文「Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve」(USENIX OSDI 2024、2024年7月)は、chunked prefillという方式を提案しました。chunked prefillは、prefillをほぼ同じ大きさの塊に分け、生成中のdecodeを止めずに新しいリクエストを加える方式です。論文では、パイプライン並列で動かしたFalcon-180Bで、エンドツーエンドの処理能力が最大5.6倍になったと報告されています。vLLMにも、prefillを分けて実行する設定が用意されています。
ポイント:
vLLMが同時接続に強いのは、PagedAttentionでKVキャッシュの無駄を減らし、連続バッチングでGPUの空き時間を減らしているためです。ただし同時接続を増やすほど1件ごとの遅れは大きくなりやすいので、どこで止めるかは測って決めてください。
vLLMの使い方:OpenAI互換APIサーバーを起動する
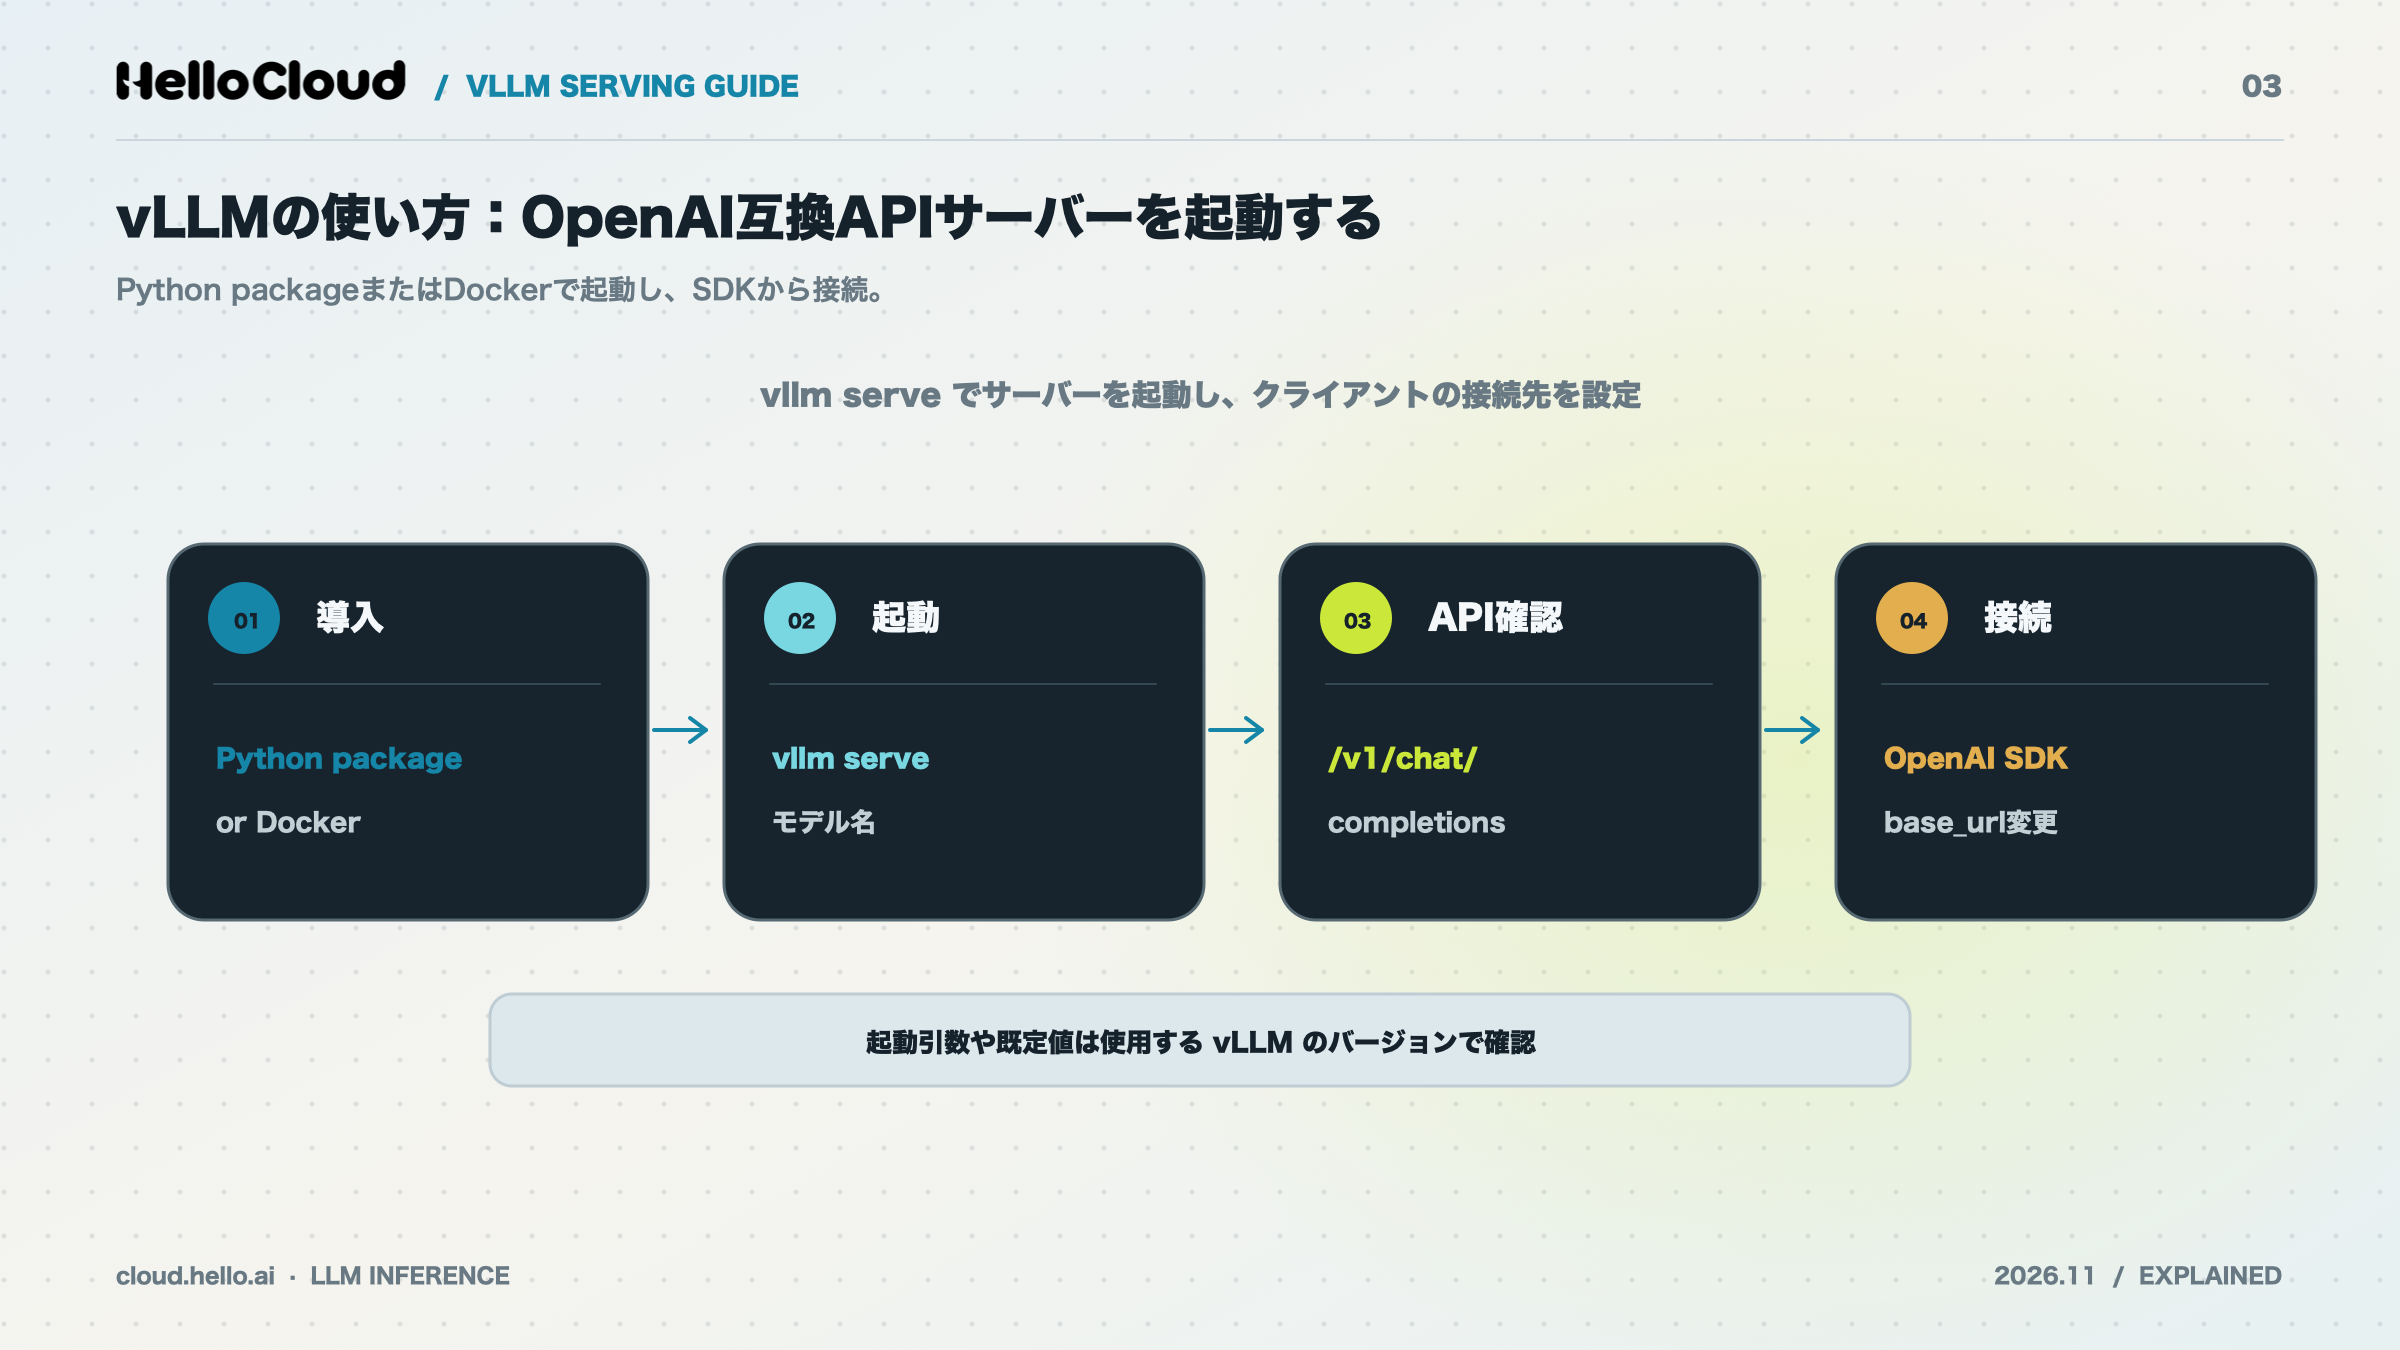
vLLMの基本の使い方は、vllm serve にモデル名を渡してAPIサーバーを起動し、OpenAI SDKの接続先をそのサーバーに向けることです。手順とエンドポイントは、vLLM v0.32.0の公式ドキュメントに合わせています。版が変わると引数や既定値が変わる場合があるため、使う版のドキュメントもあわせて確認してください。
動作環境とインストール:uv・pip・Docker
vLLMの導入方法は、GPUを使うサーバーにPythonのパッケージとして入れる方法と、Dockerコンテナで動かす方法の2つです。
公式ドキュメント(latest版、2026年11月20日確認)が示すNVIDIA GPU版の動作環境は、次のとおりです(vLLM公式ドキュメント「GPU」)。
OS:Linuxのみ。Windowsにはネイティブで対応していないため、WSLを使います
Python:3.11〜3.14
GPU:compute capability 7.5以上(T4、RTX 20xx、A100、L4、H100、B200など)
Mac:Apple Siliconでは、vLLM-Metalを使ってGPUで動かす方法もあります
Pythonのパッケージとして入れる方法は、検証環境で早く試したいときに向いています。公式に推奨されているのは、uvで新しい仮想環境を作って入れる手順です。
uv venv --python 3.12 --seed --managed-python
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm download-kernels
最後の vllm download-kernels は、事前にコンパイルされたカーネルを取得するコマンドです。実行しないと、起動時にカーネルのダウンロードとコンパイルが走り、数分かかることがあります。condaで入れたPyTorchの環境では問題が起きることがあるため、vLLM用に新しい仮想環境を作って入れます。仮想環境の作り方は、Minicondaのインストールと仮想環境の作り方で解説しています。
Dockerコンテナで動かす方法は、本番で版を固定しやすいのが利点です。NVIDIAのGPUを使う場合は、NVIDIAが毎月リリースしているvLLMコンテナも選べます。NVIDIAのリリースノートによると、NVIDIAのvLLMコンテナにはテスト・調整・最適化を済ませたライブラリが入っています(NVIDIA vLLM Release Notes)。コンテナからGPUを使うには、ホスト側でGPUドライバとコンテナ用のツールを先に整えておく必要があります。GPUクラウドでドライバやコンテナの環境を用意する流れは、GPUクラウドの環境構築の手順で解説しています。
vllm serve でAPIサーバーを起動する
vLLMのAPIサーバーを起動するコマンドは、vllm serve の後にHugging Faceのモデル名を書くだけです。公式ドキュメントの例で使われているモデルを指定すると、起動コマンドは次のようになります。
vllm serve NousResearch/Meta-Llama-3-8B-Instruct
起動から動作確認までは4段階です。
モデルを決める:使うモデルのパラメータ数と、想定する入出力の長さを決めます。GPUメモリに重みとKVキャッシュが収まるかを、この段階で見積もっておくと後の手順で迷いません。
サーバーを起動する:
vllm serve <モデル名>を実行します。初回はモデルのダウンロードの時間も必要です。起動を確かめる:
/healthと/v1/modelsにアクセスし、サーバーの応答とモデルの読み込みを確認します。リクエストを送る:次の項のコードで
/v1/chat/completionsを呼び、応答が返るかを確かめてください。
チャット形式で使うときに、チャット用のテンプレートのファイルを指定するには --chat-template を使います。
OpenAI SDK・curlから呼び出す
vLLMのAPIサーバーは、OpenAI SDKの base_url をvLLMのサーバーに向けるだけで呼び出せます。既存のアプリで変えるのは、接続先のURL、APIキー、モデル名の3か所です。
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="<サーバー起動時に設定したAPIキー>",
)

response = client.chat.completions.create(
    model="NousResearch/Meta-Llama-3-8B-Instruct",
    messages=[{"role": "user", "content": "vLLMの特徴を1文で説明してください。"}],
)
print(response.choices[0].message.content)
curlで確かめる場合のリクエスト例です。
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer <APIキー>" \
  -d '{
    "model": "NousResearch/Meta-Llama-3-8B-Instruct",
    "messages": [{"role": "user", "content": "こんにちは"}]
  }'
model には、サーバーが読み込んだモデル名を指定します。名前が違うとエラーが返るため、/v1/models で返る名前をそのまま使うと確実です。
使えるエンドポイント一覧(/v1・/health・/metrics)
vLLM v0.32.0のAPIサーバーには、推論用のOpenAI互換エンドポイントと、運用で使うヘルスチェック・監視用のエンドポイントがあります。
エンドポイント | 用途 |
|---|---|
| チャット形式の推論(OpenAI互換) |
| テキスト補完の推論(OpenAI互換) |
| Responses API形式の推論(OpenAI互換) |
| 埋め込みの生成(OpenAI互換) |
| Anthropic形式の推論 |
| 読み込まれているモデルの一覧 |
| サーバーが応答しているかの確認(ヘルスチェック) |
| Prometheus形式の監視用メトリクス |
| vLLMの版の確認 |
出典:vLLM公式ドキュメント Online Serving(v0.32.0)(2026年11月9日確認)
ポイント:
vLLMはvllm serve <モデル名>で起動し、OpenAI SDKのbase_urlを向けるだけで使えます。本番では、推論用の/v1に加えて、/healthと/metricsも監視の対象です。
Pythonから直接使う:オフラインのバッチ推論(LLMクラス)
APIサーバーを立てずに大量の文章をまとめて処理するときは、Pythonの LLM クラスを使います。次のコードは公式クイックスタートの例で、プロンプトのリストをまとめて渡し、生成結果を受け取ります(vLLM公式ドキュメント「Quickstart」、2026年11月20日確認)。
from vllm import LLM, SamplingParams

prompts = [
    "Hello, my name is",
    "The capital of France is",
]
sampling_params = SamplingParams(temperature=0.8, top_p=0.95)
llm = LLM(model="facebook/opt-125m")
outputs = llm.generate(prompts, sampling_params)

for output in outputs:
    print(output.prompt, output.outputs[0].text)
社内文書の一括要約や分類など、応答の速さより処理量を重視する場面に向いています。
vLLMの同時接続とスループットの測り方
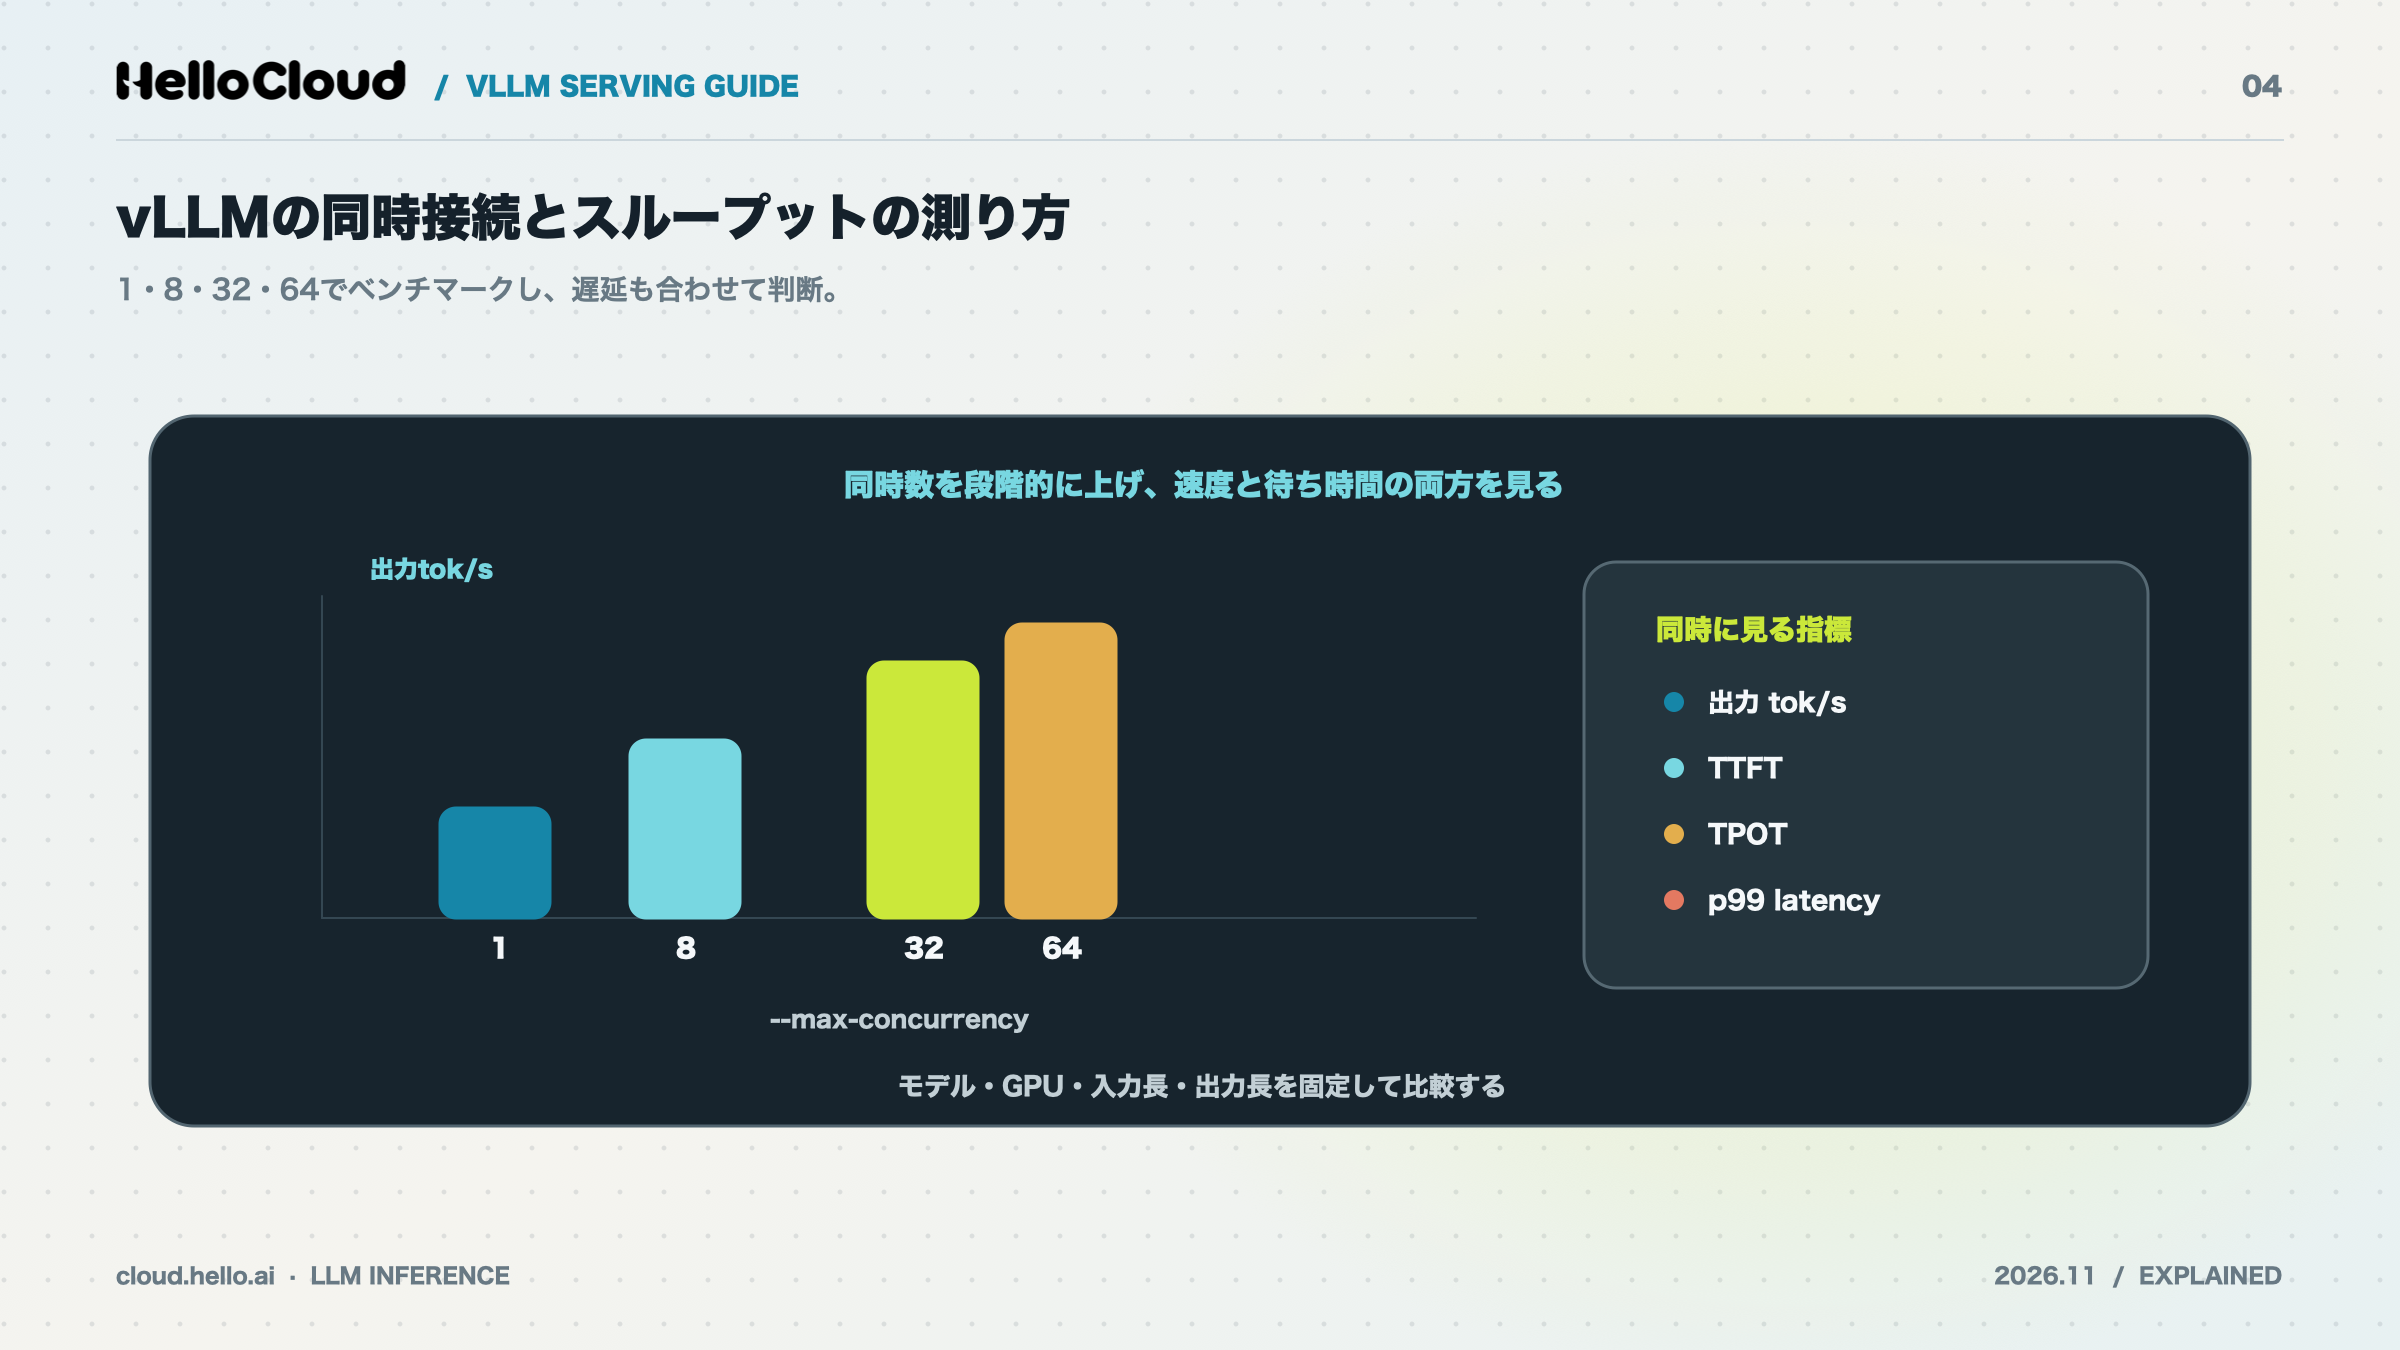
vLLMで本番に使える同時接続数は、公式のベンチマークツール vllm bench serve の --max-concurrency を1・8・32・64と段階的に変えて測ると分かります。同じvLLMでも、モデル、GPU、入出力の長さが変われば、捌ける同時接続数は大きく変わるからです。他の記事やベンダーの数値をそのまま当てはめず、自分の条件で測った数値で決めてください。
測る指標:出力tok/s・TTFT・TPOT・p99
同時接続数を決めるときは、処理量を表す出力tok/sと、利用者が感じる遅れを表すTTFT・TPOT・p99レイテンシを組み合わせて見ます。
指標 | 意味 | 見る目的 |
|---|---|---|
出力tok/s(スループット) | 1秒あたりに生成された出力トークンの数 | GPU1台がどれだけの量を処理できるか。コスト計算の元になる |
TTFT(Time To First Token) | リクエストを送ってから最初のトークンが返るまでの時間 | 利用者が「反応がない」と感じる時間 |
TPOT(Time Per Output Token) | 出力トークン1つあたりの生成時間 | 文字が流れてくる速さ |
p95・p99レイテンシ(e2el) | 遅い方から5%・1%のリクエストの、全体の遅延 | 平均では見えない、一部の利用者の待ち時間 |
出典:vLLM公式ドキュメント vllm bench serve(v0.32.0)(2026年11月9日確認)
vllm bench serve が既定で出すのは、TTFT・TPOT・ITL(トークン間の遅延)の99パーセンタイルです。p95や、リクエスト全体の遅延(e2el)も見たい場合は、--percentile-metrics と --metric-percentiles 95,99 を指定してください。
平均のレイテンシだけを見ていると、一部のリクエストが大きく遅れていても気づけません。チャットのように人が待つ用途ではTTFTとp99を、夜間のバッチ処理のように人が待たない用途では出力tok/sを優先して見ます。
--max-concurrency を1→64と段階的に変えて測る
vllm bench serve の --max-concurrency は、同時に送るリクエスト数の上限を決める引数です。--max-concurrency の値だけを変えながら同じ条件で負荷をかけると、同時接続数ごとの性能を比べられます。
APIサーバーを起動する:本番と同じモデル・同じ引数で
vllm serveを起動します。引数が本番と違うと、測った数値は使えません。入出力の長さを決める:本番のリクエストに近い入力と出力の長さを決めます。実際のログがあれば、その平均や分布に合わせてください。
同時接続数1で測る:
--max-concurrency 1で測り、負荷がないときの基準の値を記録します。8・32・64と増やして測る:同じ条件のまま、
--max-concurrencyだけを変えて測ってください。結果を保存する:
--save-resultを付けると、結果をJSONで保存できます。--result-filenameで同時接続数ごとにファイル名を分けて残してください。
vllm bench serve \
  --backend vllm \
  --model NousResearch/Meta-Llama-3-8B-Instruct \
  --dataset-name random \
  --random-input-len 512 \
  --random-output-len 256 \
  --num-prompts 200 \
  --max-concurrency 8 \
  --percentile-metrics ttft,tpot,itl,e2el \
  --metric-percentiles 95,99 \
  --save-result \
  --result-filename concurrency-8.json
--dataset-name には、random(指定した長さのランダムな入力)、sharegpt(公開されている会話データ)、custom(自分で用意したデータ)などを指定できます。実際のリクエストに近いデータを custom で渡すと、本番に近い結果が得られます。上の例の入出力の長さ(512と256)は説明用の値なので、自分の用途に合わせて変えてください。
1・8・32・64で傾向をつかんだら、変化が大きかった区間(例:32と64の間)を細かく刻んで測り直します。粗く測ってから細かく測るほうが、上限を短い時間で絞り込めて効率的です。
上限を上げたいときに見直す引数
同時接続数の上限を上げたいときや、GPUメモリが足りないときは、vllm serve の起動時の引数を見直します。
引数 | 役割 | 見直す場面 |
|---|---|---|
| 1回の処理で扱うシーケンス(リクエスト)の最大数 | 同時接続数を増やしたい、または絞りたいとき |
| 1回の処理で扱うトークンの最大数 | 長い入力が多く、遅延が大きいとき |
| GPUメモリのうちvLLMが使う割合(0〜1) | 同じGPUで別の処理も動かすとき、メモリが足りないとき |
| 入力と出力を合わせた最大の長さ | 用途より長い設定でKVキャッシュを圧迫しているとき |
| KVキャッシュを保存するデータ型( | KVキャッシュのメモリを減らしたいとき |
| prefillを分けて実行する設定 | 長い入力が割り込んで、生成中の応答が止まるとき |
出典:vLLM公式ドキュメント vllm serve(v0.32.0)(2026年11月9日確認)
公式ドキュメントのCLIのページでは、--max-num-seqs や --max-num-batched-tokens などの既定値はテスト用で、実際の値はエンジンの設定処理で決まると注記されています。実際に使われている値は、起動時のログで確認してください。。
ポイント:
同時接続数の上限は、--max-concurrencyを段階的に変えて測り、スループットの伸びが止まる点と遅延が急に伸びる点の手前に決めます。引数を変えたときも、同じ条件で測り直して比べます。
測定中のGPU使用率やメモリ使用量の見方は、GPU負荷の確認方法で解説しています。
vLLMを本番運用するときのチェックポイント
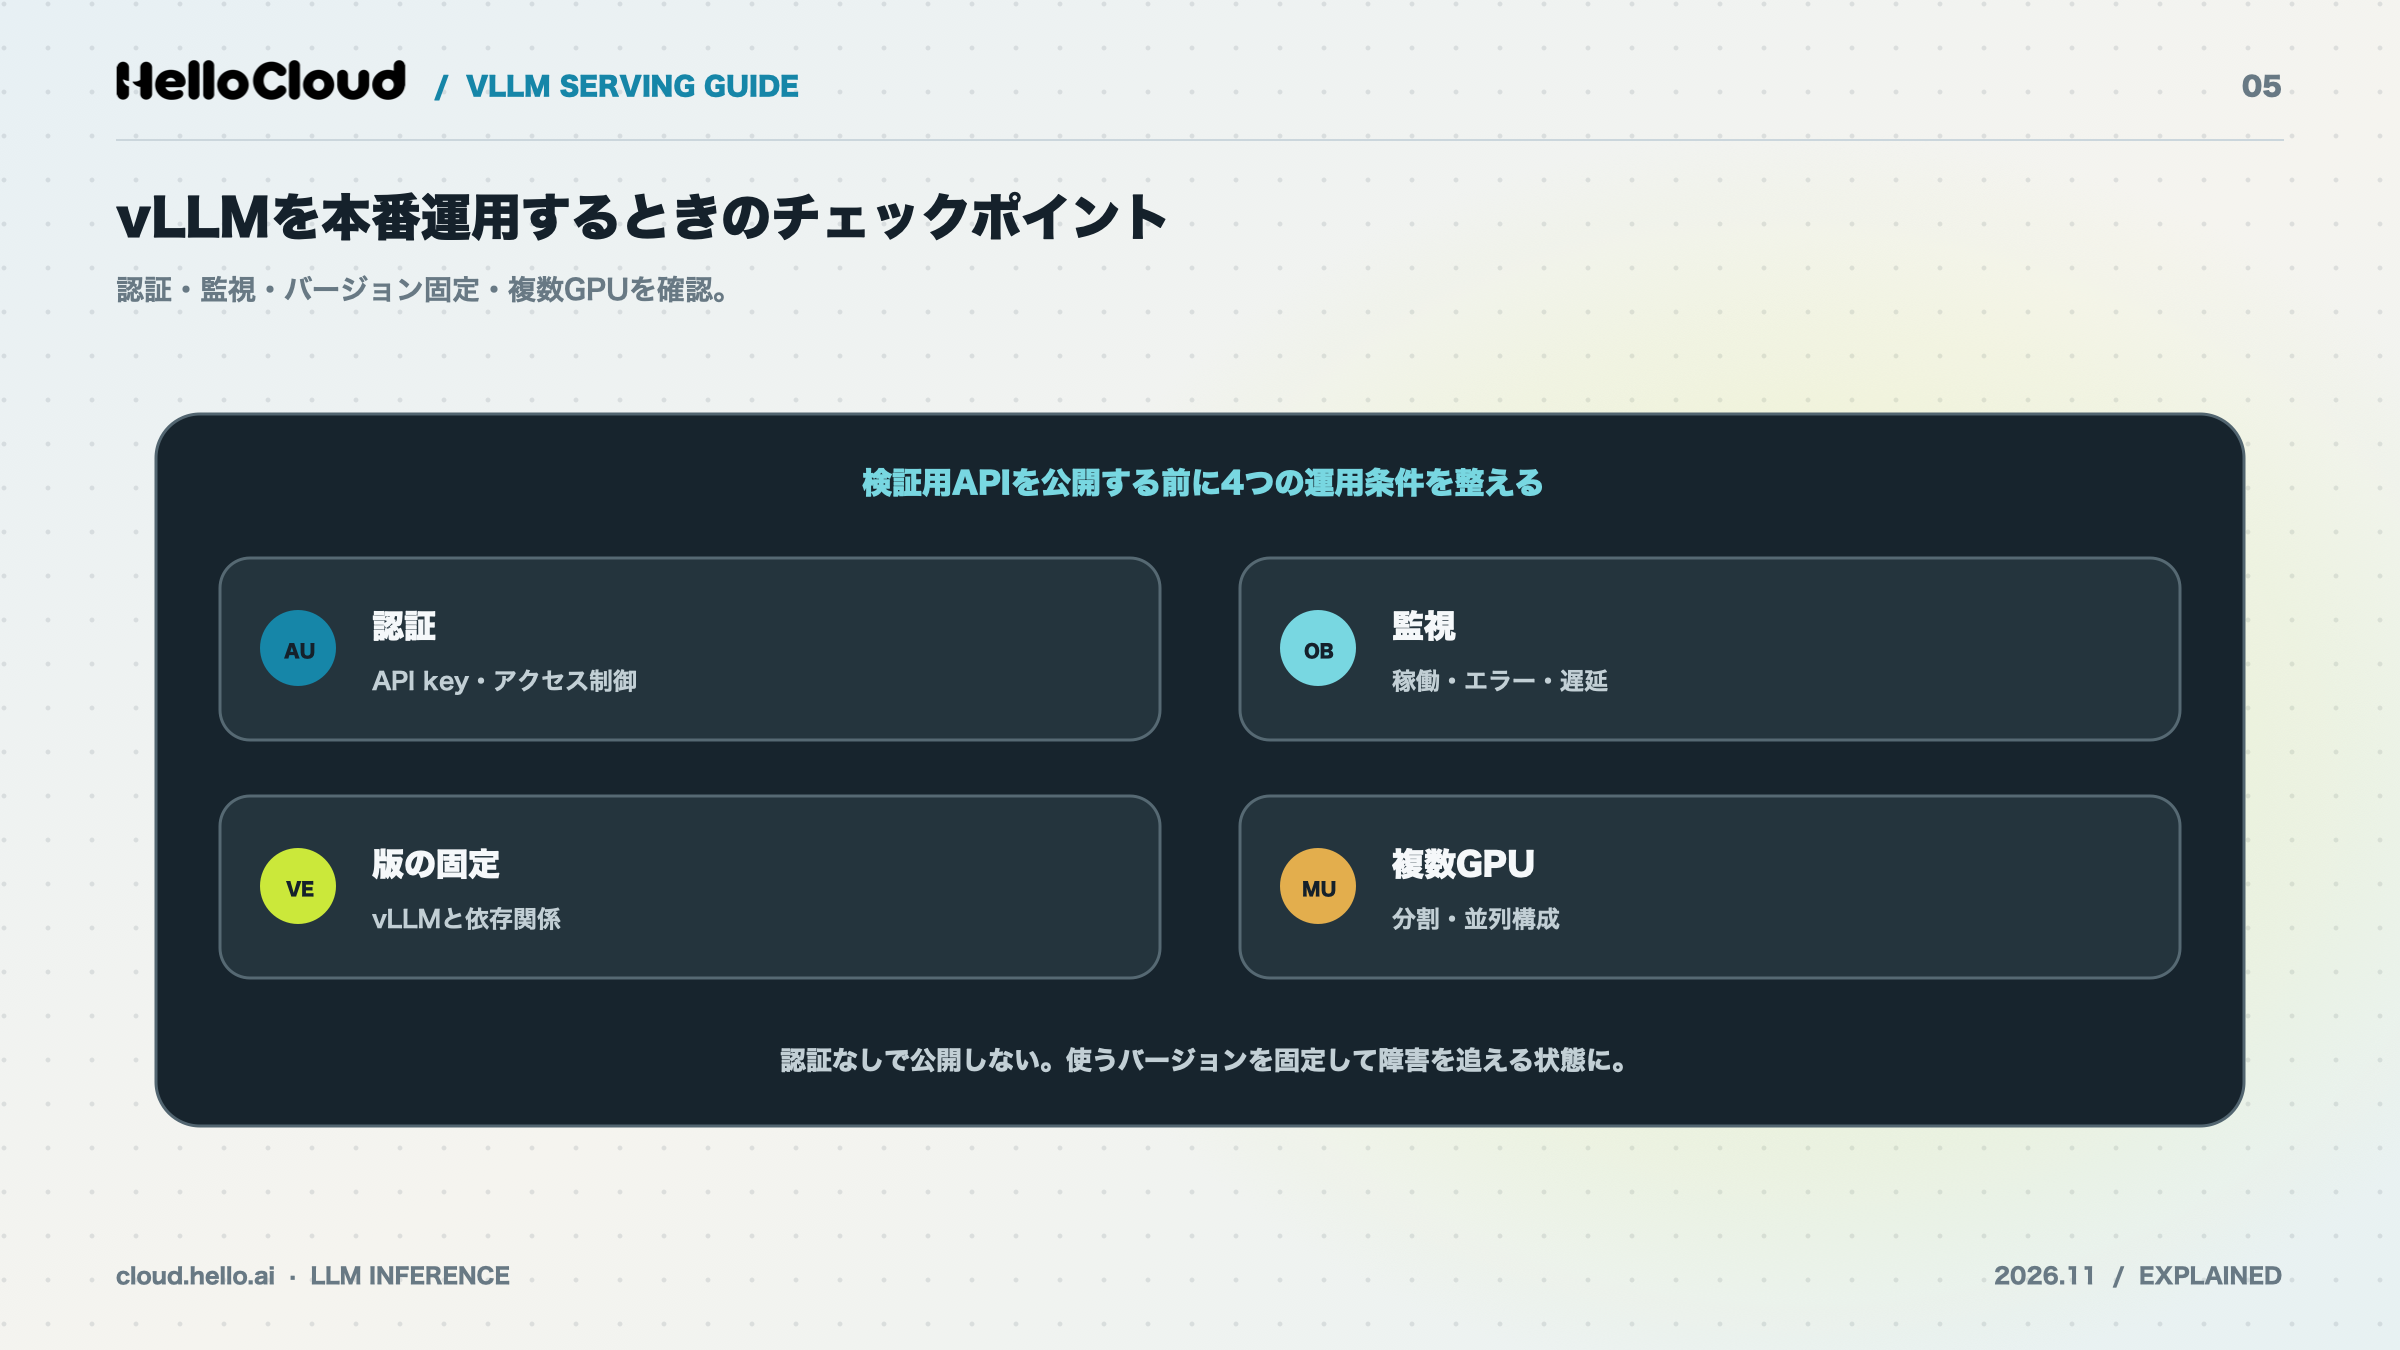
vLLMを本番に出す前に確認したいのは、認証、監視、版の固定、複数GPUの4つです。vLLMは起動するだけでAPIとして使えるので、検証のときの設定のまま公開すると、誰でも呼べるAPIになったり、障害に気づけなかったりしかねません。
項目 | 確認すること | 参照するドキュメント |
|---|---|---|
認証 |
| vllm serve、Security(v0.32.0) |
ヘルスチェック | ロードバランサーなどから | Online Serving(v0.32.0) |
監視 |
| Online Serving(v0.32.0) |
版の固定 | vLLMの版とコンテナのタグを固定しているか | リリースノート |
開発モード |
| Online Serving(v0.32.0) |
複数GPU | 1枚のGPUに収まらないモデルを、テンソル並列で動かしているか | vllm serve(v0.32.0) |
出典:vLLM公式ドキュメント Online Serving(v0.32.0)、vLLM公式ドキュメント vllm serve(v0.32.0)、vLLM公式ドキュメント Security(v0.32.0)(2026年11月9日確認)
APIキーで認証をかける(--api-key)
vLLMのAPIサーバーに認証をかけるには、起動時に --api-key でキーを指定します。v0.32.0の公式ドキュメントでは、--api-key を指定するとリクエストのヘッダーにキーが必要になると説明されています。
vllm serve NousResearch/Meta-Llama-3-8B-Instruct --api-key <APIキー>
クライアント側では、OpenAI SDKの api_key に同じキーを設定してください。キーはコードに直接書かず、環境変数や秘密情報の管理ツールから読み込むようにしてください。
注意:
認証をかけずにvLLMのAPIを外部から届く場所に置くと、第三者にGPUを使われ、その分の利用料がかかるおそれがあります。v0.32.0のSecurityのページによると、--api-keyが認証を求めるのは/v1・/v2・/inference・/cohereで始まるエンドポイントだけです。/health・/metrics・/invocationsなどは認証なしで届きます。同じページは--api-keyだけに頼らないよう求めており、リバースプロキシで公開するエンドポイントを絞る対策を勧めています(vLLM公式ドキュメント Security(v0.32.0))。
/health と /metrics で監視する
vLLMの監視は、/health でサーバーが動いているかを、/metrics で処理の詰まりと遅延を確かめる2段構えにします。/metrics の出力はPrometheus形式なので、Prometheusで集めてGrafanaなどで可視化できます。
メトリクス | 分かること | アラートの例 |
|---|---|---|
| 処理中のリクエスト数 | 同時接続数の上限に張り付いたまま下がらない |
| 待ち行列にあるリクエスト数 | 待ちが増え続けている |
| KVキャッシュの使用率(0〜1) | 使用率が1に近い状態が続く |
| TTFTの分布 | p99が決めた許容値を超えた |
| リクエスト全体の遅延の分布 | p99が決めた許容値を超えた |
出典:vLLM公式ドキュメント Production Metrics(v0.32.0)(2026年11月9日確認)
待ち行列が増え続け、KVキャッシュの使用率も高いままなら、同時接続数が上限を超えている状態です。
版を固定し、開発モードは本番で使わない
vLLMは更新の速いOSSなので、本番では版を固定し、更新するときは既定値の変更を確かめてから切り替えます。Dockerで動かす場合は、latest のような中身が変わるタグではなく、版を明記したタグを使ってください。
更新するときは、新しい版のリリースノートで既定値や挙動の変更を読み、検証環境で前の章と同じ条件のベンチマークを測り直します。数値が下がっていないことを確かめてから、本番を切り替えます。
注意:
v0.32.0の公式ドキュメントでは、VLLM_SERVER_DEV_MODE=1で有効になる開発モードのエンドポイントは、本番環境での利用が推奨されていません。検証で使った環境変数が本番に残っていないかを確認してください。
1枚に載らないモデルはテンソル並列で動かす
1枚のGPUのメモリに収まらない大きなモデルは、--tensor-parallel-size で複数のGPUに分けて動かします。テンソル並列(tensor parallelism)は、モデルの重みを複数のGPUに分けて持たせ、1つのリクエストを複数のGPUで一緒に計算する方式です。
vllm serve <モデル名> --tensor-parallel-size 2
GPUの枚数を増やすと、重みが分かれる分、KVキャッシュに使えるメモリも増えます。ただし、GPU間の通信が増えるため、性能は枚数に比例して伸びるとは限りません。反対に、小さなモデルを1枚のGPUで複数動かしたい場合は、GPUを分割するMIGの仕組みも参考にしてください。
ポイント:
本番に出す前に、APIキーでの認証、/healthと/metricsでの監視、版の固定、開発モードを使っていないことを確認します。大きなモデルは--tensor-parallel-sizeで複数GPUに分けて動かしてください。
vLLMのコストの考え方:100万トークンあたりの計算式
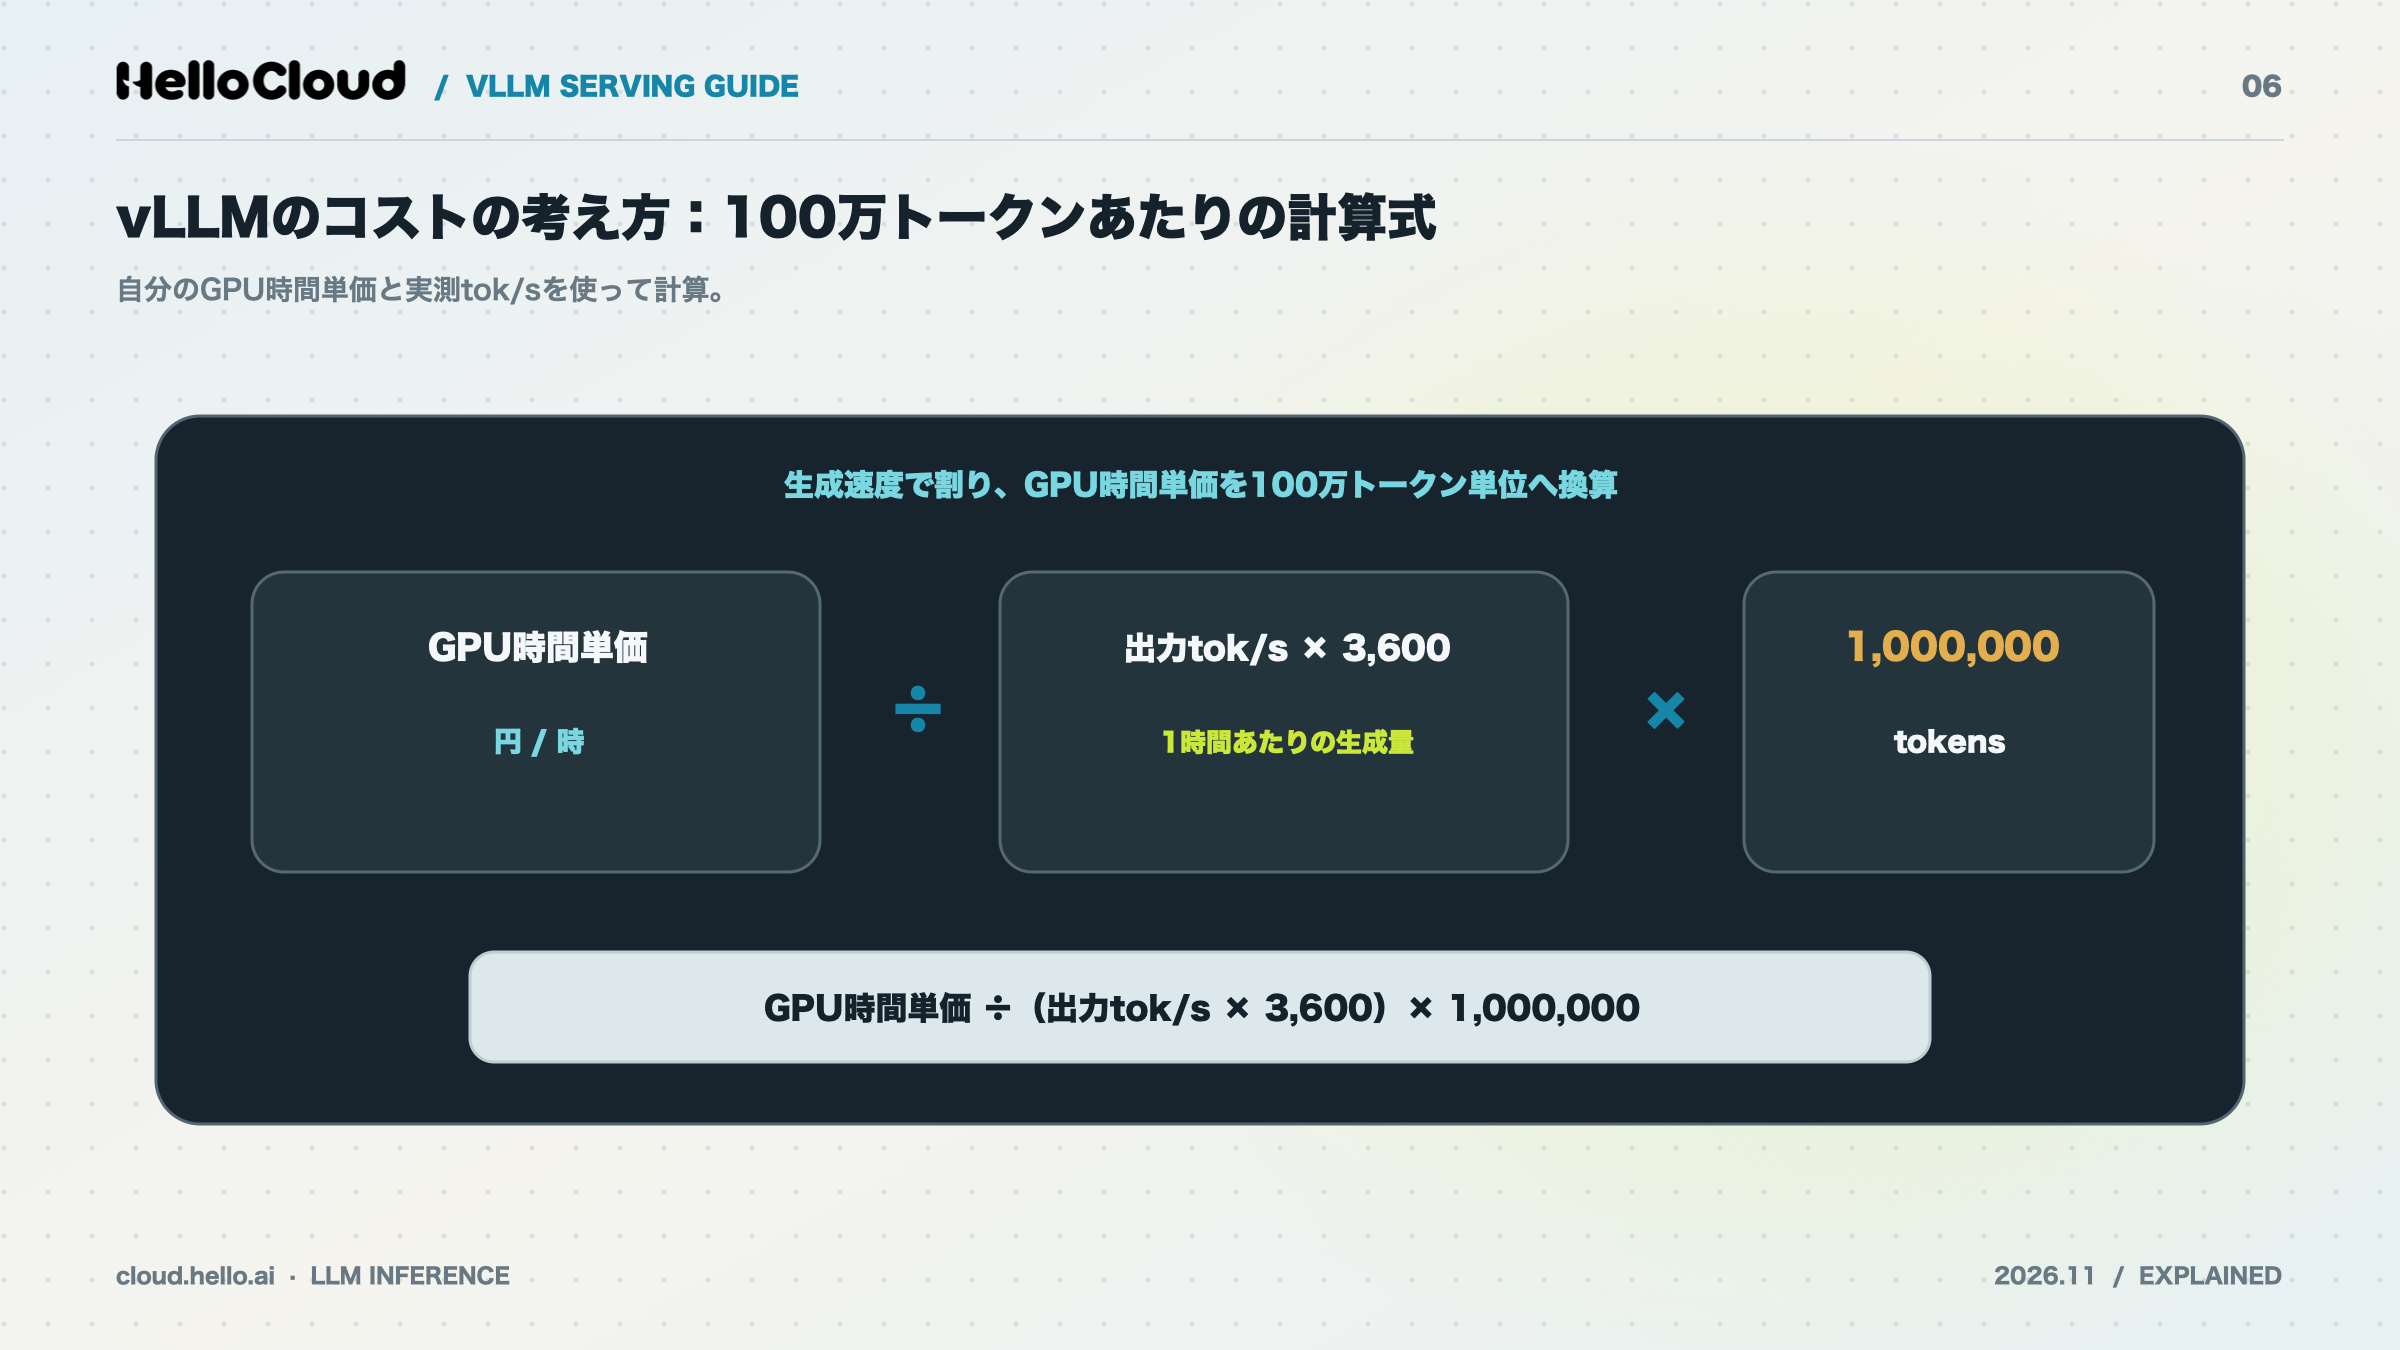
vLLMを自前で動かしたときの100万トークンあたりのコストは、「GPUの時間単価÷(出力tok/s×3,600)×1,000,000」で計算できます。GPUを1時間借りたときの料金を、その1時間で生成できるトークン数で割る考え方です。外部のLLM APIの料金と比べるときも、100万トークンあたりの単位にそろえると判断しやすくなります。
計算式と計算例(仮の値で計算)
100万トークンあたりのコストの式は、次のとおりです。
100万トークンあたりのコスト = GPUの時間単価 ÷(出力tok/s × 3,600)× 1,000,000
計算例として、HelloCloudのRTX 6000(参考価格 ¥380/時間)で、出力tok/sが仮に1,000だった場合を考えます。1時間に生成できるのは1,000×3,600で360万トークンです。¥380を360万トークンで割って100万を掛けると、100万トークンあたり約106円になります。出力tok/sが仮に2倍の2,000なら、同じGPUで約53円です。
計算例の出力tok/s(1,000と2,000)は、説明のための仮の値です。実際の値はモデル・入出力の長さ・同時接続数で大きく変わるため、前の章の手順で測った値を入れてください。RTX 6000の料金は公式サイトの「1インスタンスあたりの参考価格」で、税込・税別の記載はありません。
夜間などリクエストが少ない時間もGPUを借り続けるなら、1日の平均の出力tok/sで計算した方が、実際のコストに近づきます。
GPUの時間単価をそろえて比べる
複数のGPUやクラウドを比べるときは、同じモデルと同じ条件で測った出力tok/sを使い、100万トークンあたりのコストを並べます。
GPU(提供元) | 時間単価 | 測った出力tok/s | 100万トークンあたりのコスト |
|---|---|---|---|
候補1 | |||
候補2 | |||
候補3 |
時間単価が安くても、出力tok/sが半分なら100万トークンあたりのコストは2倍です。料金を比べるときは、税込・税別、為替レート、GPU以外の費用の扱いも、各社の公式ページでそろえてください。国内GPUクラウドの時間単価と総額は国内GPUクラウドの料金比較で、AWSの単価はAWSのGPUインスタンス料金の解説で、同じ条件に並べています。
ポイント:
100万トークンあたりのコストは、時間単価を1時間の生成トークン数で割って出します。式に入れる出力tok/sには、自分の条件で測った値を使ってください。
vLLMを本番でどこで動かすか:自前GPU・クラウド・API
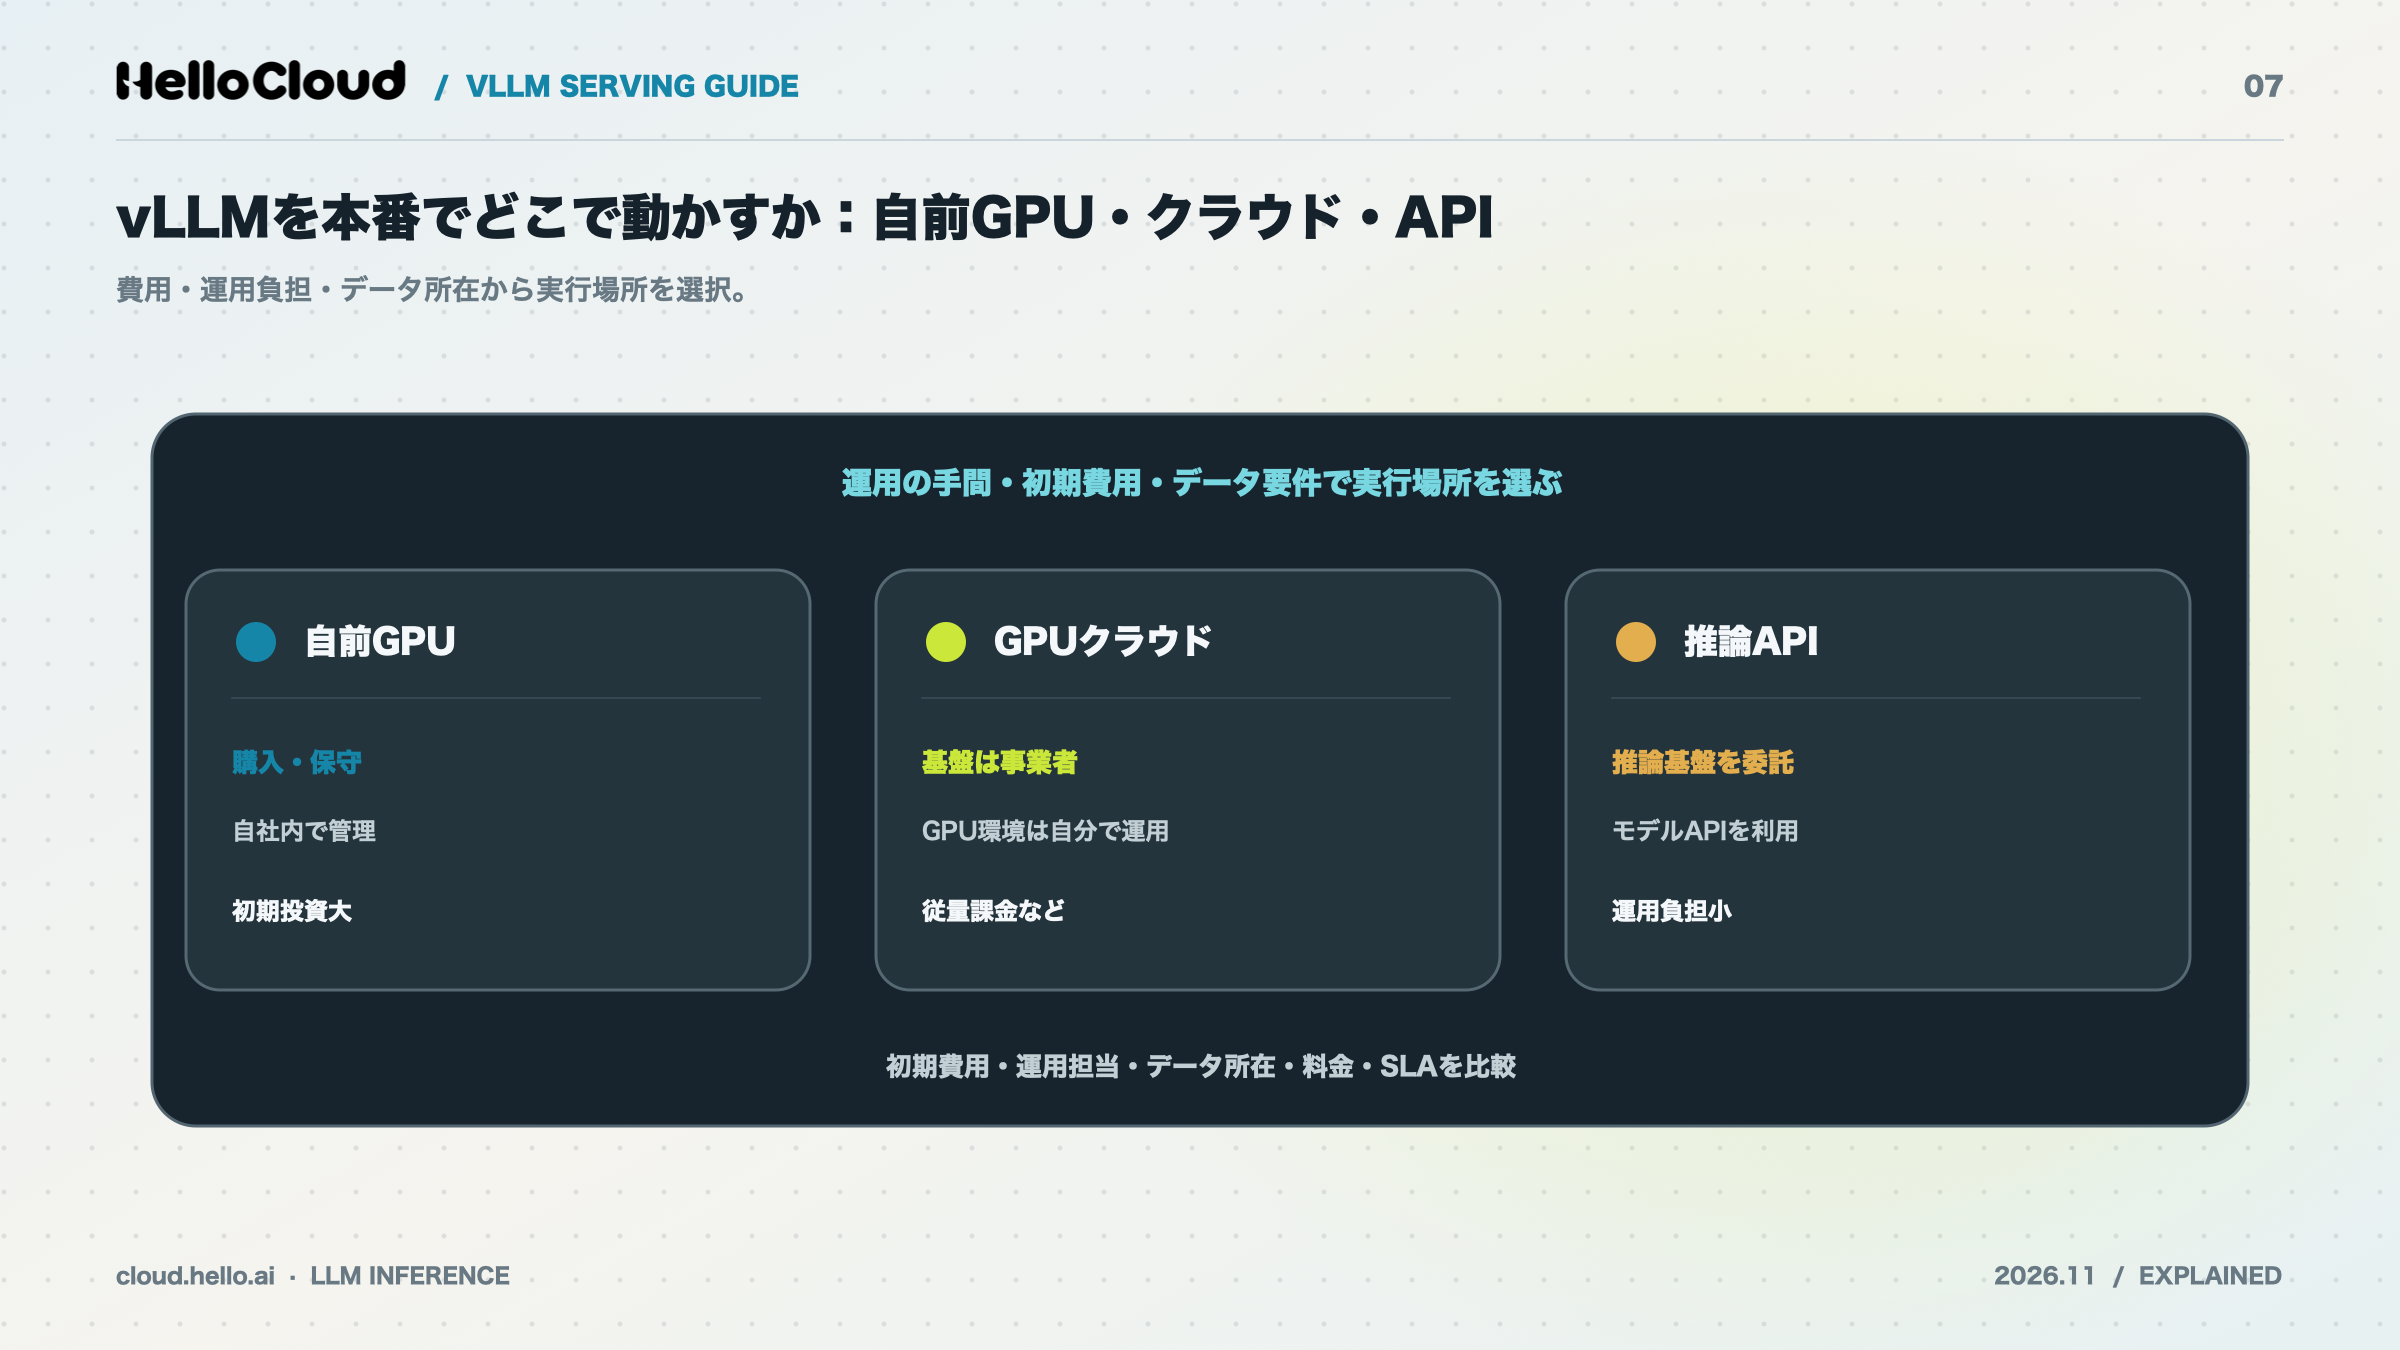
vLLMを本番で動かす場所は、自前のGPUサーバー、GPUクラウド、vLLMを自分で運用しない推論APIの3つから選びます。どれが合うかを分けるのは、初期費用、運用の手間を誰が担うか、データをどこに置く必要があるかの3点です。
3つの選択肢を同じ項目で比べる
3つの選択肢は、初期費用、運用の手間、データの置き場所、料金の公開状況、SLAの5項目で比べると違いがはっきりします。
項目 | 自前GPUサーバー | GPUクラウド | 推論API |
|---|---|---|---|
初期費用 | GPUサーバーの購入費がかかる | 事業者による(HelloCloudは初期費用不要) | 事業者による |
運用の手間 | ハードウェア・OS・vLLM・監視をすべて自社で担う | OS・vLLM・監視を自社で担う(サーバーレス型ではサーバーの用意が不要) | vLLMの運用は不要。呼び出す側だけを作る |
データの置き場所 | 自社の設備 | 事業者のデータセンター | 事業者の処理基盤(所在国は事業者の説明で確認) |
料金の公開状況 | 購入費と電気代などを自社で計算 | 事業者による | 事業者による(HelloCloudのZDR推論APIは担当者が案内) |
SLA | 自社で決める | 事業者による | 事業者による |
出典:HelloCloud公式サイト、HelloCloud SLA(2026年11月9日確認)
長期間ほぼ一定の負荷が続くなら、自前のGPUサーバーも候補です。負荷が時間帯で大きく変わる場合や、検証から始めたい場合は、使った分だけ払うGPUクラウドの方が始めやすくなります。GPUクラウドの利用形態や料金の見方は、GPUクラウドの仕組みと使い方の解説で扱っています。
GPUクラウドで動かす場合:HelloCloudの例
HelloCloudは、東京の2拠点(JPTY01/JPTY02)でGPUインスタンスとサーバーレスGPU実行環境を提供する国産のGPUクラウドです。GPUインスタンスにvLLMを入れれば、本記事の手順でAPIサーバーを立てられます。
GPU | VRAM | RAM | vCPU | 参考価格 | 公式サイトでの想定用途 |
|---|---|---|---|---|---|
RTX 6000 | 96GB | 96GB | 16 | ¥380/時間 | 軽量〜中規模LLMの推論、画像や音声のバッチ処理、開発とプロトタイピング |
B300 | 288GB | 384GB | 24 | ¥1,480/時間 | 大規模モデルの学習、高負荷な推論、生成AIの本番運用 |
出典:HelloCloud公式サイト(2026年11月9日確認)。料金は1インスタンスあたりの参考価格で、税込・税別の記載はありません。
GPUは従量課金で初期費用は不要、申し込んだ当日から使えます。サーバーレスGPU実行環境では、コードにGPUの種類と枚数を書いて supa deploy コマンドでデプロイすると、指定したGPUでコンテナが起動し、負荷に合わせてコンテナの数が自動で増減します。
利用規約では、利用者がコンテンツの保存先のリージョンを選べること、法令や政府機関の拘束力ある命令への対応に必要な場合を除き、コンテンツを第三者へ開示せず選択されたリージョンの外へ移さないことが定められています(第1条1.4)。SLAは、APIのリクエスト成功率について月間稼働率99.9%以上の維持に向けて商業上合理的な範囲で努力するもので、保証ではありません。
vLLMを自分で運用しない選択肢:ZDR推論API
vLLMのサーバーを自分で運用せずに推論を使いたい場合は、HelloCloudのZDR推論APIも選べます。OpenAI SDKのまま、接続先のURL・APIキー・モデル名を差し替えるだけで使える推論APIです。ZDR(ゼロデータ保持)の方針で、プロンプトと生成結果は保存されず、学習にも使われません。料金は担当者が案内する形で、公開価格はありません。
注意:
ZDR推論APIは、モデルに応じて自社保有のGPUと、TEE(信頼できる実行環境)を用いた分散GPUを使い分けます。分散GPUのノードの所在国は特定できないため、データを国内で処理する必要がある場合は、GPUインスタンスかサーバーレスGPU実行環境を選んでください。
公開されている導入事例:ラス恋・Aimy
HelloCloudの公式サイトに載っている、推論を本番で動かしている企業の導入事例は2件です。
株式会社ラス恋(CEO 山口様)は、会員の個人情報を扱うため推論も国外のサーバーに出せない前提で、処理を国内に閉じられる点が決め手になり、申し込んだ日のうちに検証を始め、レコメンドのモデルを本番に載せています。
Aimy株式会社(CEO 平野様)は、AIキャラクターとの対話サービスで推論を常時動かしながら、同じ環境でモデルの学習も進めています。
出典:HelloCloud公式サイト(2026年11月9日確認)
ポイント:
置き場所を選ぶ基準は、初期費用、運用の手間、データの置き場所、料金の公開状況、SLAの5項目です。データを国内で処理する必要があるなら、拠点と処理基盤の所在を事業者の公式情報で確認してください。
国内のGPUでvLLMの推論APIを動かす環境を検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。GPUインスタンス(RTX 6000・B300)とサーバーレスGPU実行環境は、東京の2拠点で稼働しています。
資料請求(HelloCloudの特徴と料金)
vLLMについてよくある質問
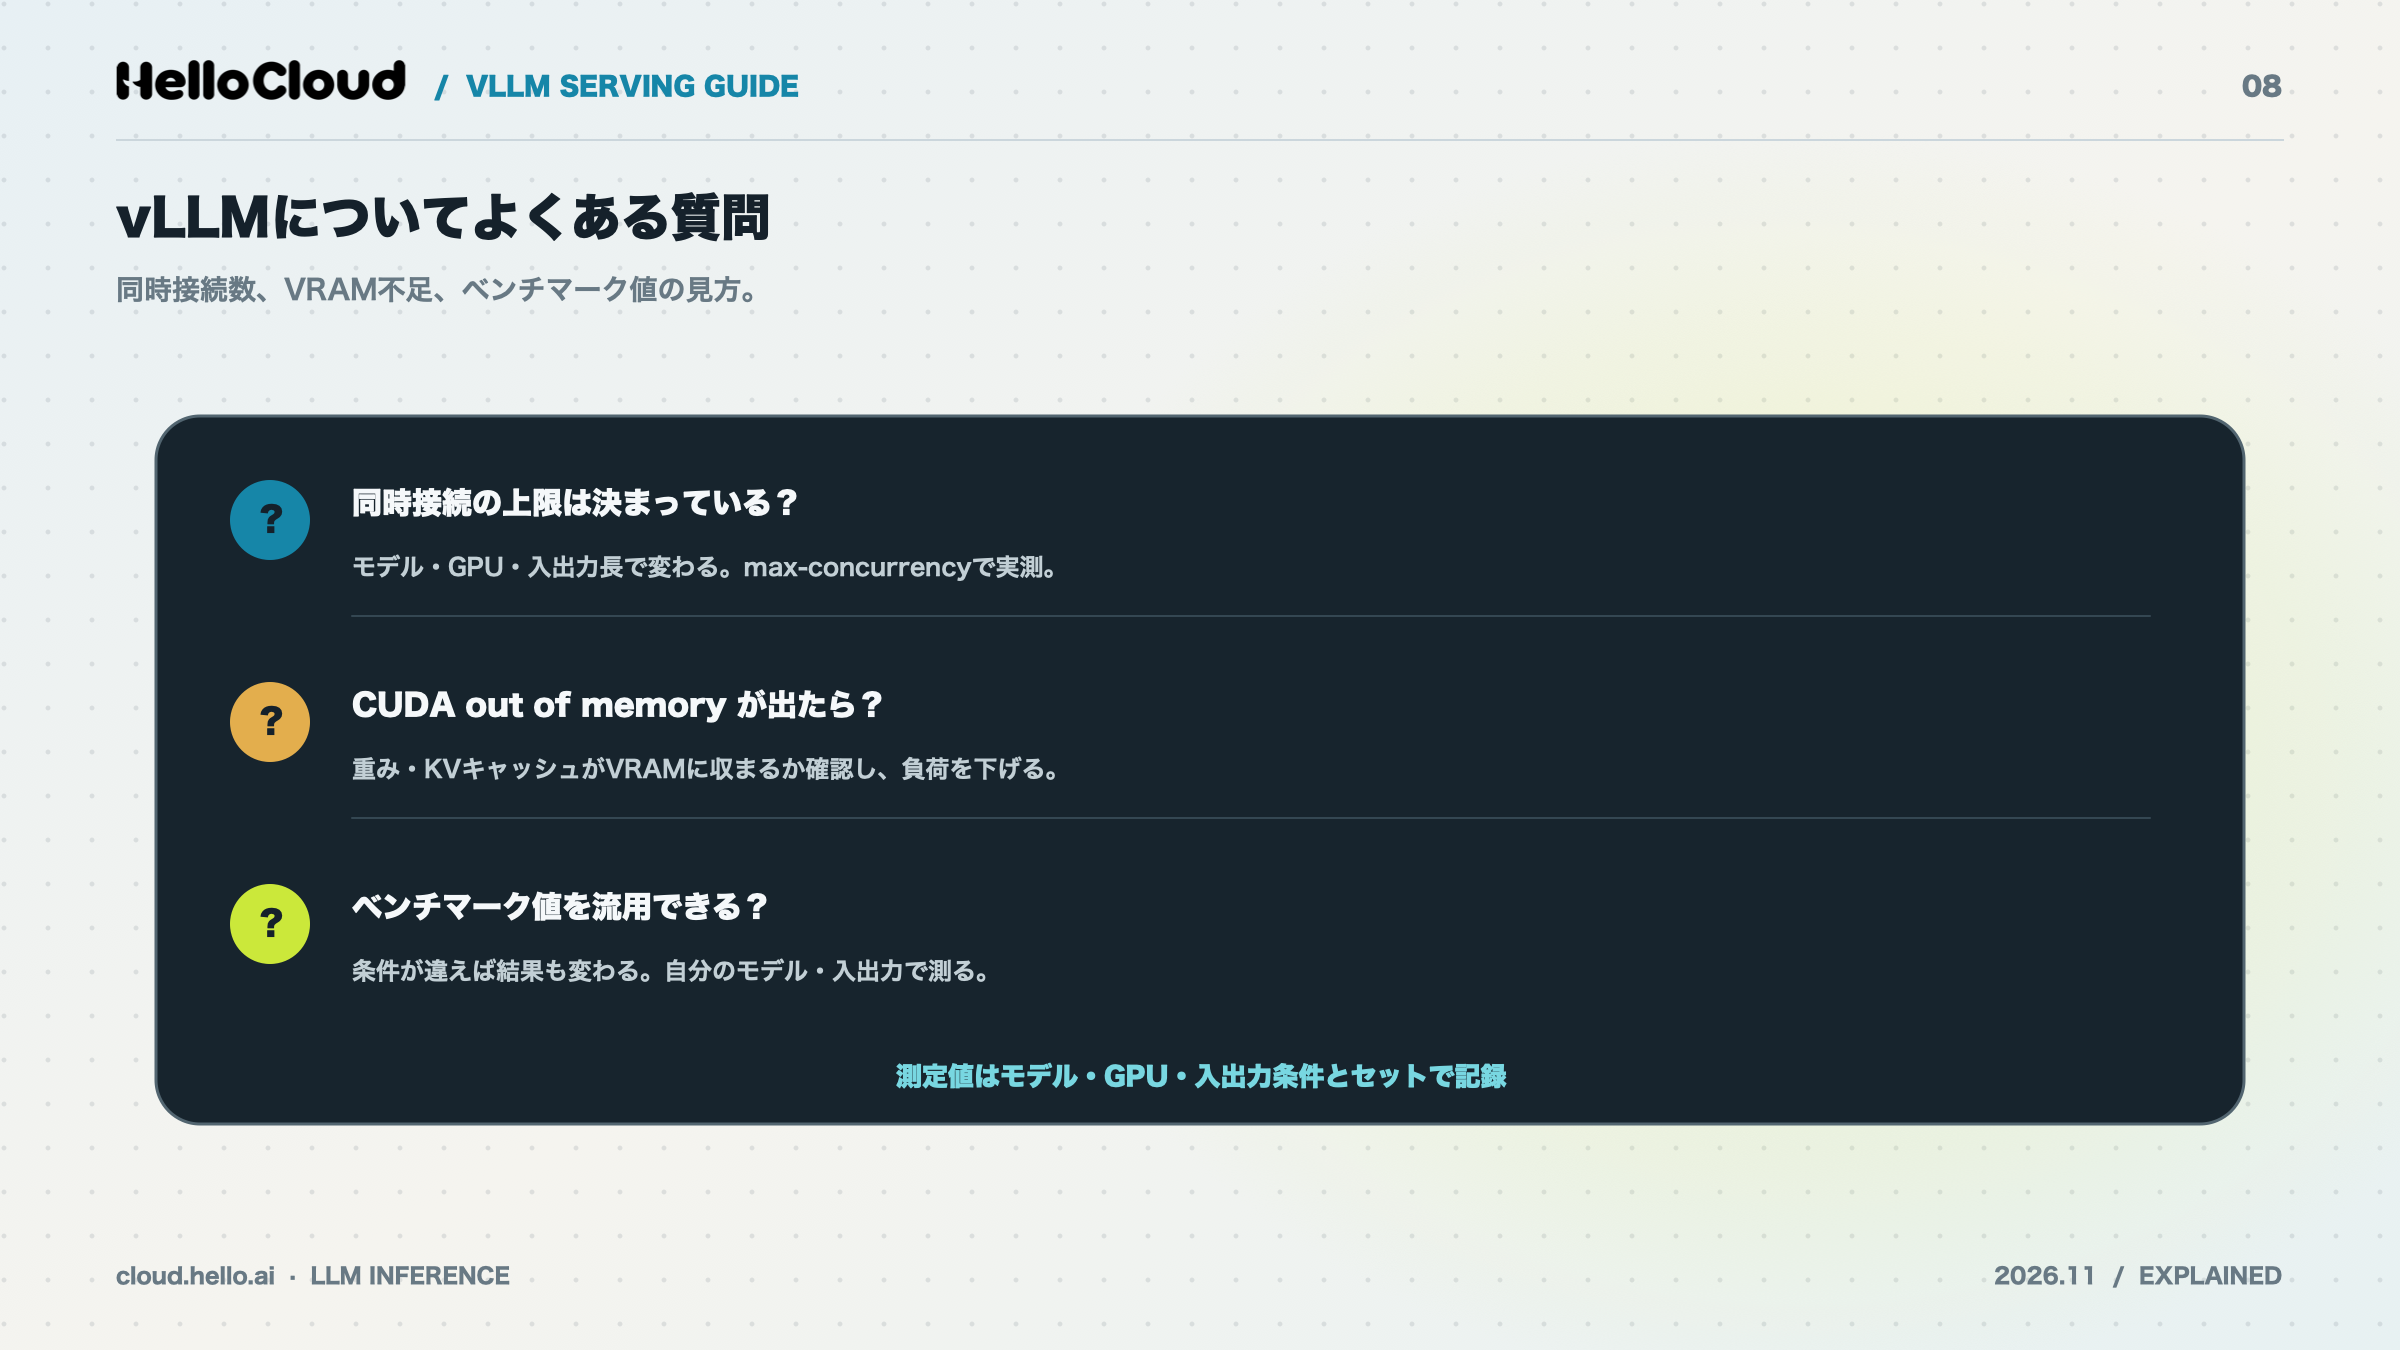
vLLMの同時接続数の上限はいくつですか?
vLLMの同時接続数の上限に、どの環境でも通用する決まった数字はありません。上限は、GPUメモリのうちモデルの重みを置いた残りに、どれだけのKVキャッシュを置けるかで決まります。モデルの大きさと入出力の長さで変わるので、vllm bench serve の --max-concurrency を段階的に変え、自分の条件で測って決めてください。
CUDA out of memory が出たときはどうすればいいですか?
CUDA out of memoryは、主にGPUメモリにモデルの重みとKVキャッシュが収まらないときに出るエラーです。次の3つを順に試します。
最大の長さを短くする:
--max-model-lenを用途に合った長さまで短縮同時に処理する数を減らす:
--max-num-seqsの値を下げて同時処理数を削減vLLMが使う割合を調整する:
--gpu-memory-utilizationの値を調整
メモリがまだ足りない場合は、VRAMの大きいGPUに替えるか、--tensor-parallel-size で複数のGPUに分けてください。
vLLMはどのバージョンを使えばいいですか?
本番では、検証で性能と動作を確かめた版に固定してください。公開されている版は、PyPIのリリース履歴で確認できます(2026年11月20日確認)。新しい版に上げるときは、リリースノートで既定値や挙動の変更を読み、検証環境で同じ条件のベンチマークを測り直してから切り替えます。NVIDIAのGPUを使う場合は、NVIDIAが毎月リリースしているvLLMコンテナから選ぶ方法もあります。
vLLMは商用で使えますか?
vLLMのソースコードは、商用利用を認めるApache License 2.0で公開されています(vLLMのLICENSE、2026年11月9日確認)。ただし、vLLMで動かすモデルの重みには、モデルごとに別のライセンスがあります。商用で使う前に、使うモデルのライセンスと利用条件を配布元で確認してください。
まとめ:vLLMは自分の負荷で測って同時接続数を決める
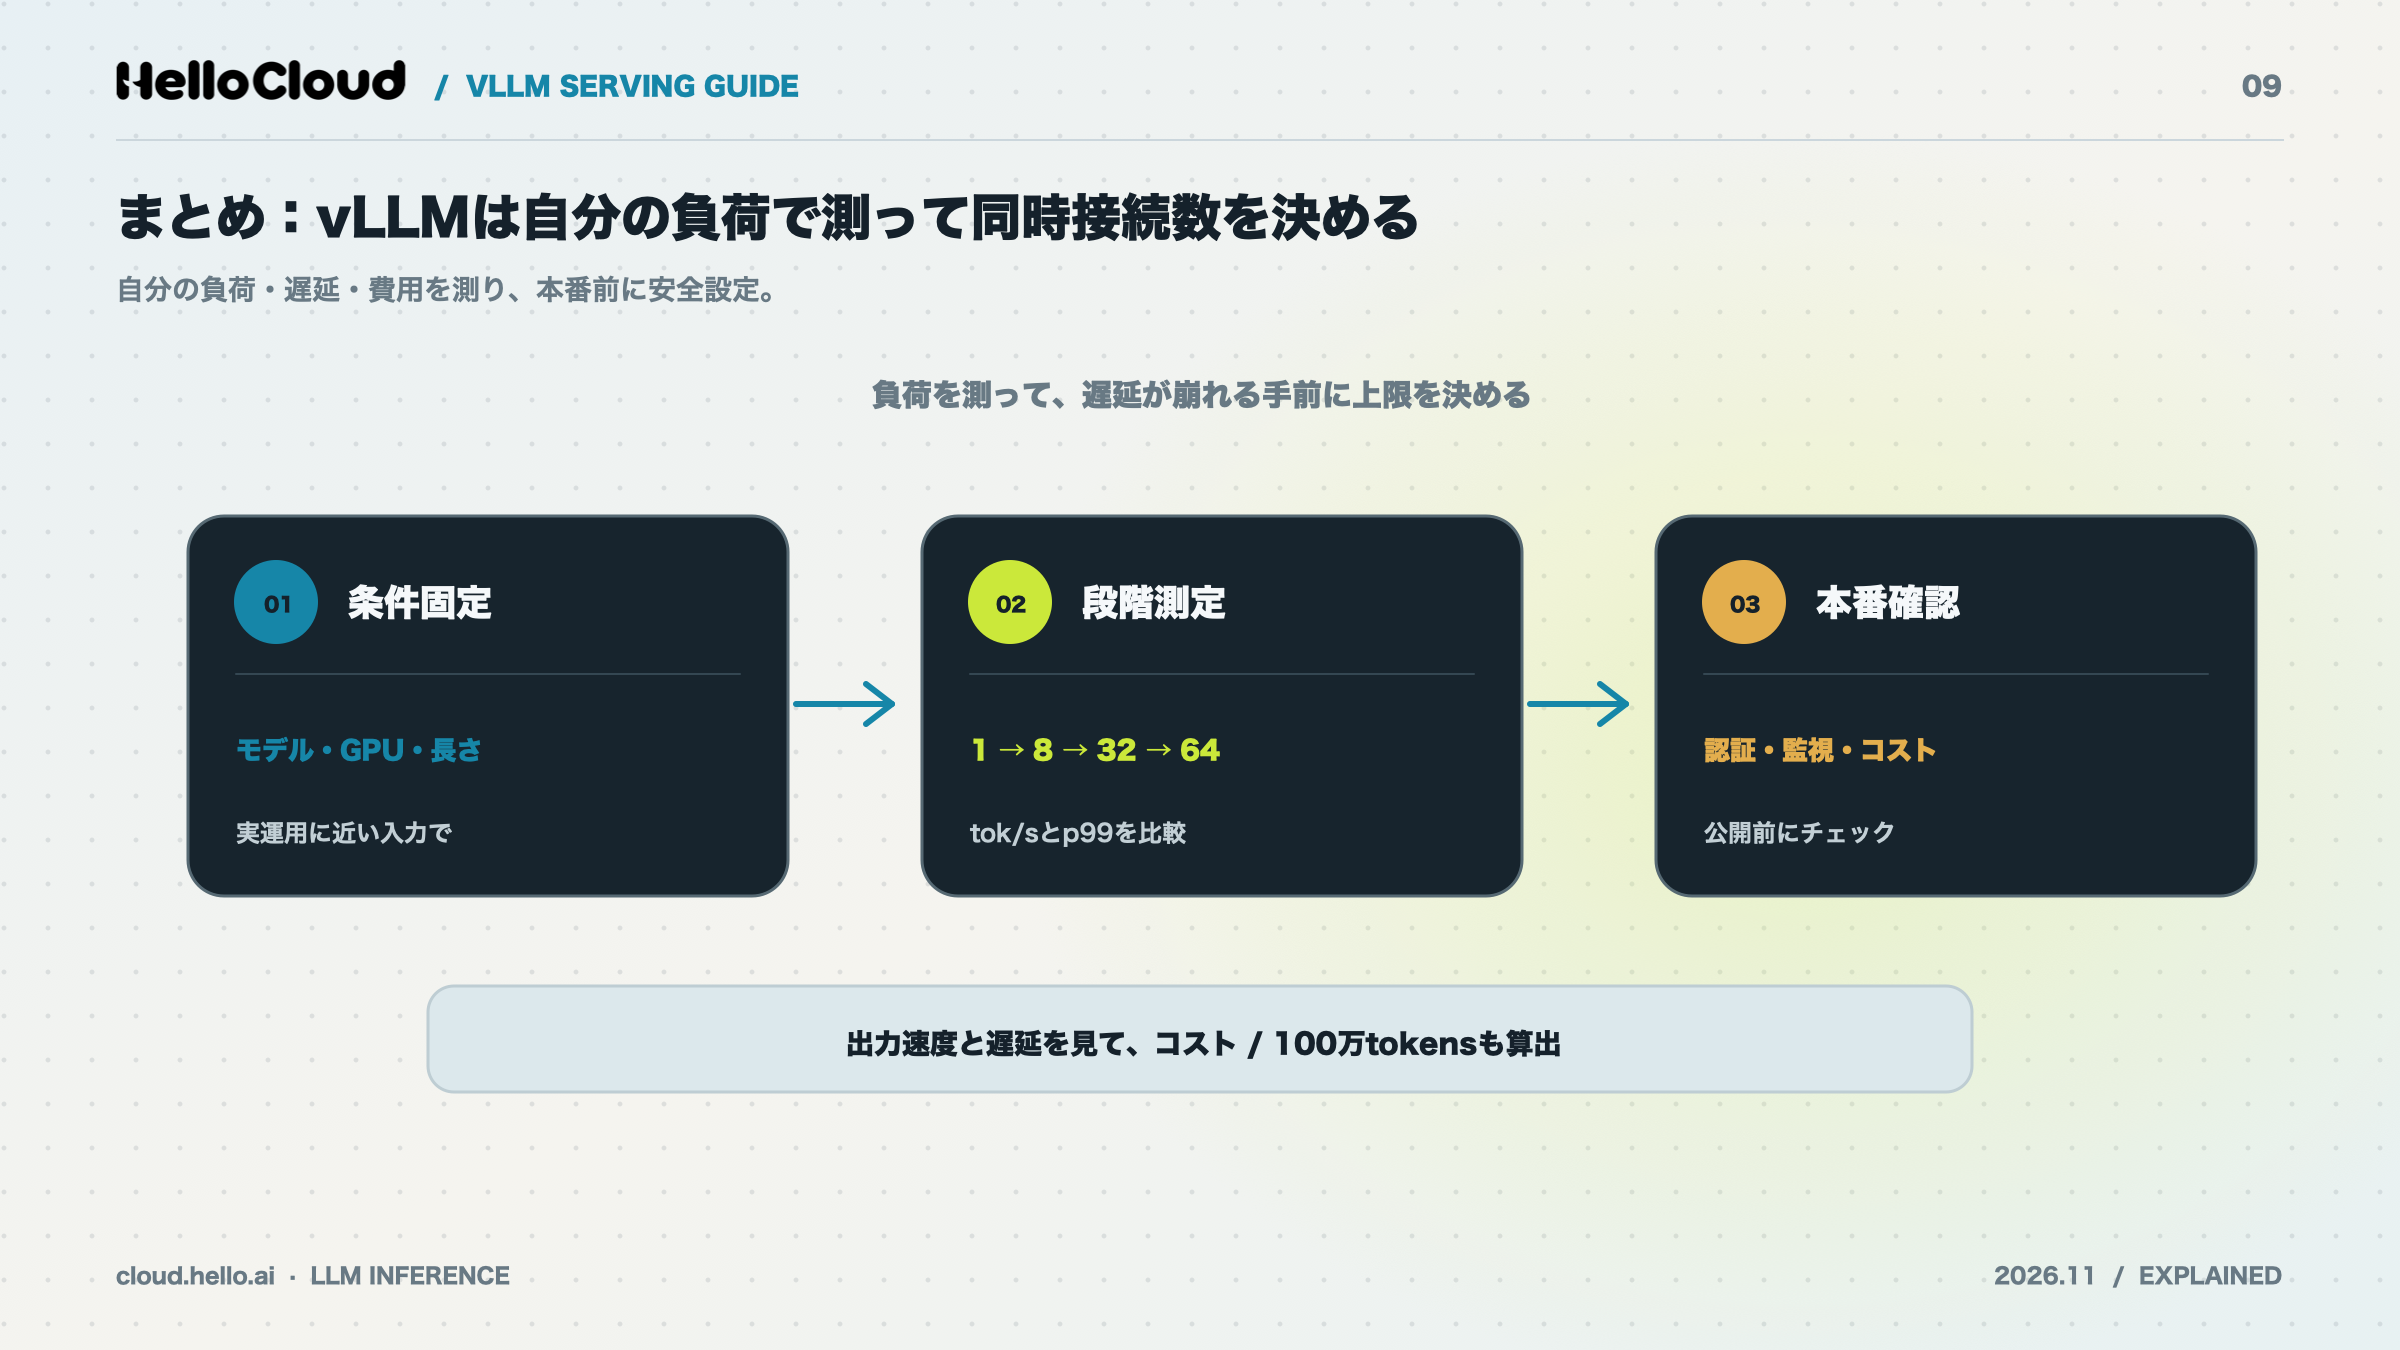
vLLMは、OpenAI互換APIで多くの同時リクエストを効率よく処理できる、オープンソースの推論エンジンです。
同時接続数の上限は、
--max-concurrencyを1・8・32・64と変えて測り、スループットの伸びが止まる点と遅延が急に伸びる点の手前に決めます。本番では、認証・監視・版の固定を確認してから公開してください。
100万トークンあたりのコストの元になるのは、GPUの時間単価と、自分で測った出力tok/sです。
vLLMの検証から本番運用まで、国内のGPU環境で進めたい方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。資料には、LLM推論・モデル学習・バッチ処理での活用方法も載っています。
資料請求(HelloCloudの特徴と料金)
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


