この記事の結論
推論エンジンを選ぶときは、動かすモデルの種類、対応するGPU・OS、使える精度の3点を公式ドキュメントで確かめます。推論エンジンを使ってもGPUは必要なので、動かす環境も同時に決めておくと手戻りを防げます。
推論エンジン(inference engine)とは
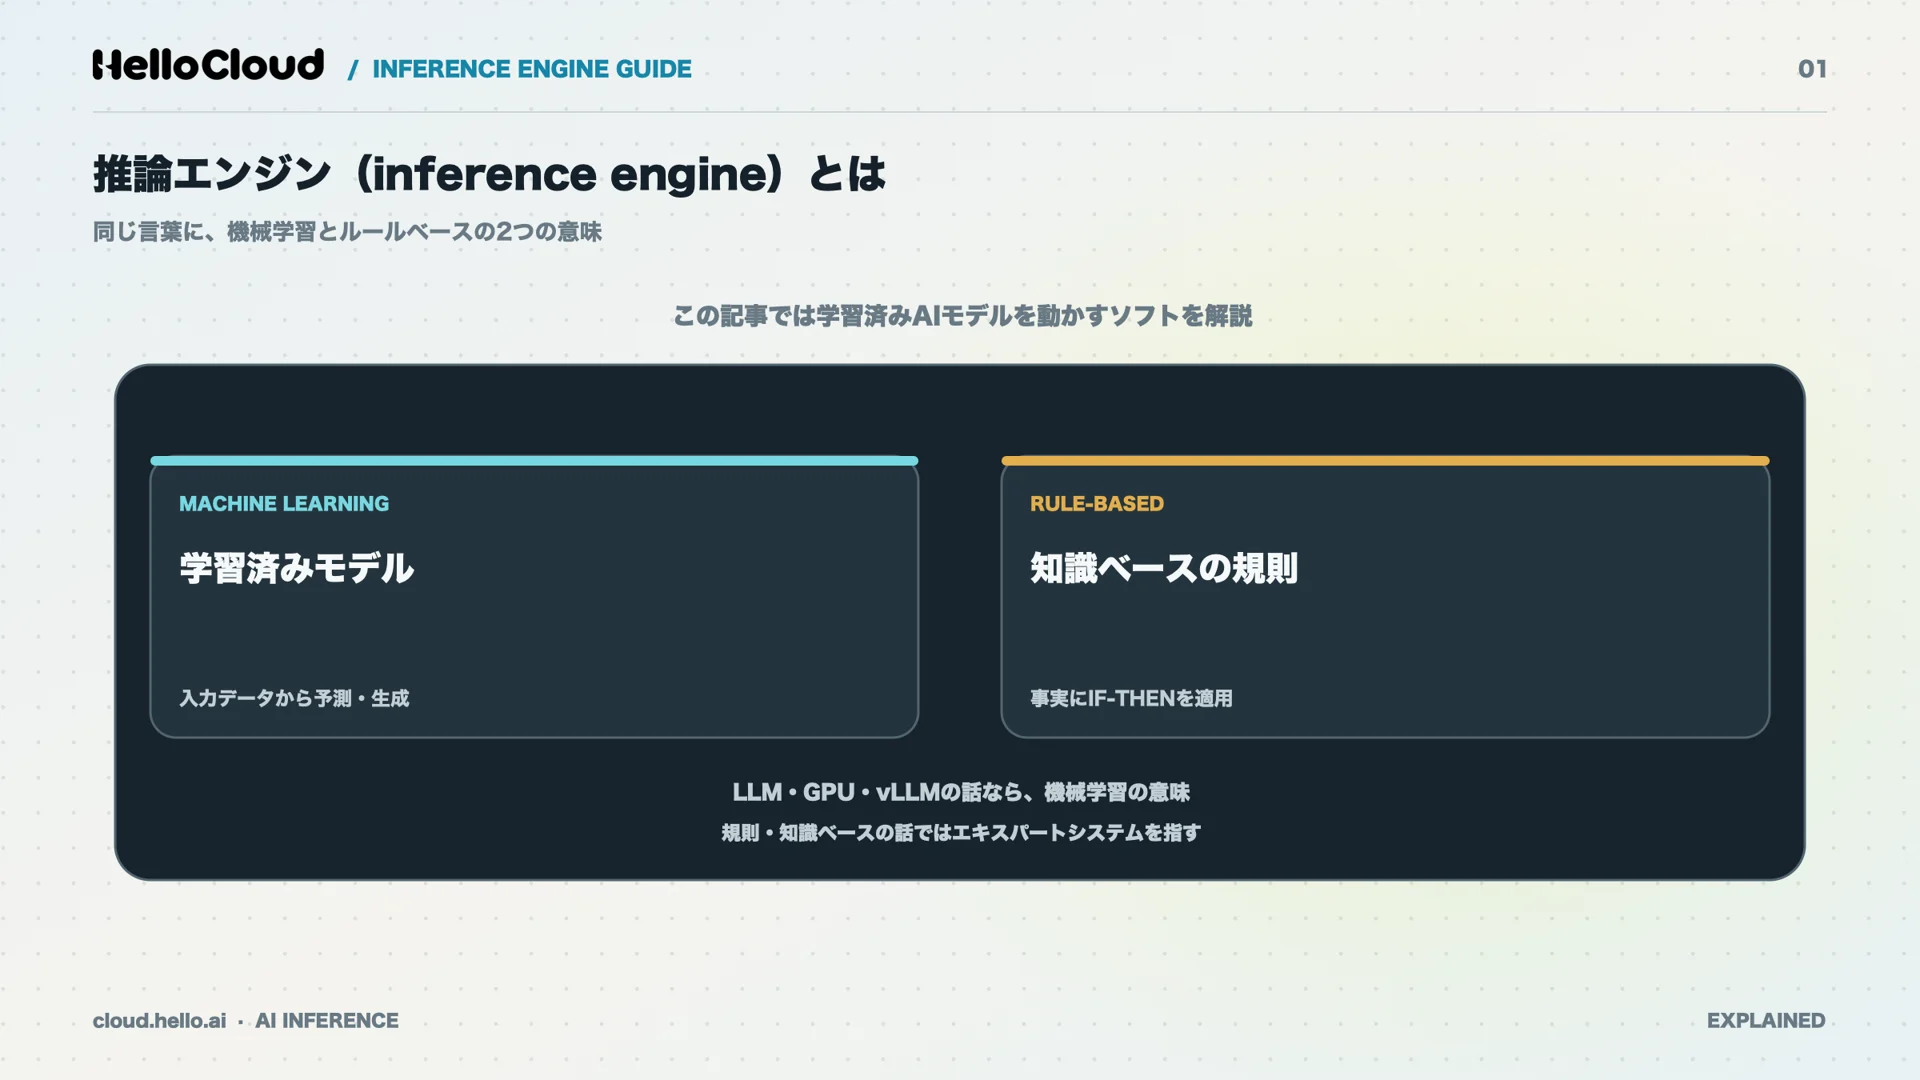
推論エンジンには、機械学習の推論エンジンと、ルールベースの推論エンジンの2つの意味があります。
英語版Wikipediaの「Inference engine」の項目はエキスパートシステムの意味、AI企業の用語集は機械学習の意味で説明しており、使い方が分かれています。
意味 | 入力 | やること | 具体例 |
|---|---|---|---|
機械学習の推論エンジン | 文章・画像・音声などのデータ | 学習済みモデルの計算を実行する | vLLM、SGLang、TensorRT LLM、ONNX Runtime |
ルールベースの推論エンジン | 事実 | 知識ベースの規則を当てはめて結論を出す | 診断などのエキスパートシステム |
機械学習の推論エンジン:学習済みモデルを動かすソフト
機械学習の推論エンジンは、学習済みのモデルで新しい入力に答えを出す処理(推論)を実行するソフトウェアです。
SGLangの論文(NeurIPS 2024)も、最先端の推論エンジンの例としてvLLM、TGI、TensorRT-LLMを挙げています。
ルールベースの推論エンジン:エキスパートシステム
ルールベースの推論エンジンは、エキスパートシステム(専門家の知識を規則にしたシステム)の中で、「もし〜なら〜」という規則を事実に当てはめて結論を導く部分です。
学習済みモデルではなく、人が書いた規則で動く点が機械学習の推論エンジンと異なります。
2つの意味の見分け方
推論エンジンがどちらの意味かは、一緒に使われる言葉で判断できます。
機械学習の意味:LLM、GPU、モデル、推論API、量子化、vLLMなどの製品名
ルールベースの意味:知識ベース、規則(ルール)、IF-THEN、前向き推論・後向き推論
ポイント:
LLMやGPUの話なら機械学習の推論エンジン、知識ベースや規則の話ならルールベースの推論エンジンです。この記事で扱うのは、機械学習の推論エンジンです。
推論エンジンと関連用語の違い
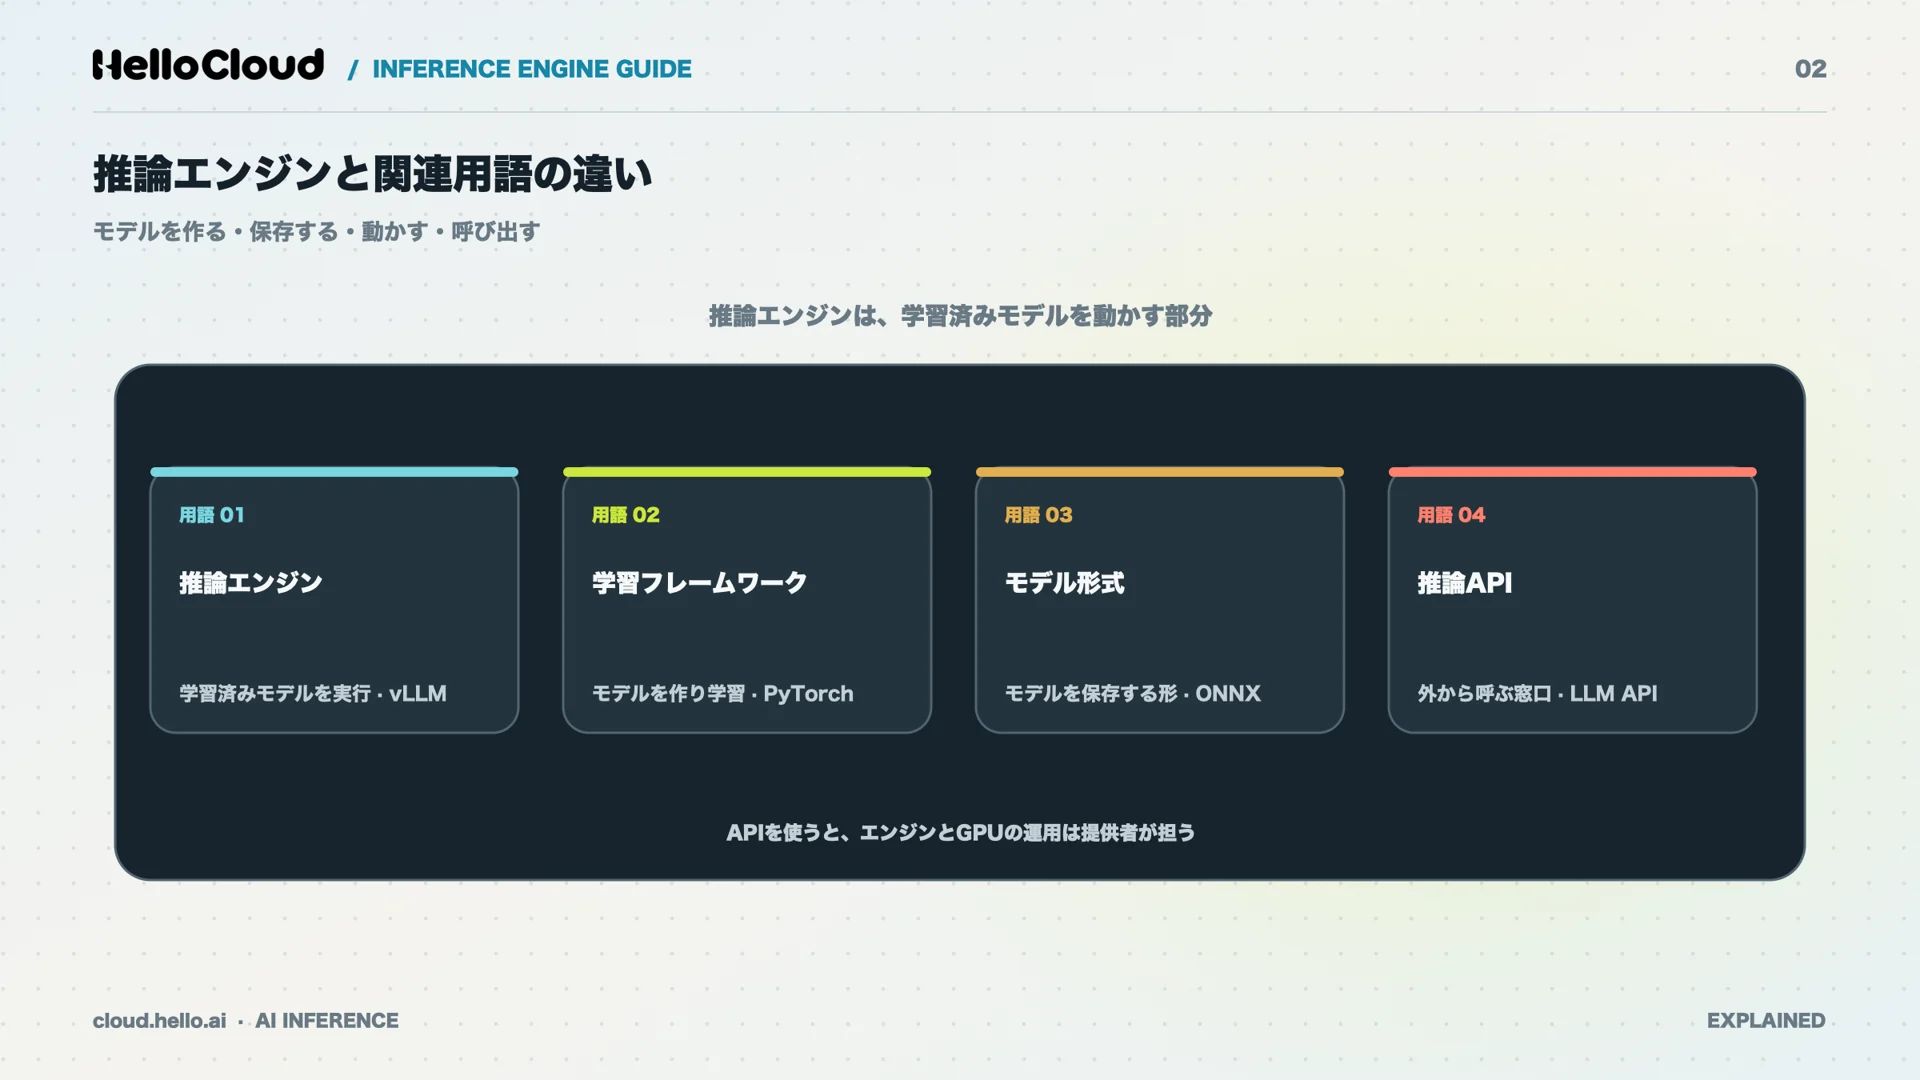
推論エンジンは学習済みモデルを実行する部分で、モデルを作る学習フレームワーク、モデルを保存するモデル形式、外から呼び出す推論APIとは役割が違います。
4つの言葉はAIの解説で同時に出てくることが多く、取り違えやすい組み合わせです。
学習フレームワーク・ONNX・推論APIとの違い(表)
4つの用語は、AIモデルを作ってから使うまでの別々の段階を受け持ちます。
用語 | 役割 | 主な例 |
|---|---|---|
推論エンジン | 学習済みモデルをGPU・CPU上で速く実行する | vLLM、TensorRT LLM、ONNX Runtime |
学習フレームワーク | モデルを設計し、データで学習させる | PyTorch、TensorFlow |
モデル形式 | 学習済みモデルを、別のソフトで読み込める形で保存する | ONNX |
推論API | ネットワーク越しにモデルを呼び出す窓口 | クラウド事業者のLLMのAPI |
出典:NVIDIA「TensorRT LLM Overview」、ONNX Runtime「Execution Providers」、PyTorch、TensorFlow(2026年11月10日確認)
推論エンジンと推論APIの関係
推論APIを使う場合、モデルを動かす推論エンジンやGPUの運用は、APIの提供者が担います。推論エンジンを自分で運用するか、推論APIの提供者に任せるかが、両者の違いです。
ポイント:
推論エンジンは「モデルを動かす部分」、推論APIは「動いているモデルを外から呼ぶ窓口」です。推論APIを使う場合は、推論エンジンの運用を提供者に任せる形になります。
推論エンジンが注目されている理由
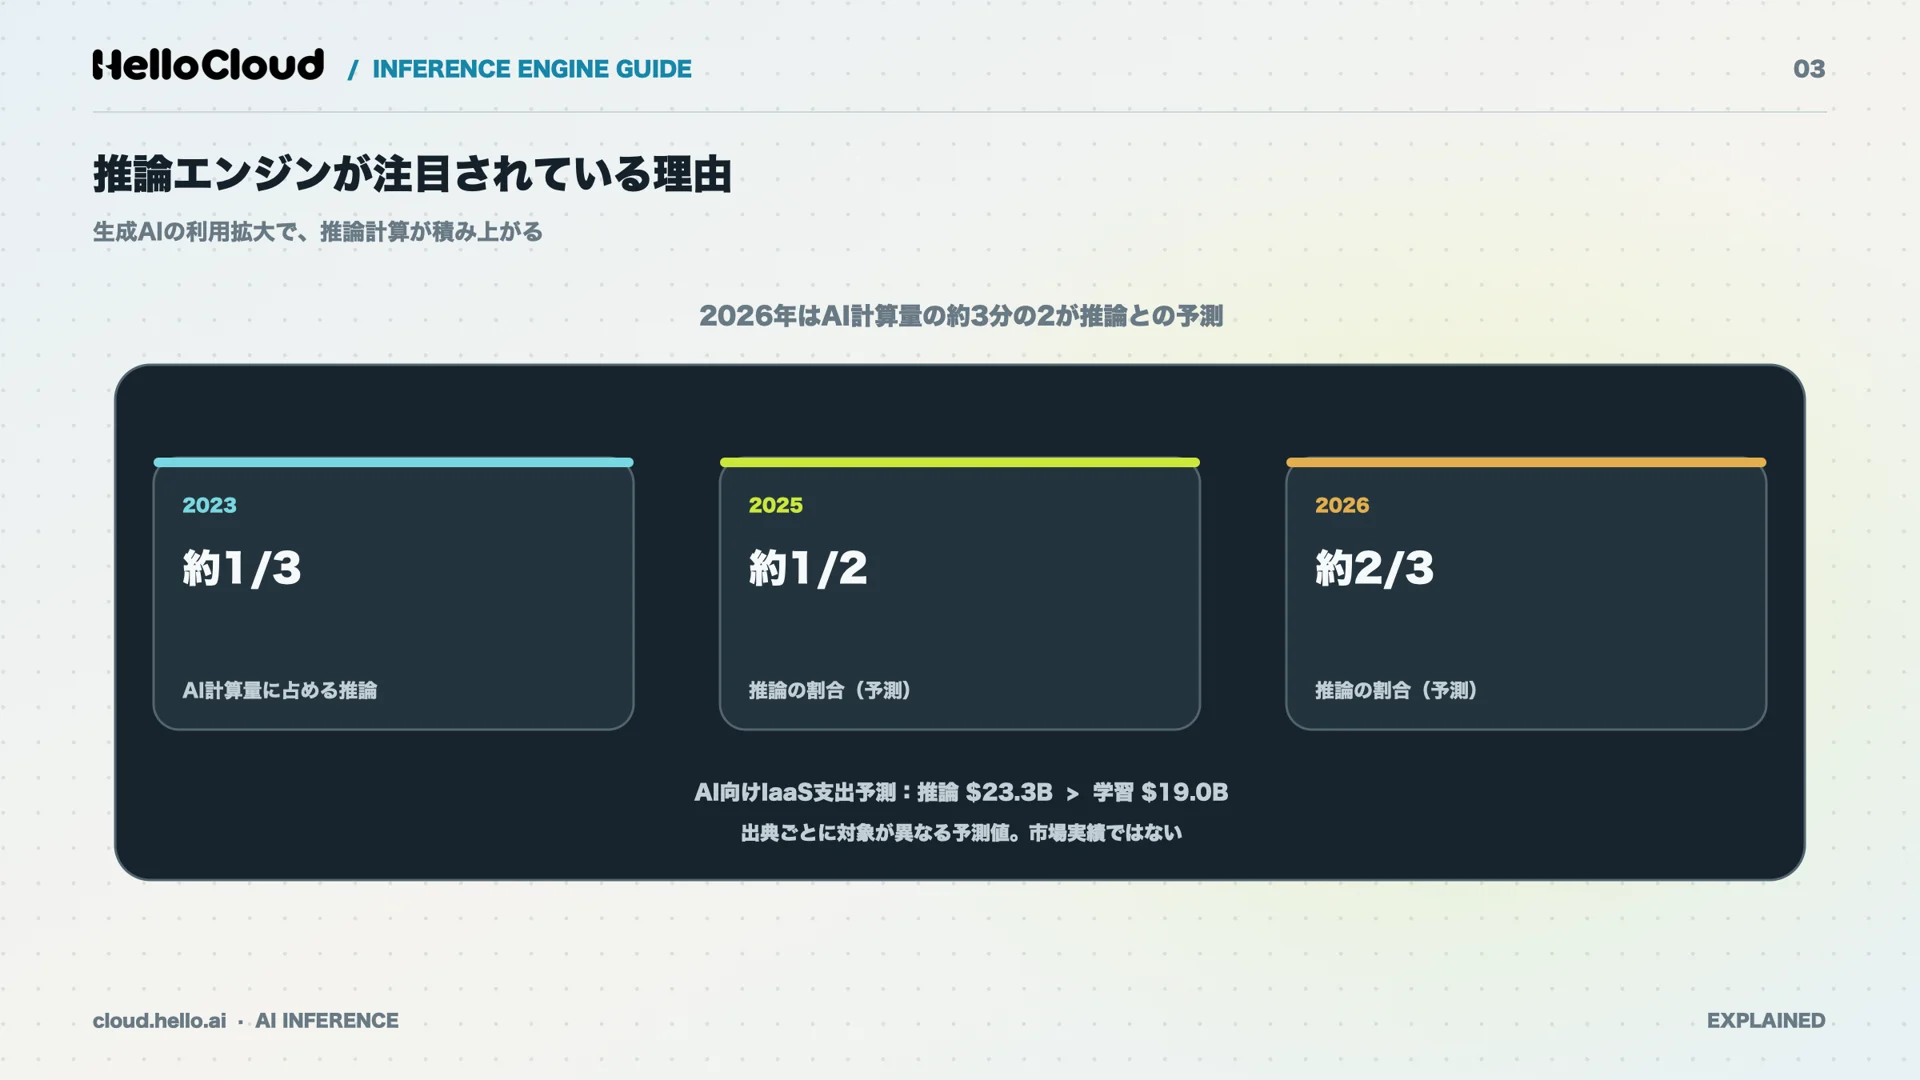
推論エンジンが注目されているのは、AIの計算資源と投資の中心が、学習から推論へ移っているためです。生成AIの利用が増えるほど、質問ごとに発生する推論の計算量が積み上がります。
AIの計算量の中心は学習から推論へ
Deloitte(2025年11月)は、AIの計算量に占める推論の割合が2023年の3分の1、2025年の約半分から、2026年に約3分の2へ増えると予測しています。
Gartner(2026年8月)の予測は、AI向けに最適化したIaaS(クラウドで借りる計算資源)の支出が対象です。2026年は推論向けが233億ドルで、学習向けの190億ドルを上回る見込みです。
国内でも生成AIの業務活用が広がっている
総務省「令和8年版 情報通信白書」(2026年7月)によると、生成AIの活用方針を定めている日本企業は、2024年度の49.7%から2025年度は68.9%に増えました。
米国の82.8%、ドイツの82.2%と比べると、引き続き低い水準です(米独の値は図表の2項目を合計したもの)。
ポイント:
推論は2026年にAIの計算量の約3分の2を占める予測で、推論を効率よく動かす推論エンジンの役割が大きくなっています。
推論エンジンの仕組み
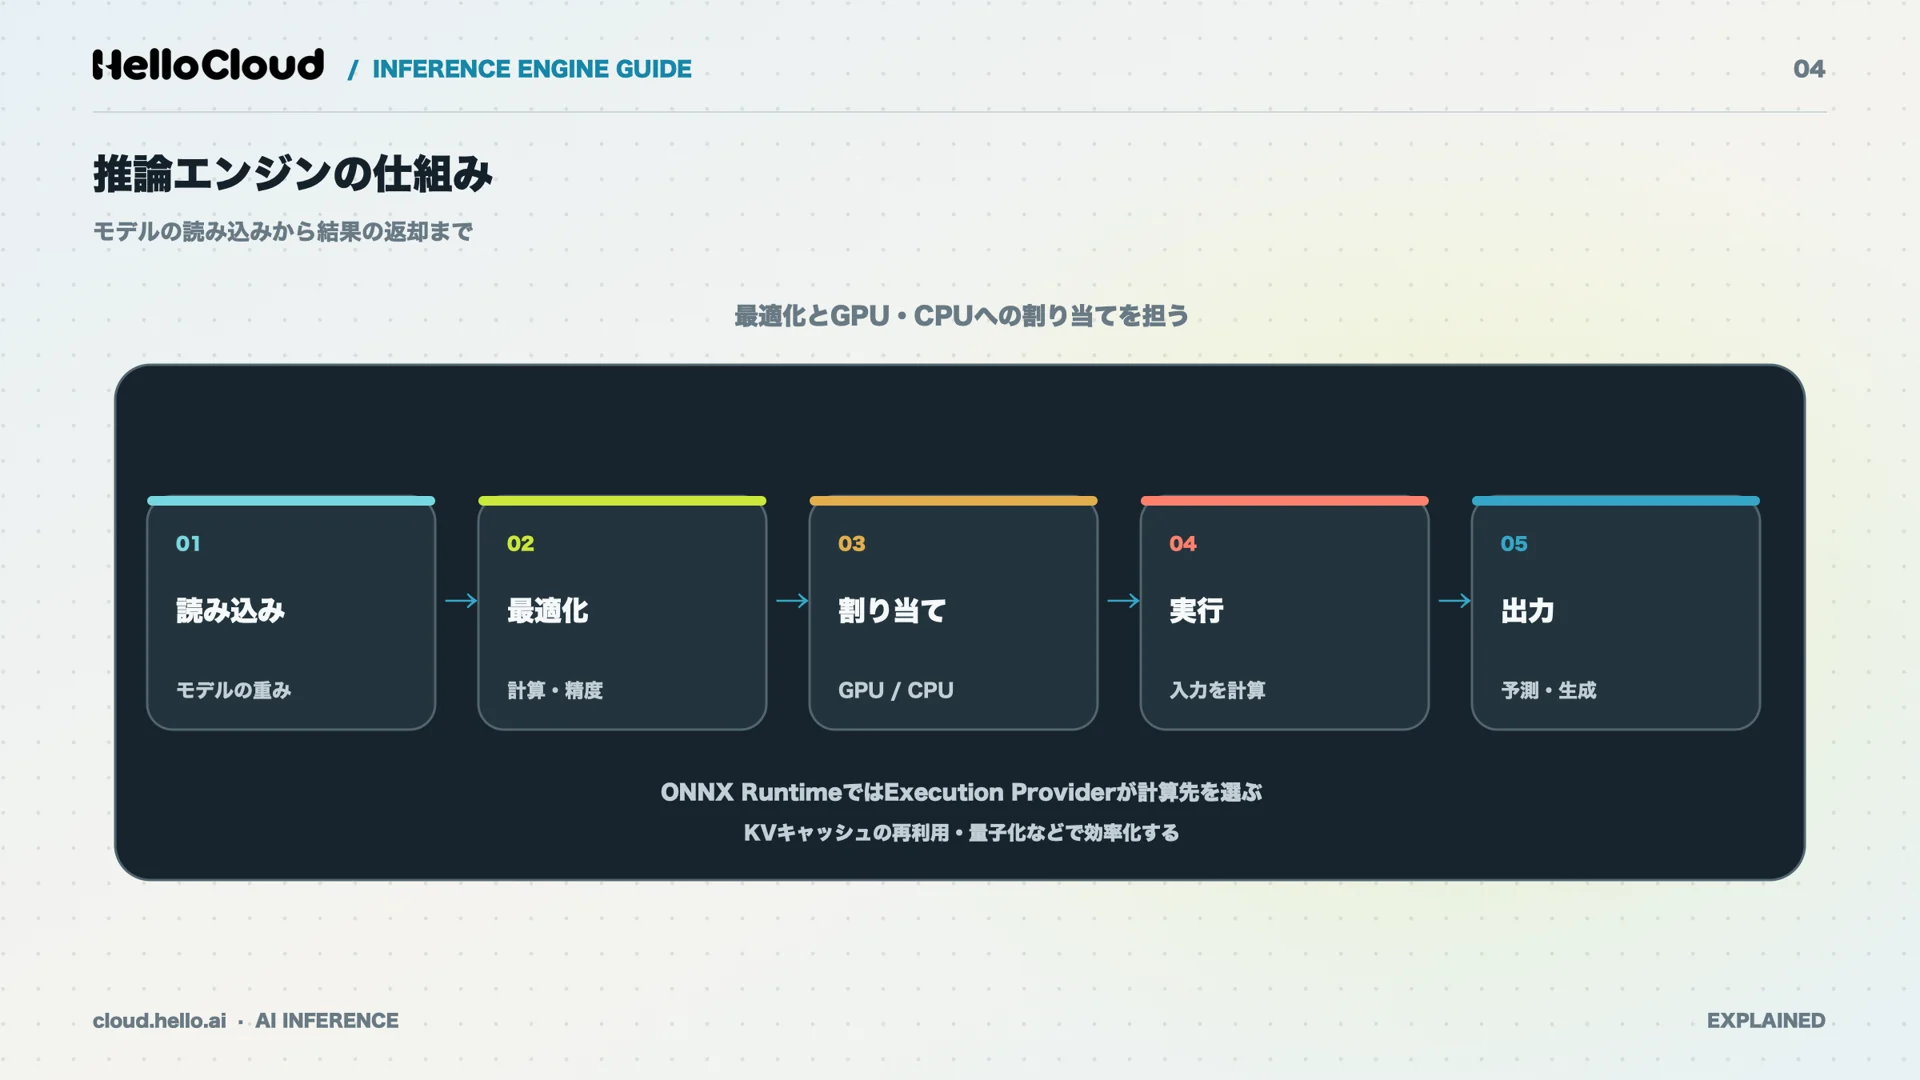
推論エンジンは、学習済みモデルを読み込み、計算を最適化し、GPUやCPUに割り当てて実行するソフトウェアです。
同じモデルでも、推論エンジンによって速度やメモリの使い方は変わります。
処理の流れ:モデルの読み込みから出力まで
機械学習の推論エンジンの処理は、おおまかに次の5段階です。
モデルを読み込む:学習で決まった数値(重み)をメモリに載せる
計算を最適化する:計算をまとめ直したり、数値の精度を下げたりする
ハードウェアに割り当てる:各計算をGPU・CPUのどちらで実行するか決める
実行する:入力データを受け取り、モデルの計算をする
結果を出力する:予測の結果や生成した文章を返す
CPU・GPUへの割り当て:Execution Providerの例
ONNX Runtimeでは、Execution Provider(実行先のハードウェアごとの計算処理の集まり)が、計算をどの装置で動かすかを決めます。
ONNX Runtimeの公式ドキュメントの説明では、CUDA(NVIDIA GPU向け)とCPUの順に指定すると、CUDA側に対応する処理がある計算はGPUで、ない計算はCPUで動きます。
ONNX Runtime 1.10以降は、CPU以外で動かす場合、使うExecution Providerを明示的に指定する必要があります。
推論エンジンが推論を速くする主な手法
推論エンジンが推論を速くする代表的な手法は、KVキャッシュの再利用と量子化です。
KVキャッシュは、LLMが文章を生成するときに、それまでの計算結果をGPUメモリに保存しておく領域を指します。量子化は、モデルの数値を少ないビット数で表し、メモリと計算を減らす手法です。
手法 | 公表されている効果 | 条件 |
|---|---|---|
KVキャッシュの再利用(SGLang) | 既存の推論システムと比べ、スループットが最大6.4倍、レイテンシが最大3.7倍改善 | 論文の実験で、特定のモデル・処理内容で出た最大値 |
量子化(TensorRT LLMのFP8) | 16ビット浮動小数点と比べ、性能を2倍に、メモリ消費を半分にできる | NVIDIA H100以降のGPU |
出典:SGLangの論文、NVIDIA「TensorRT LLM Overview」(版情報1.4.0rc3)(2026年11月10日確認)
KVキャッシュの再利用は、複数の生成で共通する入力文の計算を省くため、入力をまとめて処理する段階(prefill)の負担を減らします。
ポイント:
推論エンジンは「読み込み→最適化→割り当て→実行→出力」の流れでモデルを動かします。高速化の数値は、実験条件や対応GPUとセットで読むものです。
主な推論エンジンの種類と例
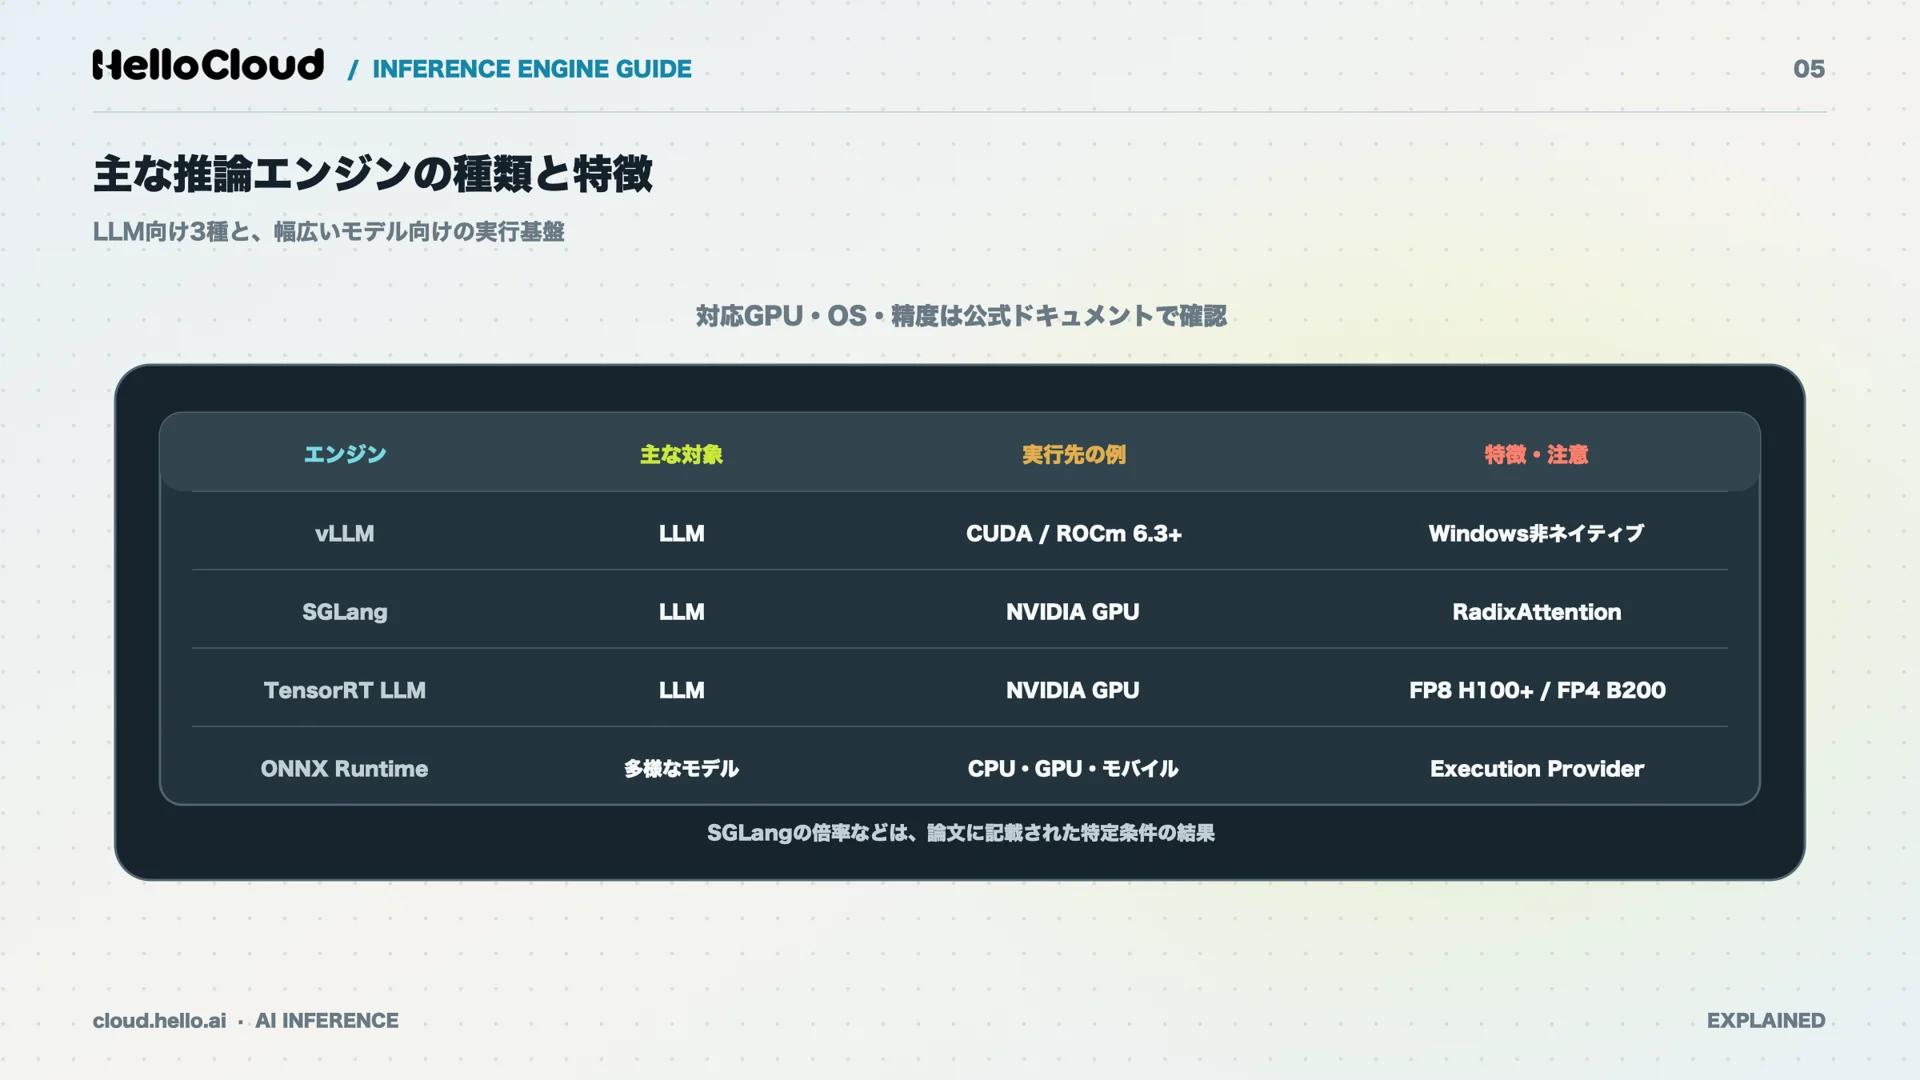
主な推論エンジンは、LLM向けのvLLM・SGLang・TensorRT LLMと、幅広いモデル向けのONNX Runtimeに分けられます。
LLM向けの推論エンジンは、SGLangのRadixAttentionのように、文章を生成するときのKVキャッシュの扱いに工夫があります。ONNX Runtimeの特徴は、CPU・GPU・モバイル向けの実行先がそろっていることです。
LLM向け:vLLM・SGLang・TensorRT LLMなど
vLLM:公式ドキュメントで、LLMの推論と提供(サービング)のためのライブラリと説明されています。インストールのページでは、AMD GPUはROCm 6.3以上に対応し、Windowsにはネイティブ対応していないと書かれています。同時接続数の測り方と100万トークンあたりのコストの計算は、vLLMの使い方の解説で扱っています。
SGLang:KVキャッシュの再利用(RadixAttention)を特徴とし、論文ではスループットが最大6.4倍になった実験結果が示されています。
TensorRT LLM:NVIDIAが公開するオープンソースのライブラリで、NVIDIA GPU上でLLMの推論を高速化します。FP8やFP4での量子化に対応しています。
幅広いモデル向け:ONNX Runtimeなど
ONNX Runtimeは、ONNX形式のモデルを、CPU・GPU・モバイル機器などで動かせる推論エンジンです。公式ドキュメントには、NVIDIA CUDA・NVIDIA TensorRT・AMD MIGraphX・Intel OpenVINO・CoreML(プレビュー版)などの実行先が並んでいます。サーバー向けのGPUと、Android・iOSなどモバイル向けの実行先の両方が用意されています。
比較表:対応ハードウェア・OS・精度・用途
4種の推論エンジンを、公式ドキュメントと論文の記載だけで比べました。
推論エンジン | 主な対象 | 対応ハードウェア | OSの注意点 | 量子化の記載 |
|---|---|---|---|---|
vLLM | LLM | NVIDIA GPU(CUDA)、AMD GPU(ROCm 6.3以上)など | Windowsはネイティブ非対応 | — |
SGLang | LLM | NVIDIA GPU(論文の実験はA10G・A100) | — | — |
TensorRT LLM | LLM | NVIDIA GPU | — | FP8(H100以降)、FP4(B200) |
ONNX Runtime | ONNX形式のモデル | CPU、GPU、モバイル・エッジ | — | — |
出典:vLLM(stable版)、SGLangの論文、TensorRT LLM(版情報1.4.0rc3)、ONNX Runtime(2026年11月10日確認)。「—」は確認した資料に記載がなかった項目です。
ポイント:
LLMならvLLM・SGLang・TensorRT LLM、画像・音声などを多様なハードウェアで動かすならONNX Runtimeが候補です。対応状況は確認日時点のものです。
推論エンジンの選び方
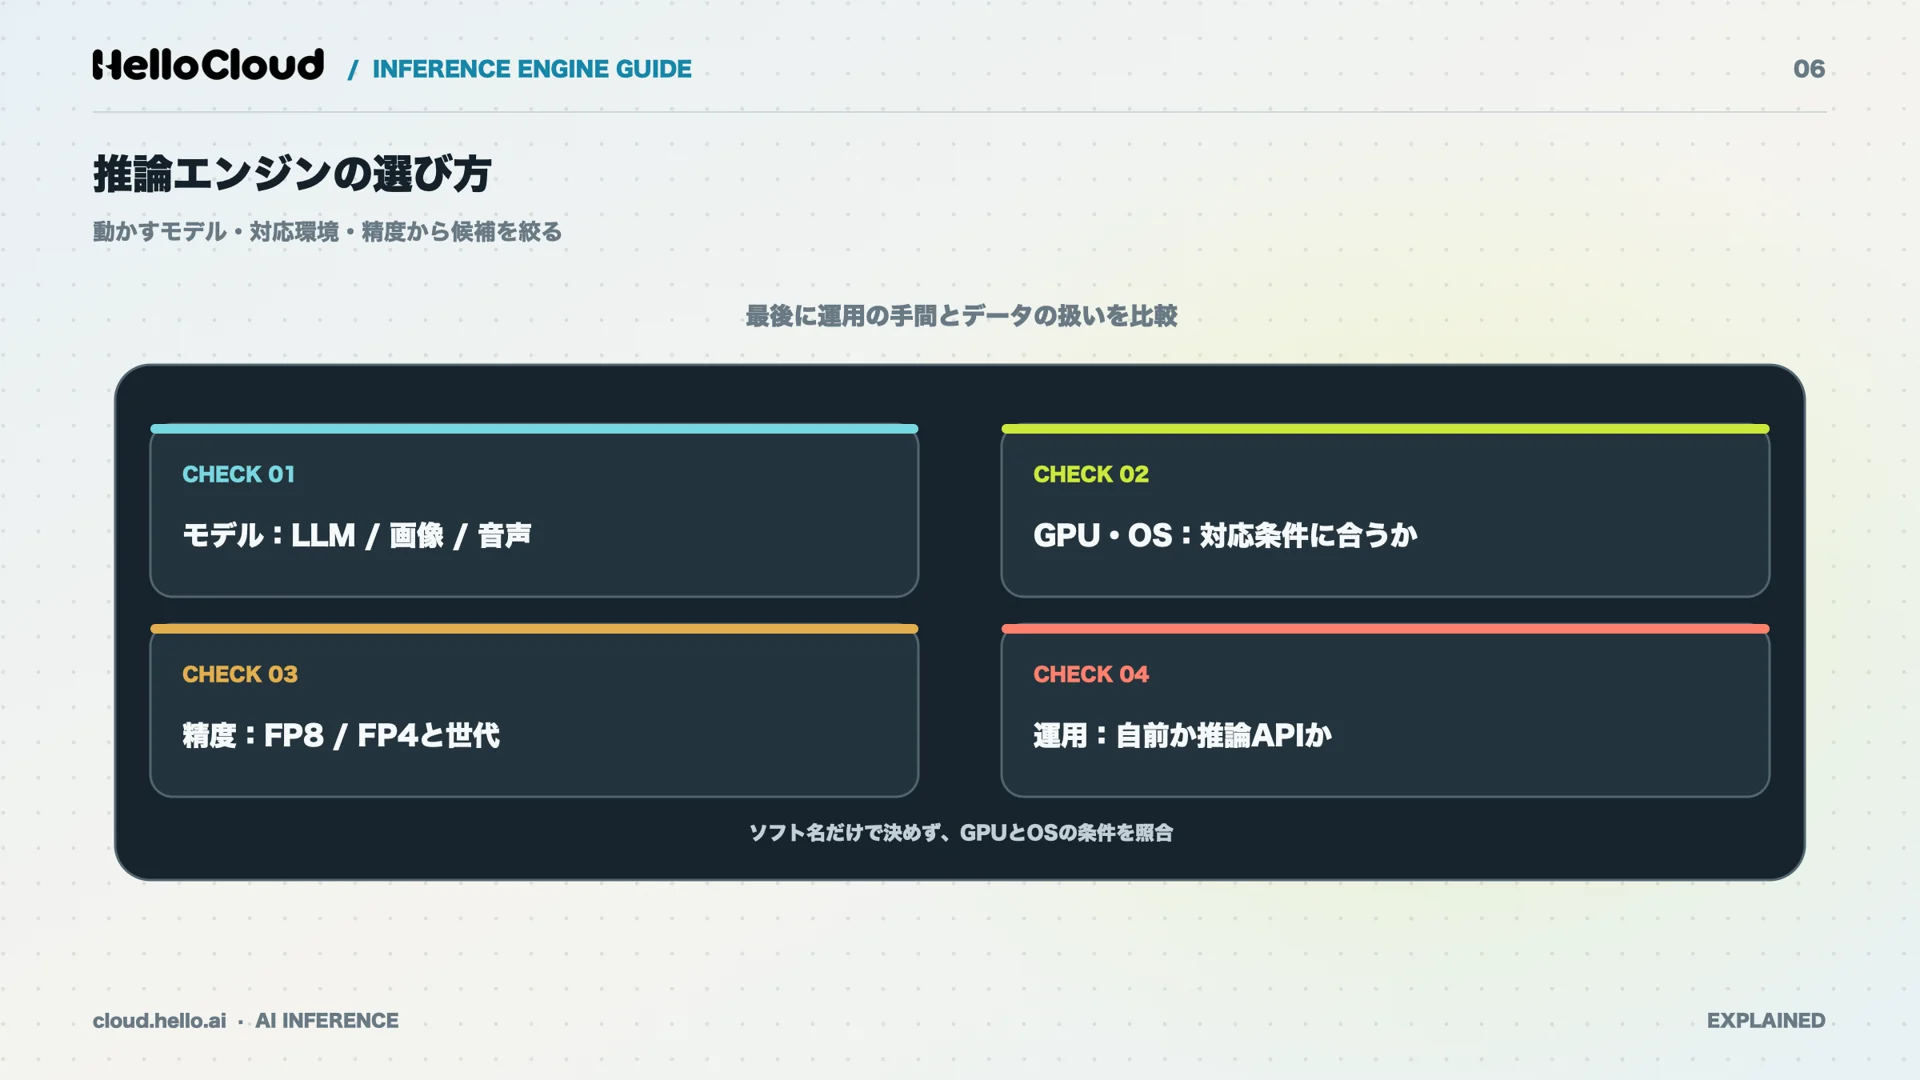
推論エンジンは、動かすモデルの種類、対応するGPU・OS、使える精度の3点で候補を絞り、最後に自分で運用するかを決めると選びやすくなります。
1つでも条件が合わないと、インストールできなかったり、想定した速度が出なかったりするためです。
動かすモデルの種類で選ぶ
LLMを動かすならLLM向けの推論エンジン、画像・音声のモデルや複数のハードウェアで動かすならONNX Runtimeのような推論エンジンが候補になります。ONNX Runtimeを使う場合、モデルはONNX形式で用意するのが前提です。
軽量なモデルを分類の用途で比べた例として、軽量モデルを分類器として比較した検証もあります。
対応するGPU・OSを確認する
推論エンジンごとに、動くGPUとOSは決まっています。vLLMはWindowsにネイティブ対応していないため、Windowsで使うならWSL(Windows上でLinuxを動かす機能)などが必要です。TensorRT LLMの公式ドキュメントは、NVIDIA GPU上での推論を対象にしています。
使える精度とGPUの世代を確認する
量子化でメモリを減らしたいなら、GPUの世代の確認が先です。TensorRT LLMでは、FP8はNVIDIA H100以降、FP4はNVIDIA B200に対応すると公式ドキュメントに書かれています。GPUそのものの選び方は、使うモデルに必要なVRAMの量が出発点です。
自分で動かすか推論APIを使うかを決める
推論エンジンを自分で動かせばモデルや設定を自由に選べますが、GPUの用意や更新の手間がかかります。推論APIなら運用を任せられる一方、モデルは提供者が用意したものから選ぶ形です。入力するデータを社外のAPIに送れるかどうかも、決める前に確認します。
ポイント:
モデルの種類、GPU・OS、精度とGPUの世代を公式ドキュメントで確認し、最後に運用の手間とデータの扱いで、自分で動かすか推論APIを使うかを決めます。
推論エンジンやAPIで動かすLLMを業務に組み込む手順は、AIエージェントの作り方で解説しています。
推論エンジンを使うときの注意点
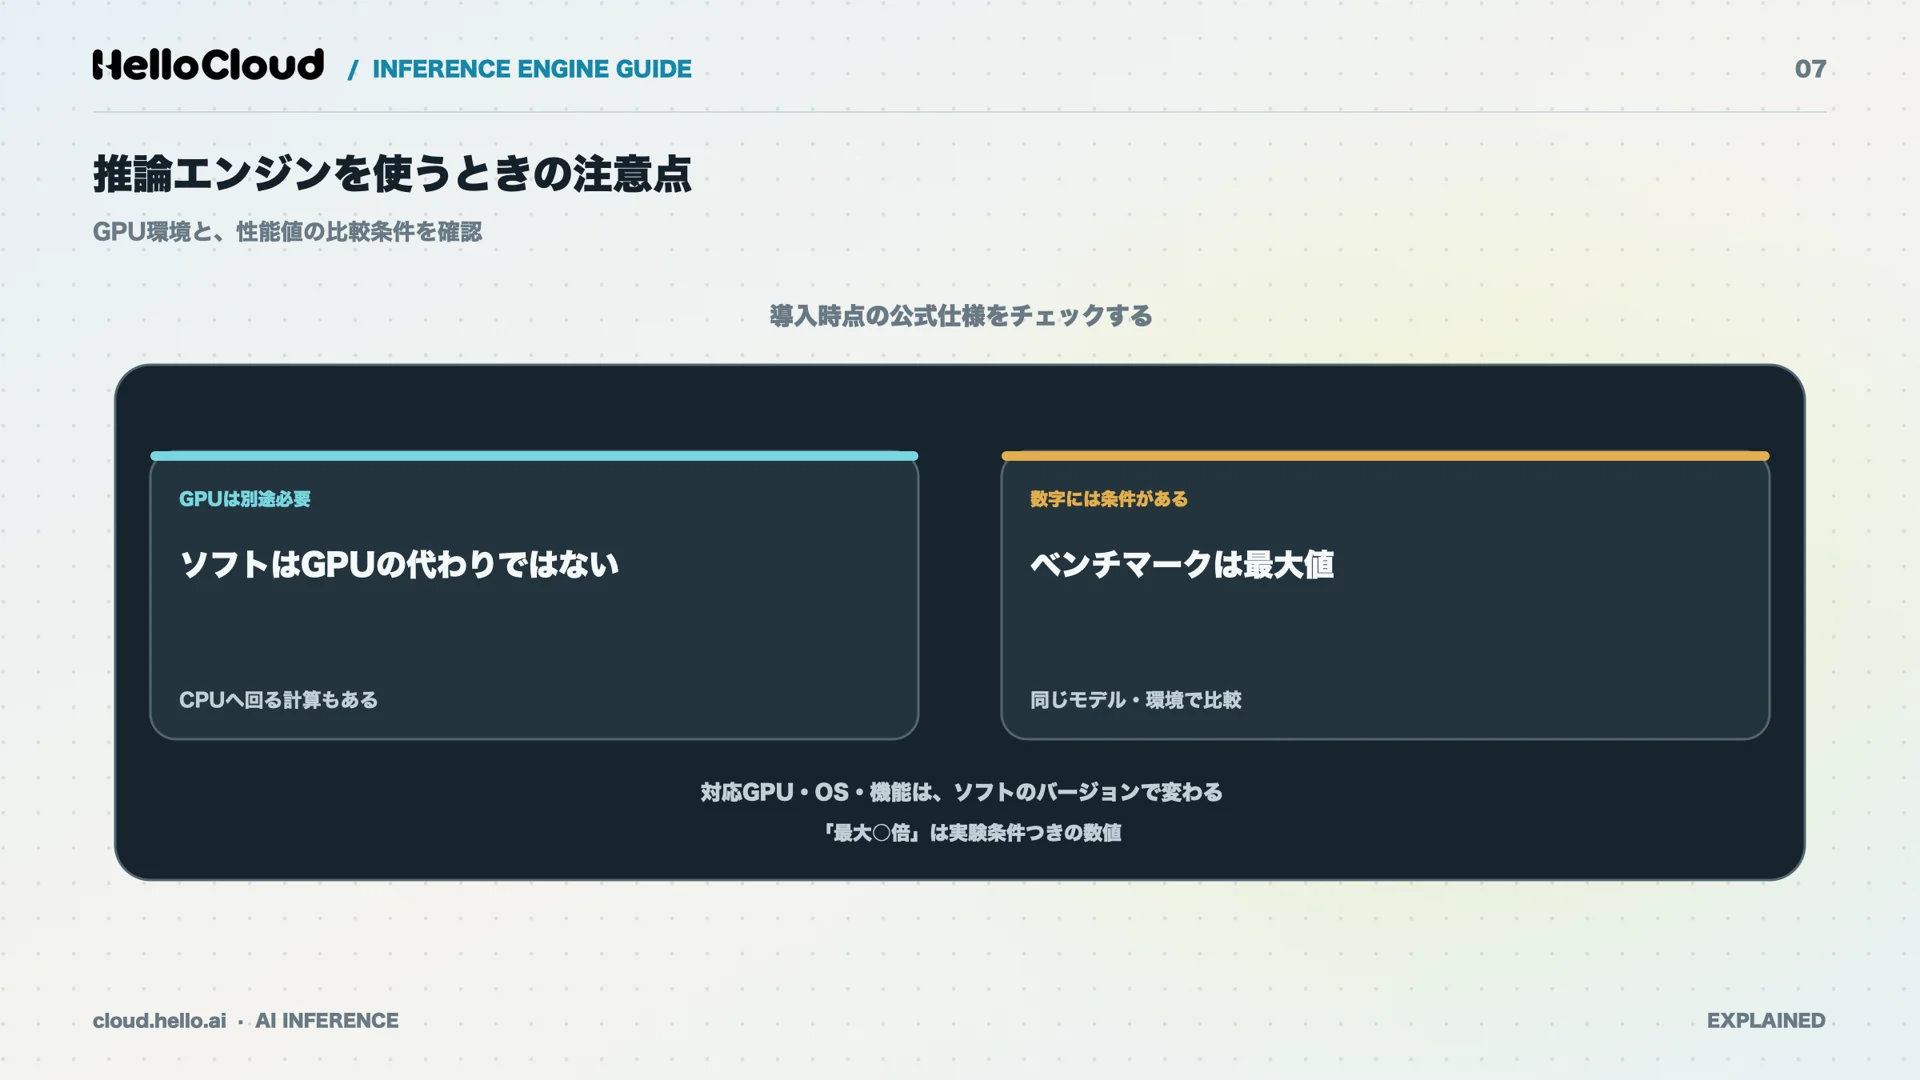
推論エンジンを使うときの注意点は、GPUが必要なことと、性能値や対応状況が条件と版で変わることの2つです。
推論エンジンを使ってもGPUは必要
推論エンジンはGPUを効率よく使うためのソフトウェアで、GPUの代わりにはなりません。
Deloitte(2025年11月)は、長く考えて答える推論には、メールの要約のような単純な推論の100倍以上の計算量がかかると推定しています。
注意:
ONNX Runtimeでは、GPU向けの処理がない計算はCPUで実行されます。GPUで実行する場合より処理に時間がかかる場合があるため、導入前に使うGPUと推論エンジンの対応を確認してください。
性能値と対応状況は条件と版で変わる
SGLangの「最大6.4倍」は論文の実験条件での最大値で、どの環境でも同じ結果になるとは限りません。TensorRT LLMの記載は、2026年11月10日時点の公式ドキュメント(ページ上の版情報は1.4.0rc3)にもとづきます。vLLMの記載もstable版のドキュメントにもとづくため、導入時点の最新版で確かめてください。
ポイント:
推論エンジンはGPUの代わりにはなりません。性能値は実験条件つき、対応状況は版ごとに変わるものとして読みます。
推論エンジンを動かすGPU環境の用意の仕方
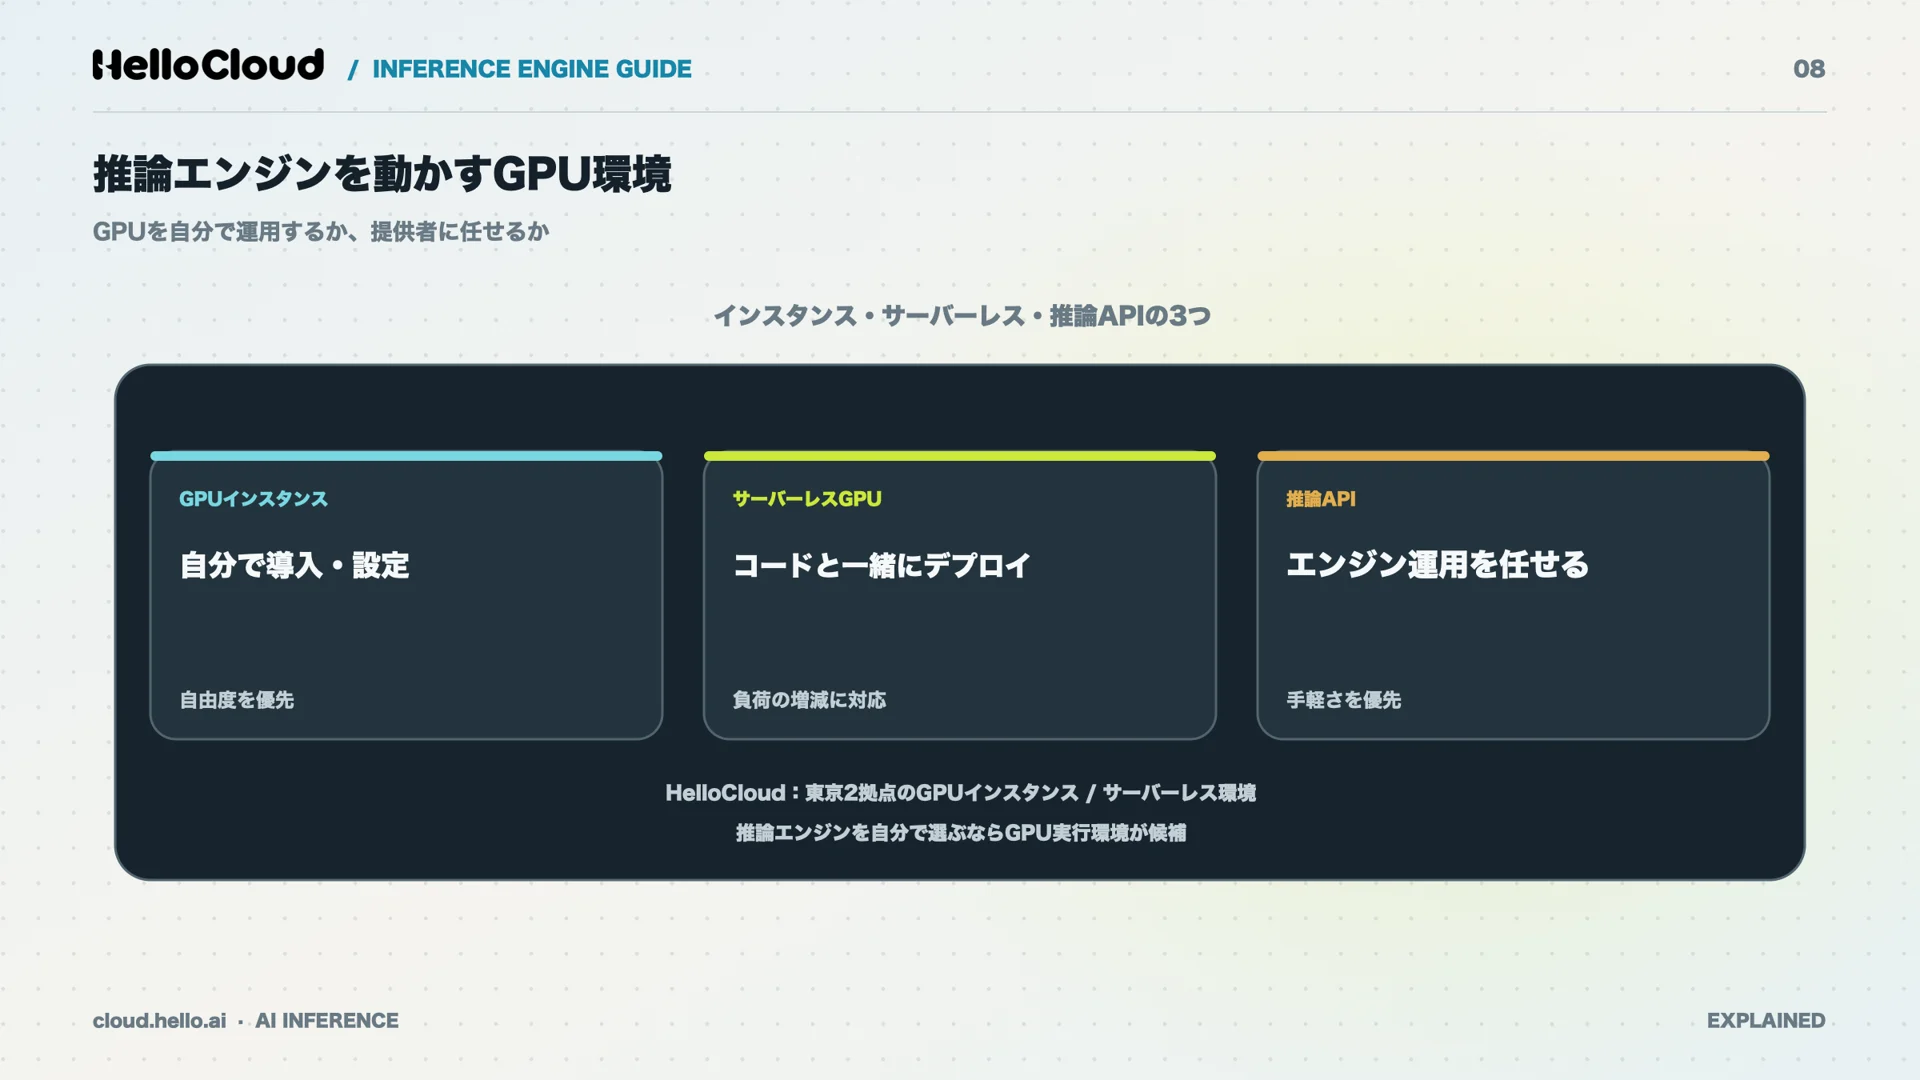
推論エンジンを動かすGPU環境は、GPUインスタンス、サーバーレスGPU実行環境、推論APIの3つの形で用意できます。GPUクラウドの仕組みと使い方は、GPUクラウドの仕組み・使い方・料金を解説した記事で確認できます。
Gartner(2026年8月)の予測では、AI向けに最適化したIaaSの支出は2026年に前年比96.4%増える見込みです。
推論エンジンを動かすのに必要な環境
推論エンジンを動かすには、対応するGPU、モデルが収まるVRAM(GPUのメモリ)、対応するOS、GPUのドライバが必要です。GPUとOSは、使う推論エンジンの対応条件から逆算して決めます。ドライバ・CUDAのバージョンのそろえ方は、GPUクラウドの環境構築の手順で解説しています。
GPUインスタンス・サーバーレス・推論APIの違い
3つの形の違いは、推論エンジンを自分で選べるかどうかです。
用意の仕方 | 推論エンジンの選択 | 向いている使い方 |
|---|---|---|
GPUインスタンス | 自分で入れて選べる | 設定を細かく調整したい |
サーバーレスGPU実行環境 | コンテナイメージに含めて選べる | 負荷の増減が大きい |
推論API | 選べない(提供者が運用) | 運用を任せたい |
国内のGPUクラウドで動かす選択肢:HelloCloud
株式会社HelloCloudの国産GPUクラウド「HelloCloud」は、東京の2拠点でGPUインスタンスとサーバーレスGPU実行環境を提供しています。GPUインスタンスはRTX 6000(VRAM 96GB、¥380/時間)とB300(VRAM 288GB、¥1,480/時間)の2種類です。料金は1インスタンスあたりの参考価格で、税込・税別の記載はありません。
サーバーレスGPU実行環境では、コードにGPUの種類と枚数を書いて「supa deploy」コマンドでデプロイすると、指定したGPUでコンテナが起動します。
ZDR推論APIは、OpenAI SDKのまま接続先のURL・APIキー・モデル名を差し替えて使え、プロンプトと生成結果を保存しない方針です。モデルによっては所在国を特定できない分散GPUで処理するため、国内で完結させたい場合はGPUインスタンスかサーバーレスGPU実行環境を選びます。
HelloCloudの公式サイトでは、株式会社ラス恋の導入事例が紹介されています。
ラス恋は会員の個人情報を扱うため、推論も国外のサーバーに出せない前提でした。処理を国内に閉じられる点が決め手になり、レコメンドのモデルを本番に載せています。
ポイント:
推論エンジンを自分で選ぶならGPUインスタンスかサーバーレスGPU実行環境、運用を任せるなら推論APIが候補です。データをどこで処理するかも、選ぶ基準の1つです。
国内のGPUで推論エンジンを動かす環境を検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。LLM推論・モデル学習・バッチ処理での活用方法も紹介しています。
資料請求(HelloCloudの特徴と料金)
推論エンジン(inference engine)のよくある質問
inference engineの日本語訳は?
inference engineの日本語訳は「推論エンジン」です。AI・LLMの分野では学習済みモデルを動かすソフトウェアを、エキスパートシステムの分野では規則から結論を導く仕組みを指す言葉です。
推論エンジンは無料で使える?
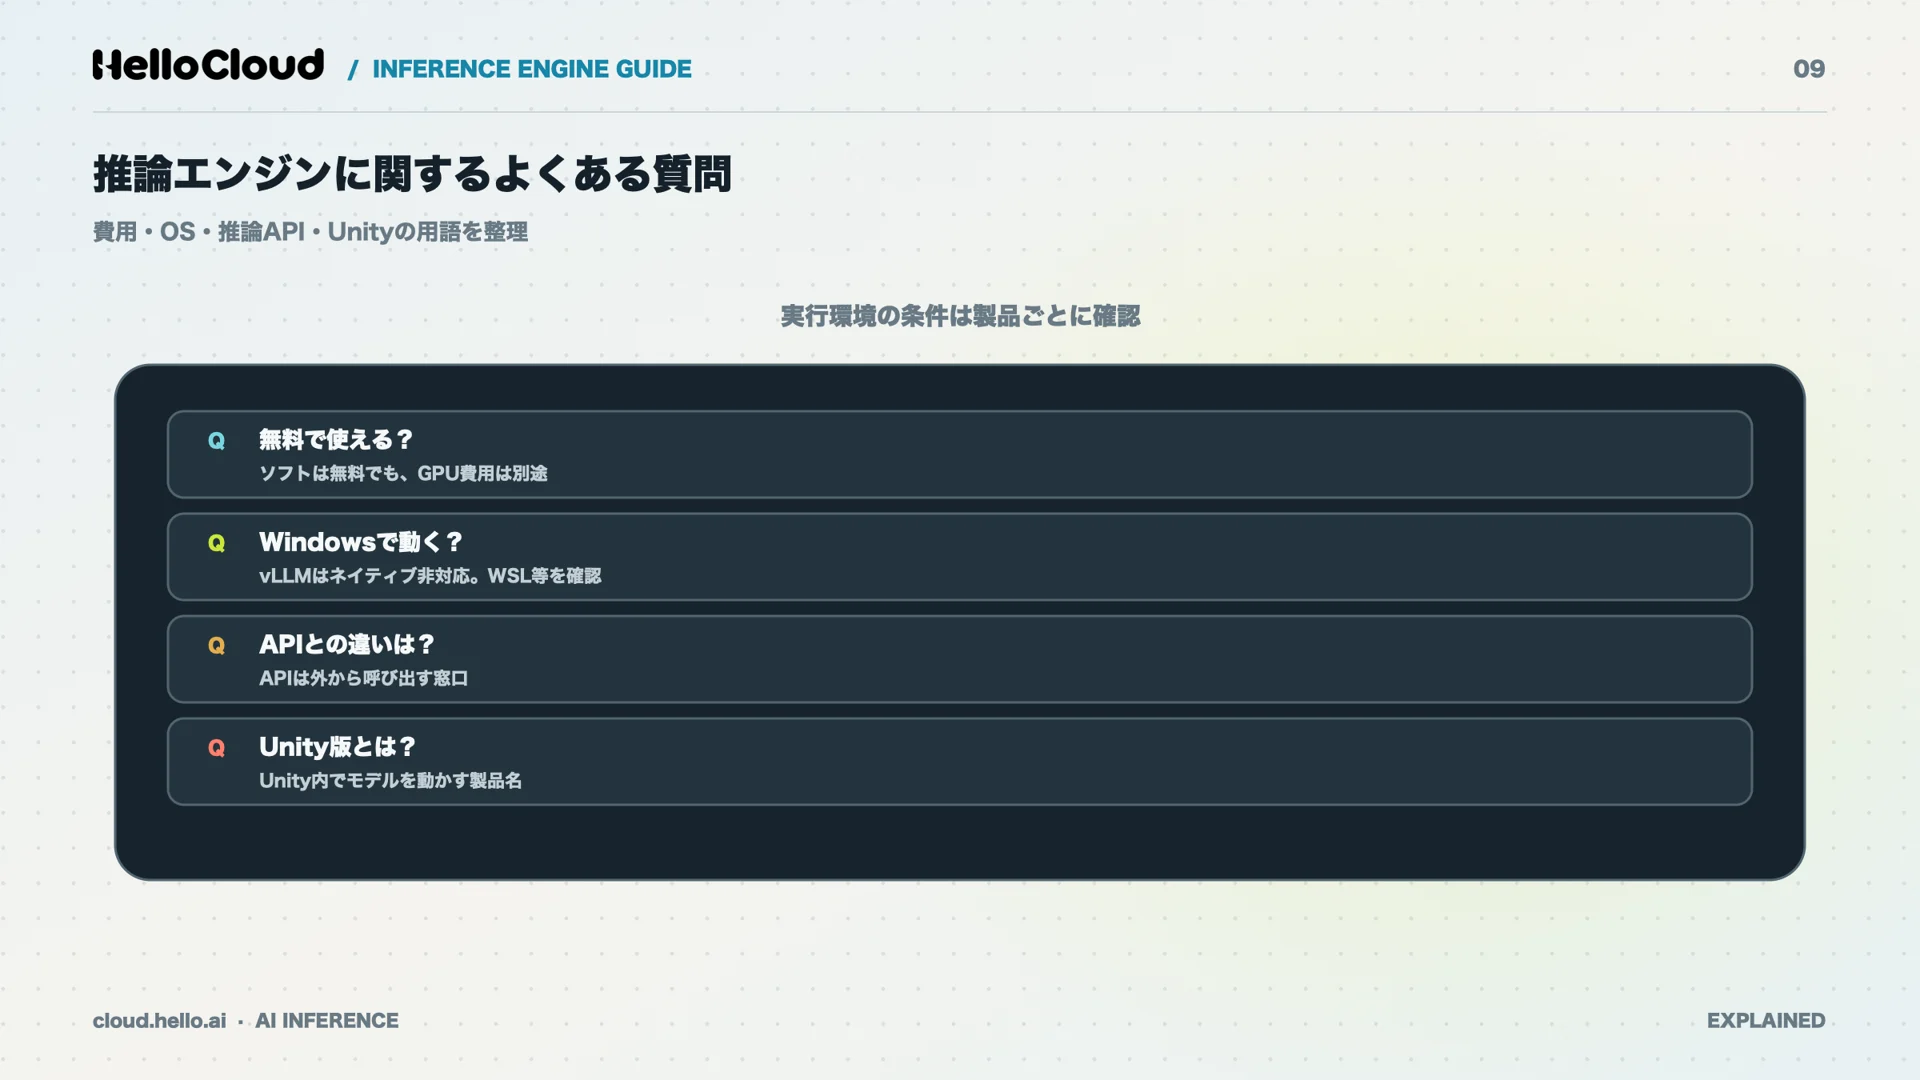
無料で入手できるオープンソースの推論エンジンはあります。TensorRT LLMはNVIDIAが公開するオープンソースのライブラリで、SGLangもソースコードが公開されています。ただし、動かすためのGPUの費用は別途必要です。
推論エンジンはWindowsで使える?
推論エンジンによって異なり、vLLMはWindowsにネイティブ対応していません。vLLMの公式ドキュメントでは、WSLなどを使う方法が案内されています。Windowsで動かす予定があるなら、導入前に対応OSを公式ドキュメントで確認してください。
Unityの「Inference Engine」とは?
Unityの「Inference Engine」は、Unityの中で機械学習モデルを動かすための推論ライブラリの製品名です。
Unityの公式ドキュメントによると、パッケージ名はcom.unity.ai.inferenceです。ONNX形式の多くのモデル(opsetバージョン7〜15)に対応し、学習済みのニューラルネットワークをUnityのアプリでCPUやGPUを使ってリアルタイムに動かせます。
まとめ:推論エンジンの理解から実行環境選びへ
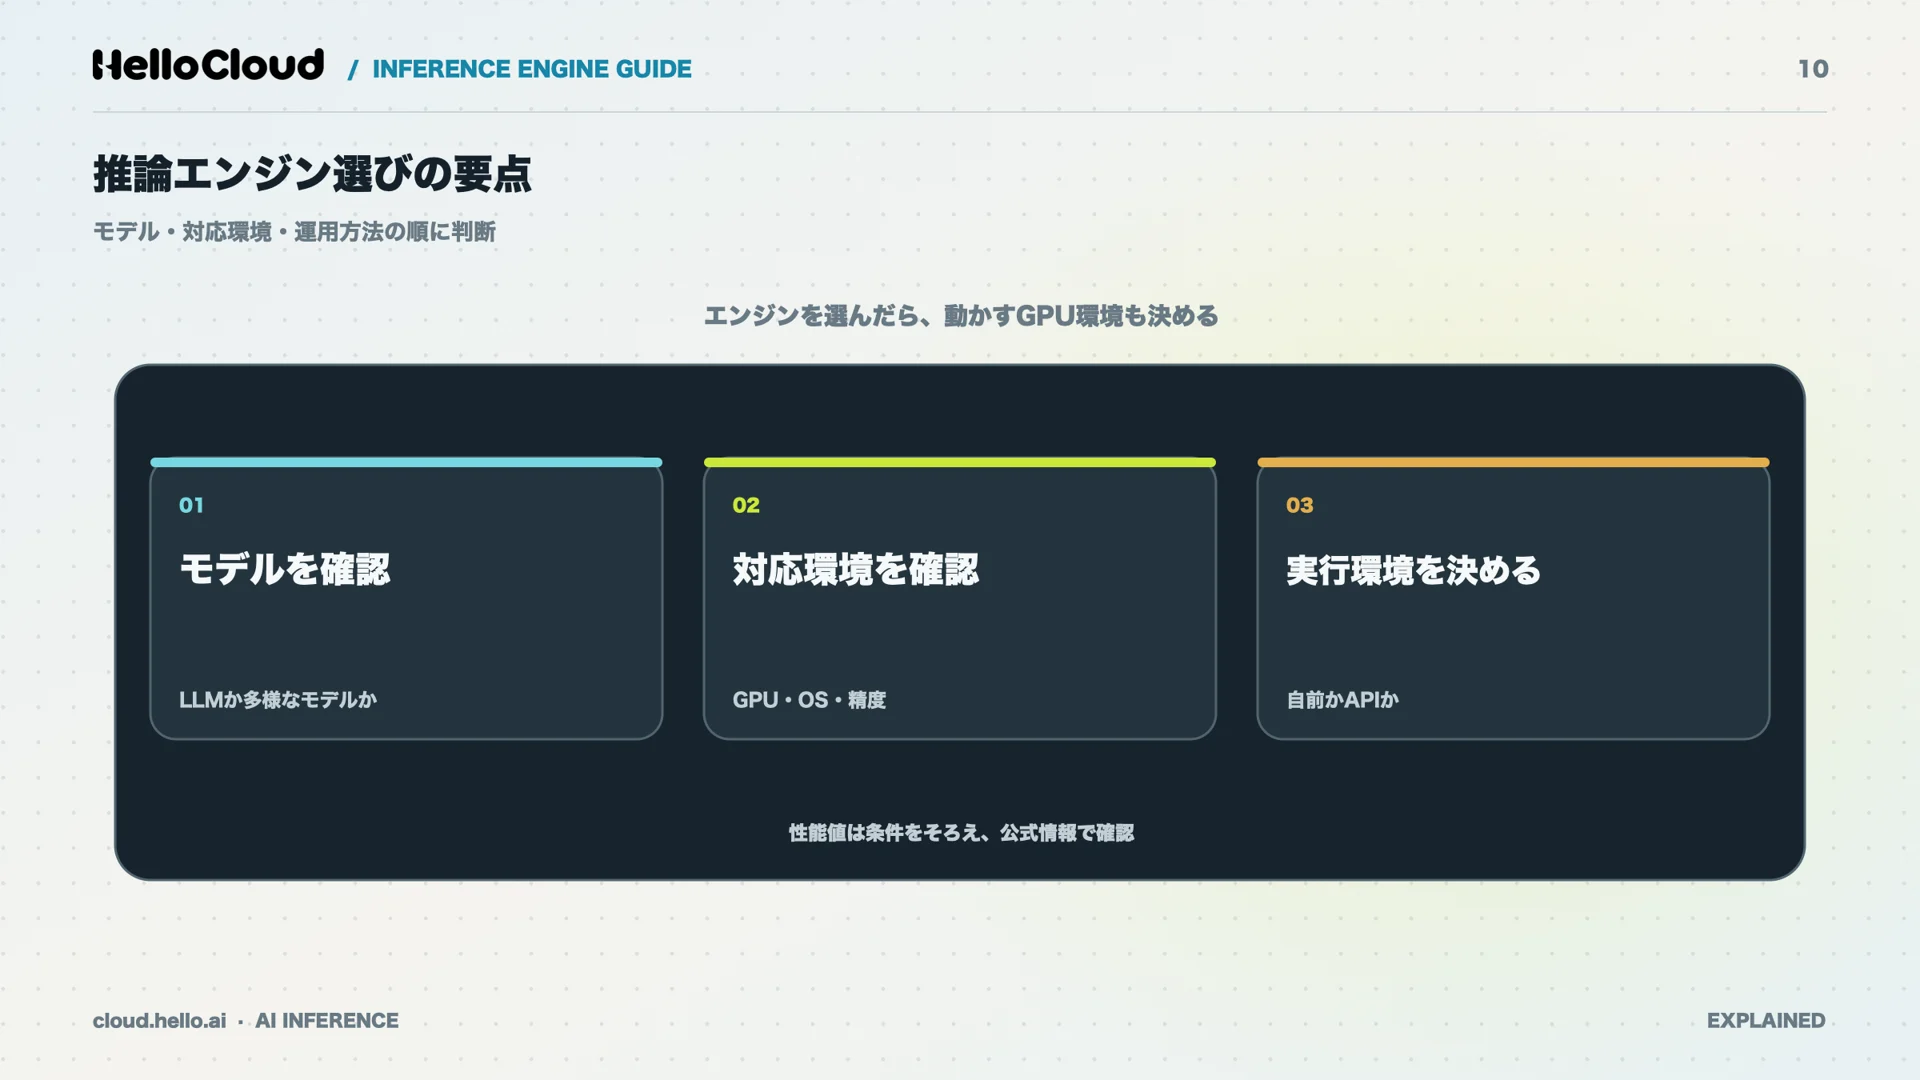
推論エンジンは、学習済みのAIモデルをGPUなどで効率よく実行するソフトウェアです。
LLM向けにはvLLM・SGLang・TensorRT LLM、幅広いモデル向けにはONNX Runtimeがある
モデルの種類、対応GPU・OS、精度とGPUの世代を公式ドキュメントで確認して選ぶ
推論エンジンを使ってもGPUは必要で、性能値は条件つきで読む
次の作業は、選んだ推論エンジンの条件に合うGPU環境を決めることです。
推論エンジンを動かすGPU環境をこれから決める方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。HelloCloudは従量課金で初期費用がかからず、申し込みの当日からGPUを使えます。
資料請求(HelloCloudの特徴と料金)
参考文献
Zheng et al.「SGLang: Efficient Execution of Structured Language Model Programs」(第38回NeurIPS、NeurIPS 2024)2024年
総務省「令和8年版 情報通信白書」第Ⅰ部 第2章 第1節 図表Ⅰ-2-1-1 2026年7月
Gartner「Gartner Forecasts Worldwide AI-Optimized IaaS Spending to Grow 96% Through 2026」2026年8月
Deloitte「Technology, Media & Telecommunications Predictions 2026」(AI計算資源の章)2025年11月
NVIDIA「TensorRT LLM Overview」(ページ上の版情報1.4.0rc3)2026年11月10日確認
ONNX Runtime「Execution Providers」2026年11月10日確認
ONNX Runtime「Python API Summary」2026年11月10日確認
vLLM「vLLM公式ドキュメント」(stable版)2026年11月10日確認
vLLM「GPU Installation」(stable版)2026年11月10日確認
PyTorch 公式サイト 2026年11月10日確認
TensorFlow 公式サイト 2026年11月10日確認
Unity「Inference Engine overview」(パッケージ2.2.2)2026年11月10日確認
株式会社HelloCloud「HelloCloud 公式サイト」(導入事例を含む)2026年11月10日確認
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


