最終確認日:2026年11月17日
この記事の結論
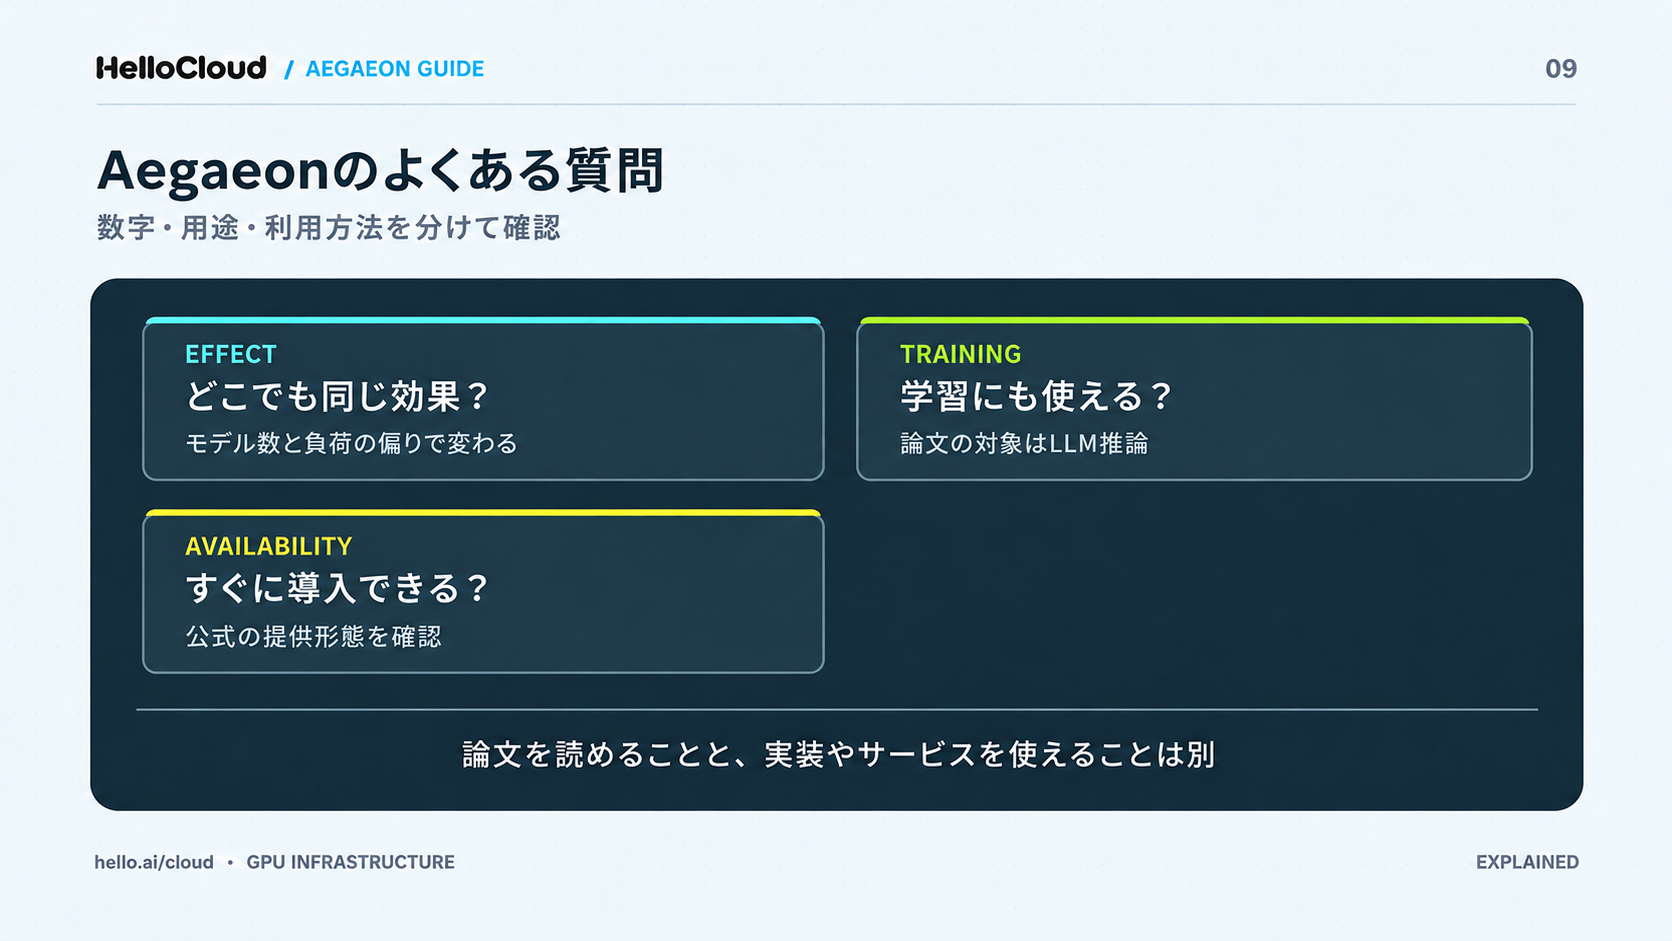
82%削減はAlibaba Cloudの本番環境での値で、どこでも同じだけ減るわけではありません。Aegaeonは推論向けの技術で、学習のコストは下げません。
Aegaeonとは?Alibabaと北京大学のGPU共有技術
Aegaeonは、2025年10月の国際会議SOSP '25で発表された論文のシステムです。北京大学のSchool of Computer ScienceとAlibaba Groupの研究者が開発し、Alibaba Cloudのモデル提供サービスで運用されました。
Aegaeonの論文と発表の場(SOSP '25)
Aegaeonの論文名は「Aegaeon: Effective GPU Pooling for Concurrent LLM Serving on the Market」です。論文はACM SIGOPS 第31回 Symposium on Operating Systems Principles(SOSP '25)で発表されました。会期は2025年10月13〜16日、開催地は韓国・ソウルです(出典:Aegaeonの論文、2025年10月)。
複数のLLMでGPUを共有して推論するシステム
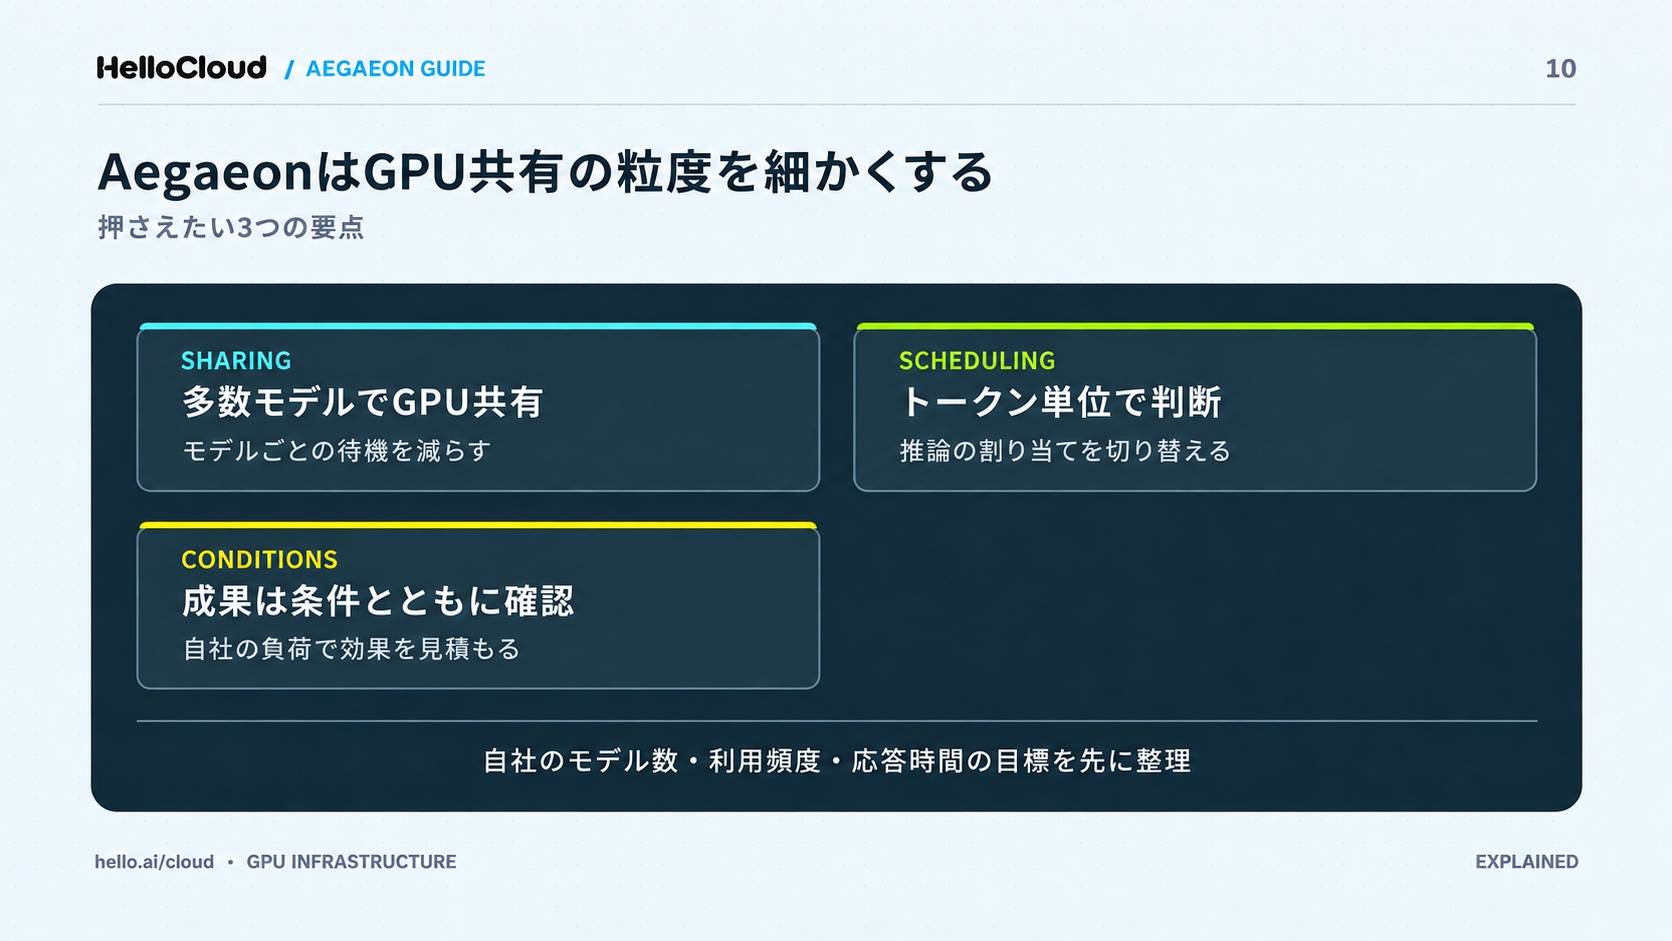
Aegaeonは、多数のLLMを少ないGPUで同時に提供するためのマルチモデル推論システムです。複数のモデルでGPUを共有し、どのモデルにGPUを使わせるかをトークン1つごとに判断します。論文では、GPU1基で最大7モデルを扱えたとしています。
「GPU 82%削減」はどこで出た数字か
82%削減は評価実験ではなく、Alibaba Cloud Model Studioでのベータ運用で出た数字です。数十のモデルの提供に必要なH20が、1,192基から213基に減りました。
ポイント:
Aegaeonは2025年10月に発表された推論システムで、82%削減は本番環境での結果です。
Aegaeonが解決する問題:なぜGPUが無駄になるのか
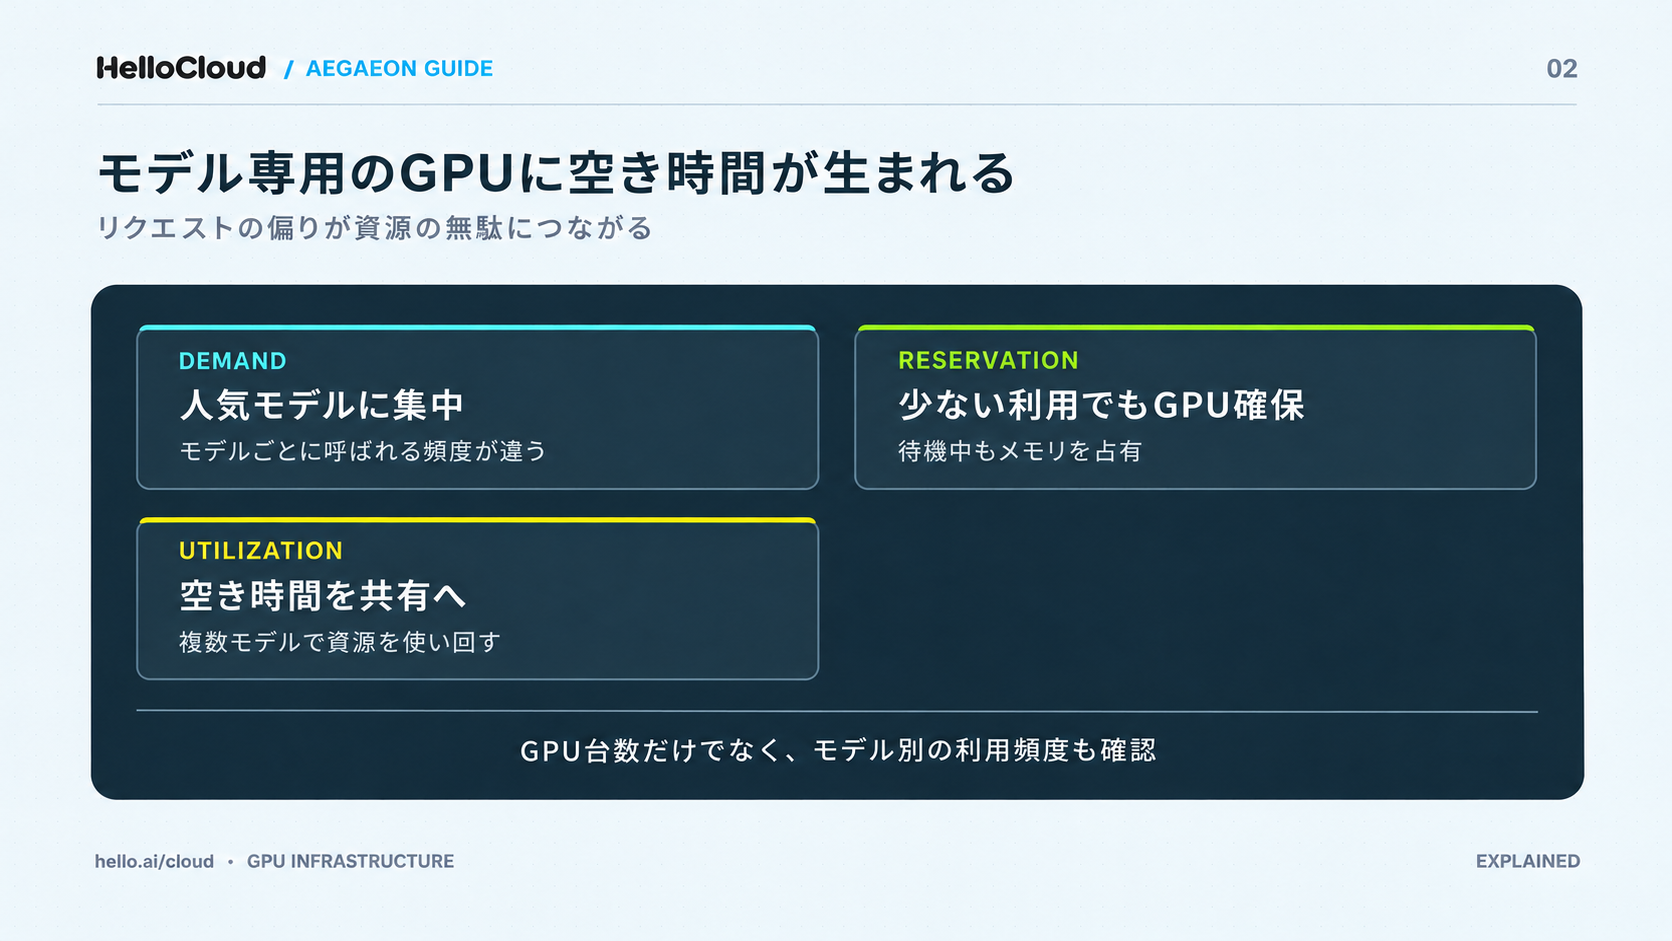
Alibaba Cloudでは、GPUの17.7%を、全リクエストの1.35%を処理するためだけに確保していました。Aegaeonの論文は、モデルごとにGPUを専用で割り当てるやり方の無駄を、この偏りから示しています。
リクエストは一部の人気モデルに集中する
論文によると、Alibaba Cloudのモデルマーケットでは、779モデルのうち94.1%のモデルが受けたリクエストは全体の1.35%でした。集計の対象は1億6,760万リクエスト、GPUは約3万基です(出典:Aegaeonの論文、2025年10月)。論文の執筆時点で、Hugging Faceには100万を超えるモデルが公開されていて、モデルが増えるほど、たまにしか呼ばれないモデルも増えます。
1モデル1GPUでは、GPUの多くが待機する
利用の少ないモデルにもGPUを専用で割り当てると、GPU1基あたりの処理は平均0.2リクエスト/秒未満にとどまります。リクエストがない間も、モデルはGPUのメモリを占めたままです。GPUの台数は多いのに、実際に計算している時間は短いままです。
既存のGPU共有でも扱えるモデル数に限りがあった
複数のモデルでGPUを共有する方法は以前からありましたが、論文によると、1GPUで扱えるのは最大2〜3モデルでした。GPUプーリングやサーバーレスの仕組みを使っても、2〜3モデルではGPUを使い切れないと論文は指摘しています。
ポイント:
GPUの無駄は、利用の少ない多数のモデルにGPUを専用で割り当てることから生まれます。Alibaba Cloudでは、GPUの17.7%が1.35%のリクエストのために確保されていました。
Aegaeonの仕組み:トークン単位でGPUを切り替える
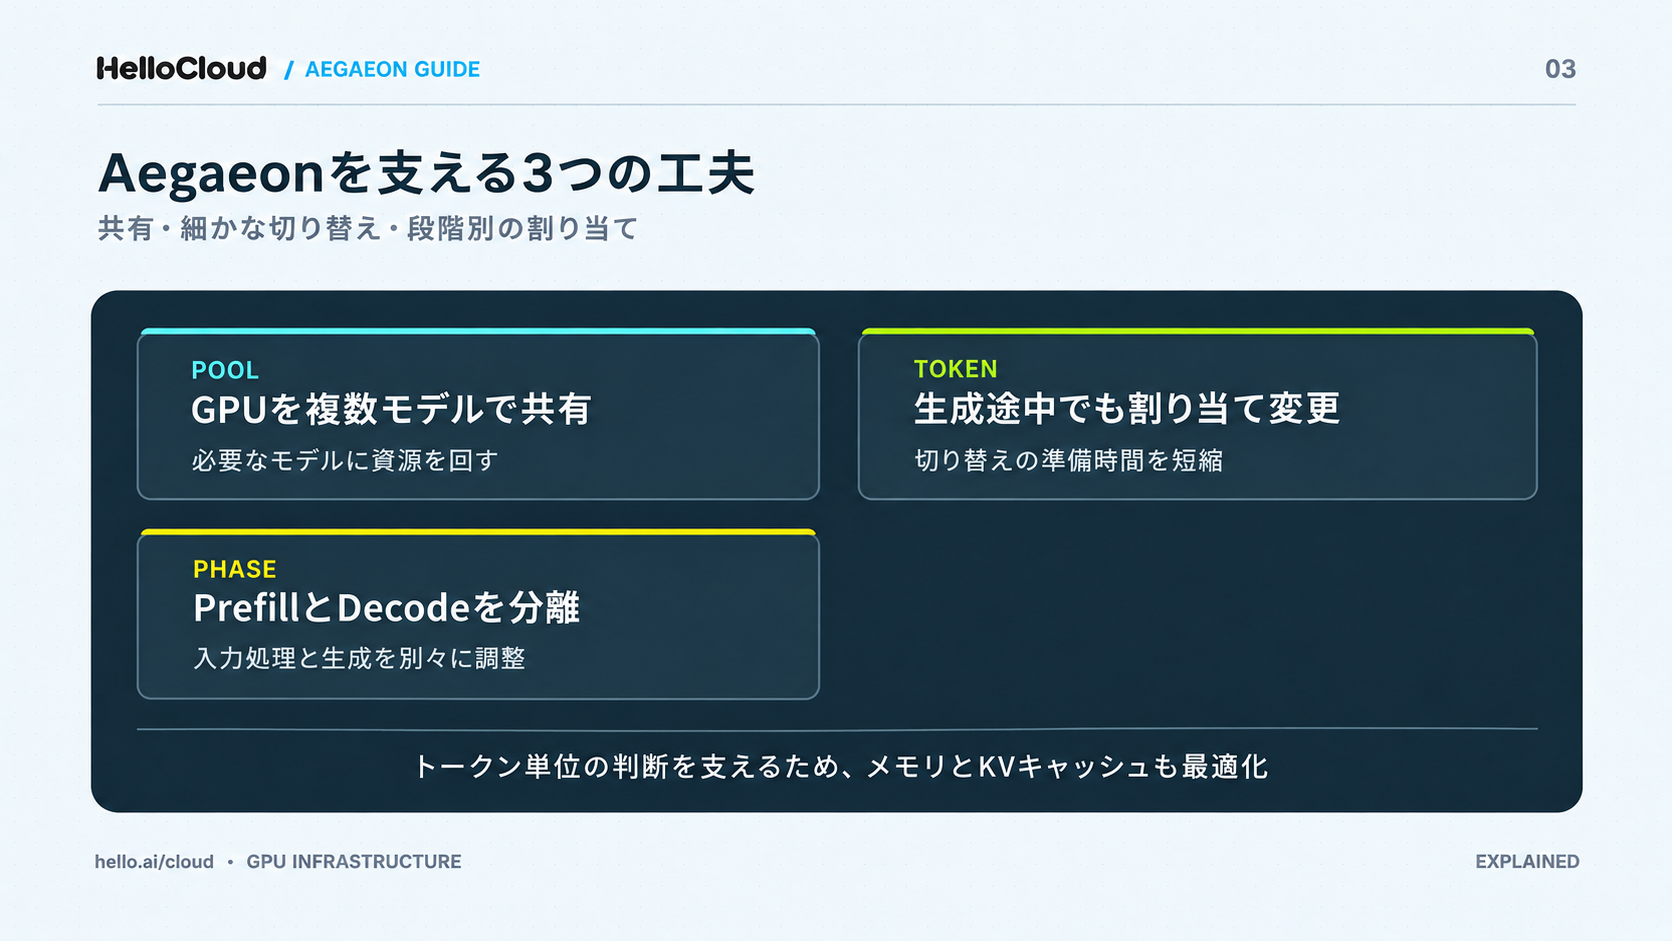
Aegaeonは、GPUを複数のモデルで共有し、どのモデルにGPUを使わせるかをトークン1つごとに決めます。ここでは、GPUプーリング、トークン単位の切り替え、PrefillとDecodeの分離、切り替え時間の短縮の4つに分けて説明します。
GPUプーリング:複数モデルでGPUをまとめて使う
GPUプーリング(GPU pooling)とは、複数のモデルでGPUをまとめて共有して使うやり方です。モデルごとにGPUを固定しないため、リクエストが届いたモデルに空いているGPUを回せます。Aegaeonは、共有したGPUのまとまり(GPUプール)の上で、多数のモデルの推論を動かす仕組みです。
リクエスト単位ではなくトークン単位で切り替える
LLMは、トークン(単語や文字の断片)を1つずつ生成して文章を出力します。リクエスト単位でGPUを割り当てる方法では、1つのモデルが長い応答を生成している間、ほかのモデルへのリクエストは待たされやすくなります。
Aegaeonは、リクエストのスケジューリングと自動スケーリングの判断を、トークンごとに行う設計です(出典:Aegaeonの論文)。自動スケーリングとは、負荷に合わせてモデルにGPUを割り当てたり外したりすることです。1つのGPUの上で、複数のモデルの生成を細かく入れ替えながら進められるのが利点です。
PrefillとDecodeを分けて割り当てる
LLMの推論は、入力全体をまとめて処理するPrefillと、出力を1トークンずつ作るDecodeの2段階に分かれます。Aegaeonは、Prefill用とDecode用のGPUを分け、段階ごとに別のスケジューリングを行います(出典:Aegaeonの論文 第4章)。PrefillとDecodeの特性の違いを生かして計算資源を共有する考え方は、MuxServeの論文(ICML 2024)でも示されています。
切り替えの待ち時間を97%削減した工夫
トークンごとにモデルを入れ替えると、切り替えのたびに準備の時間がかかります。論文によると、Aegaeonは部品の再利用、メモリの明示的な管理、KVキャッシュの細かい同期で、自動スケーリングのオーバーヘッドを97%削減しました。KVキャッシュとは、生成の途中結果をGPUメモリに保持したものです。
ポイント:
Aegaeonの中心は、GPUを共有し、モデルの割り当てをトークンごとに切り替える仕組みです。切り替えのオーバーヘッドを97%減らしたことで、細かい入れ替えが実用的になりました。
Aegaeonの成果:GPU 82%削減の数値と前提条件
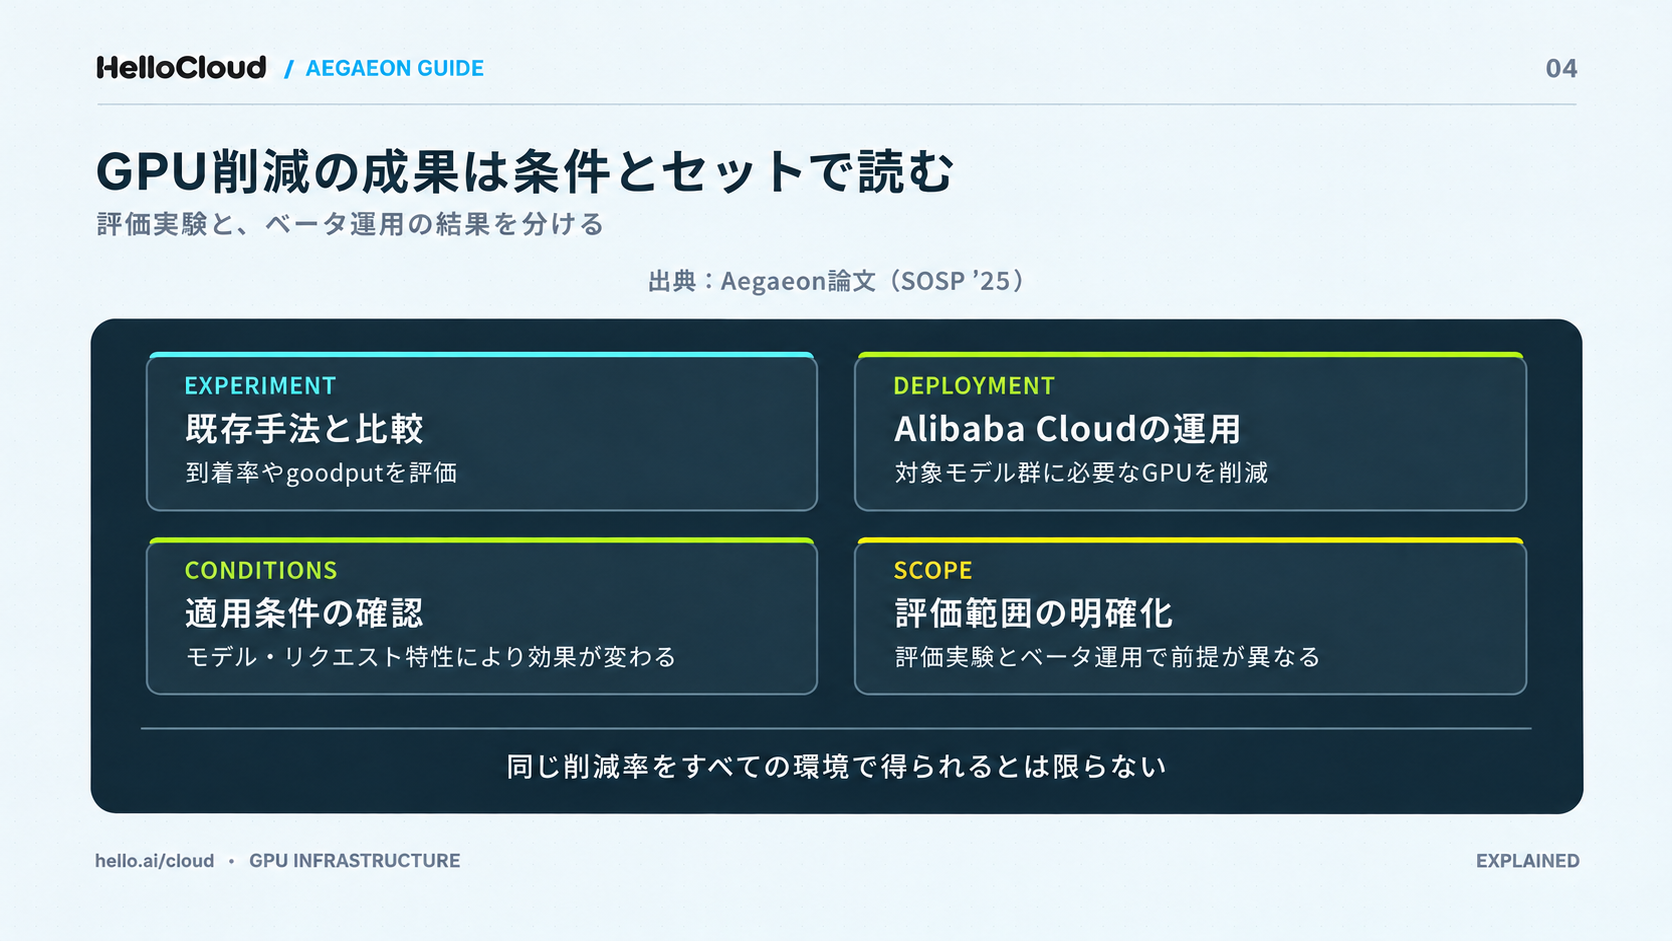
Aegaeonの成果は、論文の評価実験と、Alibaba Cloudでの本番運用の2種類です。82%削減は本番運用の値で、評価実験の数値とは条件が違います。2種類を分けて読めば、数字の意味を取り違えずに済みます。
評価実験の結果(2〜2.5倍、または1.5〜9倍)
論文の評価実験では、Aegaeonは既存の方法と比べて、受けられるリクエストの到着率が2〜2.5倍、またはgoodputが1.5〜9倍になりました。goodputとは、応答時間の目標(SLO)を満たしたうえで処理できた量のことです。「2〜2.5倍」と「1.5〜9倍」は論文で「または」で並べられていて、2つが同時に出るという意味ではありません。
本番運用の結果(H20を1,192基→213基)
論文によると、AegaeonはAlibaba Cloud Model Studioで3か月以上ベータ運用されました。対象は47モデルで、内訳は1.8〜7Bのモデルが28、32〜72Bのモデルが19です。必要なH20は1,192基から213基に減り、GPUの平均利用率は13.3〜33.9%から48.1%に上がりました。
指標 | 数値 | 条件 |
|---|---|---|
必要なGPUの台数 | NVIDIA H20 1,192基→213基(82%削減) | 本番運用 |
GPUの平均利用率 | 13.3〜33.9%→48.1% | 本番運用 |
対象モデル | 47モデル(1.8〜7Bが28、32〜72Bが19。32〜72BはGPU4基に分けて実行) | 本番運用 |
運用期間 | 3か月以上(ベータ運用) | 本番運用(Alibaba Cloud Model Studio) |
自動スケーリングのオーバーヘッド | 97%削減 | 評価実験 |
受けられるリクエスト到着率/goodput | 2〜2.5倍、または1.5〜9倍 | 評価実験(既存の方法との比較) |
GPU1基で扱えるモデル数 | 最大7モデル | 論文の記載 |
出典:Xiang et al.「Aegaeon: Effective GPU Pooling for Concurrent LLM Serving on the Market」(2025年10月、2026年11月17日確認)
数字を読むときの注意点
82%は、Alibaba Cloudが自社のモデルマーケットで得た結果です。論文の出発点は、利用の少ないモデルが多いという偏りでした。自社で動かすLLMが数個だけの場合や、どのモデルにも常にリクエストが来ている場合は、同じだけGPUが減るとは限りません。
ポイント:
82%削減は本番運用の値で、評価実験の「2〜2.5倍、または1.5〜9倍」とは条件が違います。どちらも論文の著者(北京大学とAlibaba Group)が示した数字です。
Aegaeonとvllmなど既存の手法との違い
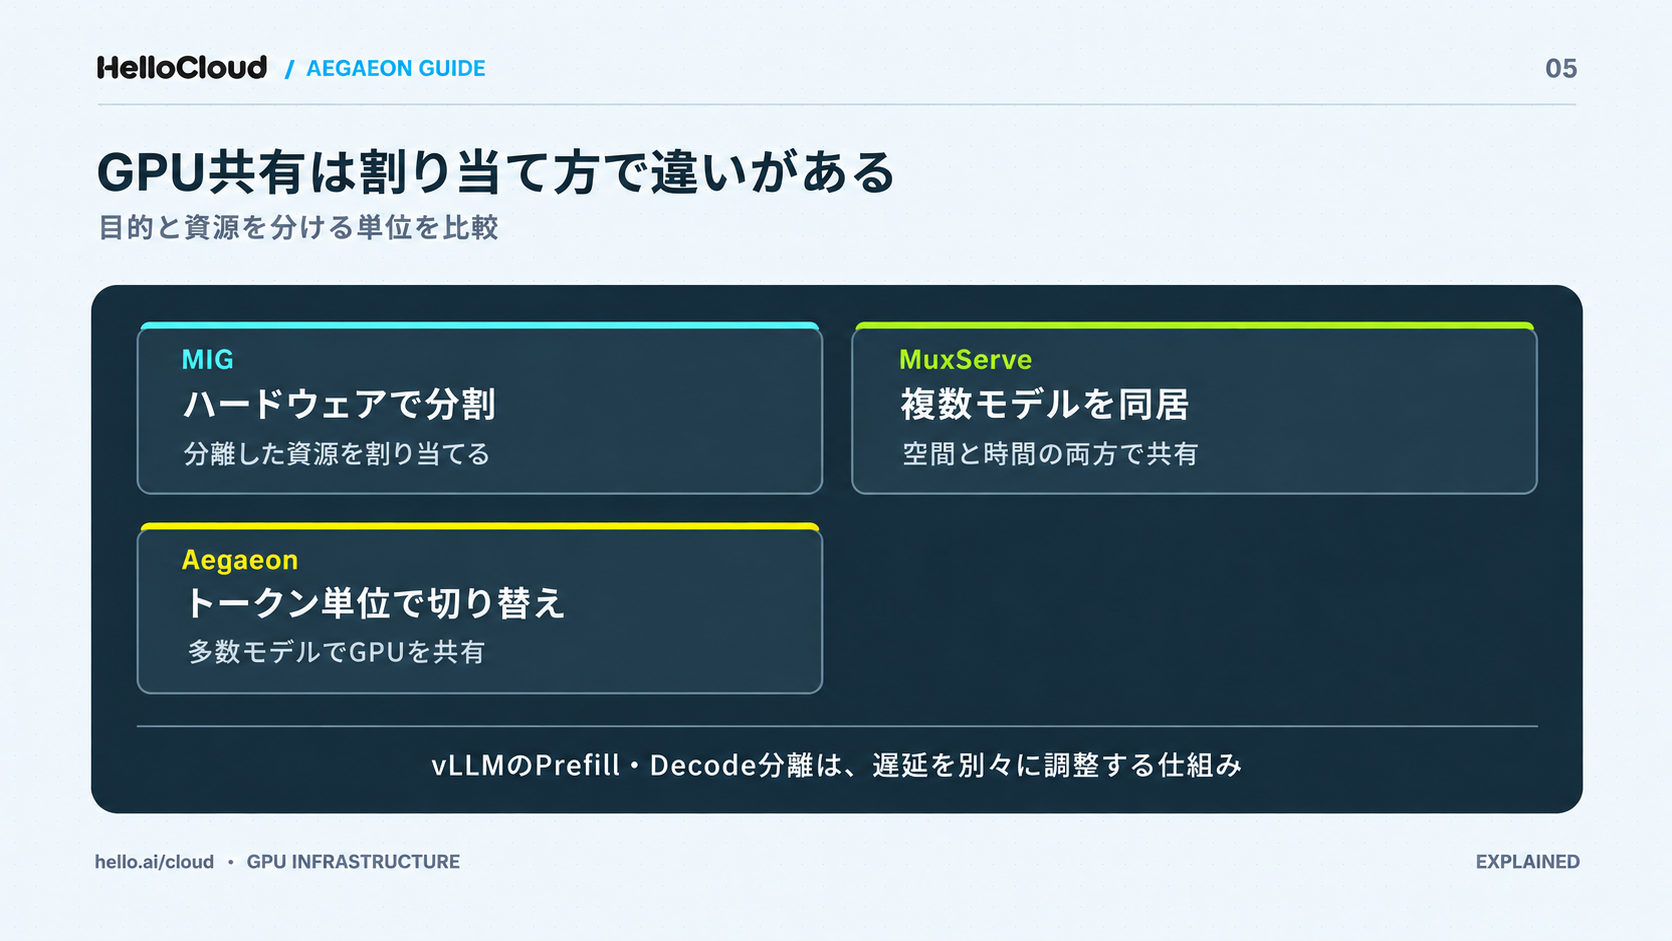
Aegaeonとほかの手法の違いは、GPUを「どの単位で分けて使うか」にあります。MIGはハードウェアで、ServerlessLLMはモデル単位の読み込みで、MuxServeはモデルの同居でGPUを使い分けます。Aegaeonは、トークン単位で割り当てを切り替える方式です。
GPUを「どの単位で分けるか」で比べる
手法 | GPUを分ける単位 | 主な目的 | 公表されている効果 |
|---|---|---|---|
MIG(NVIDIA) | ハードウェアで1つのGPUを最大7インスタンスに分割 | 複数のユーザーや処理に、分離したGPU資源を割り当てる | 各インスタンスで、演算資源とメモリの経路が分離される |
ServerlessLLM | モデル単位で、必要なときにGPUサーバーへ読み込む | サーバーレス推論の遅延を減らす | 遅延を10〜200倍削減(2024年の値) |
MuxServe | 複数のモデルを同じGPUに同居させ、空間・時間の両方で多重化 | 人気の違う複数のLLMでGPUを使い切る | スループット最大1.8倍、または2.9倍のリクエストを処理(2024年の値) |
vLLMのPrefill・Decode分離 | Prefill用とDecode用のインスタンスを分ける | 最初のトークンまでの時間とトークン間の遅延を別々に調整する | スループットは向上しないと明記(実験的な機能) |
Aegaeon | トークン単位でモデルの割り当てを切り替える | 多数のモデルで少ないGPUを共有する | GPU1基で最大7モデル、2〜2.5倍または1.5〜9倍 |
出典:NVIDIA Multi-Instance GPU User Guide(最終更新:2026年10月13日)、NVIDIA Multi-Instance GPU、ServerlessLLM(USENIX OSDI '24)(2024年7月)、MuxServe(ICML 2024)(2024年7月)、vLLM Disaggregated Prefilling、Aegaeonの論文(2025年10月)(いずれも2026年11月17日確認)
MIG(Multi-Instance GPU)は、NVIDIAのAmpere世代以降のGPUを、ハードウェアで最大7つに分ける機能です。分割の数を先に決めるため、リクエストに応じて割り当てを変えるAegaeonとは考え方が違います。
vLLMには、PrefillとDecodeを2つのインスタンスに分け、コネクタでKVキャッシュを受け渡す機能があります。公式ドキュメントには、実験的な機能であり、スループットは向上しないと明記されています。
論文が比較したServerlessLLM・MuxServeとの違い
ServerlessLLMは、エディンバラ大学などが2024年7月のOSDI '24で発表したサーバーレス型の推論システムです。モデルのデータを速く読み込む工夫などで、既存のサーバーレス推論より遅延を10〜200倍減らしたとしています。
MuxServeは、ICML 2024で発表された、人気の違う複数のLLMを同じGPUに同居させる仕組みです。スループットは最大1.8倍、または99%のSLO達成率を保ったまま2.9倍のリクエストを処理できたとしています。
Aegaeonの論文は、既存の方法では1GPUあたり2〜3モデルが限度だったと指摘し、最大7モデルまで広げました。2つの手法の数値は、2024年の発表当時の値です。
ポイント:
MIGはハードウェアで、MuxServeはモデルの同居で、AegaeonはトークンごとにGPUを分けて使います。vLLMのPrefill・Decode分離の目的は、スループットではなく遅延の調整です。
AlibabaがAegaeonを開発した背景
Alibaba CloudがGPUの効率化に取り組む背景は2つです。2025年4月からH20の対中輸出にライセンスが必要になったこと、そしてAI関連製品の売上がクラウドの外部売上の30%に達したことです。
NVIDIA H20の対中輸出にライセンスが必要に
NVIDIAの米国証券取引委員会への提出書類によると、米国政府は2025年4月9日、H20の中国への輸出にライセンスが必要だと通知しました。4月14日には、要件が無期限に続くと通知しています(出典:NVIDIA Form 8-K、2025年4月)。
Aegaeonの本番運用で使われたGPUもH20です。規制は変わりやすいため、2025年4月時点の情報として読んでください。
Alibaba CloudでAI関連の売上が伸びている
Alibaba Groupの2026年5月13日の決算発表によると、Cloud Intelligence Groupの外部顧客からの売上は40%増えました。AI関連製品の売上は11四半期連続で前年比3桁の伸びとなり、外部売上の30%を占めています(出典:Alibaba Groupの決算発表、2026年5月)。
ポイント:
Alibaba CloudがGPUの効率化を進める背景は、H20の輸出規制によるGPU調達の難しさと、AI関連事業の伸びの2つです。
Aegaeonの限界と注意点
Aegaeonの限界は4つです。学習のコストを下げる技術ではないこと、82%がAlibaba Cloud自身の環境での値であること、NVIDIAのGPUは引き続き必要なこと、利用者向けの公式提供が確認できないことです。IT媒体のThe Registerは、2025年10月21日の記事でAegaeonを「no DeepSeek moment」と評しました。DeepSeekのような転換点ではない、という意味です。
推論の効率化で、学習コストを下げる技術ではない
The Registerは、Aegaeonは推論のスケジューリングと資源共有の改善で、学習のブレークスルーではないと指摘しています(出典:The Register、2025年10月21日)。モデルの学習やファインチューニングに使うGPUを減らす技術ではありません。
結果はAlibaba Cloud自身の環境・3か月の運用
82%削減は、Alibaba Cloud Model Studioでの3か月以上のベータ運用の結果です。The Registerは、ほかのクラウド事業者がすでに同じ課題に対処している可能性も十分にあると書いています。一方で、利用の少ないモデルを動かす料金が跳ね上がりにくくなる点は評価していました。
NVIDIAのGPUが不要になるわけではない
Aegaeonは、NVIDIAのGPUを使わずに済む技術ではありません。本番運用でも213基のH20を使っていて、減ったのは同じモデル群の提供に必要なGPUの台数です。
Aegaeonを利用者が直接使えるかは確認できない
2026年11月時点で、Aegaeonを外部の利用者が使える形で公式に提供しているかは確認できませんでした。論文のPDFは公開されていて、仕組みは詳しく読めます。
Aegaeonから考える、日本でLLMを動かす確認点
Aegaeonの論文が示したのは、モデルを増やすほど、使われないまま確保されるGPUが増えるという問題でした。日本の企業が自社でLLMを動かすときも、同じ問題はGPUの費用として表れます。
モデルを増やすほどGPUの空き時間が生まれやすい
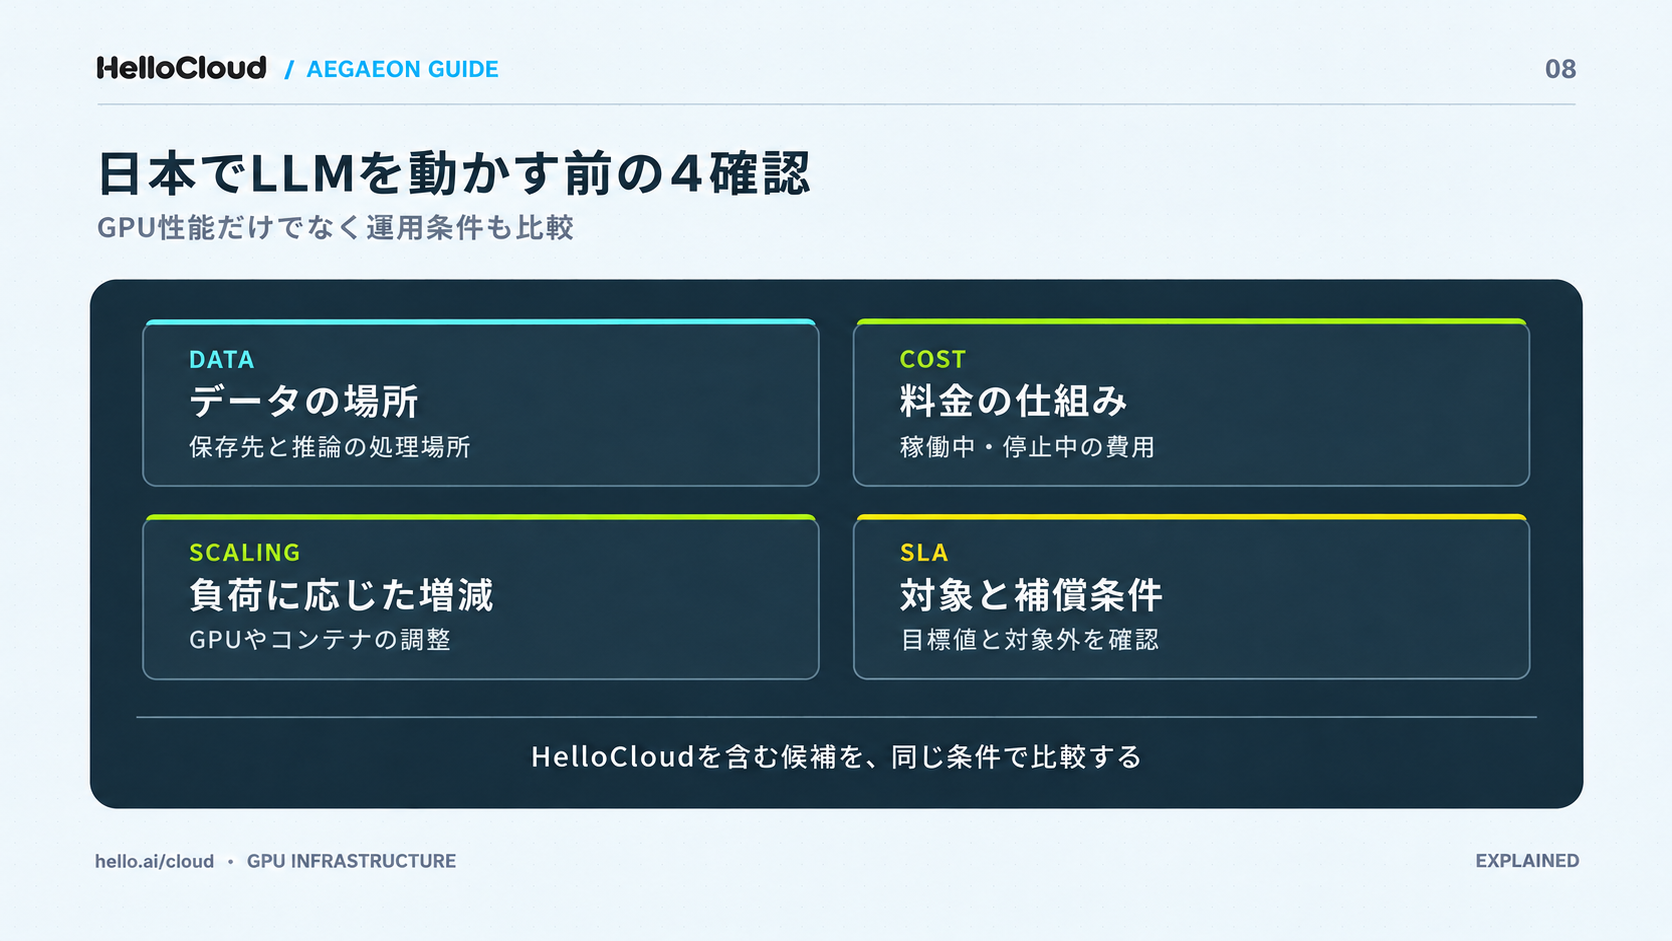
社内チャット、文書検索、レコメンドなど用途ごとにモデルを用意すると、リクエストの少ないモデルにもGPUが必要です。モデルごとにGPUを確保し続ければ、使っていない時間の分も費用がかかります。停止中にかかる費用はサービスごとに違うため、契約前に確認しておくと安心です。
確認したい4つの点:データ・料金・増減・SLA
経済産業省は2024年4月の発表で、基盤クラウドの国内市場における国内事業者のシェアを約3割としています(出典:経済産業省 ニュースリリース、2024年4月19日)。国内外のGPU環境を比べるときは、次の4点を確認すると判断しやすくなります。
確認点 | 確認すること | 確認する理由 |
|---|---|---|
データの保存先と処理の場所 | データを保存する国・リージョンと、推論を処理する場所 | 個人情報や機密情報は、国外で処理できない場合があるため |
GPUの種類と料金の仕組み | 使えるGPU、時間あたりの料金、初期費用、停止中の費用 | モデルの大きさと利用量で、必要なGPUと費用が変わるため |
負荷に応じた増減 | リクエストに合わせてGPUやコンテナの数を増減できるか | リクエストが少ない時間の費用を抑えるため |
SLAの対象範囲 | 稼働率の目標、補償の条件、対象外の項目 | 補償される範囲によって、運用の備えが変わるため |
注意:
データを国内に保存しても、それだけで法令上の対応がすべて済むわけではありません。個人情報の扱いは、社内の法務や情報セキュリティの担当と確認してください。
国内でGPUを用意する方法の例:HelloCloud
HelloCloudは、株式会社HelloCloudが提供する国産のGPUクラウドで、日本国内のデータセンターでAIモデルの実行と学習ができます。
項目 | 内容 |
|---|---|
拠点 | 東京の2拠点(JPTY01/JPTY02)。GPUインスタンスとサーバーレスGPU実行環境がこの2拠点で稼働 |
料金の仕組み | GPUは従量課金で、使った分だけ支払う。毎月の利用料金を計算して請求(利用規約 第3条) |
参考価格 | RTX 6000(VRAM 96GB):¥380/時間、B300(VRAM 288GB):¥1,480/時間。1インスタンスあたりの参考価格で、税込・税別の記載はない |
負荷に応じた増減 | サーバーレスGPU実行環境は、負荷に合わせてコンテナの数を自動で増減する |
データの扱い | 保存先のリージョンを選べる。法令や政府機関の拘束力ある命令への対応に必要な場合を除き、選んだリージョンの外へ移さない(利用規約 第1条1.4) |
SLA | APIのリクエスト成功率を対象に、月間稼働率99.9%以上の維持に向けて商業上合理的な範囲で努力する(保証ではない)。GPU上で実行するプログラムの計算精度や処理時間は対象外 |
出典:HelloCloud 公式サイト、HelloCloud 利用規約、HelloCloud SLA(2026年11月17日確認)
HelloCloudの公式サイトに掲載されている導入事例は、次の2社です。
株式会社ラス恋(CEO 山口様):「会員の個人情報を扱うため、推論も国外のサーバーに出せないのが前提でした。処理まで国内に閉じられる点が決め手で、申し込んだ日のうちに検証を始められました。レコメンドのモデルも、調達を待たずに本番へ載せられています。」
Aimy株式会社(CEO 平野様):「AIキャラクターとの対話は、推論を止められないサービスです。国内のGPUで推論を常時動かしながら、同じ環境でモデルの学習まで進められるのが助かっています。」
ポイント:
自社でLLMを動かす前に確認するのは、データの保存先、料金の仕組み、負荷に応じた増減、SLAの対象範囲の4点です。
国内でLLMの推論環境を検討している方へ
GPUインスタンスとサーバーレスGPU実行環境は、東京の2拠点で稼働中です。HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。
資料請求(HelloCloudの特徴と料金)
Aegaeonについてよくある質問
Q. Aegaeonはオープンソースで使えますか?
2026年11月時点で、Aegaeonが公式にオープンソースとして公開されていることは確認できませんでした。論文のPDFは公開されているため、仕組みや評価の内容は読めます。
Q. Aegaeonの論文はどこで読めますか?
Aegaeonの論文は、著者の1人のWebサイトで公開されているPDFで読めます(Aegaeonの論文PDF)。
Q. Aegaeonとvllmの違いは?
vLLMはLLMの推論を動かすソフトウェアで、Aegaeonは多数のモデルでGPUを共有するためのスケジューリングの仕組みです。vLLMにもPrefillとDecodeを分ける機能がありますが、公式ドキュメントではスループットは向上しないと明記されています。
Q. どの環境でもGPUを82%減らせますか?
いいえ、どの環境でも82%減るわけではありません。82%は、利用の少ないモデルを多数抱えるAlibaba Cloud Model Studioでの結果です。
Q. 学習(ファインチューニング)のコストも下がりますか?
いいえ、Aegaeonは推論の効率を上げる技術で、学習やファインチューニングのコストを下げるものではありません。
まとめ:Aegaeonとは何か、何に気をつけるか
Aegaeonは、北京大学とAlibaba Groupが2025年10月に発表した、複数のLLMでGPUを共有し、トークン単位で割り当てを切り替える推論システムです。Alibaba Cloud Model Studioでは、3か月以上のベータ運用で必要なH20を82%減らしました。ただし数値はAlibaba Cloud自身の環境での結果で、学習のコストを下げる技術ではありません。
国内でAIの推論や学習の環境を探している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。資料では、LLM推論・モデル学習・バッチ処理での活用方法も紹介しています。
資料請求(HelloCloudの特徴と料金)
参考文献
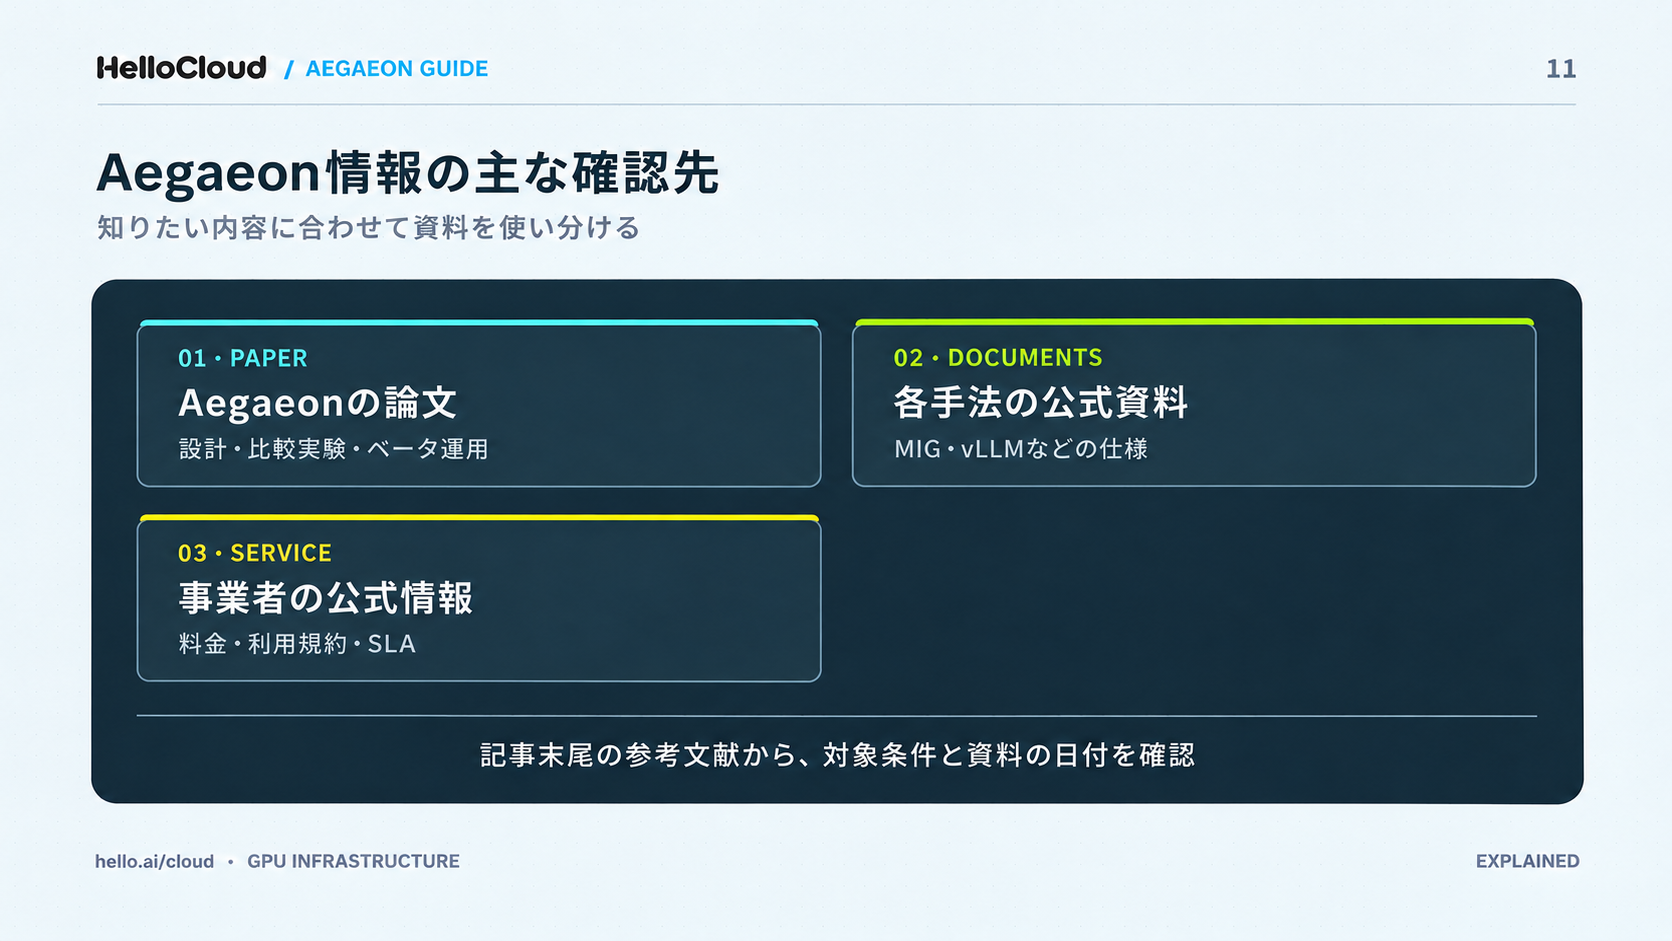
Xiang et al.「Aegaeon: Effective GPU Pooling for Concurrent LLM Serving on the Market」(ACM SIGOPS 31st Symposium on Operating Systems Principles/SOSP '25)、2025年10月:論文PDF
Fu et al.「ServerlessLLM: Low-Latency Serverless Inference for Large Language Models」(18th USENIX OSDI '24)、2024年7月:USENIX
Duan et al.「MuxServe: Flexible Spatial-Temporal Multiplexing for Multiple LLM Serving」(Proceedings of the 41st ICML, PMLR 235)、2024年7月:PMLR
経済産業省「経済安全保障推進法に基づくクラウドプログラムの安定供給確保に係る供給確保計画の認定等について」、2024年4月19日:経済産業省
Alibaba Group「Alibaba’s Cloud Revenue Growth Accelerates to 40% as AI Strategy Delivers」、2026年5月13日:Alibaba Group
The Register「Alibaba reveals 82 percent GPU resource savings – but this is no DeepSeek moment」(Simon Sharwood)、2025年10月21日:The Register
NVIDIA Corporation Form 8-K(米国証券取引委員会への提出書類)、2025年4月:SEC
NVIDIA「Multi-Instance GPU User Guide」(最終更新:2026年10月13日、2026年11月17日確認):NVIDIA Docs
NVIDIA「Multi-Instance GPU」製品ページ(2026年11月17日確認):NVIDIA
vLLM「Disaggregated Prefilling (experimental)」公式ドキュメント(2026年11月17日確認):vLLM Docs
HelloCloud 公式サイト(2026年11月17日確認):HelloCloud
HelloCloud 利用規約(2026年11月17日確認):HelloCloud 利用規約
HelloCloud サービスレベル契約(SLA)(2026年11月17日確認):HelloCloud SLA
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。