AI向けの計算需要は大きく、NVIDIAのデータセンター部門の売上高は2027年度第3四半期に1,076億ドルでした。前年同期比で110%増です(NVIDIAの決算発表、2026年11月17日)。
情報の確認日:2026年11月19日
この記事の結論
TPUは行列演算が中心の大規模な機械学習に向き、Google Cloudから使うチップです。GPUは独自の演算を含むモデルにも対応しやすく、使える環境も多くあります。迷ったら、学習ループの中に独自の演算があるかが判断の目安です。
TPUとGPUの違いを一覧表で比較【CPUも含む】
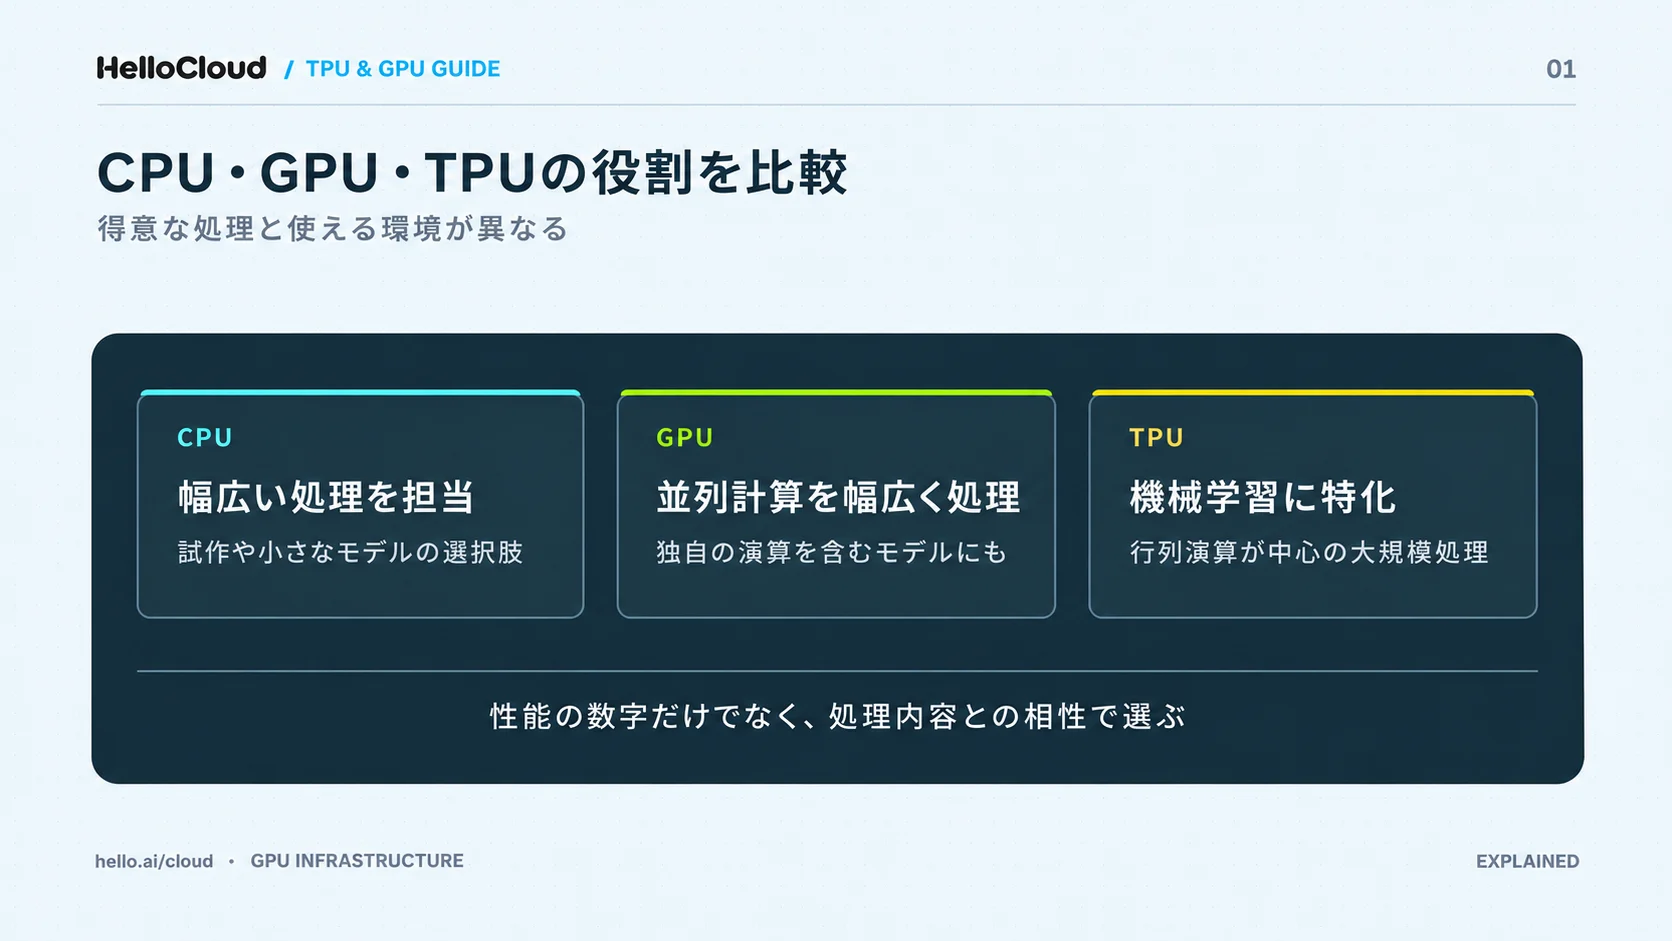
TPUとGPUは、設計の考え方・得意な処理と向かない処理・使える場所・ソフトウェアの4点で違います。CPUを加えて一覧にしました。
チップ | 設計の考え方 | 得意な処理 | 向かない処理 | 使える場所 | 主なソフトウェア |
|---|---|---|---|---|---|
CPU | 汎用の処理を順番にこなす | 試作、小さなモデル | ― | パソコン、各社のクラウド | 一般的なプログラム |
GPU | 並列計算を幅広くこなす汎用チップ | 独自の演算を含むモデル、中〜大規模のモデル | ― | パソコン、各社のクラウド | CUDA、PyTorchなど |
TPU | 行列演算に絞った専用チップ | 行列演算が中心の大規模な学習 | 分岐の多い処理、高精度の演算 | Google Cloud | XLAを通したJAX・PyTorch・TensorFlow |
出典:得意な処理と、TPUの向かない処理はGoogle Cloud「Introduction to Cloud TPU」(最終更新 2026-11-10、2026-11-19確認)。そのほかの項目は一般的な説明です。
CPUとGPUの違いは、CPUとGPUの役割の違いをまとめた記事でも解説しています。
ポイント:
TPUは得意な処理を行列演算に絞ったぶん、使える処理と場所が限られます。
TPUとは?GPUとの関係とGoogleのAIチップの基本
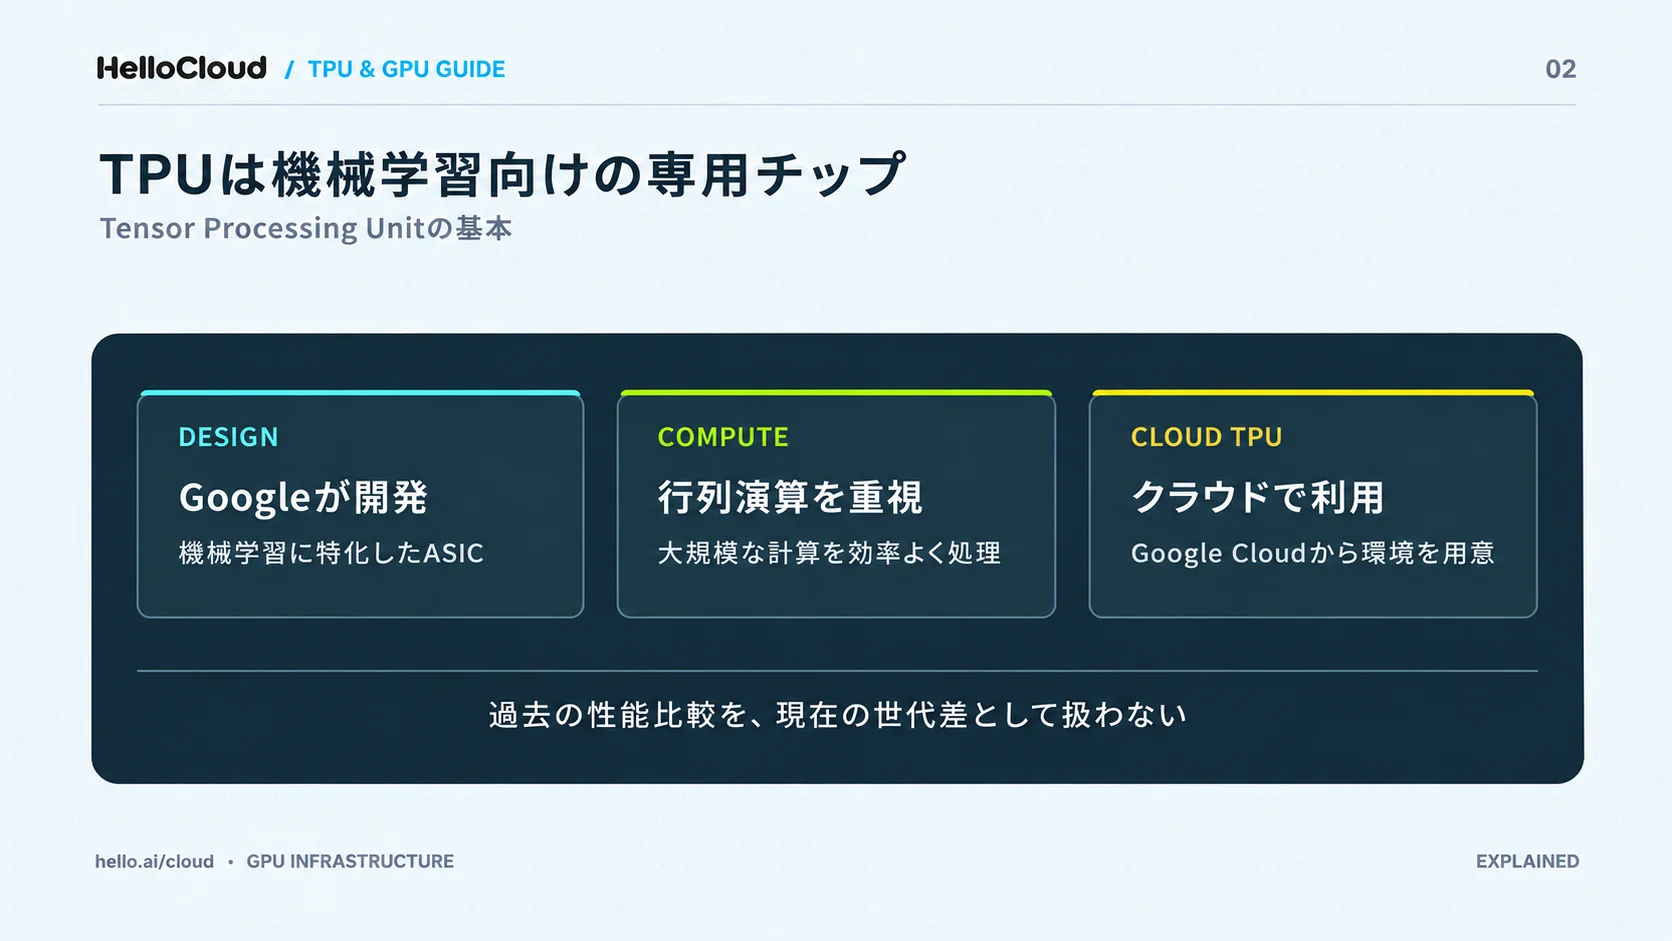
TPU(Tensor Processing Unit)は、Googleが機械学習の計算向けに独自に開発したAIチップ(専用チップ)です。GPUが画像処理から発展した汎用チップであるのに対し、TPUは最初から機械学習のために設計されました。
TPU(Tensor Processing Unit)の意味
TPUは、ASIC(特定の用途専用に設計した集積回路)の一種です。名前のTensor(テンソル)は、機械学習で扱う多次元の数値データを表す言葉です。TPUは、行列演算が中心の機械学習の計算を速く処理するために設計されています。
データセンター向けのTPU(Cloud TPU)は、Google Cloudを通して借りて使う形で提供されています。
TPUが生まれた背景:GPUとの比較から
TPUは2015年から、Googleのデータセンターでニューラルネットワークの推論を速くするために使われてきました。2017年の論文によると、推論用の初代TPUは、同世代のGPU(NVIDIA K80)やCPU(Intel Haswell)より平均で約15〜30倍速い結果でした。電力あたりの性能は約30〜80倍です(Jouppi ほか「In-Datacenter Performance Analysis of a Tensor Processing Unit」、2017年4月)。
ただし「15〜30倍」は、2017年時点の初代TPUと、K80という古い世代のGPUを推論で比べた数値です。今のTPUとGPUの性能差を表す数値ではありません。
ポイント:
TPUは、Googleが機械学習専用に作ったASICです。よく見かける「15〜30倍速い」は、2017年の初代TPUの結果です。
GPUとは?AI開発で広く使われる理由
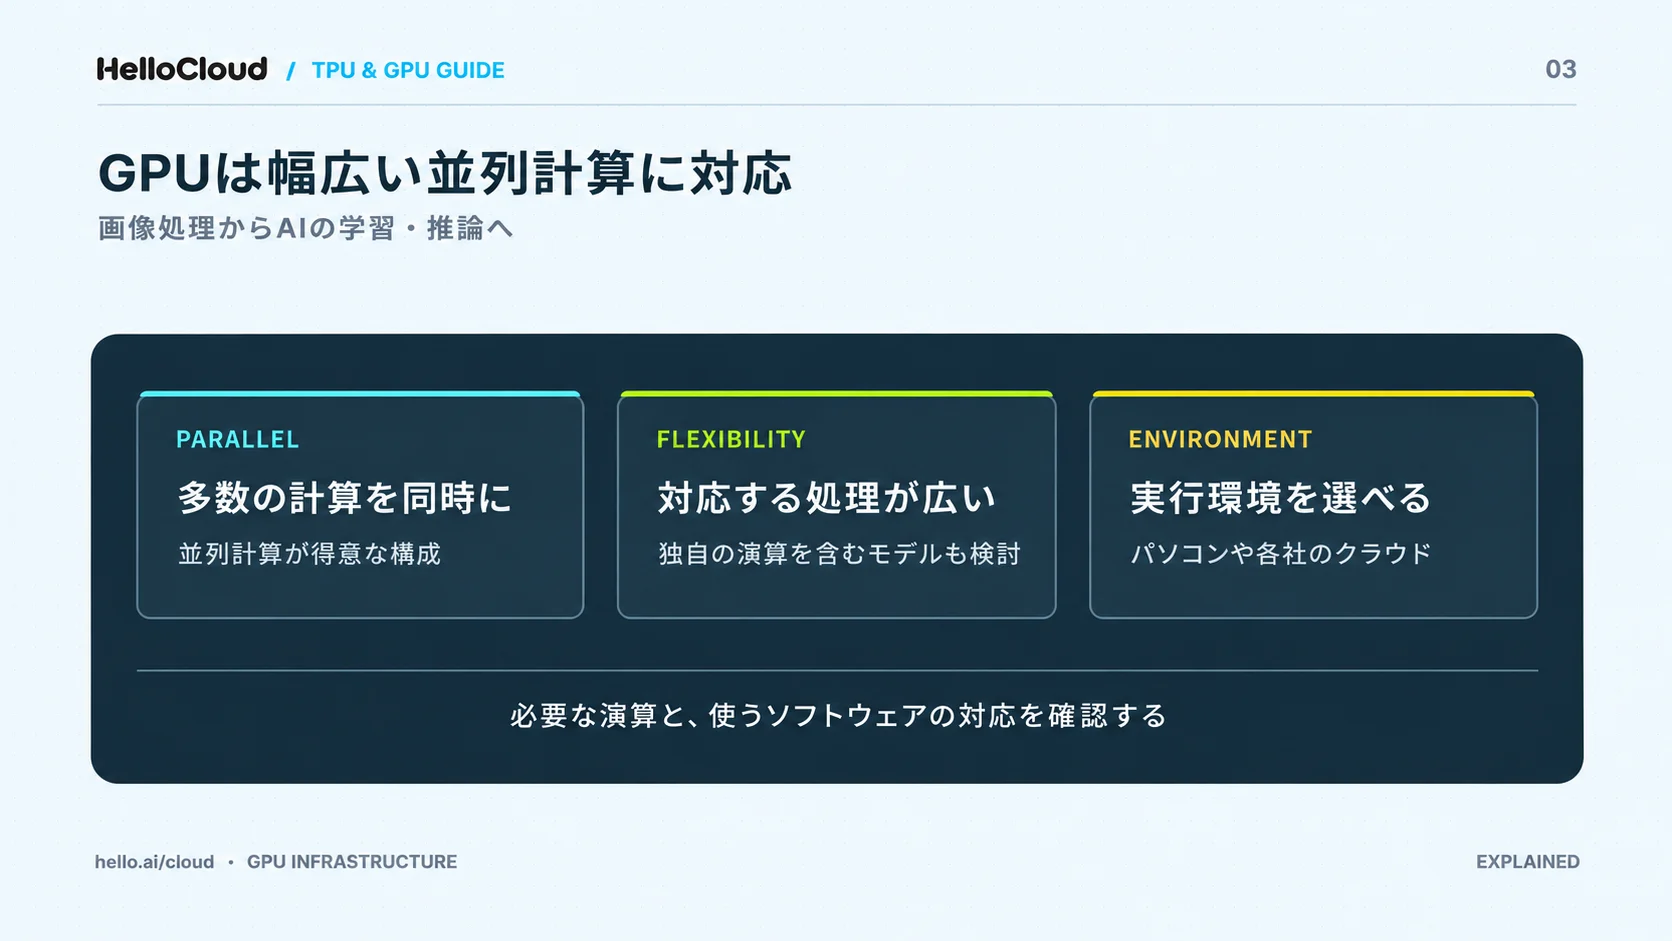
GPU(Graphics Processing Unit)は、多くの計算を同時にこなす並列計算が得意な汎用の演算チップです。TPUが登場したあとも、AIの学習と推論ではGPUが広く使われています。
GPU(Graphics Processing Unit)の意味
GPUは、もともとゲームや画像・動画ソフトのグラフィックスを処理するために設計されたチップです(IBMによるNPUとGPUの解説)。画像の描画では多数の画素を同じ手順で一斉に計算するため、GPUは多くの計算を同時に処理できる作りになっています。
GPUの役割や仕組みは、別の記事で解説しています。
AI開発でGPUが使われる理由
GPUがAI開発で使われる理由の1つは、対応できる処理の幅の広さです。Googleの公式ドキュメントは、独自のPyTorch/JAXの演算を多く含むモデルにGPUを挙げています。Cloud TPUで使えないTensorFlowの演算を含むモデルについても、GPUが向くと書かれています。
ポイント:
GPUは、独自の演算を含むモデルにも対応できる汎用チップです。
TPUとGPUの4つの違い
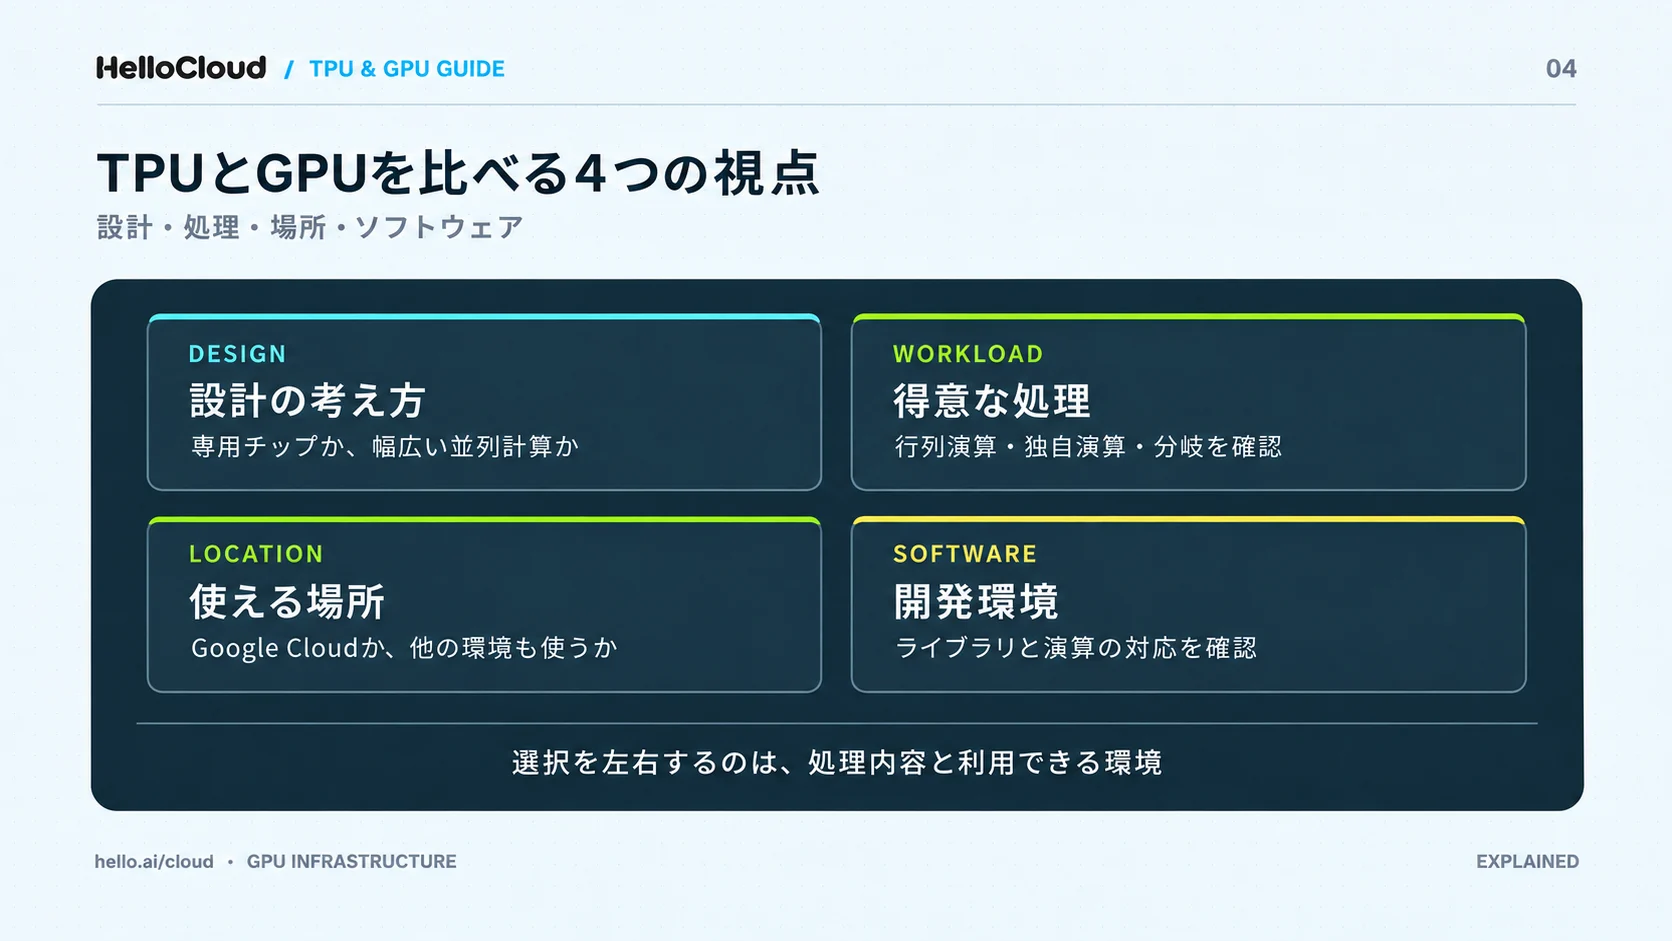
TPUとGPUは、設計の考え方、得意な処理、使える場所、ソフトウェアの4点で違います。どちらを選ぶかを左右するのは、4点のうち「得意な処理」と「使える場所」の2つです。
違い①設計の考え方:専用チップか汎用チップか
TPUは行列演算に絞った専用チップで、GPUは並列計算を幅広くこなす汎用チップです。TPUは対象を絞ったぶん、行列演算以外の処理や、細かい分岐が多い処理は得意ではありません。GPUは画像処理から科学技術計算、機械学習まで、さまざまな並列計算に使えます。
違い②得意な処理と向かない処理
TPUが向くのは、行列演算が中心で、学習ループの中に独自の演算がないモデルです。Googleの公式ドキュメントが示す、チップごとの向き不向きは次のとおりです。
チップ | 向く処理 | 向かない処理 |
|---|---|---|
CPU | 試作、短時間で学習が終わる小さなモデル、入出力が制約になるモデル | ― |
GPU | 独自のPyTorch/JAX演算が多いモデル、Cloud TPUにないTensorFlow演算を含むモデル、中〜大規模のモデル | ― |
TPU | 行列演算が中心のモデル、学習ループに独自演算がないモデル、数週間〜数か月学習する大規模なモデル、超大規模な埋め込みを持つモデル | 分岐や要素ごとの演算が多い処理、高精度の演算、学習ループの中の独自演算 |
出典:Google Cloud「Introduction to Cloud TPU」(最終更新 2026-11-10、2026-11-19確認)
TPUが向くかどうかは、学習ループの中に独自の演算があるかどうかで大きく変わります。独自の演算が多いモデルは、GPUのまま動かすか、TPU向けに演算を見直すかを先に検討してください。
違い③使える場所:TPUはGoogle Cloudから使う
TPUは、Google Cloudのサービスを通して使います。案内されている利用経路は、Compute Engine(仮想マシン)、GKE(Kubernetes)、Gemini Enterprise Agent Platformの3つです。以前のCloud TPU APIは非推奨です。TPU7x(Ironwood)は、GKEとCompute Engineのどちらからでも使えます(Google Cloud「TPU7x (Ironwood)」)。
社内の基盤がGoogle Cloud以外にある場合、TPUを使うにはGoogle Cloudの環境を別に用意する必要があります。
違い④ソフトウェア:CUDAとXLA・TorchTPU
GPU向けのAI開発では、NVIDIAのCUDAを土台に、PyTorchなどのライブラリを使います。TPUでは、XLAというコンパイラが計算をTPU向けに変換し、そのうえでJAX・PyTorch・TensorFlowのコードが動く仕組みです。
Googleは2026年4月7日、PyTorchをTPUでそのまま動かすTorchTPUを発表しました(Google Developers Blogの発表)。発表時点の説明では、デバイスの指定を「tpu」に変えるだけで、学習ループを書き換えずに動かすことを目指しています。前身はPyTorch/XLAという仕組みです。
CUDAとPyTorchの組み合わせは、PyTorchでCUDAを使う方法の記事にまとめています。
ポイント:
GPUはCUDAを土台に、TPUはXLAを通してコードが動きます。TorchTPUの発表で、PyTorchのコードをTPUで動かしやすくする取り組みが進んでいます。
TPUの世代別スペック・料金【2026年11月】
TPUは世代によって、チップ1基あたりの性能、メモリの容量、1時間あたりの料金が大きく違います。表の数値は、2026年11月19日に公式ページで確認したものです。Googleは2026年4月22日に第8世代のTPU 8t(学習向け)とTPU 8i(推論向け)を発表しており、年内に一般提供する予定としています(Googleの発表)。
v5p・Trillium・TPU7x(Ironwood)のスペック
TPU7x(Ironwood)のBF16のピーク性能はチップ1基あたり2,307TFLOPsで、Trillium(v6e)の約2.5倍です。HBM(チップのそばに積む帯域の広いメモリ)は192GiBで、Trilliumの6倍にあたります。
世代 | ポッドあたりのチップ数 | BF16(TFLOPs) | FP8(TFLOPs) | HBM容量(GiB) | HBM帯域(GBps) |
|---|---|---|---|---|---|
TPU v5p | 8,960 | 459 | 459 | 95 | 2,765 |
Trillium(v6e) | 256 | 918 | 918 | 32 | 1,638 |
TPU7x(Ironwood) | 9,216 | 2,307 | 4,614 | 192 | 7,380 |
出典:Google Cloud「TPU7x (Ironwood)」(最終更新 2026-11-18、2026-11-19確認)。v5pのHBM容量は利用者が使える容量で、物理容量は96GiBです。
BF16とFP8は数値の精度の種類です。ポッドは、多数のTPUを高速な通信でつないだ単位を指します。
TPUの料金:チップ1時間あたりの単価
Cloud TPUの料金は、チップ1基を1時間使うごとにかかる仕組みです。
世代(リージョン) | オンデマンド | DWS Flex-start | DWS Calendar Mode | 1年契約 | 3年契約 |
|---|---|---|---|---|---|
Ironwood(us-central1) | $12.00 | $6.00 | $8.40 | $8.40 | $5.40 |
TPU v5e(us-central1) | $1.20 | $0.60 | $0.84 | $0.84 | $0.54 |
Trillium(asia-northeast1・東京) | $3.24 | $1.35 | $1.89 | $2.27 | $1.46 |
出典:Google Cloud「Cloud TPU pricing」(2026-11-19確認。チップ1基・1時間あたりのUSD)
東京リージョンのTrilliumを8基、オンデマンドで1時間使うと、$3.24×8=$25.92です。
GPUの料金は、GPUクラウドの料金を比べた記事にまとめました。
注意:
料金は変わることがあり、2026年11月19日時点で東京リージョンに載っている世代はTrilliumだけでした。使う前に公式の料金ページで確認してください。
TPUの導入事例:AnthropicのTPU利用の拡大
2025年10月23日のGoogle Cloudの発表によると、Anthropicは最大100万個のTPUを利用する計画で、規模は数百億ドルです。2026年には、1ギガワットを大きく超える容量が稼働する予定です。選んだ理由は、価格性能比と効率、TPUでの学習と提供の実績です(Google Cloud「Anthropic to Expand Use of Google Cloud TPUs and Services」)。
ポイント:
TPU7x(Ironwood)のBF16性能は、Trilliumの約2.5倍です。東京のTrilliumは、チップ1時間あたり$3.24(オンデマンド、2026年11月19日時点)でした。
TPUとGPUはどちらを選ぶ?判断の流れ
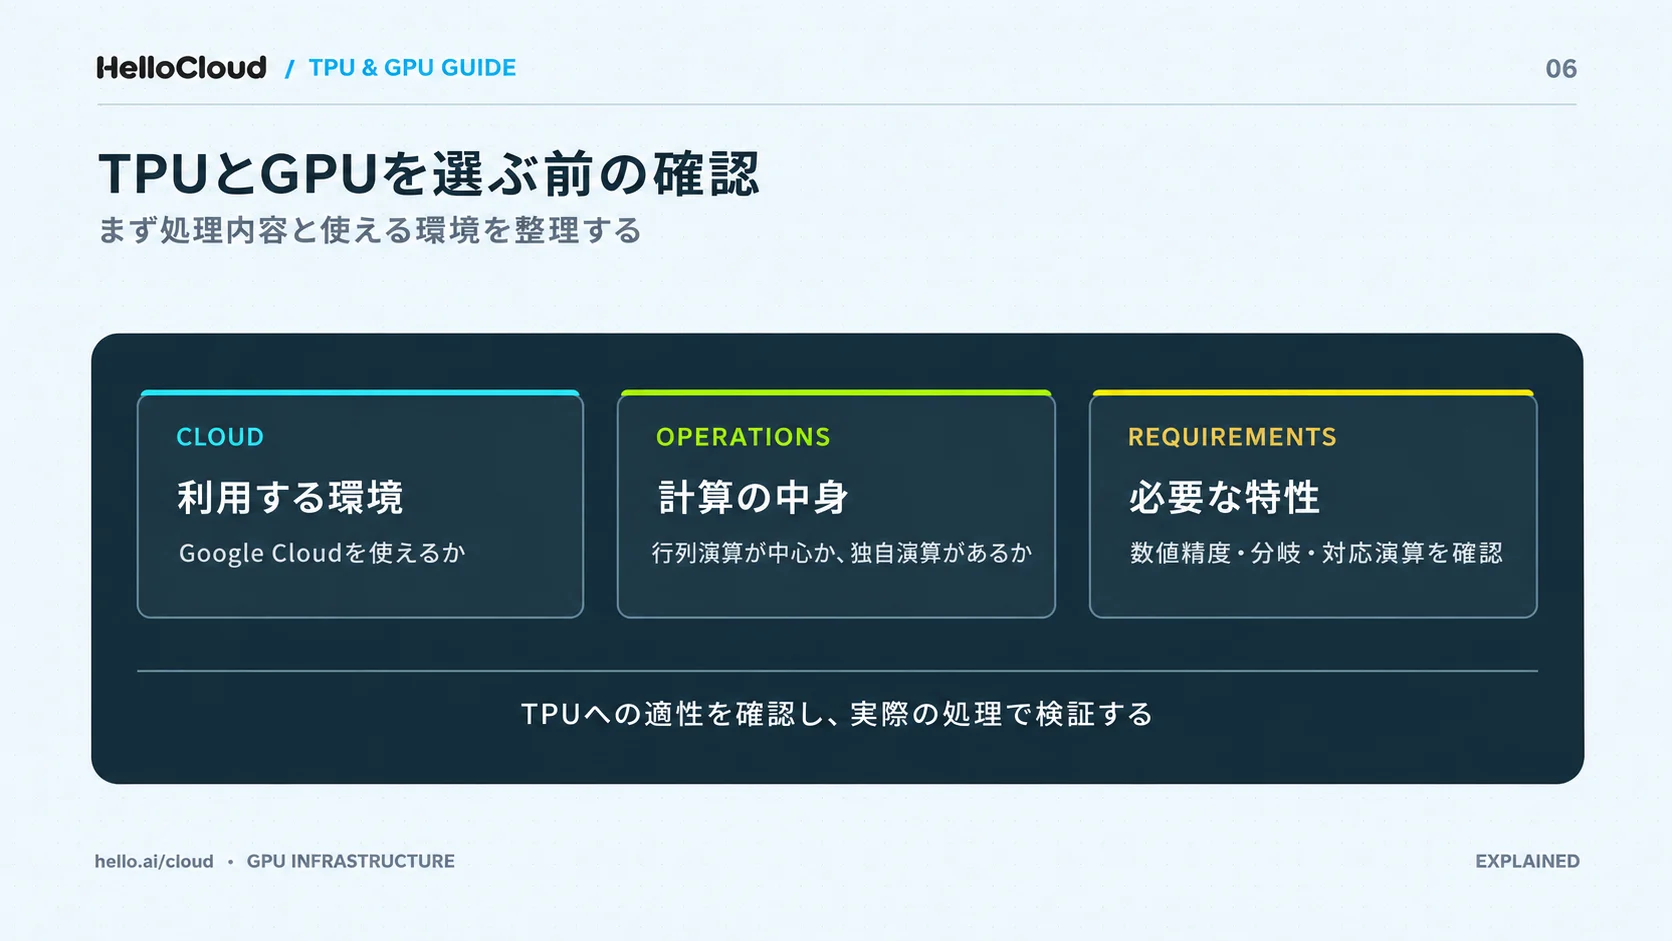
TPUとGPUのどちらを選ぶかは、処理の内容と、Google Cloudを使えるかどうかの2点で決まります。性能の数値だけでは、自分の処理に合うかは分かりません。
TPUを検討しやすいケース
TPUを検討しやすいのは、Google Cloudを使える前提で、次の条件に当てはまる場合です。
行列演算が中心のモデルを動かす
学習ループの中に、独自のPyTorch/JAXの演算がない
数週間〜数か月かけて学習する、大規模なモデルを扱う
ランキングやレコメンドなど、超大規模な埋め込みを持つモデルを扱う
GPUを選んだほうがよいケース
GPUを選んだほうがよいのは、TPUが向かない処理を含む場合や、Google Cloud以外の環境で動かしたい場合です。
一部をCPUで動かす独自のPyTorch/JAXの演算が多い
Cloud TPUで使えないTensorFlowの演算を含む
分岐が多い処理や、高精度の演算が必要な処理を含む
社内の基盤がGoogle Cloud以外にある
判断の流れ(フローチャート)
TPUとGPUのどちらにするかは、次の4つの質問に順番に答えると決めやすくなります。
Google Cloudを使えるか確認する:使えなければGPU
学習ループの独自演算を確認する:独自の演算があればGPU
計算の中身を確認する:行列演算が中心でなければGPU
精度と分岐を確認する:高精度の演算や分岐の多い処理がなければTPUを検討
GPUを選んだあとの機種の決め方は、GPUの機種の選び方の記事をご覧ください。
ポイント:
Google Cloudを使えて、行列演算が中心で、学習ループに独自の演算がない処理なら、TPUが選択肢に入ります。どれか1つでも外れる場合は、GPUが候補になります。
TPUでなくGPUを選んだ場合の国内での使い方
GPUを選んだら、次に決めるのは「どこでGPUを使うか」です。国内では、2030年度までの7年間で10兆円以上のAI・半導体支援を行う方針が2024年11月22日に閣議決定されました(経済産業省「半導体・デジタル産業戦略の今後の方向性」、2025年12月23日)。
GPU環境を選ぶときに確認したいこと
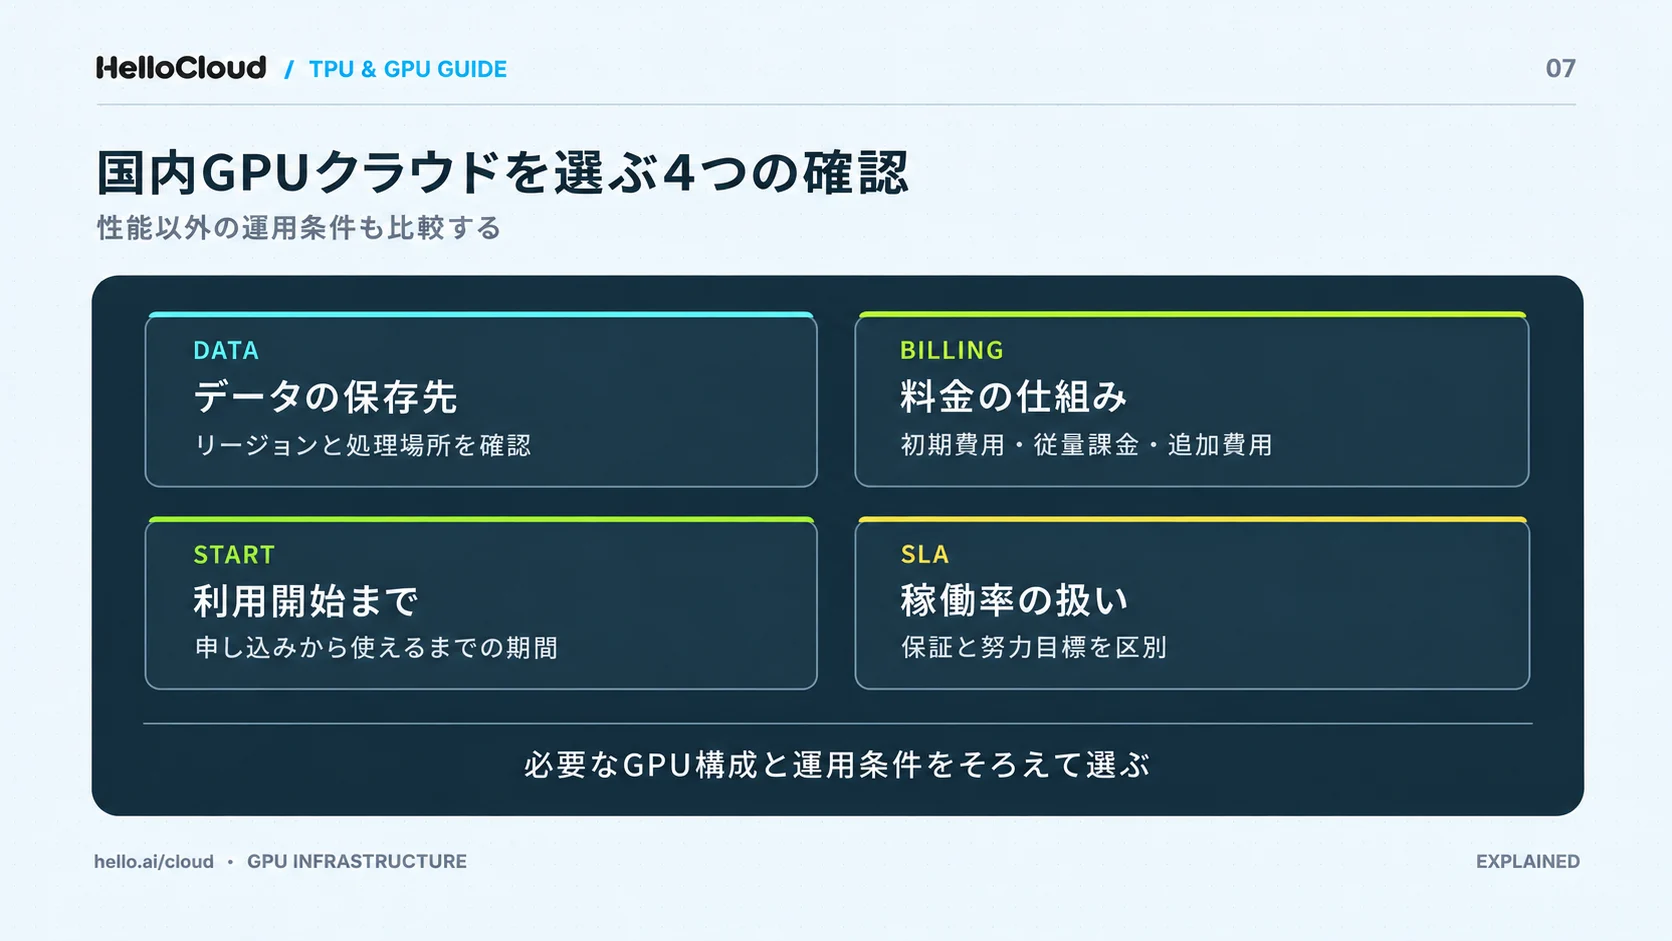
GPUのクラウドを選ぶ前に、次の4点を確認してください。
データの保存先:データを置くリージョンを選べるか
料金の仕組み:従量課金か、初期費用がかかるか
使い始めるまでの期間:申し込みから何日で使えるか
SLAの扱い:稼働率が保証か、努力目標か
注意:
データを国内に置いても、個人情報保護法の安全管理措置などの義務は残ります(個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(通則編)」)。
保存先の考え方は、データレジデンシーの解説記事で確認できます。
GPUクラウドに機密データを置く場合の注意点も、別の記事にまとめています。
国内GPUクラウド「HelloCloud」でできること
HelloCloudは、株式会社HelloCloudが提供する国産のGPUクラウドで、東京の2拠点でGPUインスタンスとサーバーレスGPU実行環境が稼働しています。
GPU | VRAM | RAM | vCPU | 参考価格(1時間) | 公式サイトでの想定用途 |
|---|---|---|---|---|---|
RTX 6000 | 96GB | 96GB | 16 | ¥380 | 小さく始める、推論・開発に |
B300 | 288GB | 384GB | 24 | ¥1,480 | 本格的なAI開発に、推論から学習まで |
出典:HelloCloud公式サイト(2026-11-19確認。GPU仮想マシン(VM)の1インスタンスあたりの参考価格)
料金は使った分だけ支払う従量課金で、申し込みの当日からGPUを使えます。データの保存先のリージョンも選べます(利用規約 第1条1.4、2026年11月5日確認)。
注意:
表の料金は参考価格で、税込・税別の記載はありません。SLAの月間稼働率99.9%以上は努力目標で、保証ではない点にも注意してください(HelloCloud SLA)。
導入事例:株式会社ラス恋・Aimy株式会社
HelloCloudの公式サイトに載っている導入事例は、次の2社です。
株式会社ラス恋(CEO 山口様)は、「会員の個人情報を扱うため、推論も国外のサーバーに出せないのが前提でした。処理まで国内に閉じられる点が決め手で、申し込んだ日のうちに検証を始められました。レコメンドのモデルも、調達を待たずに本番へ載せられています。」と話しています。
「AIキャラクターとの対話は、推論を止められないサービスです。国内のGPUで推論を常時動かしながら、同じ環境でモデルの学習まで進められるのが助かっています。」と話すのは、Aimy株式会社(CEO 平野様)です。
国内でGPUを使える環境を検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。GPU仮想マシンは、1時間¥380(参考価格)から使えます。
資料請求(HelloCloudの特徴と料金)
TPUとGPUの違いに関するよくある質問
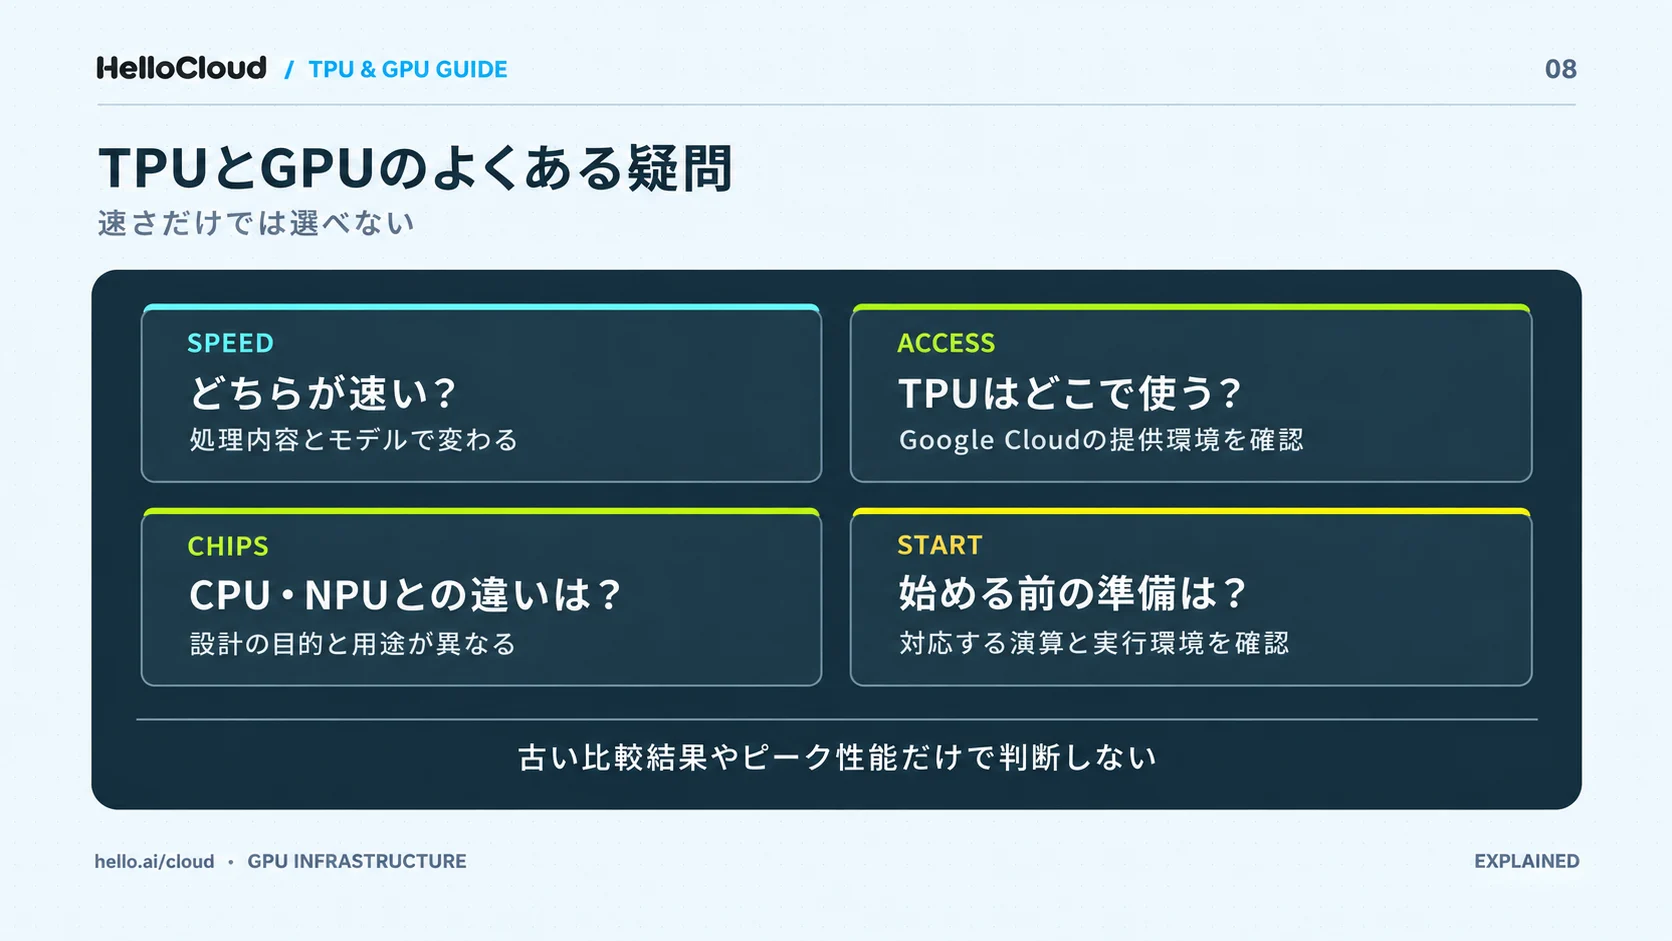
Q. TPUとGPUはどちらが速いですか?
TPUとGPUのどちらが速いかは、処理の内容しだいです。Googleの公式ドキュメントでは、行列演算が中心の大規模な学習はTPU、独自の演算を多く含むモデルはGPUが向くと書かれています。2017年の論文で示された「約15〜30倍」は、初代TPUとK80を推論で比べた結果です。
Q. TPUは個人でも使える?どこで使える?
個人か法人かにかかわらず、TPUはGoogle Cloudのサービスから使います。利用経路として案内されているのは、Compute Engine、GKE、Gemini Enterprise Agent Platformの3つです。
Q. CPUやNPUとTPUの違いは?
CPUは幅広い処理を順番にこなす汎用チップで、TPUは機械学習の行列演算に絞った専用チップです。NPU(Neural Processing Unit)もニューラルネットワーク向けのチップで、スマートフォンやウェアラブルなどの小型機器で、端末の中でAIを動かす用途に使われています(IBMによるNPUとGPUの解説)。
AI向けのチップの分類は、AIアクセラレータの解説記事が参考になります。
Q. TPUで機械学習を始めるには?
TPUで機械学習を始めるには、Compute EngineやGKEなどからTPUの環境を用意します。具体的な手順は、TPUを使った機械学習の始め方の記事をご覧ください。
まとめ:TPUとGPUの違いは処理の内容で選ぶ
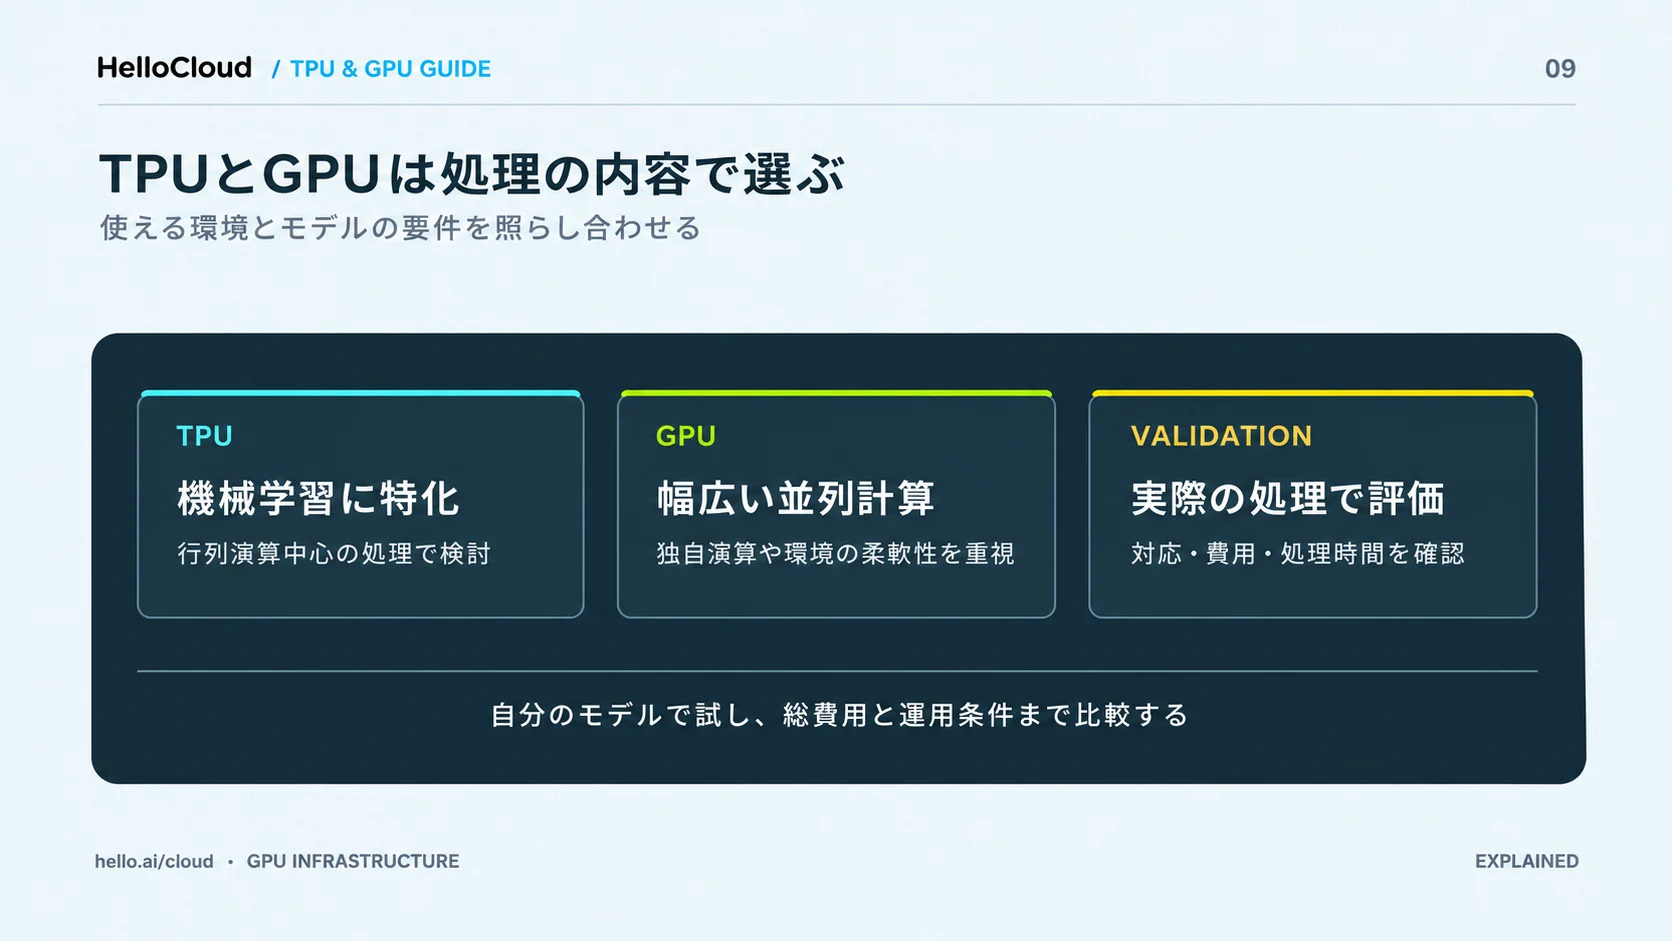
TPUとGPUを選ぶ基準は、処理の内容とGoogle Cloudを使えるかどうかの2点です。
TPUはGoogleが行列演算向けに作った専用チップで、Google Cloudから使う
GPUは並列計算を幅広くこなす汎用チップで、独自の演算を含むモデルにも対応しやすい
Google Cloudを使えて、行列演算が中心で、学習ループに独自の演算がなければTPU、それ以外はGPUが向く
GPUを国内のクラウドで使うことを検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。GPUは申し込みの当日から使え、料金は使った分だけの従量課金です。
資料請求(HelloCloudの特徴と料金)
この記事は、HelloCloud編集部(株式会社HelloCloud)が作成しました。内容の誤りに気づいた場合やHelloCloudへのお問い合わせは、support@supa.ai までご連絡ください。
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


