この記事の結論
LLMの必要VRAMは「重み+KVキャッシュ+作業領域」の式で見積もれます。7B・16bit・1リクエストなら約17.65GiB、70B・16bitなら約157〜176GiBが目安です。
LLMの必要VRAMを計算する式と3つの要素
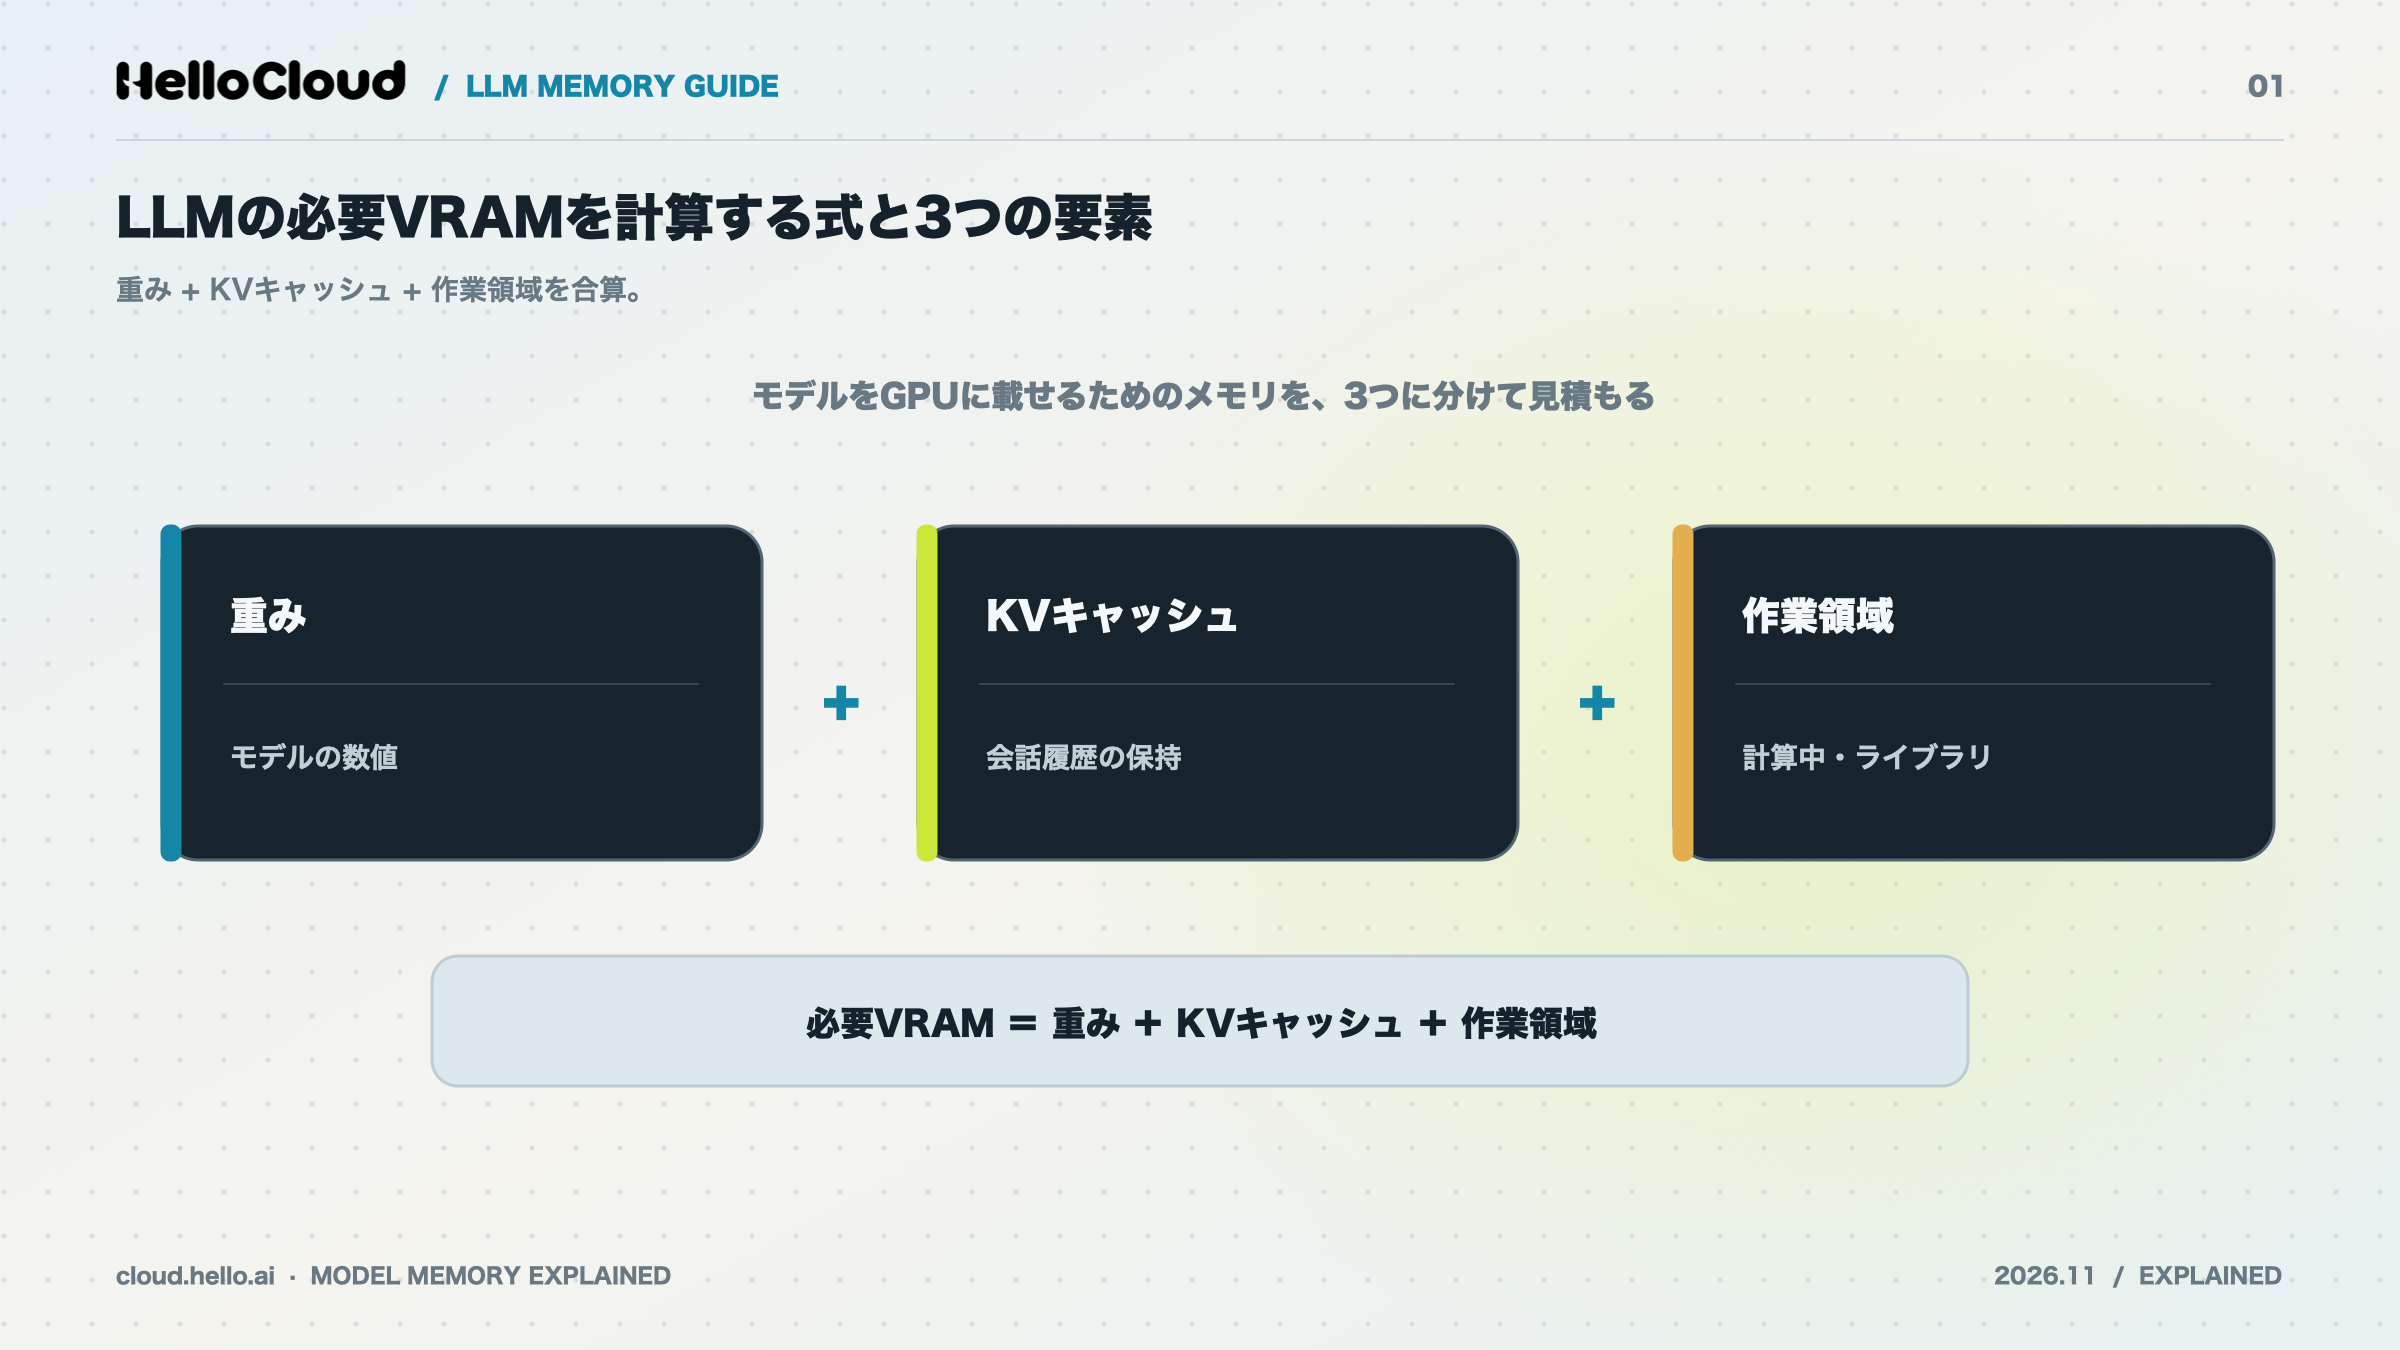
LLMの推論に必要なVRAMは、「重み」「KVキャッシュ」「作業領域」の3つを足した値です。VRAMは、GPUに載っているメモリのことです。NVIDIAの技術ブログ(2023年11月)は、推論中にGPUメモリを使う主なものとして重みとKVキャッシュを挙げています。
出典:NVIDIA Technical Blog「Mastering LLM Techniques: Inference Optimization」(2023年11月17日)
VRAMを使う3つの要素(重み・KVキャッシュ・作業領域)
重みは、モデルが学習で身につけた数値の集まりで、モデルを読み込んだ時点でサイズが決まります。KVキャッシュは、文章を生成するときに過去のトークンのキーとバリューを保存しておく領域です。作業領域は計算の途中の値やライブラリが使う領域で、大きさは実装と設定で変わります。
PagedAttentionの論文(Kwon et al.、2023年)は、A100 40GBで13Bのモデルを動かしたときのメモリの内訳を示しています。約65%が重み、30%近くがKVキャッシュでした。重みが大半を占める一方、KVキャッシュも重みの半分ほどの大きさになります。
出典:Kwon et al.「Efficient Memory Management for Large Language Model Serving with PagedAttention」(SOSP '23、2023年9月)
VRAMとRAMの違いと、計算で使う単位(GB・GiB)
VRAMはGPUに直接つながったメモリで、RAMはCPUが使うメインメモリです。LLMをGPUで動かすときは、重みとKVキャッシュをVRAMに載せて計算します。3DCGのGPUレンダリングで必要なVRAMの目安は、GPUレンダリングとVRAMの解説で紹介しています。
1GBは10億バイト、1GiBは1,073,741,824バイトで、GiBのほうが約7.4%大きい単位です。この記事では、出典とGPUの仕様の値は元の単位のまま、自分で計算した値はGiBで書きます。
ポイント: 必要VRAMは「重み+KVキャッシュ+作業領域」の合計です。値を足す前に、GBとGiBのどちらの単位かを確かめます。
重みに必要なVRAMの計算方法
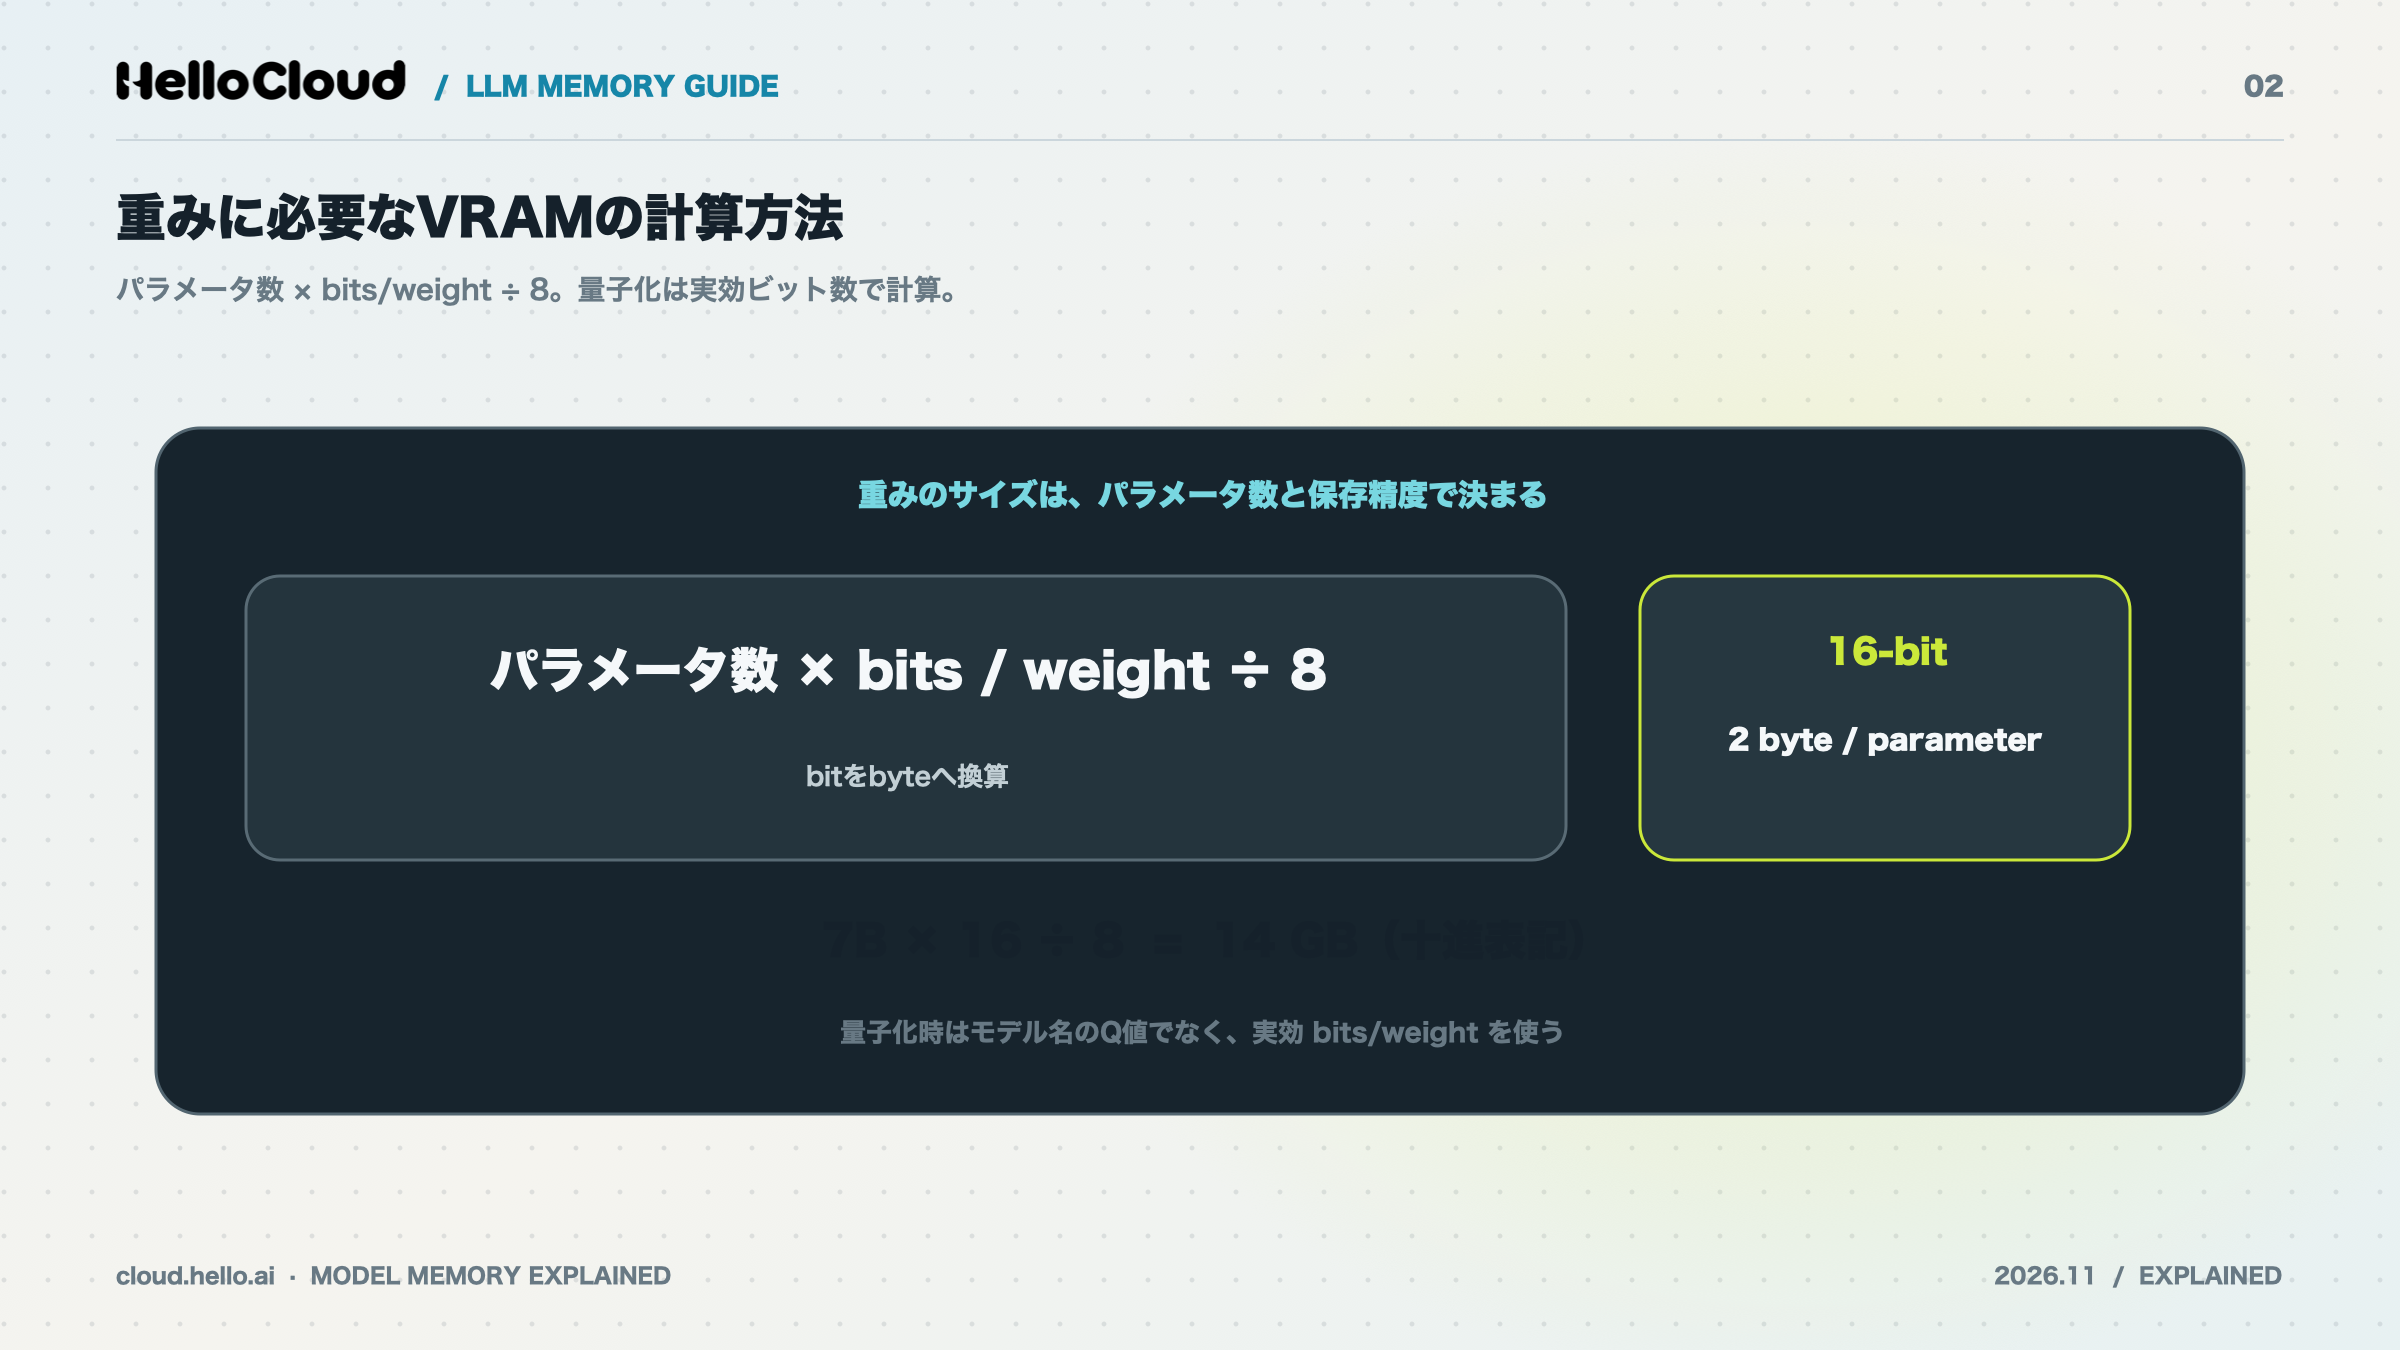
重みに必要なVRAMは、「パラメータ数×bits/weight÷8」で計算できます。bits/weightは、1つのパラメータを何ビットで持つかを表す値です。8で割るのは、ビットをバイトに直すためです。量子化したモデルでは、名前の数字ではなく実際の平均ビット数を使います。
計算式はパラメータ数×bits/weight÷8
16bit(FP16やBF16)で読み込む場合、1パラメータは2バイトです。
7Bの重み = 7,000,000,000 × 16 ÷ 8 = 14,000,000,000バイト ≒ 14GB(13.04GiB)NVIDIAの技術ブログ(2023年11月)も、Llama 2 7Bを16bitで読み込むと約14GBになると説明しています。同じ式で70Bを計算すると140GB(130.39GiB)です。Databricksのブログ(2023年10月)がLlama 2 70Bについて示す140GBと一致します。
出典:NVIDIA Technical Blog「Mastering LLM Techniques: Inference Optimization」(2023年11月17日)、Databricks「LLM Inference Performance Engineering: Best Practices」(2023年10月12日)
量子化したLLMは実効ビット数で計算する
量子化は、重みを少ないビット数で持たせてサイズを減らす方法です。llama.cppが公開しているLlama 3.1 8Bの値では、「Q4」と名前に付いた形式でも、実際の平均ビット数は4bitより大きい値です。
量子化の種類 | bits/weight | ファイルサイズ(GiB) | F16に対するサイズ |
|---|---|---|---|
Q3_K_M | 3.9960 | 3.74 | 25.0% |
Q4_K_M | 4.8944 | 4.58 | 30.6% |
Q5_K_M | 5.7036 | 5.33 | 35.6% |
Q8_0 | 8.5008 | 7.95 | 53.1% |
F16 | 16.0005 | 14.96 | 100% |
出典:llama.cpp 公式リポジトリ tools/quantize/README.md(Llama 3.1 8Bの値。2026年11月9日確認)。「F16に対するサイズ」は表の値から計算
表のファイルサイズをbits/weightで割り戻すと、パラメータ数はどの行も約80億です。式と公開値が一致するのは、実効ビット数で計算した場合です。
一方で、量子化は重みの情報を減らすため、出力の品質が下がる場合があります。Databricksのブログ(2023年10月)も、単純な量子化はモデルの品質を大きく下げることがあると注意しています。
出典:Databricks「LLM Inference Performance Engineering: Best Practices」(2023年10月12日)
影響の大きさは、モデルと量子化の方式しだいです。採用する前に、自分の用途で出力を確かめてください。
ポイント: 重みは「パラメータ数×bits/weight÷8」です。量子化したモデルには、公開されている実効ビット数(Q4_K_Mなら4.8944)を使います。
KVキャッシュに必要なVRAMの計算方法
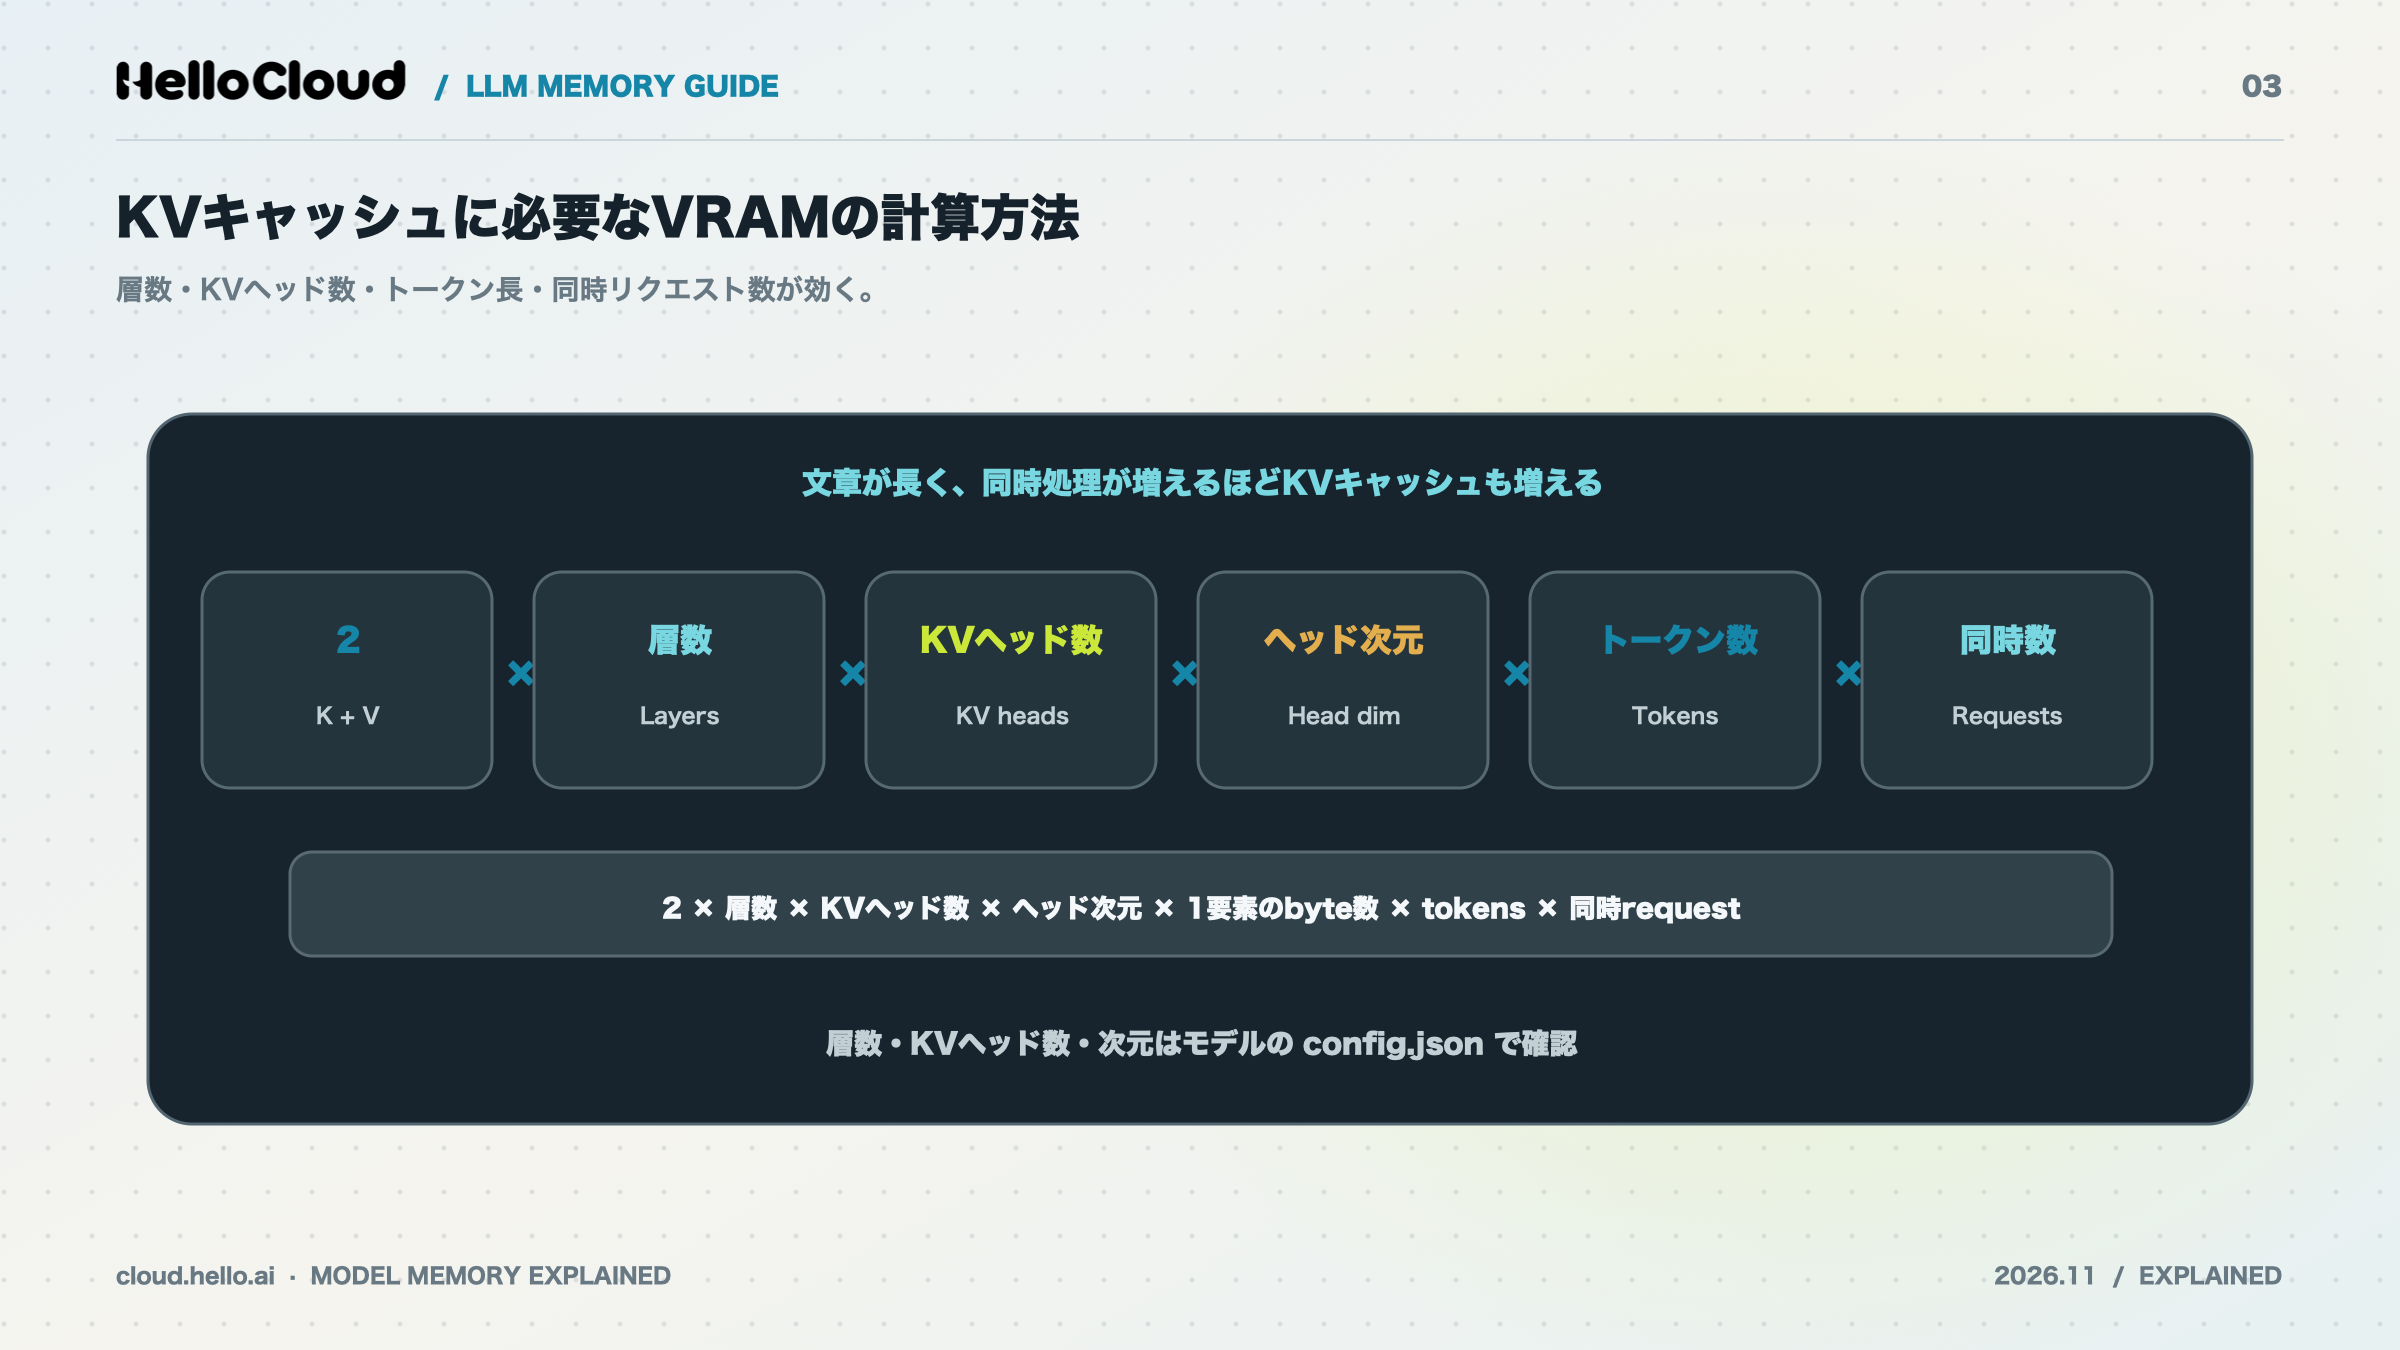
KVキャッシュに必要なVRAMは、「2×層数×KVヘッド数×ヘッド次元×1要素のバイト数×トークン数×同時リクエスト数」で計算します。「2」は、キーとバリューの2種類を保存する意味です。重みと違い、入出力が長くなるほど、同時リクエストが増えるほど大きくなります。式に入れる値は、モデルの設定ファイル(config.json)で調べられます。
KVキャッシュの計算式と計算例
NVIDIAの技術ブログ(2023年11月)は、KVキャッシュのサイズを次の式で示しています(精度はFP16の2バイト)。
全体(バイト)= バッチサイズ × シーケンス長 × 2 × 層数 × hidden_size × 2
Llama 2 7B・バッチ1・4,096トークン = 1 × 4,096 × 2 × 32 × 4,096 × 2
                                   = 2,147,483,648バイト(2.00GiB)
hidden_sizeは、多くのモデルで「ヘッド数×ヘッド次元」と同じ値です。PagedAttentionの論文(2023年)は、OPT-13Bの1トークンあたりのKVキャッシュを800KBとしています。この値も同じ式で、2×5,120×40層×2バイト=819,200バイトと計算し直せます。
出典:NVIDIA Technical Blog「Mastering LLM Techniques: Inference Optimization」(2023年11月17日)、Kwon et al.「Efficient Memory Management for Large Language Model Serving with PagedAttention」(SOSP '23、2023年9月)
ヘッド数ではなくKVヘッド数を使う理由(GQA)
GQA(Grouped-Query Attention)を使うモデルでは、式の「ヘッド数」を「KVヘッド数」に置き換えます。GQAの論文(Ainslie et al.、2023年)が提案したのは、クエリヘッドをグループに分ける方式です。各グループで、1組のキーヘッドとバリューヘッドを共有します。
KVヘッド数が少ないほど、保存するキーとバリューは減ります。NVIDIAの例のLlama 2 7Bは1トークンあたり512KiBです。DatabricksがGQAのモデルとして示すLlama-2-70Bは、表の値から逆算すると約320KiBになります。パラメータ数が10倍でも、1トークンあたりのKVキャッシュは70Bのほうが小さいという結果です。
出典:Ainslie et al.「GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints」(2023年5月)、NVIDIA Technical Blog「Mastering LLM Techniques: Inference Optimization」(2023年11月17日)、Databricks「LLM Inference Performance Engineering: Best Practices」(2023年10月12日)
式に入れる値をconfig.jsonで調べる
層数・KVヘッド数・ヘッド次元は、モデルの設定ファイル(config.json)に書かれています。次の項目名は、Llama系のモデル(Hugging Face TransformersのLlamaConfig)のものです。
提供元の公式リポジトリを開く:Hugging Faceなどで、モデルを公開している提供元のconfig.jsonを開きます。派生モデルや複製は設定が元のモデルと違う場合があるため、提供元の値を使います。
3つの項目を書き写す:層数は
num_hidden_layers、KVヘッド数はnum_key_value_heads、ヘッド次元はhead_dimです。ヘッド次元がなければ計算する:
hidden_sizeをnum_attention_headsで割った値がヘッド次元です。LlamaConfigでも、head_dimを省略した場合はこの値になります。
num_key_value_heads が1より大きく num_attention_heads より小さければ、そのモデルはGQAを使っています。1ならMQA、同じ値なら従来のマルチヘッドアテンションです(Hugging Face Transformersのドキュメント)。
出典:Hugging Face Transformers公式ドキュメント「LLaMA(LlamaConfig)」(2026年11月9日確認)
同時リクエスト数と文脈の長さで増える量
KVキャッシュは、同時リクエスト数とトークン数のどちらにも比例します。
同時リクエスト数 | FP16 | Int8 |
|---|---|---|
1 | 0.312GiB | 0.156GiB |
16 | 5GiB | 2.5GiB |
64 | 20GiB | 10GiB |
出典:Databricks「LLM Inference Performance Engineering: Best Practices」(Llama-2-70B・1,024トークン。2023年10月12日、2026年11月9日確認)
同時リクエスト数が1から64になると、KVキャッシュも64倍の20GiBになります。トークン数を1,024から4,096に増やした場合も、式どおり4倍です。vLLMで同時接続数の上限を実際に測る手順は、vLLMの同時接続とスループットの測り方で解説しています。
ポイント: 社内で複数人が同時に使うなら、同時リクエスト数を必ず式に入れます。KVキャッシュは人数と文脈の長さに比例して増えるからです。
作業領域の見込み方と、VRAM計算の確かめ方
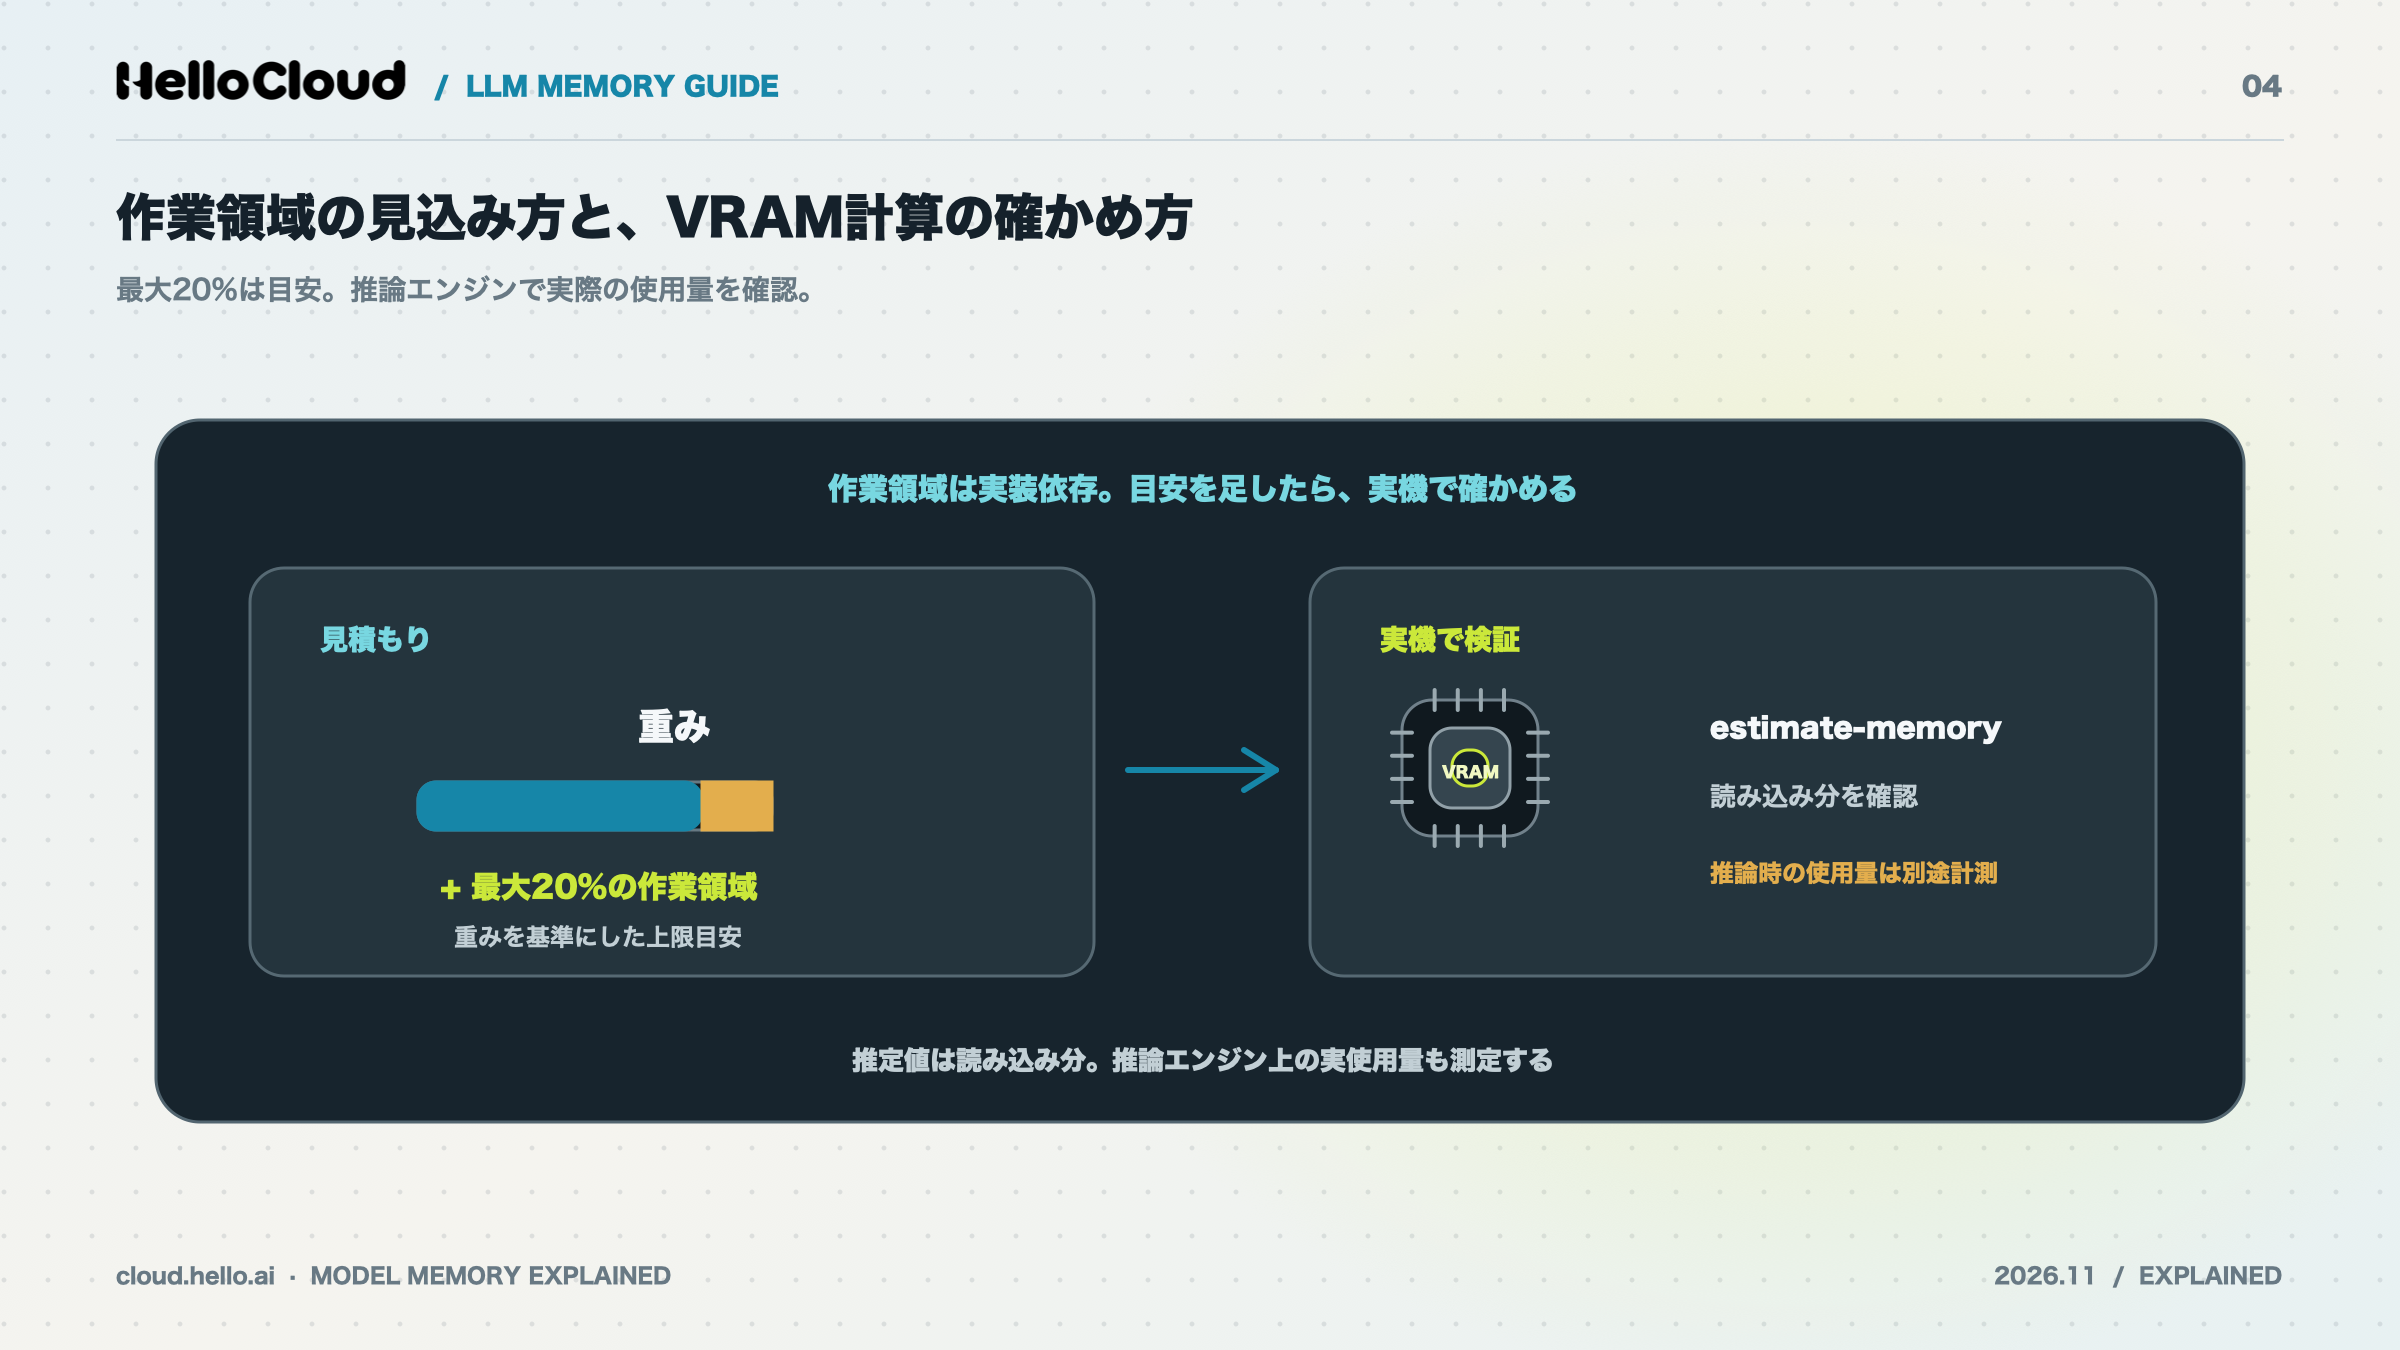
作業領域は、Hugging Face Accelerateの公式ドキュメントにある「推論では最大20%の追加」という目安で見込めます。作業領域の大きさは推論エンジンと設定しだいで、式だけでは正確に出せません。根拠のある目安で見積もり、読み込み分はツールで確かめます。
作業領域は出典のある目安で見込む
Hugging Face Accelerateの公式ドキュメントは、EleutherAIの調べをもとに、推論では最大20%の追加を見込むと記載しています。この記事の計算例では、重みの20%を作業領域の上限として足しました。実際の値は、使う推論エンジンで確かめてください。
出典:Hugging Face Accelerate公式ドキュメント「Model memory estimator」(2026年11月9日確認)
accelerate estimate-memoryで計算を確かめる
Hugging Face Accelerateの accelerate estimate-memory は、Hub上のモデルの読み込みメモリを推定するコマンドです。
モデル名を指定して実行する:config.jsonをもとに、読み込みに必要なメモリが表示されます。
精度を指定して比べる:
--dtypesを付けると、精度ごとの値を並べて確認できます。
accelerate estimate-memory bert-base-cased
accelerate estimate-memory bert-base-cased --dtypes float32 float16
コマンドは、Hugging Face Accelerate公式ドキュメント(v1.15.0、2026年11月9日確認)の例です。bert-base-casedをfloat32で読み込んだ実際の値は413.68MB、推定は413.18MBでした。ただし推定は読み込み分だけで、推論に使う分は含まれません。accelerateを入れるPythonの仮想環境は、Minicondaで仮想環境を作る手順を参考に用意できます。
計算値と実際の使用量がずれる理由
計算値と実際の使用量のずれは、主に次の4つから生じます。
推定が読み込み分だけ:accelerate estimate-memoryの値は、KVキャッシュと作業領域を含まない推定
KVキャッシュの増加:トークン数と同時リクエスト数が想定を超えた分の増加
単位の違い:GBとGiBを混ぜたときの約7.4%の差
推論エンジンの違い:推論エンジンと設定による、メモリを確保するタイミングと量の差
実際の使用量はnvidia-smiなどで確かめ、推論エンジンの公式ドキュメントでメモリの設定を確認します。
ポイント: 作業領域は重みの最大20%が目安です。estimate-memoryの推定は読み込み分だけなので、KVキャッシュと作業領域は自分で足します。
実行中のVRAM使用量やGPU使用率の確かめ方は、GPU負荷の確認方法で解説しています。
計算例:7Bと70BのLLMに必要なVRAM
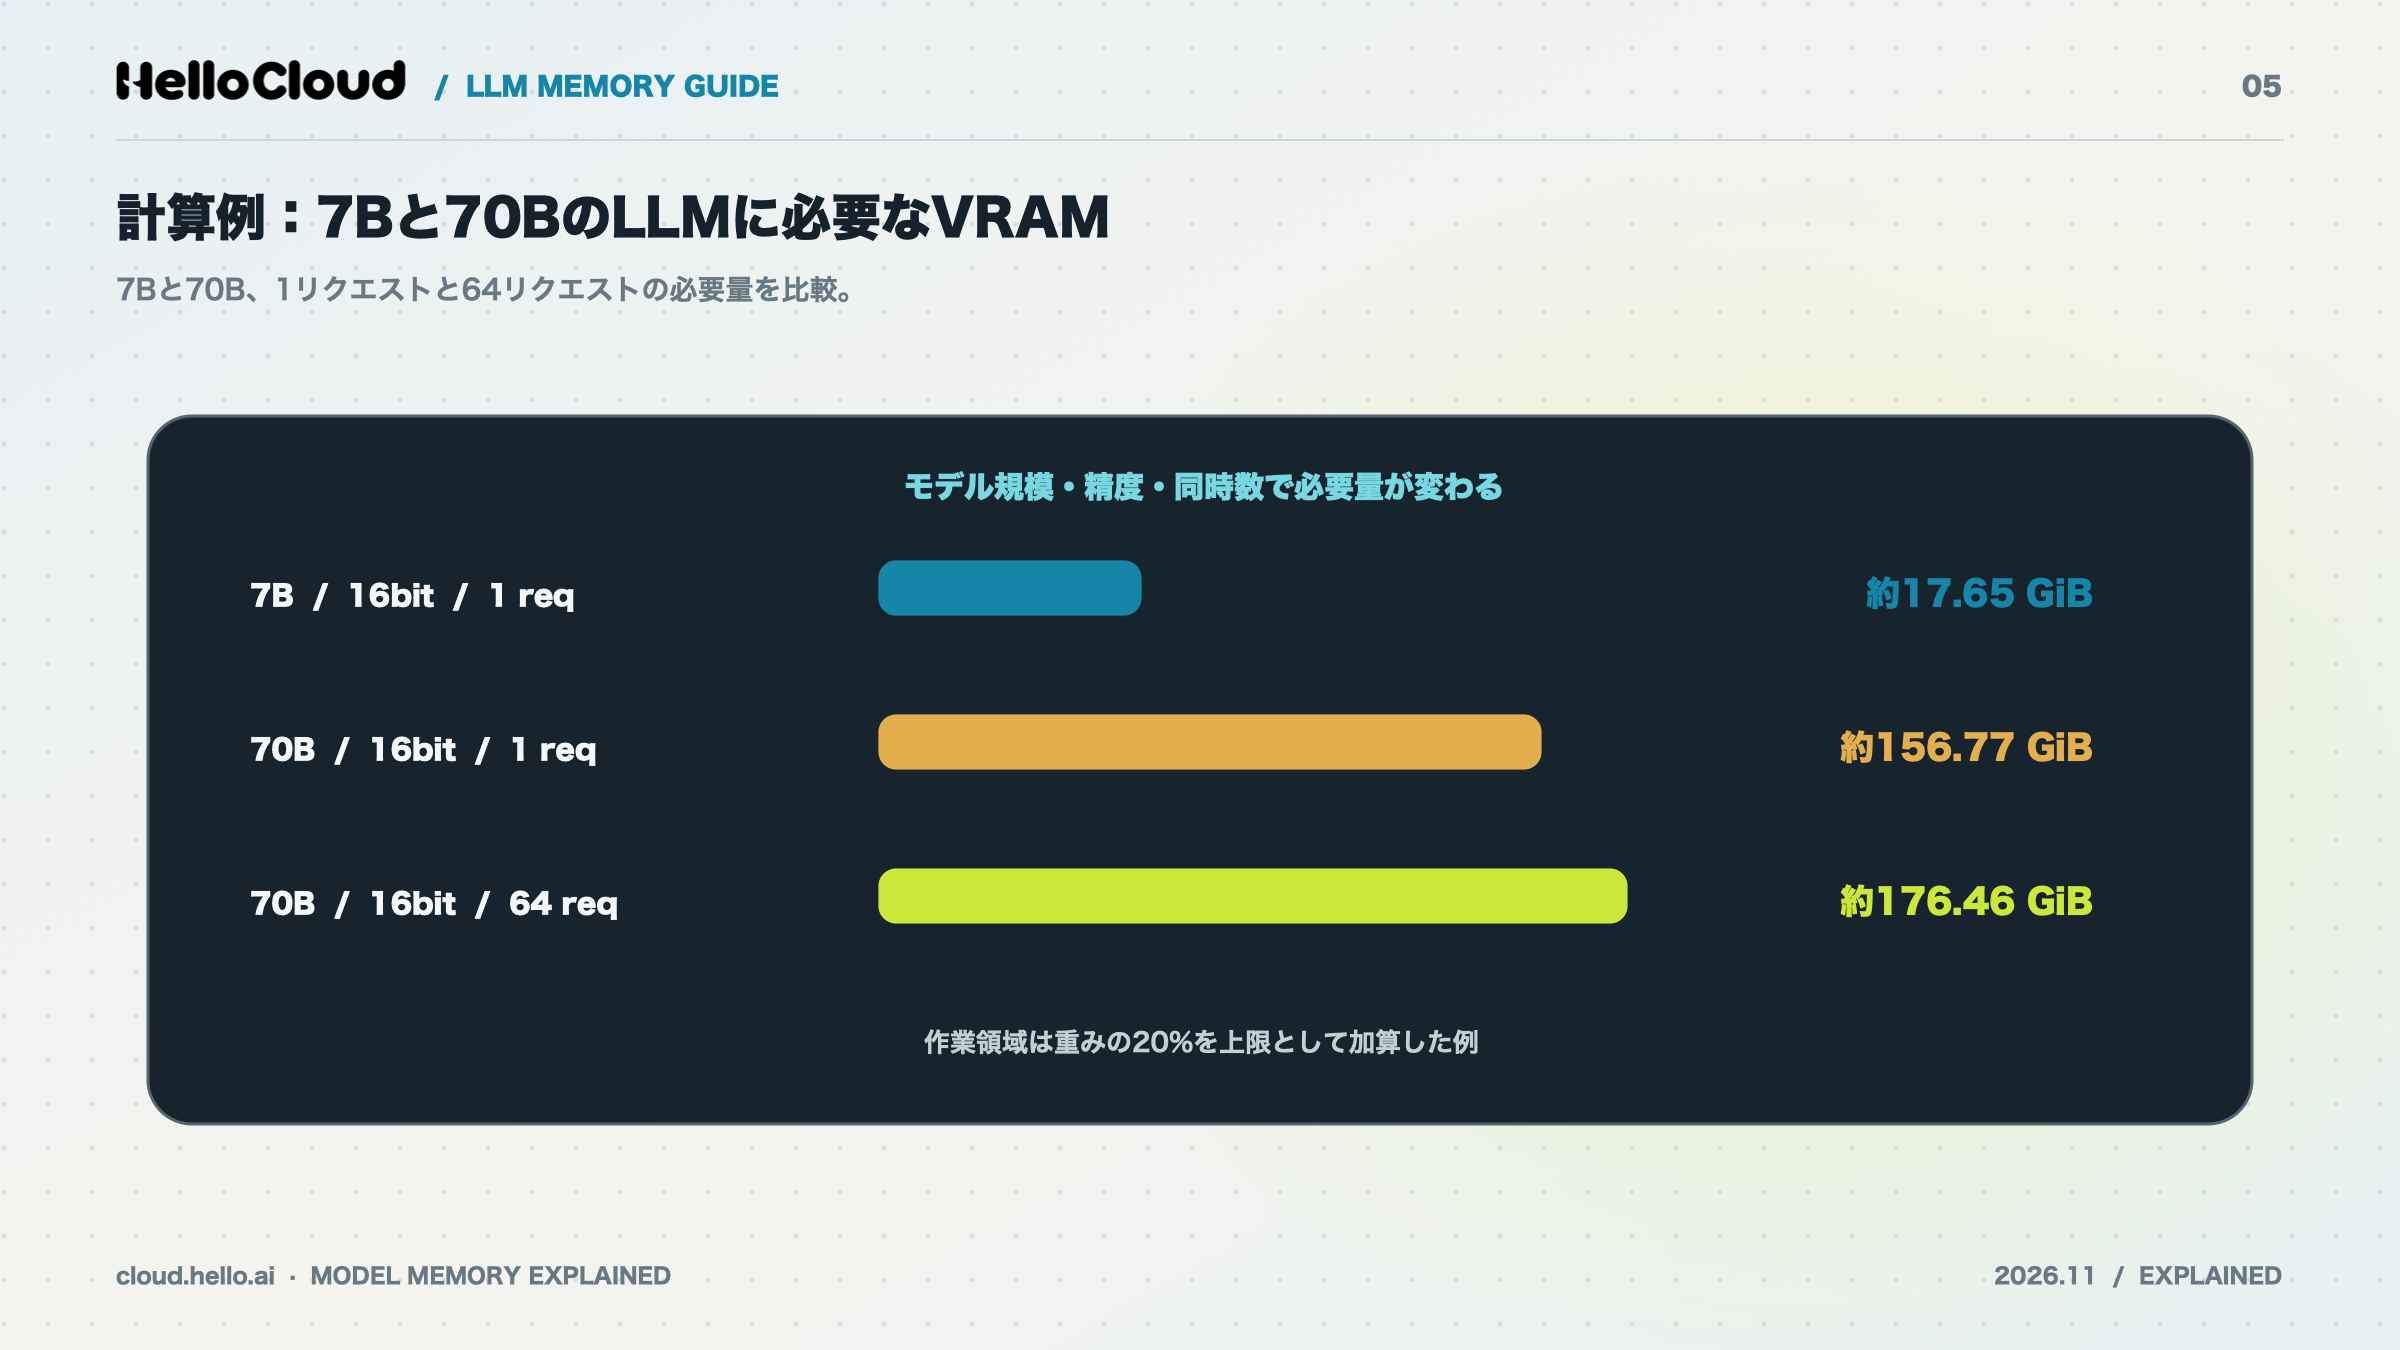
7Bのモデルを16bitで1リクエスト処理する場合、必要VRAMは最大で約17.65GiBです。70Bを16bitで動かす場合は、1リクエストで約156.77GiB、64リクエストで約176.46GiBになります。NVIDIAとDatabricksの公開値を使い、作業領域は重みの20%を上限として足しました。
例1:Llama 2 7B(16bit・4,096トークン)
重み         = 7,000,000,000 × 16 ÷ 8 = 13.04GiB
KVキャッシュ = 1 × 4,096 × 2 × 32 × 4,096 × 2バイト = 2.00GiB
作業領域     = 13.04GiB × 0.2 = 2.61GiB(最大)
合計         = 17.65GiB(約18.9GB)
重みとKVキャッシュだけで15.04GiB(約16.1GB)です。作業領域を含めると17.65GiB(約18.9GB)になり、VRAMが16GBのGPUの容量を超えます。
例2:Llama-2-70B(16bit・同時リクエスト数別)
重み         = 140GB = 130.39GiB
KVキャッシュ = 0.312GiB(1リクエスト)〜 20GiB(64リクエスト)※1,024トークン
作業領域     = 130.39GiB × 0.2 = 26.08GiB(最大)
合計         = 156.77GiB 〜 176.46GiB
70Bでは重みが大きく、64リクエストでもKVキャッシュは合計の約11%にとどまります。
計算結果のまとめ表(途中式つき)
計算例 | 重み | KVキャッシュ | 作業領域(最大) | 合計 |
|---|---|---|---|---|
7B・1リクエスト | 13.04GiB | 2.00GiB | 2.61GiB | 17.65GiB |
70B・1リクエスト | 130.39GiB | 0.31GiB | 26.08GiB | 156.77GiB |
70B・64リクエスト | 130.39GiB | 20.00GiB | 26.08GiB | 176.46GiB |
出典:NVIDIA Technical Blog(2023年11月)、Databricks(2023年10月)、Hugging Face Accelerate公式ドキュメント(2026年11月9日確認)の値をもとに計算
ポイント: 7B・16bitは約17.65GiB、70B・16bitは約157〜176GiBが目安です。モデルやトークン数が変わったら、同じ式に値を入れ直します。
推論と学習で必要VRAMはどれだけ違うか
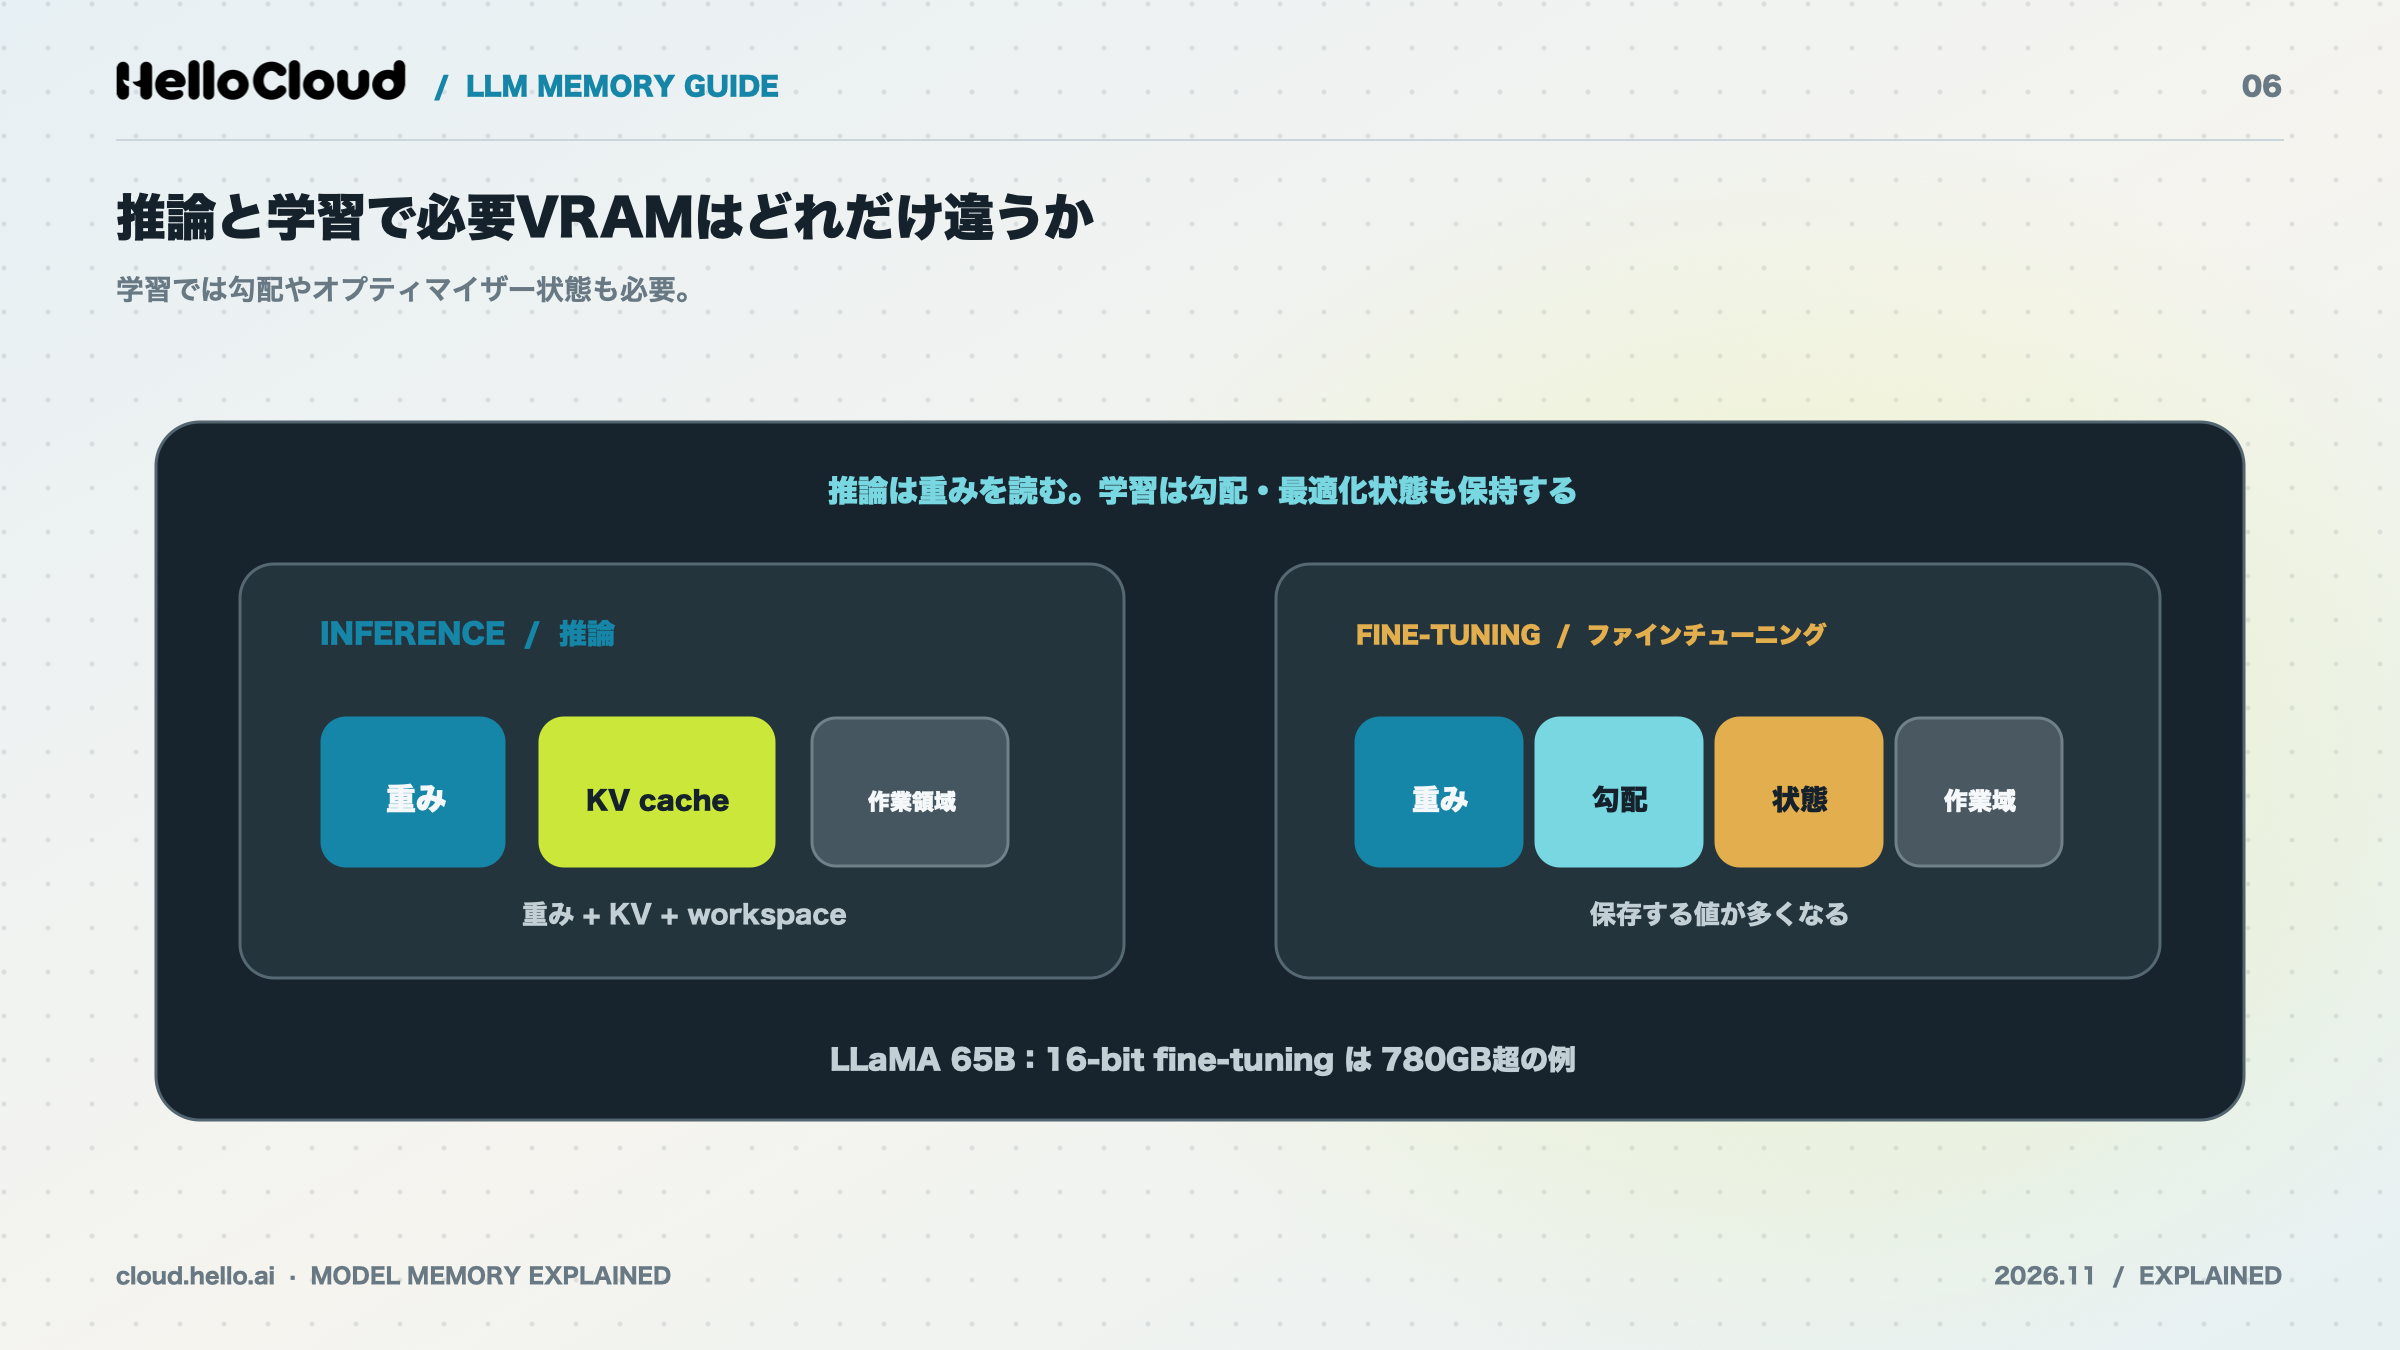
LLMのファインチューニングには、推論よりはるかに多くのVRAMが必要です。QLoRAの論文(Dettmers et al.、2023年)が、LLaMA 65Bの例を示しています。通常の16bitでファインチューニングするには、780GB超のGPUメモリが必要でした。65Bの重みを16bitで持つと130GBなので、その6倍にあたる量です。
出典:Dettmers et al.「QLoRA: Efficient Finetuning of Quantized LLMs」(2023年5月)
ファインチューニングで必要VRAMが増える理由
ファインチューニングでは、重みに加えて、重みを更新するための値もGPUのメモリに置きます。更新の方向を表す勾配や、更新の進み具合を記録するオプティマイザーの状態が、重みを更新するための値です。重みを読むだけの推論より置くものが多く、そのぶん必要なメモリが増えます。
Hugging Face Transformersのドキュメントも、学習中にGPUメモリを使うものを挙げています。重み・オプティマイザーの状態・勾配に加え、勾配の計算のために保存するアクティベーションです。
出典:Hugging Face Transformers公式ドキュメント「Model training anatomy」(2026年11月9日確認)
QLoRAで学習に必要なVRAMを減らした例
QLoRAは、4bitに量子化した重みを固定し、小さな追加の重み(LoRA)だけを学習する方法です。QLoRAの論文(2023年)は、65Bのファインチューニングを48GBのGPU 1枚で行える量までメモリを減らしました。65Bの重みは4bitなら32.5GBで、16bitの4分の1です。
ポイント: 学習は推論より大幅に多くのVRAMを使います。2023年のQLoRAの論文では、65Bの必要量が780GB超から48GBのGPU 1枚分まで下がりました。
計算結果から必要なVRAM容量を決める
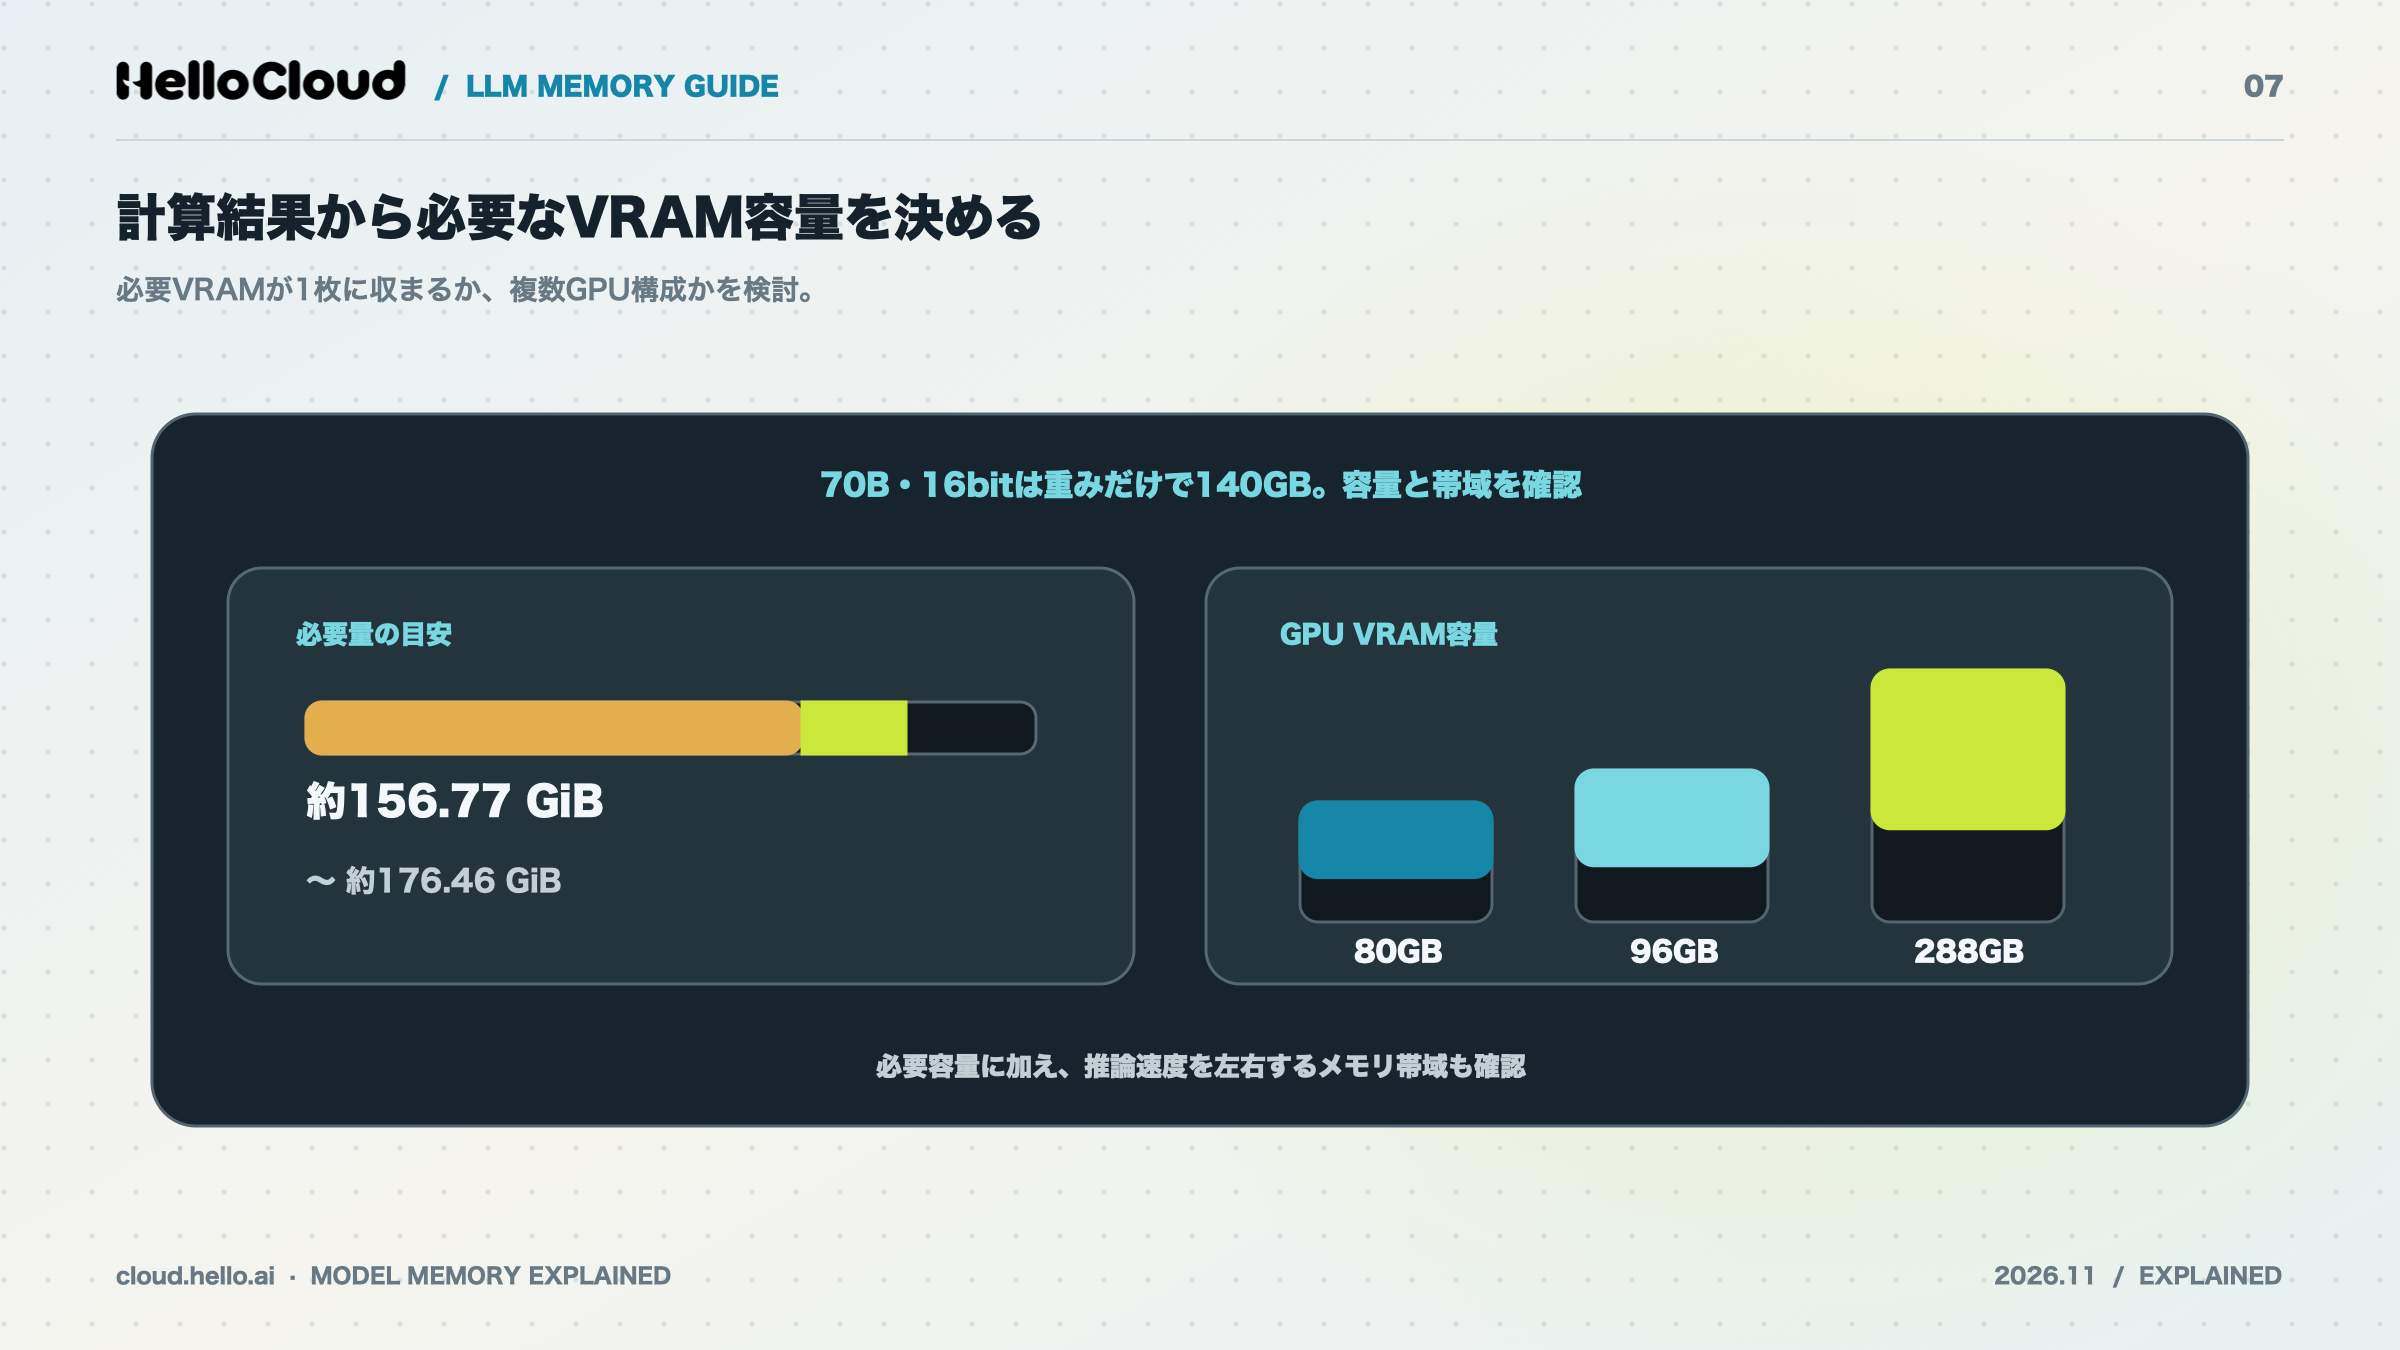
計算した必要VRAMがGPUのVRAM容量より小さければ、そのGPUにモデルが載ります。たとえば70Bを16bitで動かすと重みだけで140GBあり、80GBや96GBのGPU 1枚には載りません。容量に加えて、生成の速さを左右するメモリ帯域も確かめます。
重みの値をGPUのVRAM容量に当てはめる
モデルと条件 | 必要な量 | H100 SXM(80GB) | H100 NVL(94GB) | RTX 6000(96GB) | B300(288GB) |
|---|---|---|---|---|---|
Llama 3.1 8B Q4_K_M(重みだけ) | 4.58GiB | ○ | ○ | ○ | ○ |
7B・16bit・1リクエスト(合計) | 17.65GiB | ○ | ○ | ○ | ○ |
70B・16bit(重みだけ) | 140GB | × | × | × | ○ |
70B・16bit・64リクエスト(合計) | 176.46GiB | × | × | × | ○ |
出典:GPUの容量はNVIDIA H100製品ページ(2026年11月9日確認)とHelloCloud公式サイト(2026年11月5日確認)。必要な量は本記事の計算と、llama.cpp公式README・Databricksの値
○は1枚に載る、×は載らないことを表します。GBとGiBの差(約7.4%)を考えても、表の○×は変わりません。「重みだけ」の行は、KVキャッシュと作業領域を足してから判断します。1枚のGPUを分割して使う場合は、分割後のメモリ容量に当てはめて判断します。分割の単位と対応GPUは、GPUを分割するMIGの仕組みで解説しています。
VRAMが24GBのGPUの例として、RTX PRO 4000 Blackwellの仕様と24GBで動かせるモデルの目安も参考にしてください。
容量だけでなくメモリ帯域も確認する
VRAMに載っても、生成の速さの上限を決めるのはメモリ帯域です。Databricksのブログ(2023年10月)は、トークン生成の速さはピーク演算性能よりメモリ帯域のほうがよく予測できると説明しています。
1トークンごとに重みをすべて読むと考えると、上限は「メモリ帯域÷重みのサイズ」です。H100 SXM(3.35TB/s)で7B・16bit(14GB)なら、1リクエストあたり約239トークン/秒が理論上の上限になります。Databricksの2023年の測定(バッチサイズ1)では、実際に使えた帯域はピークに対して2×H100-80GBで60%でした。4×A100-40GBでは55%です。
出典:NVIDIA「NVIDIA H100 Tensor Core GPU」製品ページ(2026年11月9日確認)、Databricks「LLM Inference Performance Engineering: Best Practices」(2023年10月12日)
VRAM・メモリ帯域幅・消費電力を合わせたGPUの選び方は、AI GPUの選び方で解説しています。
VRAM不足のときの5つの対策
必要VRAMがGPUの容量を超えた場合は、次の5つから選びます。手元のGPUで足りるなら、手元で動かすのが手軽です。
対策 | 減るもの | 注意点 |
|---|---|---|
量子化する | 重み(Q4_K_MならF16の30.6%) | 出力の品質が下がる場合がある |
トークン数を短くする | KVキャッシュ(トークン数に比例) | 長い文書や会話を扱いにくくなる |
同時リクエスト数を減らす | KVキャッシュ(64→1で20GiB→0.312GiB) | 同時に使える人数が減る |
複数のGPUに分ける | GPU 1枚あたりの重みとKVキャッシュ | 分け方によっては、前の層の出力を待つ間に止まるGPUが出る |
VRAMの大きいクラウドGPUを使う | 手元のGPUの制約 | 料金とデータの保存先を確認する |
出典:「減るもの」の数値はllama.cpp公式READMEとDatabricks(2023年10月)の値。複数のGPUに分ける場合の注意点はNVIDIA Technical Blog(2023年11月)。2026年11月9日確認
ポイント: 必要VRAMとGPUの容量を同じ単位で比べて判断します。載らない場合は、量子化・トークン数・同時リクエスト数・GPUの枚数・クラウドGPUの5つから選びます。
必要なVRAMのGPUをクラウドで用意する方法
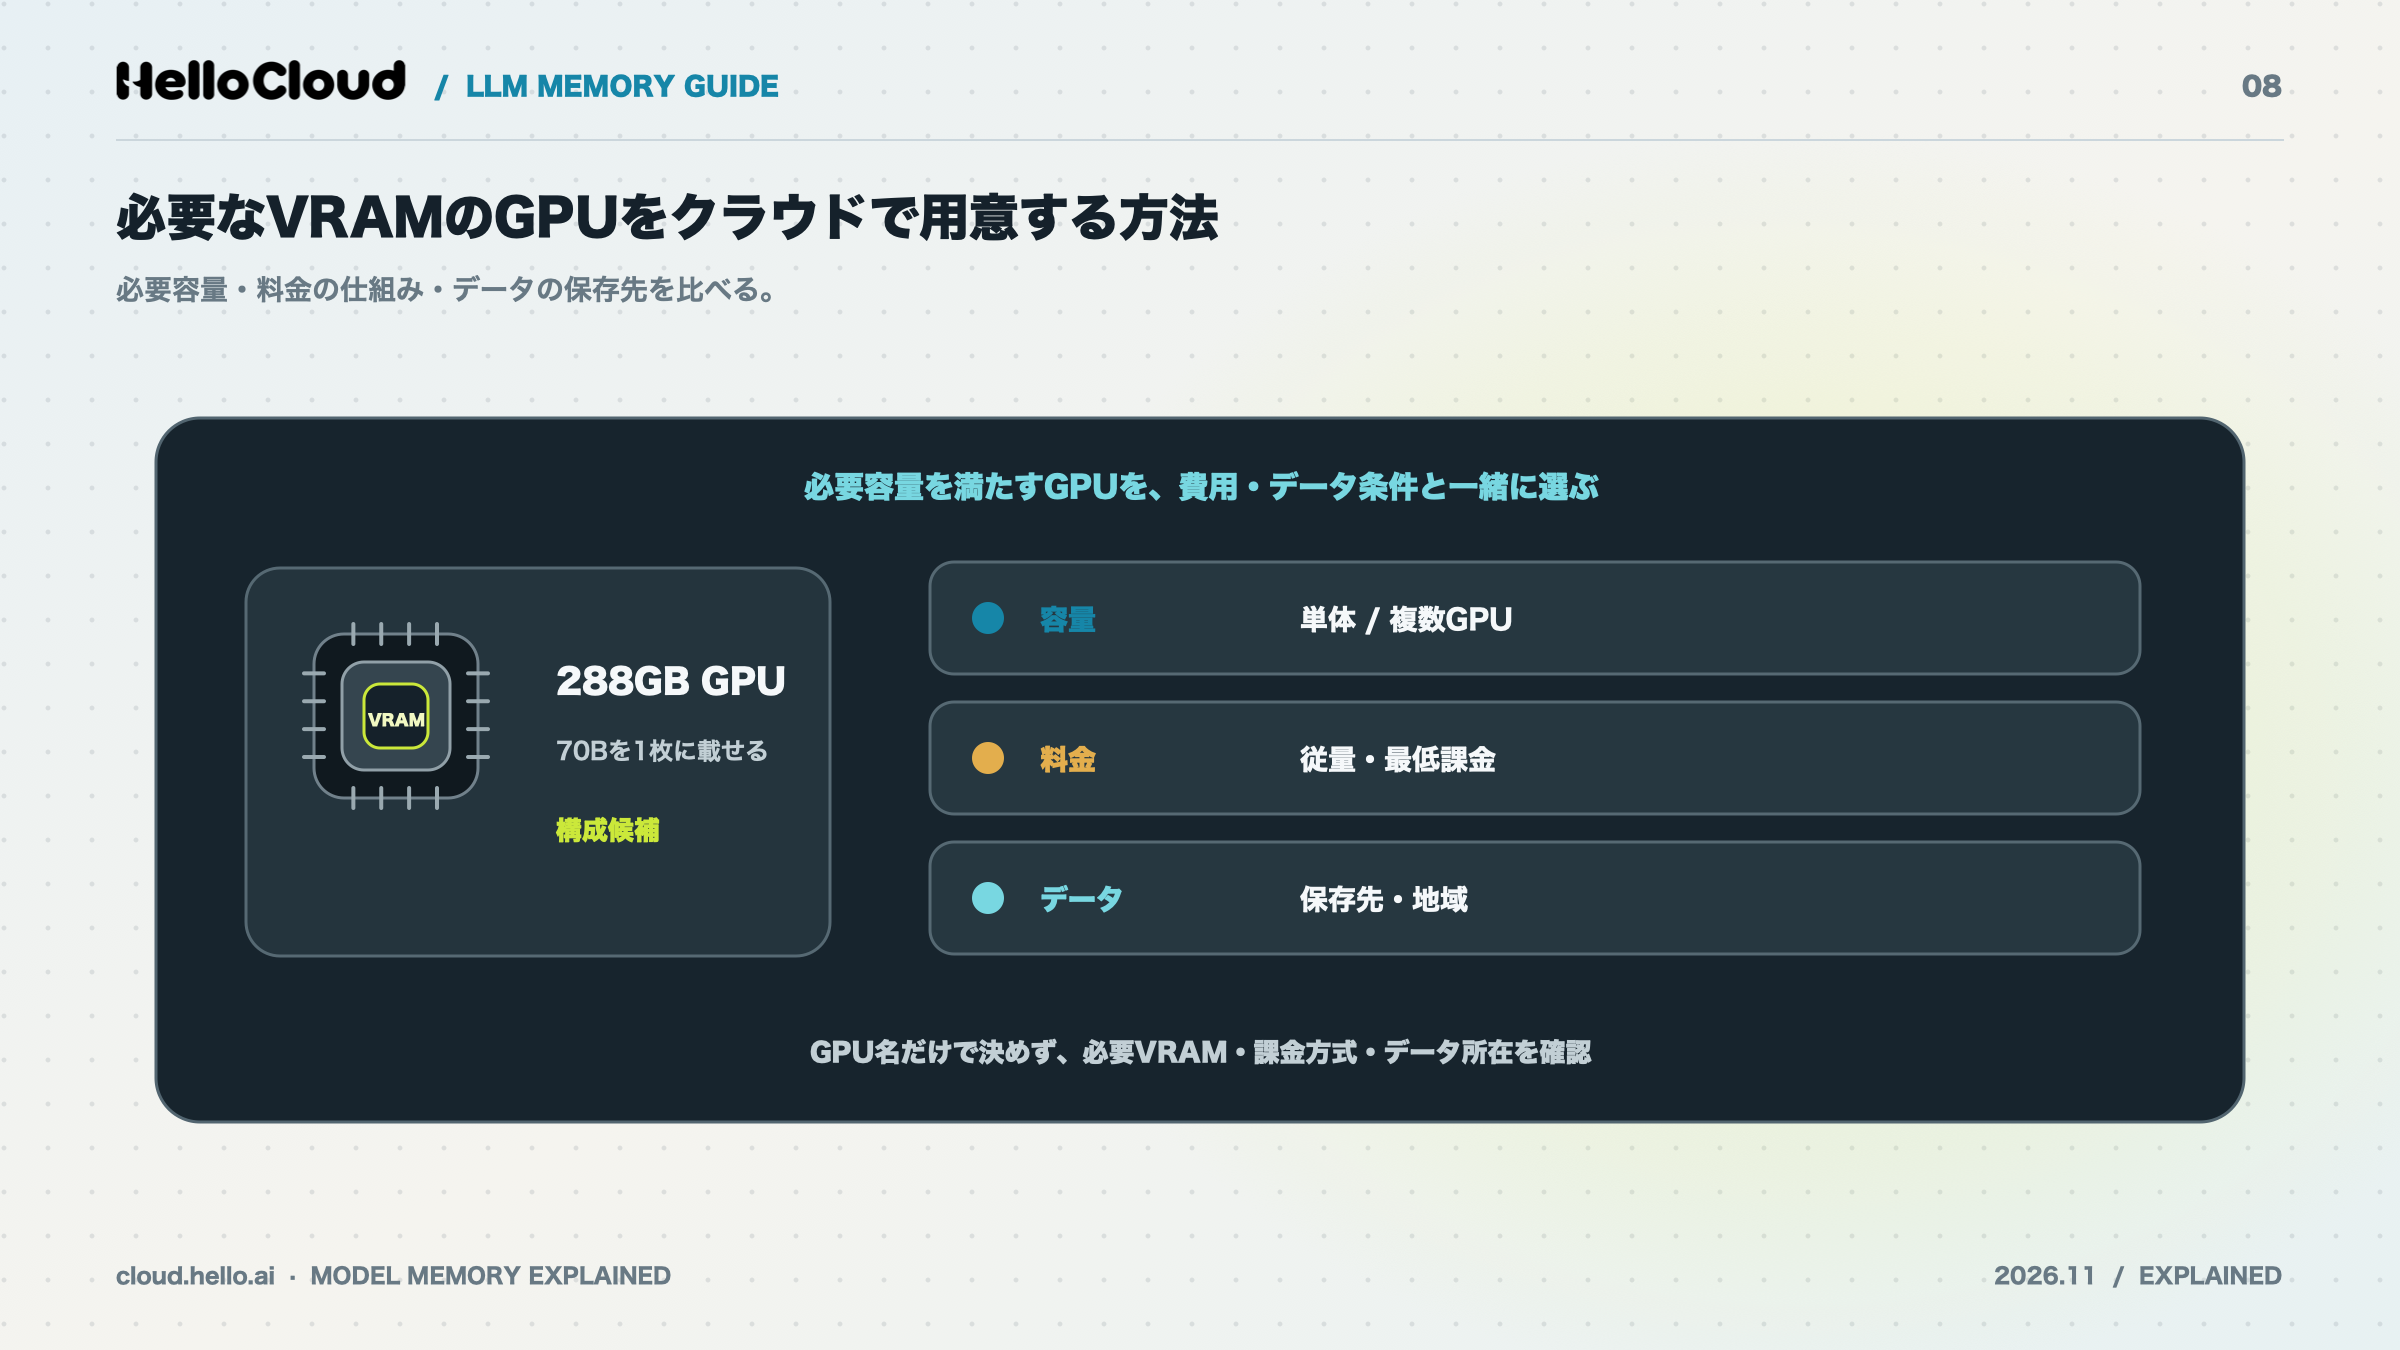
必要なVRAMのGPUが手元にない場合は、VRAMの大きいGPUをクラウドで借りるのも1つの方法です。例2の70B・16bit(約157〜176GiB)は、288GBのGPUなら1枚に収まります。クラウドGPUは、GPUの種類も料金の仕組みもサービスごとにさまざまです。国内サービスの料金を総額で並べた比較は、国内GPUクラウドの料金比較にまとめています。借りる前に、次の3項目を確かめておくと比べやすくなります。
クラウドGPUで確認しておく3つの項目
VRAM容量:計算した必要VRAMを、GPU 1枚か複数枚で満たせるか
料金の仕組み:従量課金か、何に料金がかかるか(公式サイトや資料で確認)
データの保存先:社内データや個人情報を扱う場合に、保存先の地域を選べるか
HelloCloudで使えるGPUと料金の仕組み
HelloCloudは、株式会社HelloCloudが提供する国産のGPUクラウドで、日本国内のデータセンターでAIモデルの実行と学習ができます。GPUインスタンスとサーバーレスGPU実行環境は、東京の2拠点(JPTY01/JPTY02)で稼働しています。
GPU | VRAM | RAM | vCPU | 参考価格(1インスタンス) | 公式サイトでの想定用途 |
|---|---|---|---|---|---|
RTX 6000 | 96GB | 96GB | 16 | ¥380/時間 | 軽量〜中規模LLMの推論、開発とプロトタイピングなど |
B300 | 288GB | 384GB | 24 | ¥1,480/時間 | 大規模モデルの学習、高負荷な推論など |
出典:HelloCloud公式サイト(2026年11月5日確認)。料金は1インスタンスあたりの参考価格です。税込・税別などの料金の条件は、資料請求で確認できます
GPUは使った分だけ支払う従量課金で、初期費用は不要です。申し込みの当日からGPUを使えます。利用規約(第1条1.4)では、利用者がコンテンツの保存先のリージョンを選べると定めています。
サーバーレスGPU実行環境では、コードにGPUの種類と枚数を書いて supa deploy でデプロイすると、指定したGPUでコンテナが起動する仕組みです。
注意: 表の料金は1インスタンスあたりの参考価格です。GPU以外の費用や請求の条件は、資料請求で確認できます。
HelloCloudの導入事例
HelloCloud公式サイトの導入事例には、次の2社が載っています。
株式会社ラス恋(CEO 山口様):会員の個人情報を扱うため、推論を国外のサーバーに出せないことが前提だった。「処理まで国内に閉じられる点が決め手で、申し込んだ日のうちに検証を始められました。」
Aimy株式会社(CEO 平野様):「国内のGPUで推論を常時動かしながら、同じ環境でモデルの学習まで進められるのが助かっています。」
出典:HelloCloud公式サイト(2026年11月5日確認)
計算したVRAMのGPUを、国内のクラウドで使いたい方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。LLM推論・モデル学習・バッチ処理での活用方法も、資料で紹介しています。
資料請求(HelloCloudの特徴と料金)
LLMの必要VRAM計算でよくある質問
70BのLLMには何GBのVRAMが必要?
70BのLLMを16bitで動かす場合、重みだけで140GBが必要です。KVキャッシュと作業領域を足すと、1,024トークン・1リクエストで約156.77GiBになります。Q4_K_Mの実効ビット数(4.8944)を当てはめた重みは約42.8GBですが、ビット数はモデルごとに違うため公開値で計算し直します。
計算より実際の使用量が多いのはなぜ?
KVキャッシュと作業領域が、計算の想定より大きくなることが主な理由です。accelerate estimate-memoryの推定も読み込み分だけで、推論に使う分は含みません。本文の「計算値と実際の使用量がずれる理由」で、4つの理由を整理しています。
「Q4」のモデルは4bitで計算していい?
4bitで計算すると、重みを小さく見積もります。llama.cppの公開値では、Llama 3.1 8BのQ4_K_Mは4.8944 bits/weightです。
ファインチューニングでは何GB必要?
推論よりはるかに多く、2023年のQLoRAの論文では65Bの16bitファインチューニングに780GB超が必要でした。QLoRAを使うと、48GBのGPU 1枚で足りる量まで減らせます。
まとめ:LLMの必要VRAMは3ステップで計算する
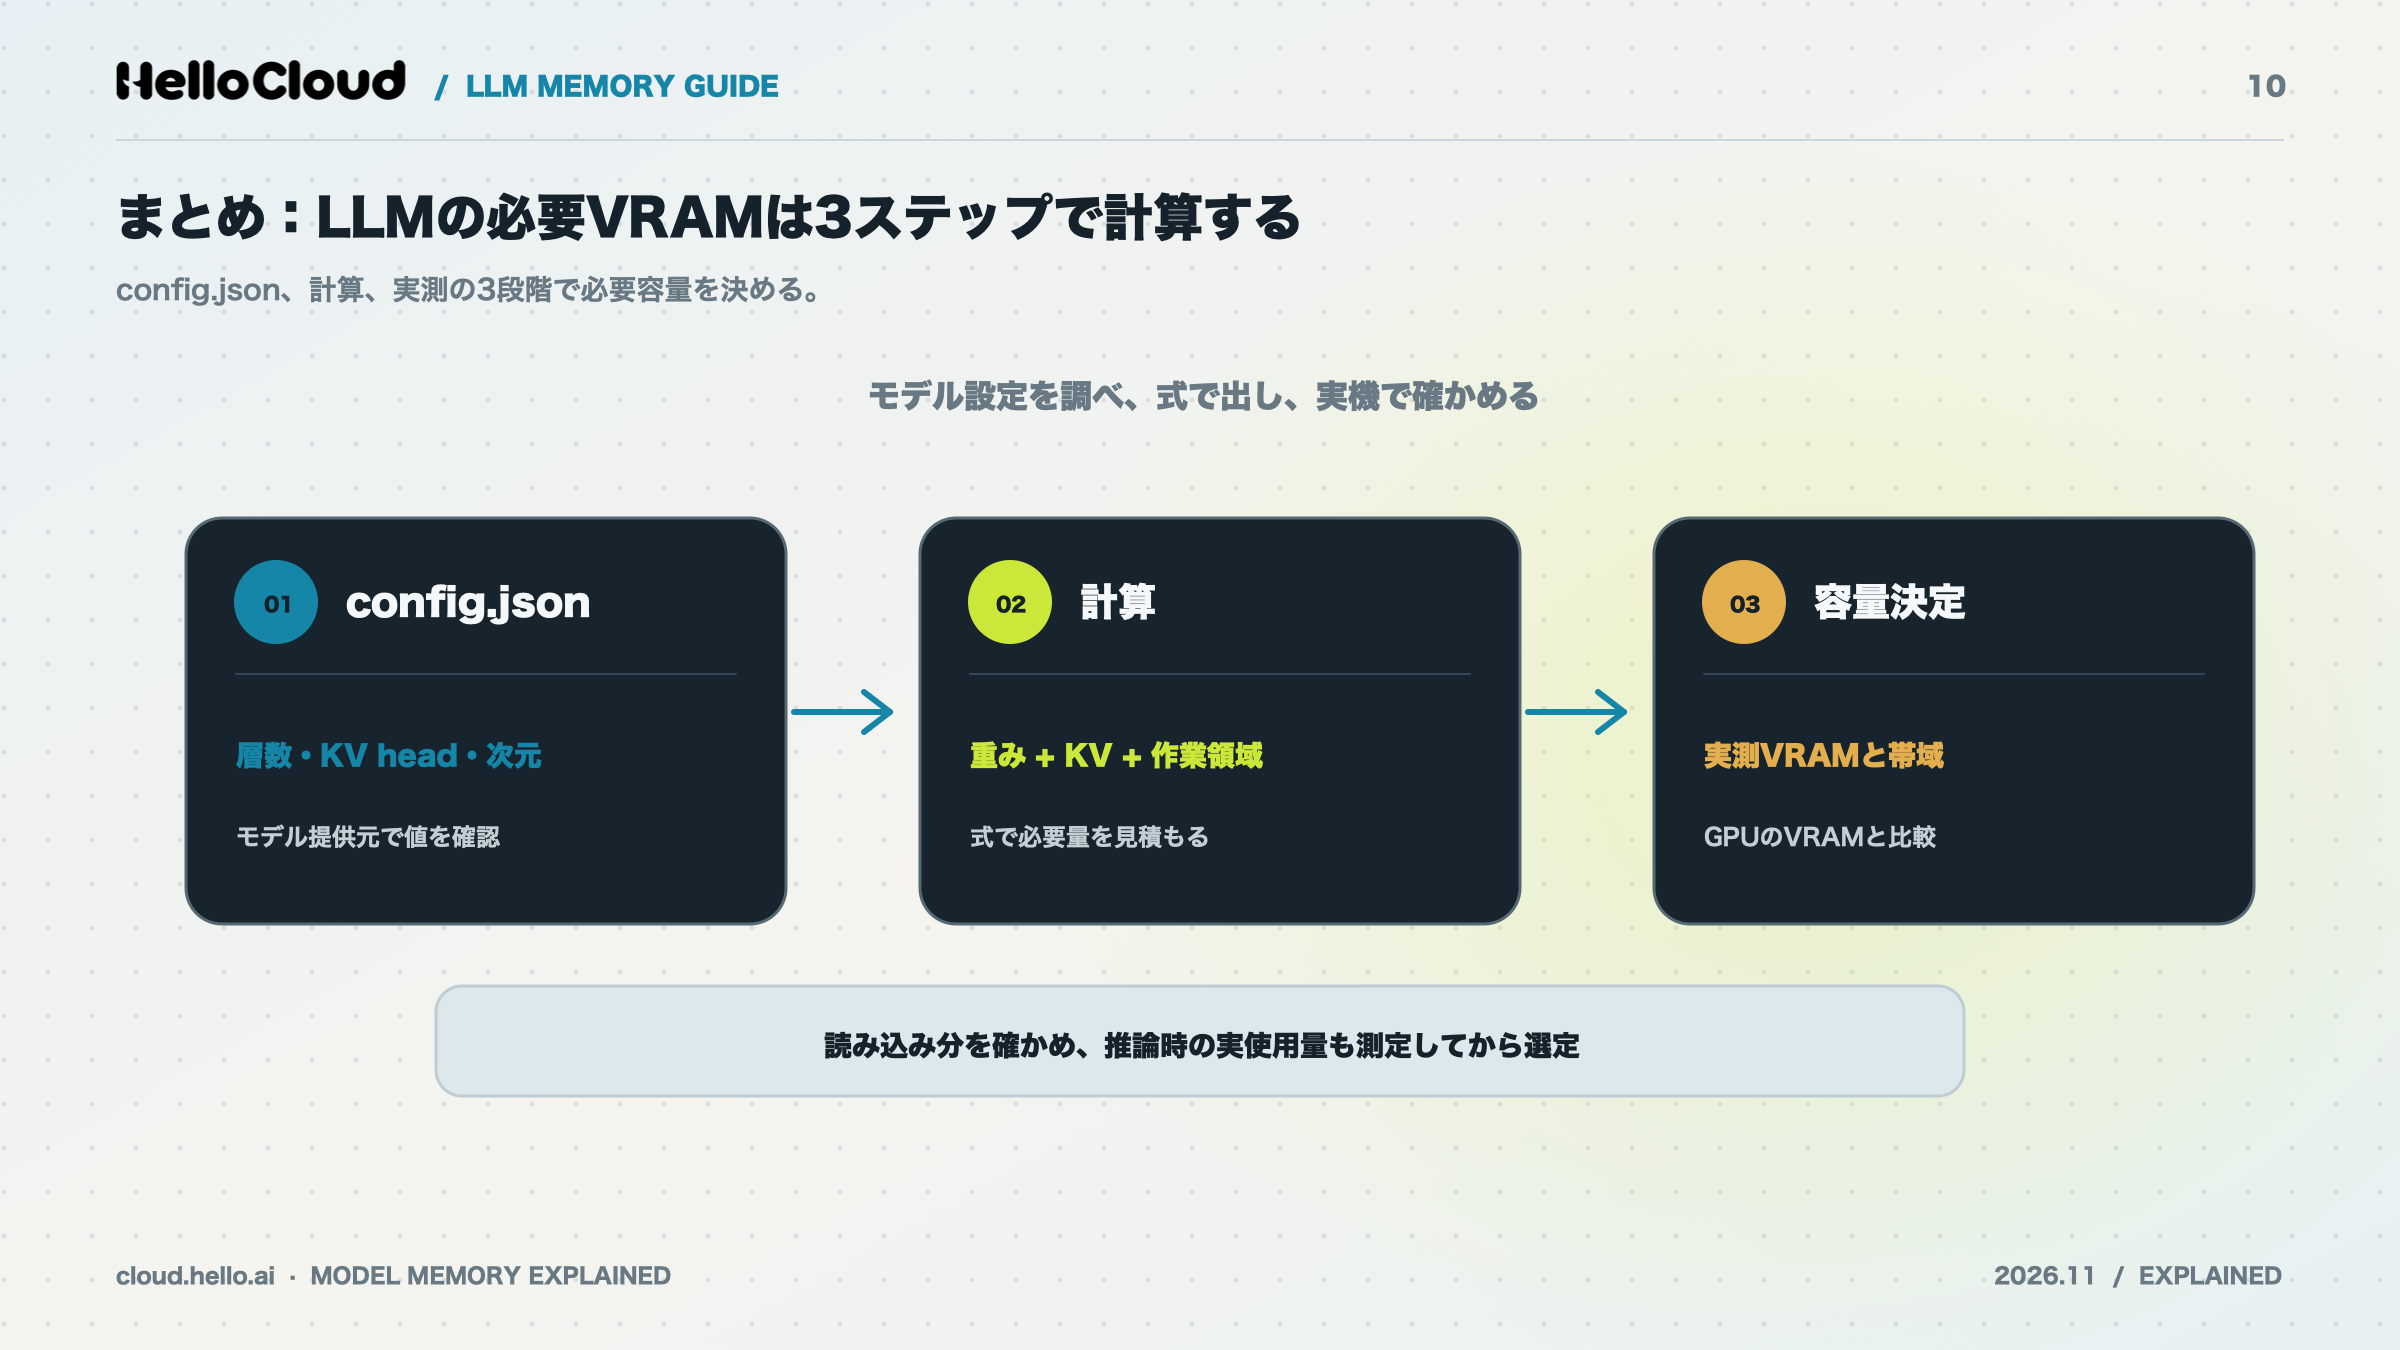
LLMの必要VRAMの見積もりは、次の3ステップです。
config.jsonで値を調べる:パラメータ数、層数、KVヘッド数、ヘッド次元を、提供元の公式ページで確認します。
式で計算する:重みとKVキャッシュを式で求めます。作業領域の目安は、重みの最大20%です。
確かめて容量を決める:estimate-memoryで読み込み分を確かめ、GPUのVRAM容量と同じ単位で比べます。
学習も行う場合は、推論の計算より大幅に多いVRAMが必要です。
必要なVRAMのGPUを、すぐに使える環境を探している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。HelloCloudのRTX 6000(VRAM 96GB)とB300(VRAM 288GB)は、申し込みの当日から使えるGPUです。
資料請求(HelloCloudの特徴と料金)
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


