この記事の結論
AI GPUは、VRAM・メモリ帯域幅・消費電力の3点で選びます。必要なVRAMは、パラメータ1つあたり学習で18バイト、推論で6バイトにアクティベーションの分を足して見積もれます(混合精度の場合)。用意の仕方は、初期費用・電力と冷却・データの保管場所などを比べて決めてください。
AI GPUとは?AIの学習と推論に使うGPUのこと
AI GPUは、AIモデルの学習と推論の計算に使うGPUです。学習はデータを使ってモデルのパラメータ(モデル内部の数値)を調整する処理、推論は学習済みモデルに入力を与えて結果を出す処理を指します。どちらも大量の掛け算と足し算をくり返すため、並列処理が得意なGPUで計算します。
AIにGPUが使われる理由:GPUを支える並列処理
AIの計算にGPUが使われる理由は、同じ種類の計算を多数のコアで同時に進める並列処理に向いているからです。ディープラーニングの計算の中心は行列の掛け算で、要素ごとの計算は互いに独立しているため、まとめて同時に処理できます。
GPUで機械学習を速くできることを早い時期に示した研究に、スタンフォード大学のRainaらが2009年に国際会議ICMLで発表した論文があります。論文では、大規模なモデルで深層信念ネットワーク(DBN)の学習がデュアルコアCPUの実装より最大70倍、スパースコーディングが従来手法の5〜15倍速くなったと報告されました(出典:Raina ほか、ICML 2009)。2009年当時の製品同士の比較であり、現在の性能差を示す数値ではありません。
CPUとGPUの役割の違い
AIの処理では、CPUがデータの読み込みや前処理、全体の制御を、GPUが行列計算などの重い計算を受け持ちます。CPUは少数の高性能なコアで分岐の多い処理を順に進め、GPUは多数のコアで同じ計算をまとめて進めるのが得意です。コアの構造の違いは、CPUとGPUの違いを図で比べた解説で確かめられます。
NVIDIAのデータセンター向けAI GPUとグラボの違い
NVIDIAのデータセンター向けAI GPUとPC向けのグラボ(グラフィックボード)を比べるときは、まずVRAMの容量を見ます。データセンター向けの例であるNVIDIA H200は、HBM3e(高帯域のメモリ規格)のVRAMを141GB搭載した製品です。
製品 | VRAM | メモリ帯域幅 | TDP | MIG(1枚を分けて使える数) |
|---|---|---|---|---|
NVIDIA H200 SXM | 141GB | 4.8TB/s | 最大700W | 最大7 |
NVIDIA H200 NVL | 141GB | 4.8TB/s | 最大600W | 最大7 |
出典:NVIDIA H200 GPU 製品ページ(2026年11月18日確認。ページ上で暫定値と記載)
H200は、H100と比べてVRAMの容量がほぼ2倍、メモリ帯域幅が1.4倍です(出典:NVIDIA H200 GPU 製品ページ)。PC向けのグラボの例では、GeForce RTX 5090のVRAMは32GB(GDDR7)、メモリ帯域幅は1,792GB/sで、VRAMの容量はH200の4分の1以下です(出典:NVIDIA GeForce RTX 5090 製品ページ、NVIDIA GeForce ニュース、2026年11月18日確認)。
ポイント:
AI GPUは、AIの学習と推論の計算を並列で速く処理するGPUです。データセンター向けのNVIDIA H200のVRAMは141GBで、PC向けのGeForce RTX 5090の32GBの4倍以上あります。
ディープラーニングの学習と推論で必要なGPUの違い
ディープラーニングでは、学習のほうが推論より多くのVRAMを使います。Hugging Faceの公式ドキュメントによると、混合精度(fp32とfp16を組み合わせる計算方法)とAdamWを使う学習では、パラメータ1つあたり18バイトが必要です。推論では6バイトで、どちらにもアクティベーション(計算途中の値)の分が加わります(出典:Hugging Face Transformers 公式ドキュメント v4.44.2)。
学習:パラメータ1つあたり18バイト+αが必要
学習では、モデルの重みに加えて、重みの直し方を示す勾配と、オプティマイザ(重みの更新方法を決める仕組み)の状態をVRAMに置きます。
項目 | 学習(混合精度+AdamW) | 推論(混合精度) |
|---|---|---|
モデルの重み | 6バイト | 6バイト |
オプティマイザ状態 | 8バイト | 不要 |
勾配 | 4バイト | 不要 |
合計 | 18バイト | 6バイト |
出典:Hugging Face「Model training anatomy」v4.44.2(2026年11月18日確認。アクティベーションの分は含まない)
4B(40億パラメータ)のモデルを学習する場合、18バイト×40億=720億バイトで、約72GBにアクティベーションの分が加わります(1GB=10億バイトで換算)。公式ドキュメントには、4Bのモデルを混合精度・バッチサイズ16で学習すると約85GB必要になる例が載っています(出典:Hugging Face 公式ドキュメント v5.14.0)。公式ドキュメントに内訳の記載はありませんが、式の約72GBとの差の約13GBは、アクティベーションや一時的なデータなど、式に含まれない分と考えられます。
推論:パラメータ1つあたり6バイト+αが必要
推論では勾配とオプティマイザ状態が要らないため、パラメータ1つあたりのVRAMは混合精度で6バイトです。同じ4Bのモデルなら6バイト×40億=240億バイトとなり、約24GBにアクティベーションの分を足した量が目安です。アクティベーションの量はバッチサイズや入力の長さで変わるため、実際の必要量は式の値より大きくなります。推論の処理の流れは、推論の仕組みを入門向けにまとめた解説が参考になります。
事例:推論を常時動かしながら同じ環境で学習も進める
推論と学習を同じGPU環境で並行して使う例が、HelloCloud公式サイトの導入事例に載っています。Aimy株式会社(CEO 平野様)は、「AIキャラクターとの対話は、推論を止められないサービスです。国内のGPUで推論を常時動かしながら、同じ環境でモデルの学習まで進められるのが助かっています」と話しています(出典:HelloCloud公式サイト、2026年11月18日確認)。推論を常に動かすサービスでは、推論に使うVRAMを先に確保し、残りの容量で学習を回せるかを式で見積もってください。
ポイント:
混合精度の場合、学習はパラメータ1つあたり18バイト、推論は6バイトにアクティベーションの分を足したVRAMが要ります。アクティベーションを除いたパラメータ1つあたりの量で比べると、学習は推論の3倍です。
AI GPUの選び方:VRAM・帯域幅・消費電力の3観点
AI GPUは、VRAM、メモリ帯域幅、消費電力の順に確認して選びます。使うモデルが載らないGPUは、ほかの性能が高くてもそのままでは動かせないため、VRAMを最初に見ます。メモリ帯域幅で処理の速さを比べたら、消費電力から電源と冷却の条件を確かめてください。
VRAM:使うモデルが載る容量があるか
VRAMは、使うモデルの重みとアクティベーションが収まるかで判断します。推論の目安は「6バイト×パラメータ数+アクティベーション」です。7B(70億パラメータ)のモデルなら6×70億=420億バイトで、約42GBにアクティベーションの分を足した量になります(混合精度の場合。出典:Hugging Face 公式ドキュメント v4.44.2)。
同じ7Bのモデルを学習するなら、18×70億=1,260億バイトで、約126GBにアクティベーションの分が加わる計算です。精度や量子化ごとの見積もりは、LLMに必要なVRAMの計算方法を解説した記事で詳しく扱っています。
メモリ帯域幅:VRAMとデータをやり取りする速さ
メモリ帯域幅は、VRAMとGPUの計算部分の間で1秒あたりにやり取りできるデータ量で、TB/s(テラバイト毎秒)で表します。AIの計算では重みをくり返しVRAMから読み出すため、帯域幅が狭いと計算部分がデータを待つ時間が増えます。NVIDIA H200のメモリ帯域幅は4.8TB/sで、H100の1.4倍です(出典:NVIDIA H200 GPU 製品ページ、2026年11月18日確認)。
消費電力:TDPと電源・冷却の条件
消費電力は、TDP(熱設計電力:GPUが消費する電力の上限の目安)で確認します。NVIDIA H200の最大TDPは、SXM版で最大700W、NVL版で最大600Wです(出典:NVIDIA H200 GPU 製品ページ、2026年11月18日確認)。自分で設置するなら、TDPに見合う電源容量と冷却設備が要ります。GPUクラウドなら電源と冷却は事業者の側で用意されるため、利用者による設備の準備は不要です。消費電力の見方は、GPUの消費電力を詳しく扱った解説にまとめています。
機械学習用PCで確認するスペック
機械学習用のPCでは、GPUのVRAMに加えて、CPU・メモリ・ストレージ・電源も確認してください。
項目 | 確認すること |
|---|---|
GPU(VRAM) | 使うモデルの必要量を上回るか |
CPU | 前処理でGPUを待たせないか |
メモリ | 学習データや前処理の途中のデータを置けるか |
ストレージ | モデルとデータセットを保存できる容量があるか |
電源 | GPUのTDPを含めた合計に足りるか |
出典:HelloCloud編集部作成(確認項目の一覧)
CPUとGPUの組み合わせ方は、CPUとGPUのバランスを解説した記事を参照してください。
ポイント:
AI GPUは、VRAM、メモリ帯域幅、消費電力の順で確認して選びます。VRAMは「バイト数×パラメータ数+アクティベーション」で見積もれます。
ノートPCに外付けGPUをつなぐ場合は、Thunderbolt接続のGPUで性能が落ちる理由を先に確認してください。
AI GPUを用意する2つの方法:購入とGPUクラウド
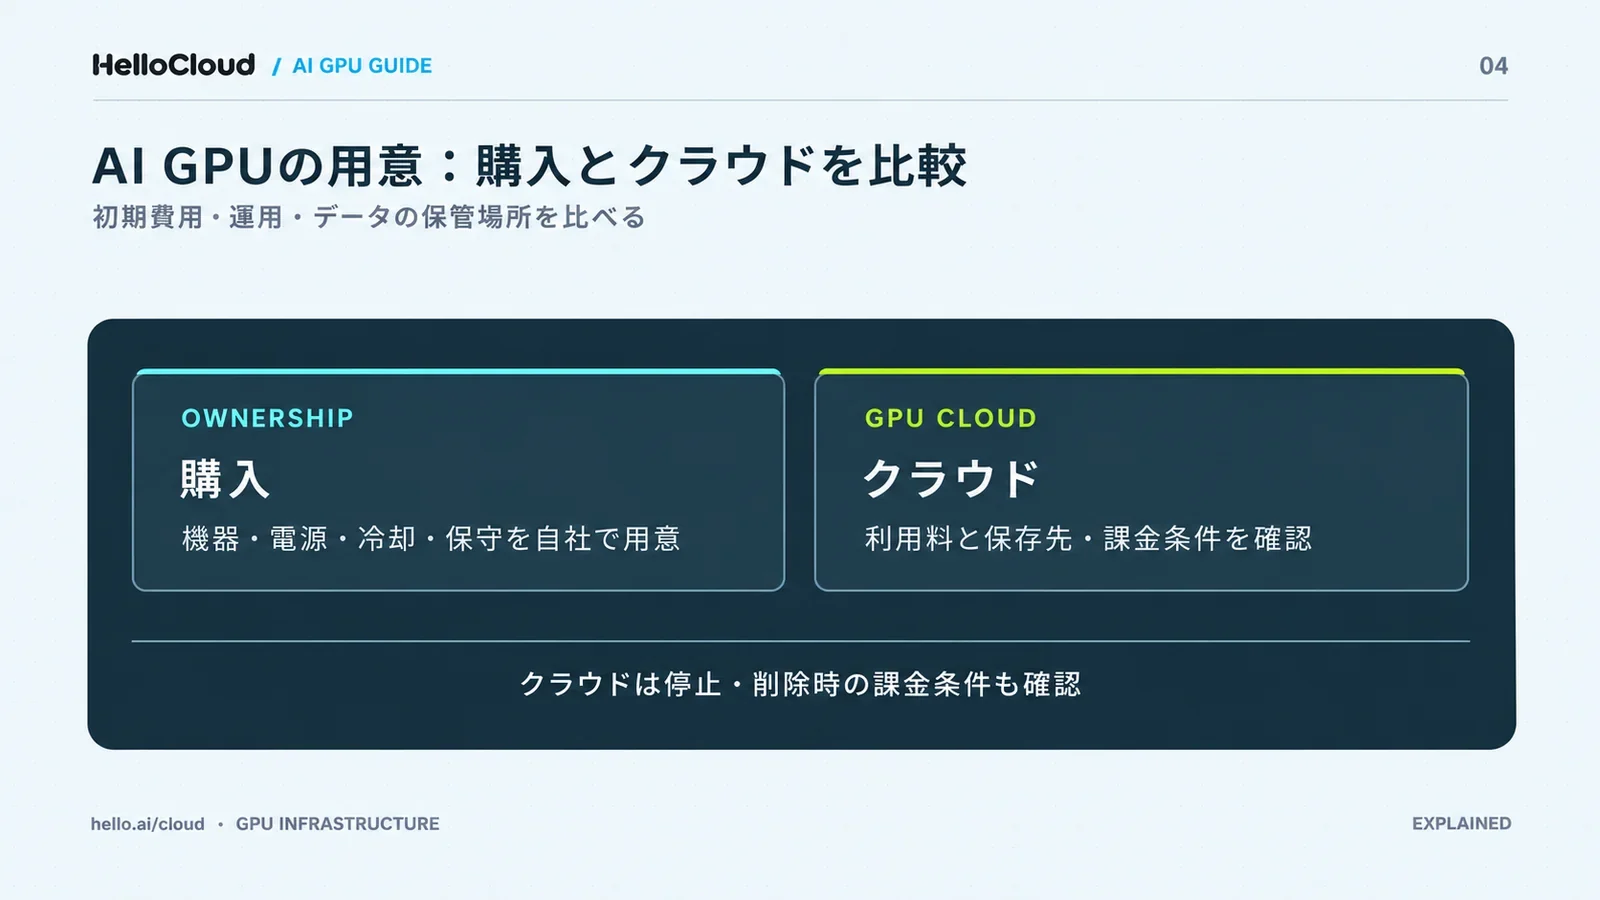
AI GPUは、PC・サーバーを購入するか、GPUクラウドで借りるかのどちらかで用意します。GPUクラウドの仕組みや使い方は、GPUクラウドとは何かを解説した記事で説明しています。比べる観点は次の5つです。
比べる項目 | PC・サーバーの購入 | GPUクラウド |
|---|---|---|
初期費用 | 機器の購入費 | 事業者の料金体系による |
電力・冷却 | 自社で用意する | 事業者が用意する |
続けてかかる費用 | 電気代・保守費 | 利用料(従量課金なら使った分) |
データの保管場所 | 自社の設置場所 | 事業者のデータセンター |
使い始めるまで | 調達・設置の期間 | 事業者の手続きによる |
出典:HelloCloud編集部作成(比べる観点の一覧)
PC・サーバーを購入する場合の注意点
PC・サーバーを購入する場合は、購入費に加えて、電源・冷却・設置場所・保守の負担を見込んでください。H200のTDPはSXM版で最大700Wのため、複数枚を載せるサーバーでは電源容量と冷却能力の確認が欠かせません。自社運用とクラウドを費用の面で比べるなら、稼働率別にオンプレミスとクラウドの損益分岐を計算した記事が役立ちます。
GPUクラウドを使う場合の注意点
GPUクラウドでは、課金、料金の変更、データの保管場所の3点に注意します。料金の変更の通知方法は利用規約で、保存先のリージョン(データセンターの地域)は申し込む前に確かめてください。停止中にどこまで課金されるかは、GPUクラウドの停止中の課金を解説した記事で整理しています。
注意:
従量課金のGPUクラウドでは、使い終わったインスタンス(クラウド上の仮想サーバー)を起動したままにすると料金がかかり続けます。停止と削除で課金がどう変わるかは事業者ごとに違うため、料金ページで確認してください。
国内のGPUクラウドとデータの保管場所
国内のGPUクラウドは、経済産業省が経済安全保障推進法にもとづいて整備を支援している分野です。経済産業省は2024年4月、GPUクラウドサービスの提供に取り組む5件を認定し、合計で最大725億円の助成を決めました。
認定事業者 | 最大助成額 |
|---|---|
さくらインターネット | 約501億円 |
KDDI | 約102.4億円 |
ハイレゾ・ハイレゾ香川(共同申請) | 約77.0億円 |
RUTILEA・AI福島(共同申請) | 約25.6億円 |
GMOインターネットグループ | 約19.3億円 |
出典:経済産業省 ニュースリリース(2024年4月19日発表、2026年11月18日確認)
経済産業省の同じ発表では、基盤クラウドの国内市場で国内に事業基盤を持つ事業者のシェアは約3割とされ、海外から提供されるサービスへの依存が高まっていると説明されています。IDCによると、2025年の国内AIインフラ支出の90.6%はハイパースケーラー(大規模クラウド事業者)を含むサービスプロバイダーによるものです(出典:IDC、2026年5月)。
HelloCloud公式サイトの導入事例によると、株式会社ラス恋(CEO 山口様)は、「会員の個人情報を扱うため、推論も国外のサーバーに出せないのが前提でした。処理まで国内に閉じられる点が決め手で、申し込んだ日のうちに検証を始められました。レコメンドのモデルも、調達を待たずに本番へ載せられています」と話しています(出典:HelloCloud公式サイト、2026年11月18日確認)。保管場所の決め方は、データの保管場所の考え方を解説した記事にまとめています。
注意:
データを国内に置くだけで、個人情報の取り扱いに関する社内規程や法令上の確認が不要になるわけではありません。扱うデータの要件は、社内の法務・セキュリティ担当者に確認してください。
クラウドGPUで最初の推論を動かすまでの流れ
クラウドGPUで最初の推論を動かすまでは、次の5段階です。
申し込む:アカウントを作り、利用規約を確認します。
GPUの種類を選ぶ:式で出したVRAMの必要量を上回るGPUが目安です。
コードやコンテナをデプロイする:推論のコードと依存ライブラリを載せる段階です。
推論を実行する:小さな入力で結果を確かめてから、本番の入力で動かしてください。
停止・削除する:使い終わったインスタンスを止め、不要なデータを消します。
OSやドライバの準備を含めた手順は、GPUクラウドの環境構築をまとめた解説で確認してください。
ポイント:
AI GPUの用意の仕方は、表の5項目、なかでも初期費用、電力と冷却、データの保管場所を比べて決めます。GPUクラウドを使うなら、インスタンスの停止とリージョンの確認を手順に入れてください。
国内でAI GPUを使える環境を検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料の請求を受け付けています。HelloCloudは、申し込みの当日からGPUを使える国産のGPUクラウドです。
資料請求(HelloCloudの特徴と料金)
国内GPUクラウドHelloCloudでAI GPUを使う場合
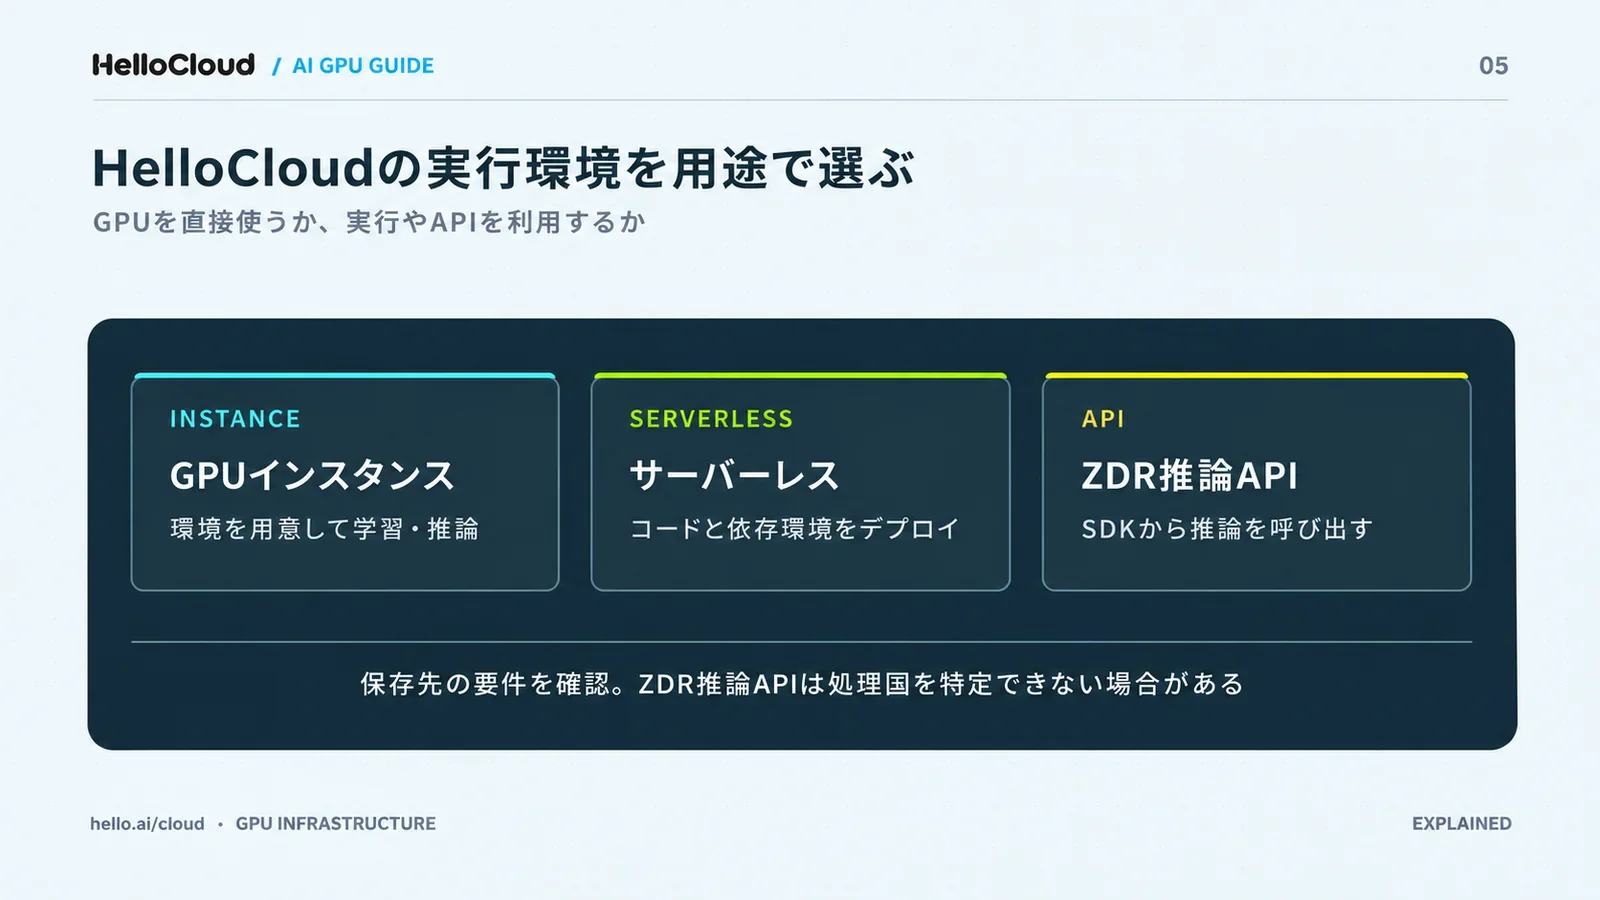
HelloCloudは、株式会社HelloCloudが提供する国産のGPUクラウドです。東京の2拠点(JPTY01/JPTY02)でGPUインスタンスとサーバーレスGPU実行環境が稼働しており、GPUの料金は使った分だけ支払う従量課金です(出典:HelloCloud公式サイト、2026年11月18日確認)。
GPUインスタンス:RTX 6000とB300
GPUインスタンス | VRAM | RAM | vCPU | 参考価格 | 用途(公式サイトの記載) |
|---|---|---|---|---|---|
RTX 6000 | 96GB | 96GB | 16 | ¥380/時間 | 軽量〜中規模LLMの推論、画像・音声のバッチ処理、開発・プロトタイピング |
B300 | 288GB | 384GB | 24 | ¥1,480/時間 | 大規模モデルの学習、高負荷な推論ワークロード、生成AIの本番運用 |
出典:HelloCloud公式サイト(2026年11月18日確認。参考価格は1インスタンスあたりで、税込・税別の記載なし)
GPUインスタンスの料金は、起動している時間だけ秒単位でかかります。公式サイトに載っていない料金の条件は、資料請求で確認できます。
サーバーレスGPU実行環境:GPUを指定してデプロイ
サーバーレスGPU実行環境では、コードにGPUの種類と枚数を書いて「hellocloud deploy」コマンドでデプロイすると、指定したGPUでコンテナが起動します。公式サイトには、次の実行例が載っています。
hellocloud deploy train.py
サーバーやクラスターの用意は不要で、依存ライブラリはコンテナイメージにまとめ、コンテナの数は負荷に合わせて自動で増減します。
ZDR推論API:OpenAI SDKのまま接続先を差し替え
ZDR推論APIは、OpenAI SDKのまま接続先のURL・APIキー・モデル名を差し替えるだけで使える推論APIです。ZDR(ゼロデータ保持)の方針により、プロンプトと生成結果は保存されず、学習にも使われません。記録されるのは、モデル名やトークン数など課金と監査に必要な情報です。処理基盤は、モデルに応じて自社保有のGPUと、TEE(信頼できる実行環境)を用いた分散GPUを使い分けています。分散GPUは、ノードを運用する事業者も処理中のプロンプトと生成結果を読み出せない構成ですが、ノードの所在国は特定できません。料金に公開価格はなく、担当者が案内します。
データの扱いとSLA
HelloCloudのSLAでは、APIのリクエスト成功率を対象に、月間稼働率99.9%以上の維持に向けて商業上合理的な範囲で努力すると定めています。99.9%を下回った月は、障害発生後2回目の請求期間の末日までにメールで申請すると、補償率に応じたクレジットが同じアカウントの今後の利用料金に充当される仕組みです。データの保存先のリージョンや契約終了後のデータの扱いは利用規約で定められており、詳しい条件は資料請求で確認できます。
月間稼働率 | 補償率 |
|---|---|
99.0%以上99.9%未満 | 10% |
95.0%以上99.0%未満 | 25% |
95.0%未満 | 100% |
出典:HelloCloud サービスレベル契約(SLA)(2026年11月18日確認)
注意:
SLAの99.9%は、APIのリクエスト成功率を維持するための努力目標で、保証ではありません。クレジットを受け取るには期限内の申請が必要で、GPU上で実行するプログラムの計算精度や処理時間も保証の対象外です。契約終了後のデータの扱いは、契約前に利用規約で確認してください。
ポイント:
HelloCloudのGPUインスタンスとサーバーレスGPU実行環境は東京の2拠点で稼働しています。ZDR推論APIは所在国を特定できない分散GPUで処理する場合があるため、保管場所の要件に合わせて選んでください。
AI GPUに関するよくある質問
AIの開発にGPUは欠かせませんか?
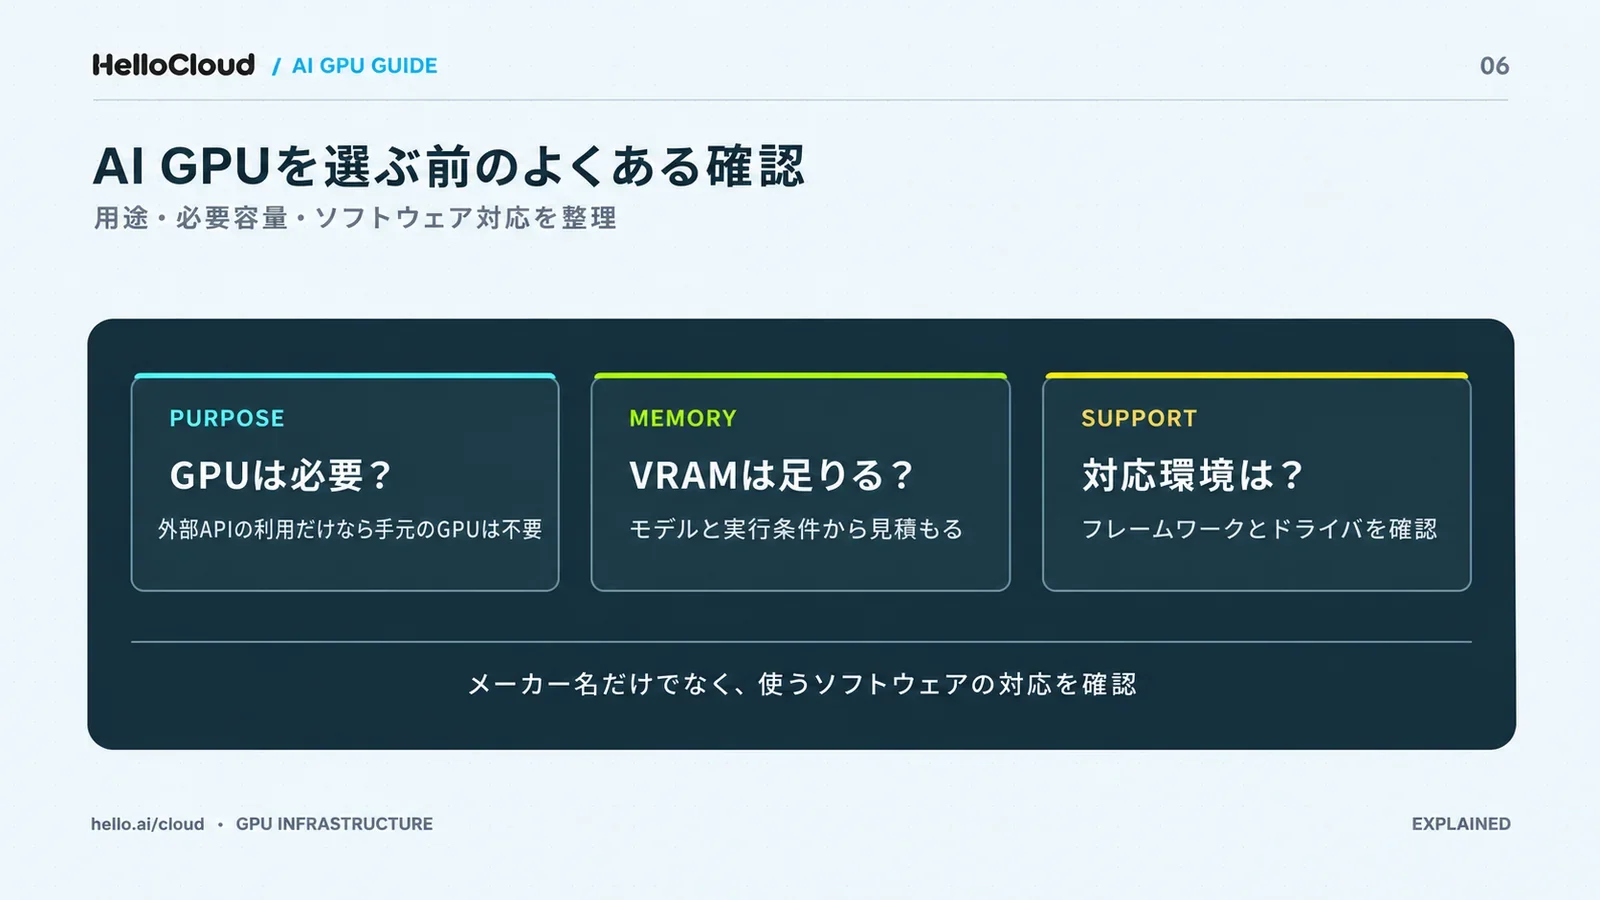
AIの開発にGPUが要るかは、扱うモデルの大きさと、学習まで自分で行うかで決まります。4Bのモデルの学習には約72GBにアクティベーションの分を足したメモリが要るため(混合精度とAdamWの場合)、GPUを前提に計画します。外部の推論APIを呼び出して使うだけなら、手元にGPUを用意する必要はありません。まずは必要なVRAMを式で見積もってください。
AIに使うGPUのVRAMは何GB必要ですか?
AIに使うGPUのVRAMは、推論なら6バイト、学習なら18バイトにパラメータ数を掛け、アクティベーションの分を足して見積もれます(混合精度の場合)。7Bのモデルの推論なら約42GBが目安の出発点です。細かい見積もり方は、LLMのVRAM必要量を計算する手順の解説で紹介しています。
AIに使うGPUはNVIDIA製を選ぶべきですか?
AIに使うGPUのメーカーは、使うフレームワークが対応しているかで判断します。PyTorchの公式サイトでは、NVIDIAのGPU(CUDA)とAMDのGPU(ROCm)のどちらにも対応したインストール手順が案内されています(出典:PyTorch「Get Started」、2026年11月18日確認)。使う予定のフレームワークとライブラリの公式ドキュメントで、対応するGPUとドライバを確かめてから選んでください。
TPUやAIアクセラレーターとGPUの違いは?
TPUやAIアクセラレーターは、AIの計算に用途を絞って設計されたチップで、幅広い計算に使えるGPUとは設計の考え方が違います。用途ごとの違いは、TPUとGPUの違いを比べた解説で詳しく説明しています。
まとめ:AI GPUの選び方と用意の仕方
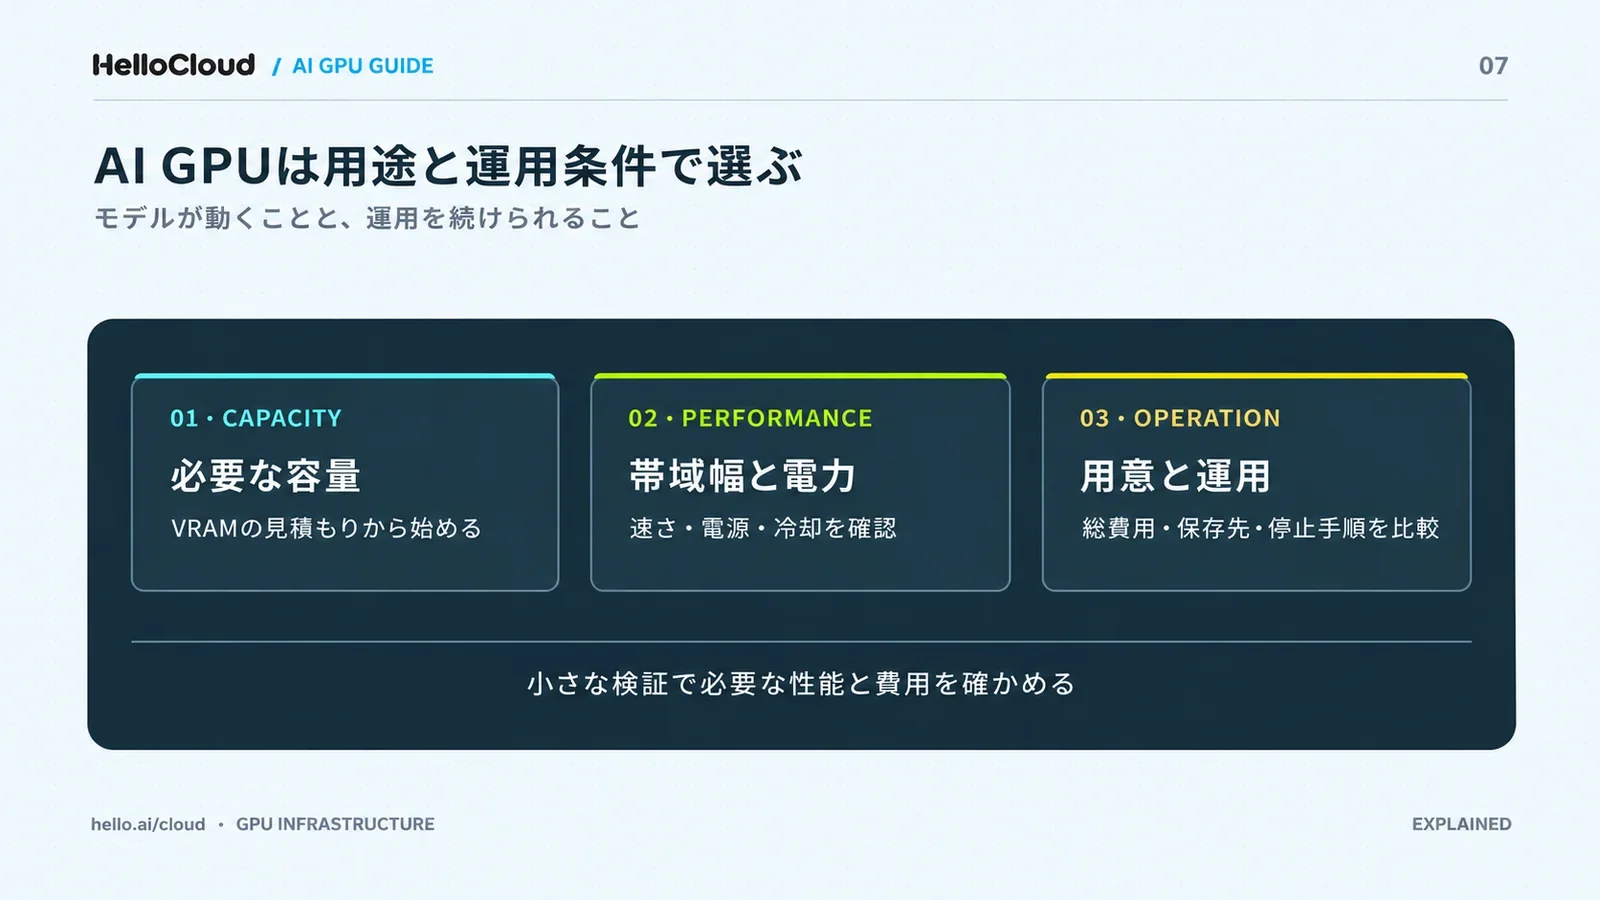
AI GPUは、VRAMにモデルが載るか、メモリ帯域幅、消費電力の3点で選びます。VRAMの必要量は、パラメータ1つあたり学習で18バイト、推論で6バイトにアクティベーションの分を足した量です(混合精度の場合)。用意の仕方は、初期費用、電力と冷却、データの保管場所などを比べて決めてください。
AI GPUの用意の仕方を社内で検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料の請求を受け付けています。AI開発での活用方法(LLM推論・モデル学習・バッチ処理)も紹介しており、受付後に担当者からメールで連絡があります。
資料請求(HelloCloudの特徴と料金)
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


