この記事の結論
AWSのGPUインスタンス料金は、確認日つきの公式単価に、付帯費用と為替を足した総額で判断します。購入方式はPoC・本番推論・学習のピークで使い分け、Azure・GCPとは同じGPU・同じ条件に揃えて比べます。
AWSのGPUインスタンス料金はいくら?2026年11月時点
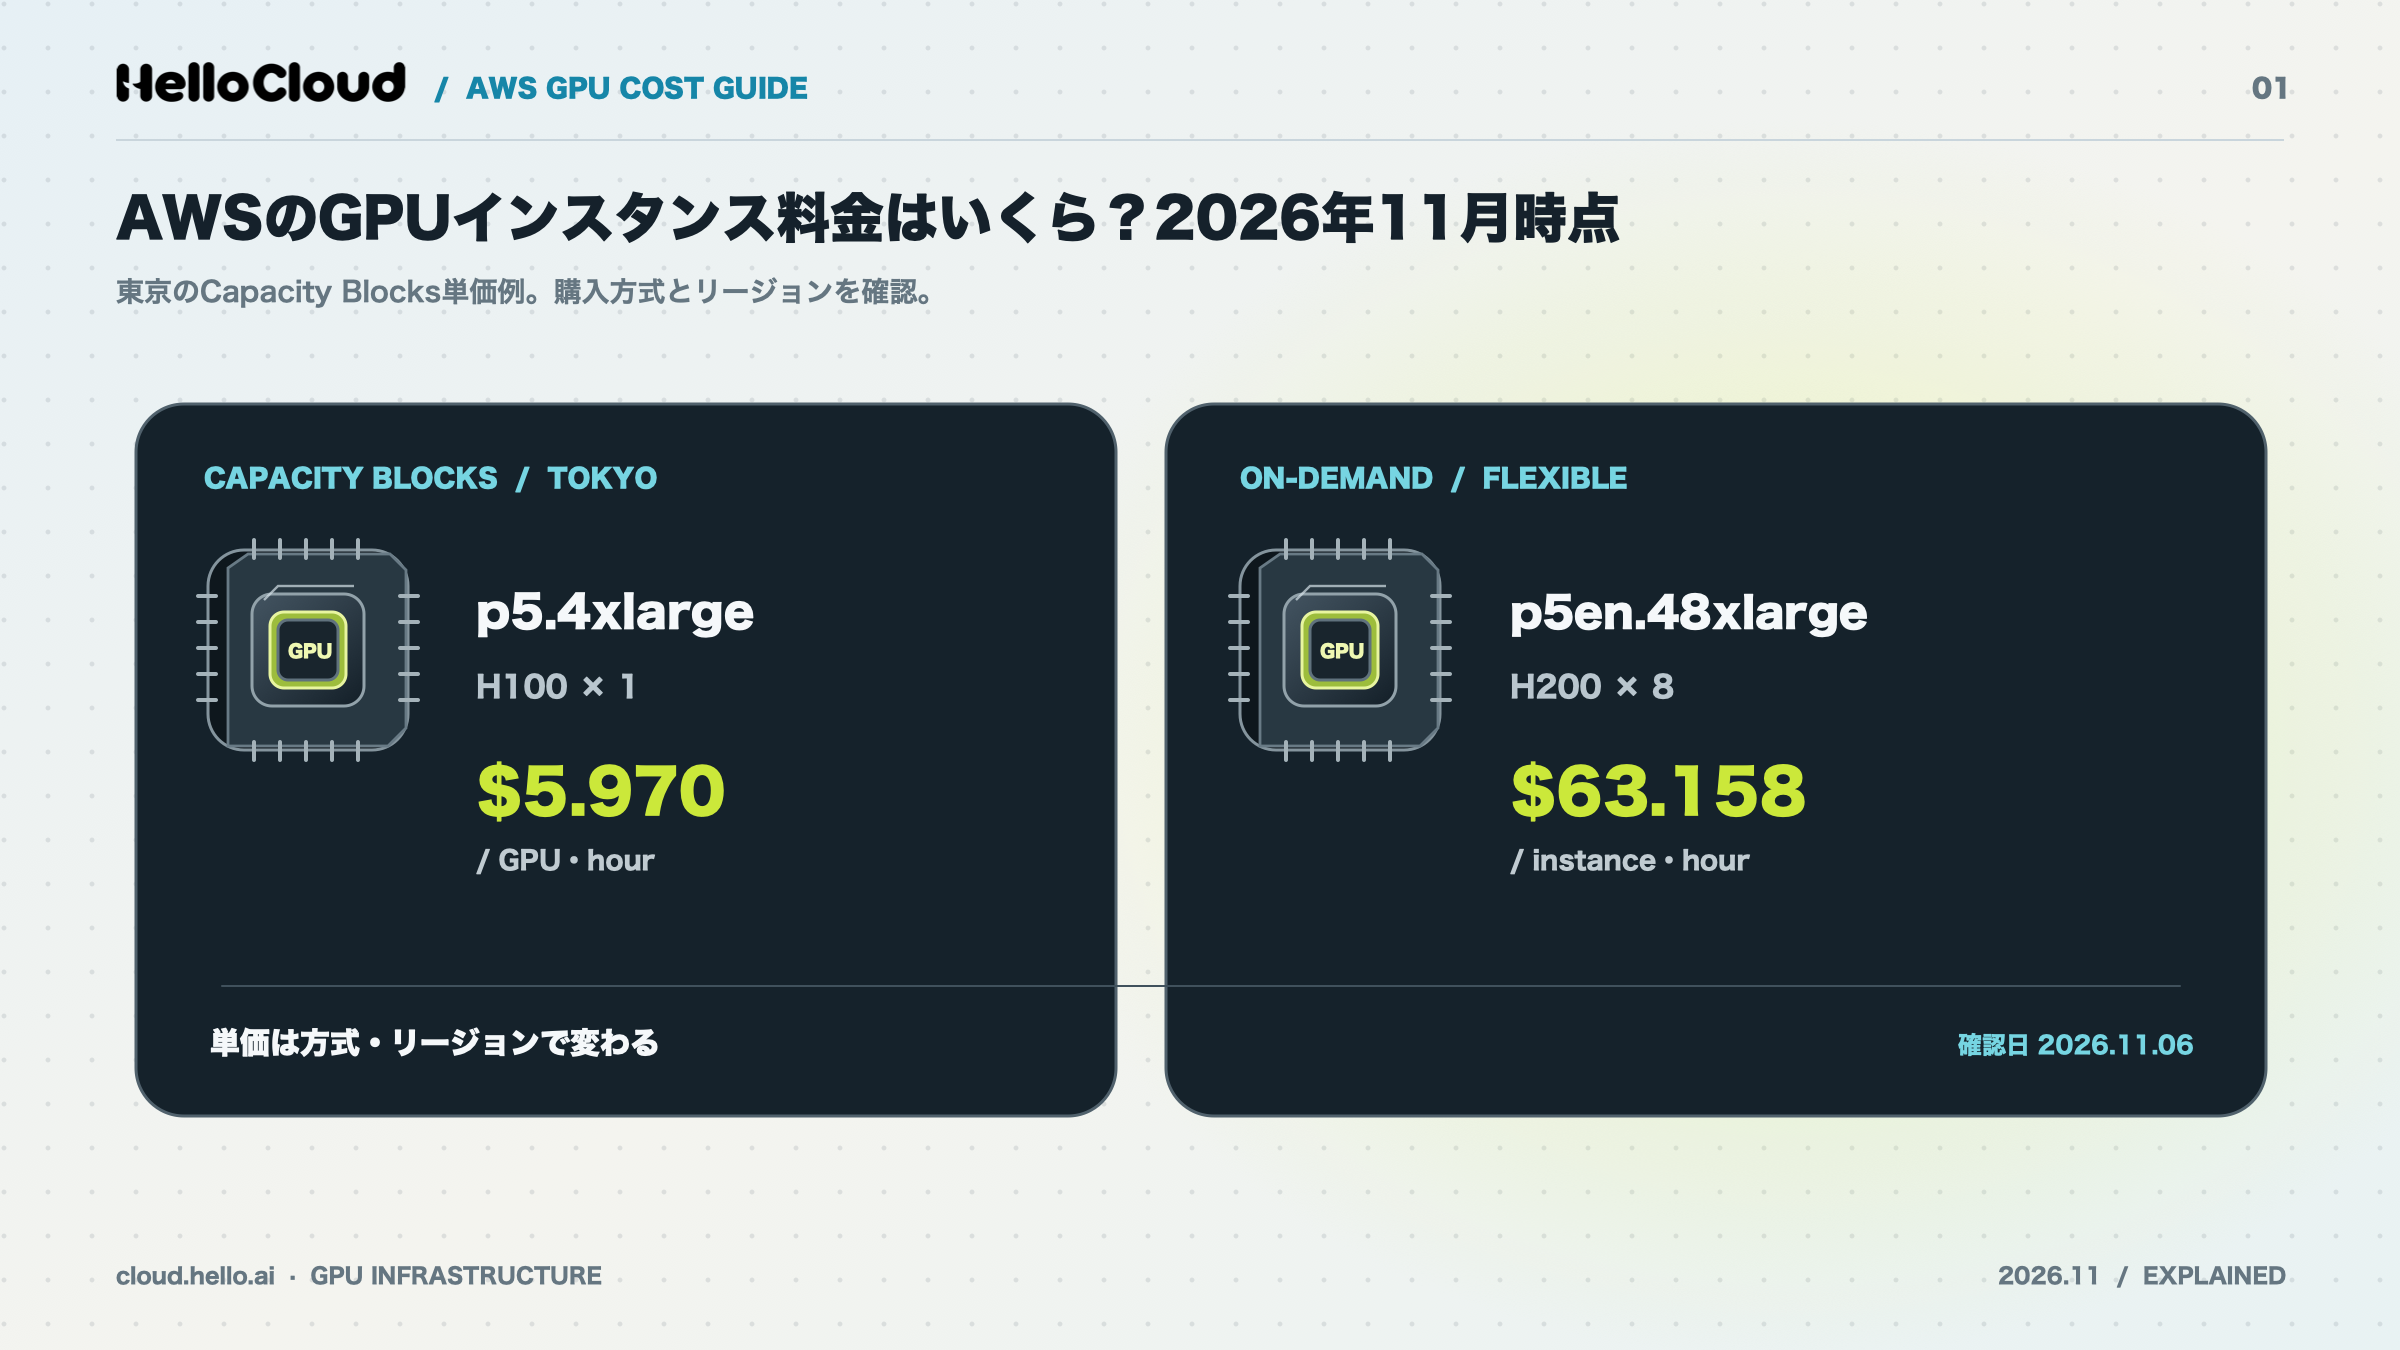
2026年11月時点で、東京リージョンのGPUインスタンスは、オンデマンドならT4を1基積むg4dn.xlargeが1時間0.710米ドル、H100を8基積むp5.48xlargeが1時間68.800米ドルです。日時を指定して予約するCapacity Blocksでは、p5.48xlargeが1時間47.757米ドルになります。AWSのGPUインスタンス料金は、購入方式とリージョン(データセンターがある地域)で変わります。
東京リージョンのCapacity Blocks単価一覧
東京リージョン(AWSの正式名は「アジアパシフィック(東京)」)でCapacity Blocksを使える主なGPUインスタンスと単価は次のとおりです。AWSの料金ページでは「アクセラレーター」という単位が使われており、GPU 1基を指します。
インスタンス | 搭載GPU | 1インスタンスあたり時間単価(USD) | GPU 1基あたり時間単価(USD) |
|---|---|---|---|
p5.48xlarge | H100×8 | 47.757 | 5.970 |
p5.4xlarge | H100×1 | 5.970 | 5.970 |
p5e.48xlarge | H200×8 | 54.924 | 6.866 |
p5en.48xlarge | H200×8 | 63.158 | 7.895 |
出典:AWS「Amazon EC2 Capacity Blocks for ML 料金」(2026年11月6日確認)
Capacity Blocksの単価は需給に応じて定期的に更新され、次回の更新は2027年1月に予定されています。見積もりに使う前に、確認日が新しい単価かどうかを確かめてください。
オンデマンドのGPUインスタンス料金一覧
2026年11月9日時点の東京リージョンのオンデマンド単価(Linux)は次のとおりです。推論向けのG系は1時間1米ドル前後から、H100を8基積むp5.48xlargeは1時間68.800米ドルです。
インスタンス | 搭載GPU | 時間単価(USD) | 730時間の月額(USD) |
|---|---|---|---|
g4dn.xlarge | T4×1 | 0.710 | 518.30 |
g6.xlarge | L4×1 | 1.1672 | 852.06 |
g5.xlarge | A10G×1 | 1.459 | 1,065.07 |
g6e.xlarge | L40S×1 | 2.699 | 1,970.27 |
p5.4xlarge | H100×1 | 8.600 | 6,278.00 |
p4d.24xlarge | A100×8 | 30.09784 | 21,971.42 |
p5.48xlarge | H100×8 | 68.800 | 50,224.00 |
p5en.48xlarge | H200×8 | 79.120 | 57,757.60 |
出典:AWS「EC2 オンデマンドインスタンスの料金」(2026年11月9日確認。アジアパシフィック(東京)、Linux)
同じp5.48xlargeでも、東京ではCapacity Blocks(1時間47.757米ドル)のほうがオンデマンド(68.800米ドル)より時間単価が低くなっています。ほかのインスタンスやリージョンの単価は、AWS「EC2 オンデマンドインスタンスの料金」ページでリージョンを切り替えると確認できます。
P系のオンデマンド料金は、2025年6月にP5で44%、P4dとP4deで33%、P5enで25%引き下げられました。2025年5月以前の単価で作った見積もりは、現行の料金ページの値で作り直す必要があります。
出典:AWS「EC2 オンデマンドインスタンスの料金」(2026年11月6日確認)、AWS公式ブログ「Amazon EC2 NVIDIA GPU 高速インスタンスの料金を最大 45% 引き下げることを発表」(2025年6月13日)
月額の計算式:時間単価×稼働時間+付帯費用
AWSのGPUインスタンスの月額は「時間単価×稼働時間+データ転送料+ストレージ料金+OS料金」で計算します。本記事では、常時稼働の1か月を730時間(1年8,760時間÷12か月)としています。
東京のp5.48xlargeをCapacity Blocksの単価で730時間使う計算では、47.757米ドル×730時間=34,862.61米ドルがインスタンス料金になります。Capacity Blocksで予約できる期間の長さは、Amazon EC2 ユーザーガイドで確認してください。
ポイント:
東京のH100×8(p5.48xlarge)は、Capacity Blocksで1時間47.757米ドル、730時間で34,862.61米ドルです(2026年11月6日確認)。月額にはここへ付帯費用を足します。
AWSのGPUインスタンスとは?G系とP系の違い
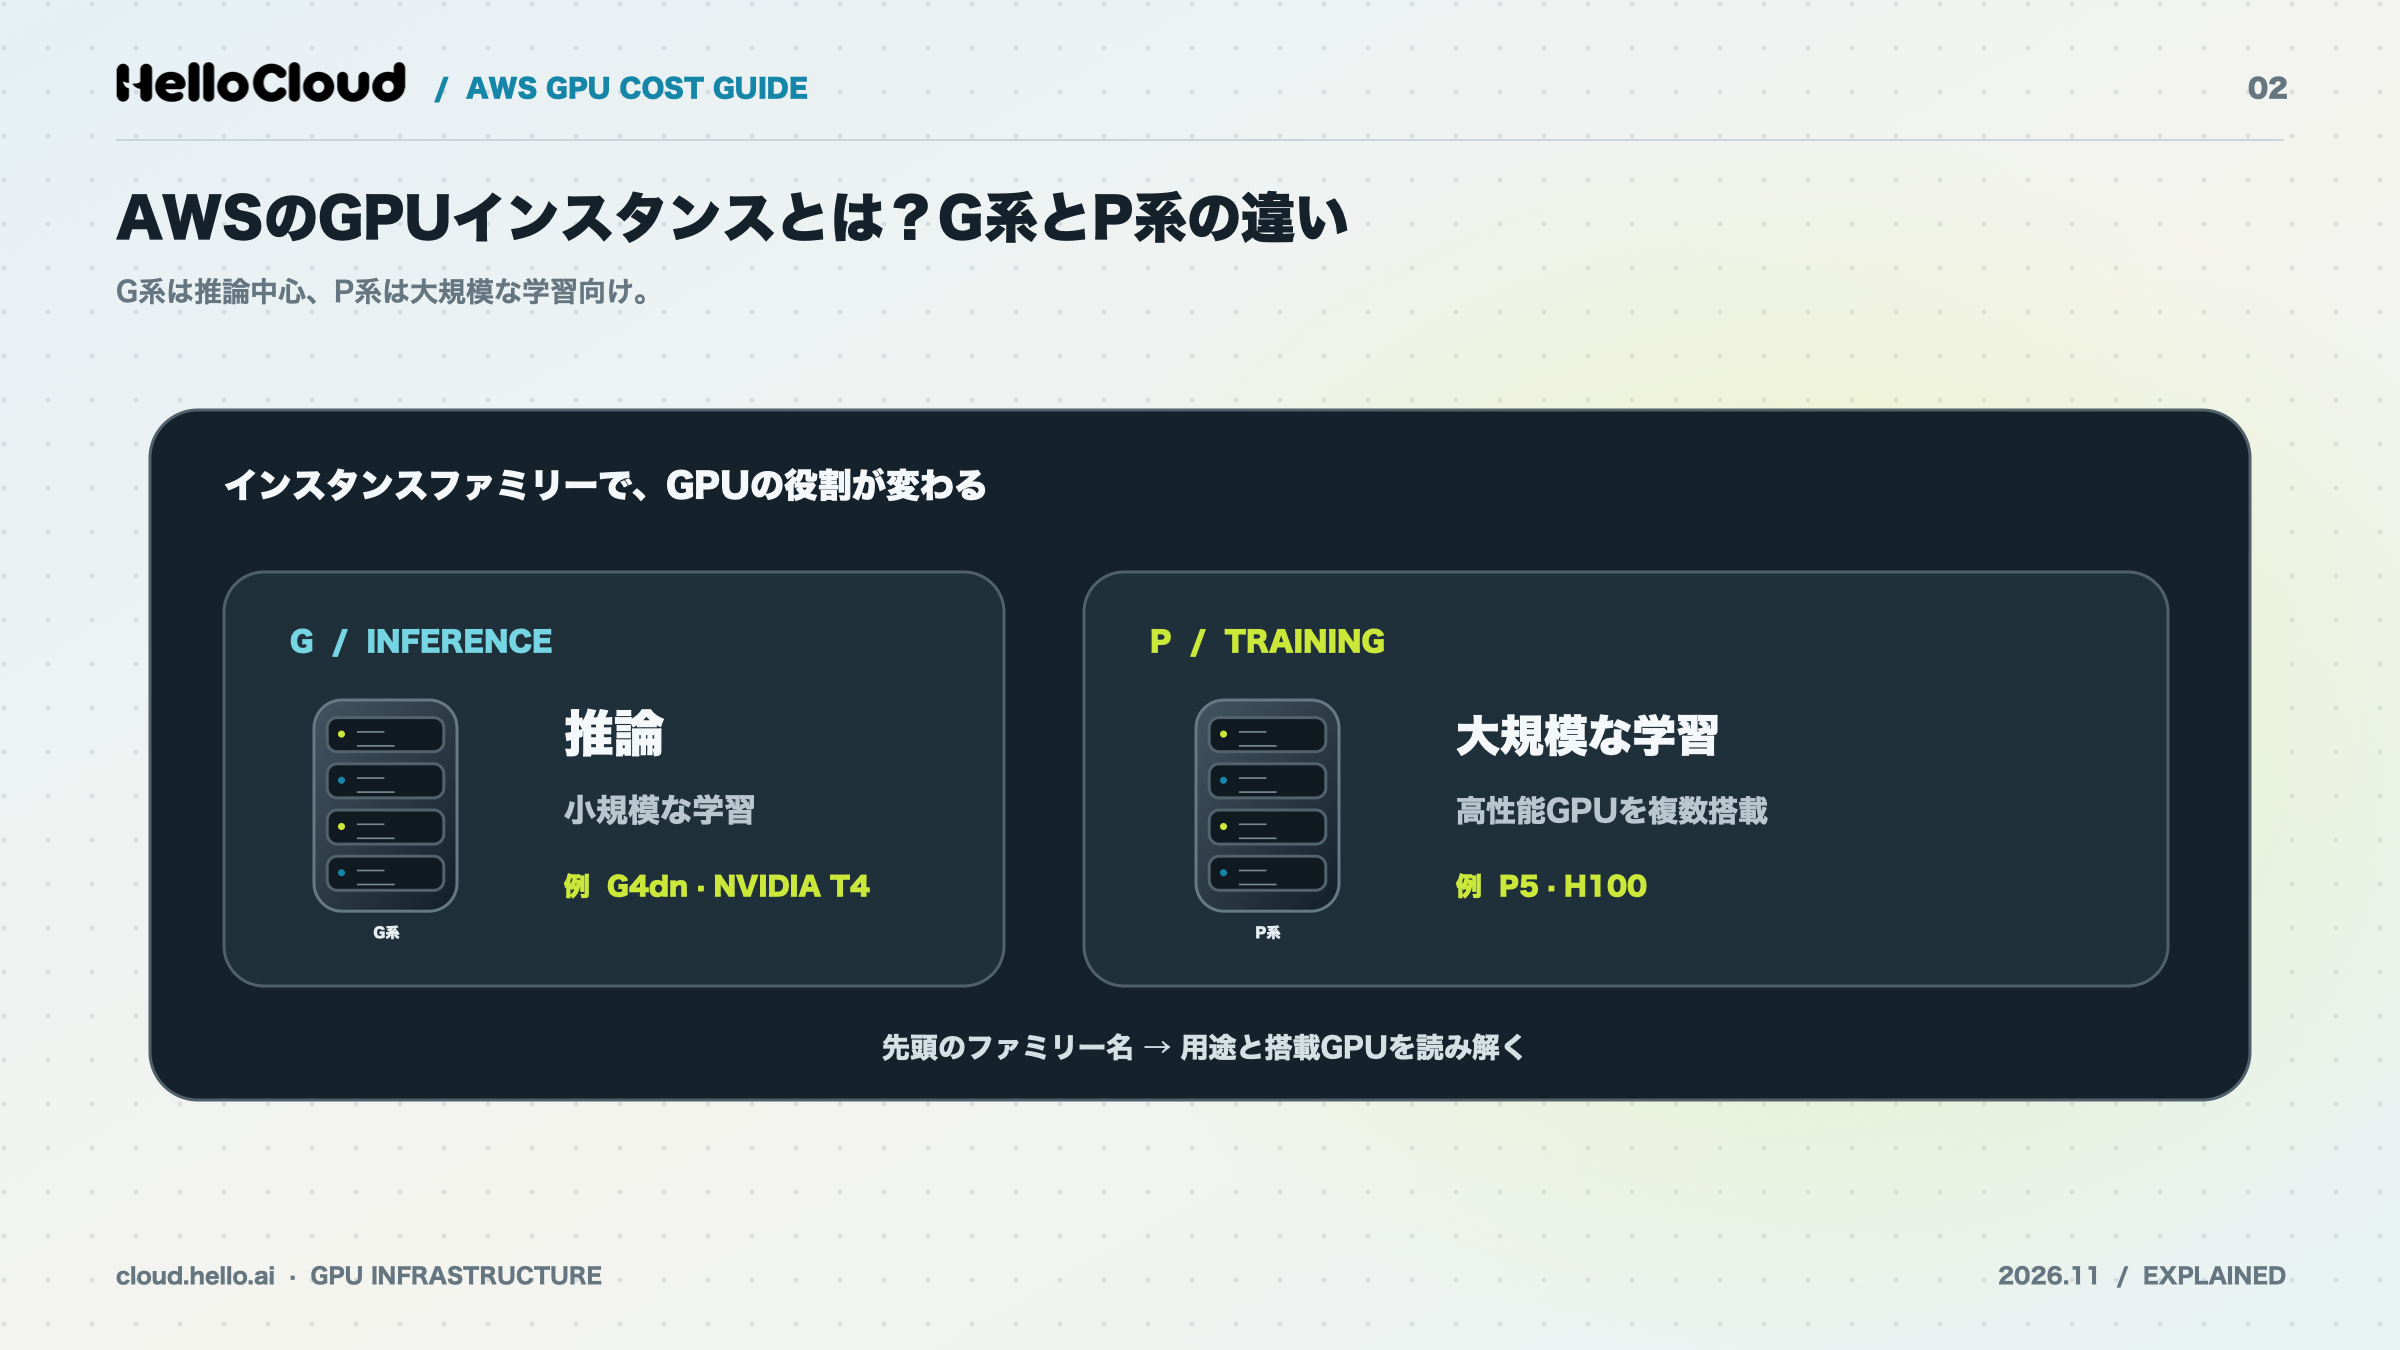
AWSのGPUインスタンスは、Amazon EC2(AWSの仮想サーバー)のうち、NVIDIAなどのGPUを積んだインスタンスタイプの総称です。名前の先頭の英字でファミリーが分かれ、G系は推論や小規模な学習、P系は大規模な学習に使われます。用途と名前の対応を押さえると、料金ページの読み間違いを防げます。
GPUインスタンスとは
GPUインスタンスとは、GPUを搭載したサーバーを時間単位で借りられるクラウドの仮想サーバーです。自社でGPUサーバーを買わずに、使った時間の分だけ料金を払って機械学習の学習や推論を動かせます。GPUクラウド全体の仕組みや、AWSなどの大手クラウドとネオクラウドの違いは、GPUクラウドとネオクラウドの基本を解説した記事で扱っています。
G系とP系の違い:推論向けと学習向け
G系は推論と小規模な学習に向いたファミリーです。たとえばG4dnインスタンスはNVIDIA T4 GPUを積み、AWSは公式ページでG4dnを機械学習の推論と小規模なトレーニングに最適化したインスタンスと説明しています。
P系はGPUを複数基まとめて使う大規模な学習に向いたファミリーです。AWSは2025年5月の発表で、Blackwell世代のGPUを積むP6-B200インスタンスについて、大規模な分散AIトレーニングと推論に特に適していると説明しています。
出典:AWS「Amazon EC2 G4 インスタンス」(2026年11月6日確認)、AWS公式ブログ「New Amazon EC2 P6-B200 instances powered by NVIDIA Blackwell GPUs to accelerate AI innovations」(2025年5月15日)
インスタンス名と搭載GPUの対応表
インスタンス名 | GPU | GPU枚数 |
|---|---|---|
p4d.24xlarge | A100 | 8 |
p4de.24xlarge | A100 | 8 |
p5.4xlarge | H100 | 1 |
p5.48xlarge | H100 | 8 |
p5e.48xlarge | H200 | 8 |
p5en.48xlarge | H200 | 8 |
出典:AWS「Amazon EC2 Capacity Blocks for ML 料金」(2026年11月6日確認)
インスタンス名のドットの後ろ(48xlargeなど)はサイズを表し、同じファミリーでもGPU枚数やvCPU数が変わります。
ポイント:
G系は推論・小規模な学習、P系は大規模な学習向けです。料金を比べるときは、インスタンス名と搭載GPU・枚数をセットで確認します。
AWSのGPUインスタンス料金を決める4つの購入方式
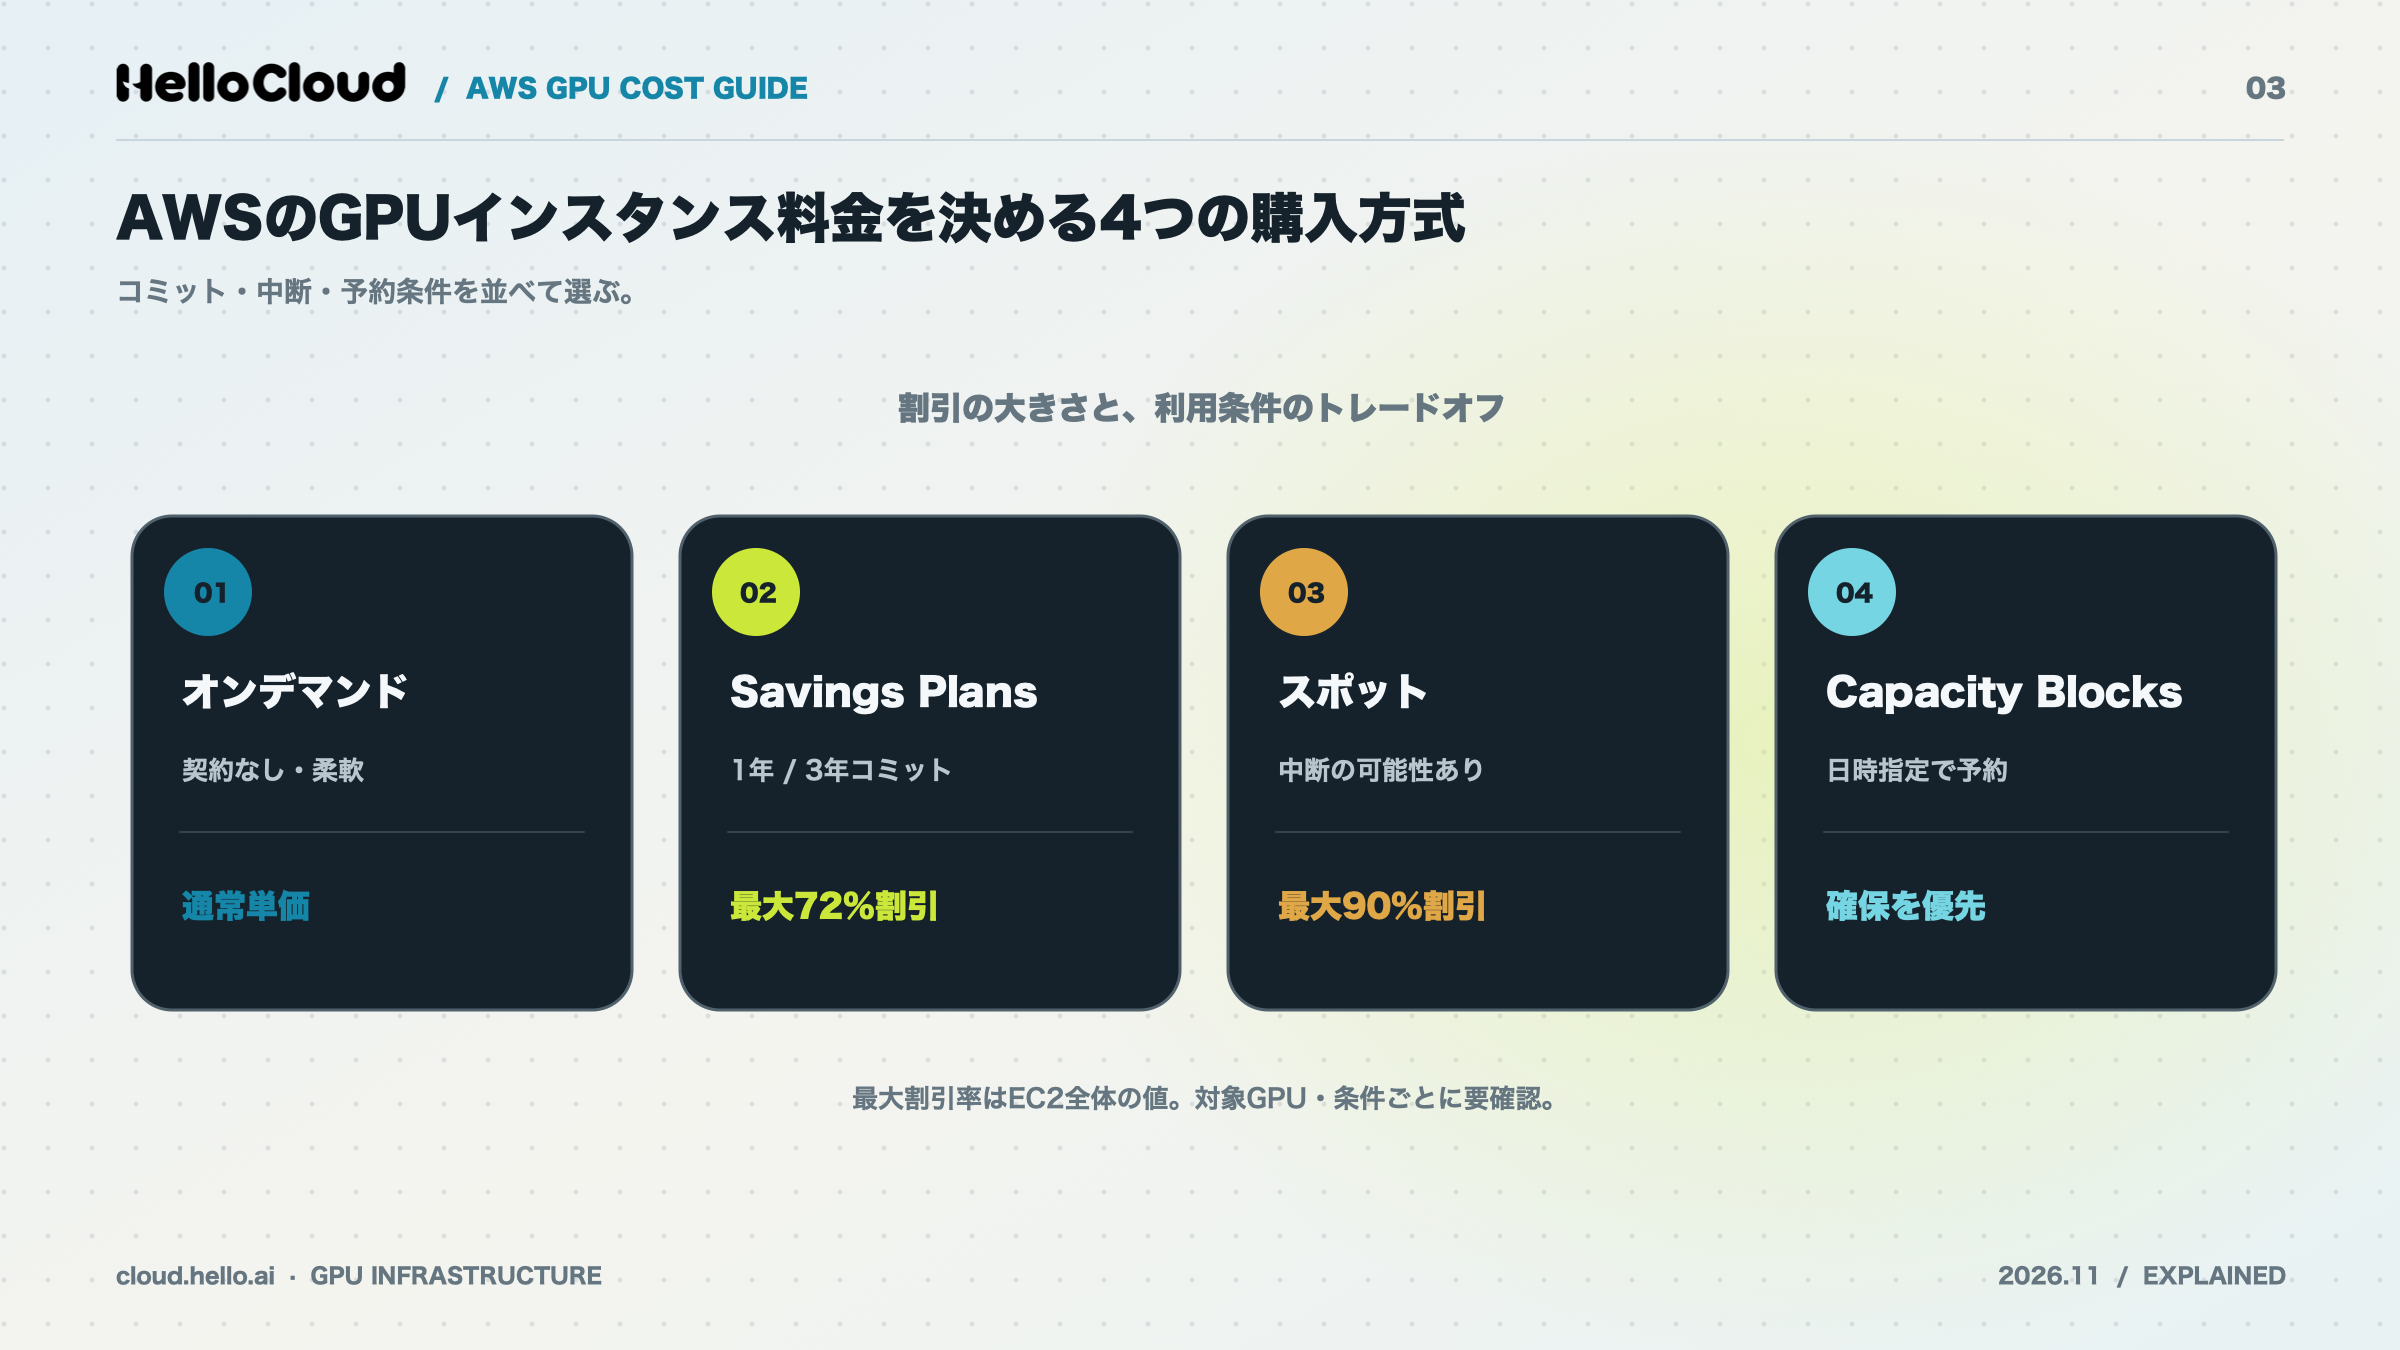
同じp5.48xlargeでも、オンデマンド、Savings Plans、スポットインスタンス、Capacity Blocks for MLのどれで買うかで支払額と条件が変わります。割引が大きい方式ほど、期間のコミットや中断の可能性といった条件が付きます。
購入方式 | 割引の目安 | 契約・予約 | 中断 | 支払い | 向く使い方 |
|---|---|---|---|---|---|
オンデマンド | なし(基準の料金) | 不要 | なし | 使った分(対象OSは秒単位、最小60秒) | PoC・検証 |
Savings Plans | オンデマンド比で最大72%削減 | 1年または3年の利用額をコミット | なし | コミットした利用額 | 稼働が読める本番 |
スポットインスタンス | オンデマンド比で最大90%割引 | 不要 | あり(2分前に通知) | 使った分 | 中断しても再開できる処理 |
Capacity Blocks for ML | 予約専用の単価 | 日時を指定して予約 | 予約期間はGPUを確保 | 申込時に前払い | 学習のピーク |
出典:AWS「Amazon EC2 料金」、AWS「Amazon EC2 Capacity Blocks for ML 料金」、AWS「スポットインスタンスの中断通知」(いずれも2026年11月6日確認)
Savings Plansとスポットインスタンスの割引率はEC2全体での最大値で、GPUインスタンスの割引率はインスタンスと条件ごとに異なります。
オンデマンド:契約なし・秒単位で課金
オンデマンドインスタンスは、長期契約や前払いなしで、使った時間の分だけ払う購入方式です。Amazon Linux、Windows、Red Hat Enterprise Linux、Ubuntuなどは秒単位(最小60秒)で課金され、使っていない時間の料金はかかりません。4つの方式の中では割引がなく、ほかの方式の割引率を測る基準になります。
Savings Plans:最大72%削減のコミット割引
Savings Plansは、1年または3年の期間に1時間あたりの利用額をコミットする代わりに、オンデマンド比で最大72%料金が下がる購入方式です。2025年6月の値下げはP4とP5のSavings Plansにも適用されており、GPUインスタンスでも使えます。
1時間あたりの利用額をコミットする仕組みのため、稼働量が読めない段階で長期のコミットをすると割高になる場合があります。
出典:AWS「Amazon EC2 料金」(2026年11月6日確認)、AWS公式ブログ「Amazon EC2 NVIDIA GPU 高速インスタンスの料金を最大 45% 引き下げることを発表」(2025年6月13日)
スポットインスタンス:最大90%割引、中断あり
スポットインスタンスは、AWSの空き容量を使う代わりに、オンデマンド比で最大90%割引になる購入方式です。AWSがキャパシティを必要とすると、インスタンスは停止または終了されます。
注意:
スポットインスタンスの中断通知は、停止・終了の2分前に出ます。通知はベストエフォート(確実な配信を約束しない方式)のため、学習の途中経過を定期的に保存していない処理では、作業が失われる場合があります。
Capacity Blocks for ML:日時指定の事前予約
Capacity Blocks for MLは、機械学習用のGPUインスタンスを日時を指定して事前に予約する購入方式です。料金は予約料金とOS料金の2つで、予約料金は申し込みの時点で前払いします。AWSの料金ページには、次の計算例が載っています。
条件:米国東部(オハイオ)でp5.48xlargeを4台、48時間予約(購入時の単価は1インスタンス時間あたり31.464米ドル、OSはRed Hat Enterprise Linux)
予約料金:192インスタンス時間×31.464米ドル=6,041.088米ドル
OS料金:188インスタンス時間×1.8432米ドル=346.52米ドル(予定より1時間早く終了)
合計:6,387.608米ドル
計算例の31.464米ドルは過去の購入時点の単価で、2026年11月6日時点の東京の単価(47.757米ドル)とは異なります。
出典:AWS「Amazon EC2 Capacity Blocks for ML 料金」(2026年11月6日確認)
注意:
Capacity Blocksは、利用開始日が単価の更新後でも、購入した時点の単価が適用されます。予約料金は申し込み時に前払いになるため、キャンセルや変更の条件は、Amazon EC2 ユーザーガイドで確認してから予約してください。
ポイント:
割引率はSavings Plansが最大72%、スポットが最大90%です。Capacity Blocksは割引ではなく、GPUを日時指定で確保するための前払いの予約です。
GPU料金以外にかかる費用と総額の出し方
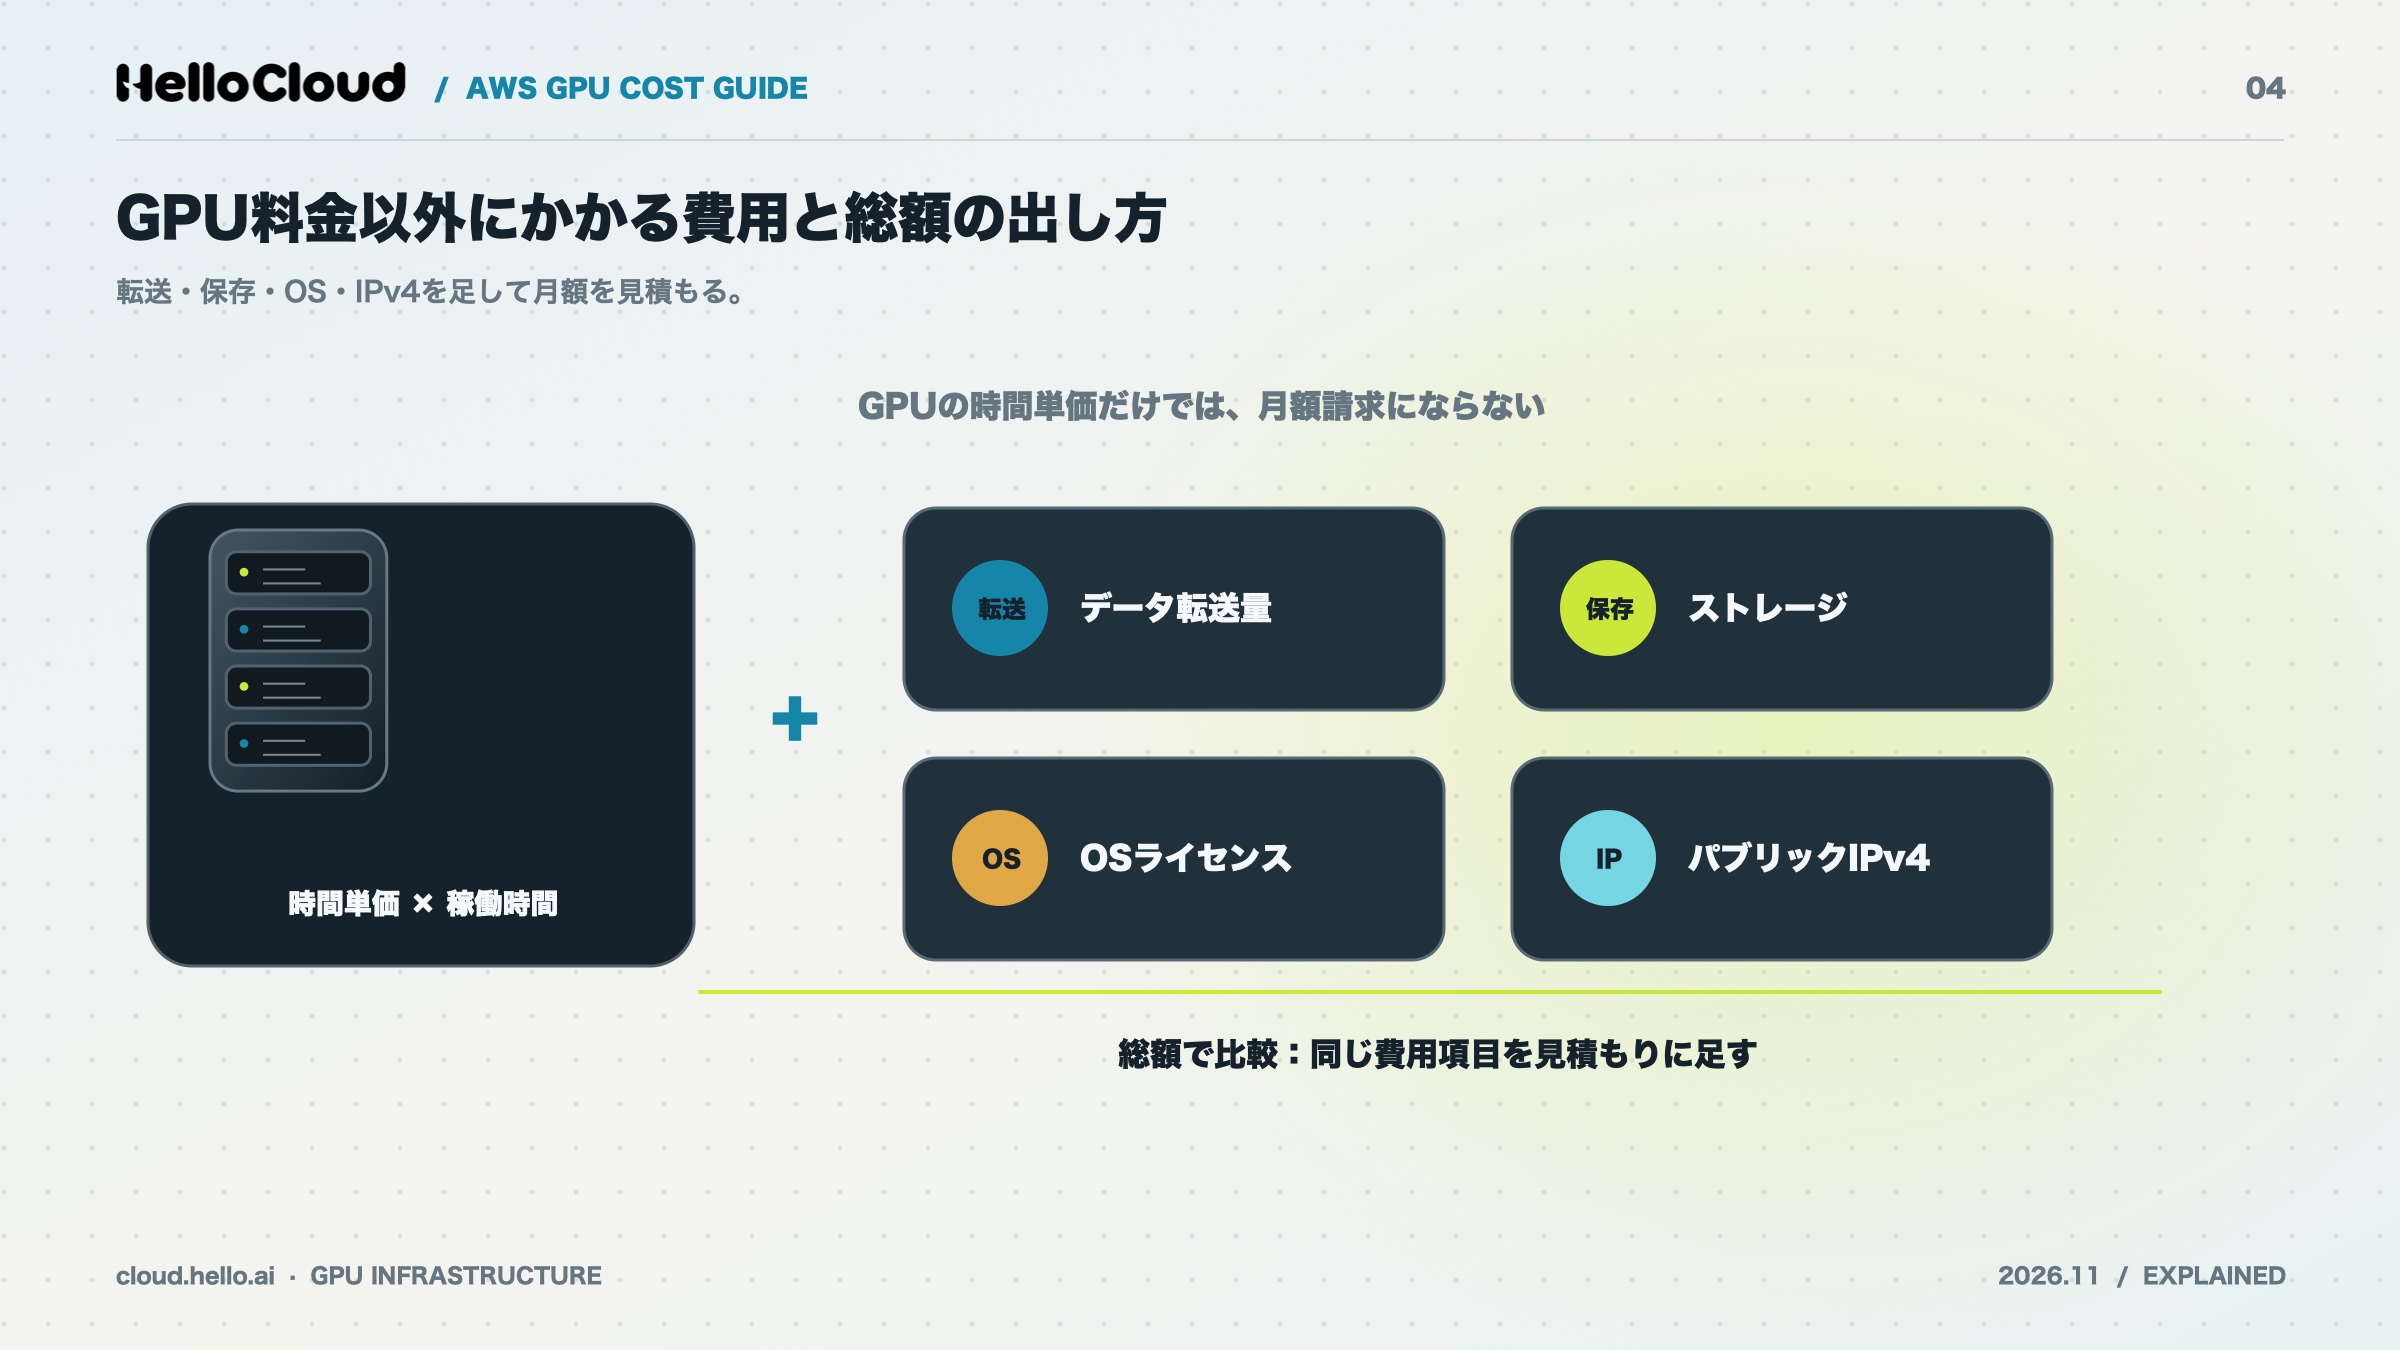
AWSのGPUインスタンスの総額は、インスタンス料金に、データ転送料・ストレージ料金・OS料金・パブリックIPv4アドレスの料金を足して求めます。インスタンスの時間単価だけでは、稟議で問われる毎月の請求額は出せません。費用項目を揃えてから、各社や各購入方式を比べます。
データ転送料とストレージ料金
インターネットへのデータ転送(アウト)は、AWSの全サービス・全リージョン(中国とGovCloudを除く)の合計で月100GBまで無料です。100GBを超えた分は従量課金で、単価はAWS「EC2 オンデマンドインスタンスの料金」ページのデータ転送の項目で確認できます。
推論APIのように結果を外部へ返し続ける用途では、月あたりの送信量を見積もり、100GBを超える分の費用を月額に足します。
出典:AWS「EC2 オンデマンドインスタンスの料金」(2026年11月6日確認)
ストレージ料金の対象は、インスタンスに付けるAmazon EBS(ブロックストレージ)の容量と性能です。モデルの重みや学習データを置く容量を決めてから、Amazon EBSの料金ページで東京リージョンの単価を確認してください。
注意:
インスタンスを停止しても、EBSボリュームを残している間はストレージ料金がかかります。停止中にかかる費用の内訳は、GPUクラウドの停止中の課金を解説した記事で詳しく扱っています。
出典:AWS「EC2 インスタンスの停止および開始の動作」(2026年11月6日確認)
OS料金とパブリックIPv4アドレスの料金
OS料金は、Capacity Blocksのp5.48xlargeの場合、Linuxは1時間0米ドル、Red Hat Enterprise Linuxは1時間1.8432米ドルです。p5.48xlargeを730時間使う計算では、Red Hat Enterprise LinuxのOS料金だけで1,345.536米ドルになります。
Elastic IPアドレスは、使用中・アイドル状態のどちらでも料金の対象です。パブリックIPv4アドレスの料金は、Amazon VPCの料金ページに掲載されています。
出典:AWS「EC2 オンデマンドインスタンスの料金」(2026年11月6日確認)
費用項目を揃えた月額試算の例
東京リージョンのp5.48xlargeを、Capacity Blocksの単価で730時間、OSはLinuxで使う場合の月額は次のとおりです。
費用項目 | 単価 | 数量 | 月額(USD) | 出典 |
|---|---|---|---|---|
インスタンス料金 | 47.757 USD/時間 | 730時間 | 34,862.61 | Capacity Blocks料金ページ |
OS料金(Linux) | 0 USD/時間 | 730時間 | 0 | Capacity Blocks料金ページ |
ストレージ(EBS) | 公式ページで確認 | 使う容量(GB) | 公式ページで確認 | Amazon EBS料金ページ |
データ転送(アウト) | 月100GBまで無料、超過分は公式ページで確認 | 送信量(GB) | 100GBまで0 | EC2 オンデマンドインスタンスの料金ページ |
パブリックIPv4アドレス | 公式ページで確認 | 使うアドレス数×時間 | 公式ページで確認 | Amazon VPC料金ページ |
合計 | - | - | 34,862.61+ストレージ+転送超過分+IPv4 | - |
出典:AWS「Amazon EC2 Capacity Blocks for ML 料金」、AWS「EC2 オンデマンドインスタンスの料金」(いずれも2026年11月6日確認)
ポイント:
月額は「インスタンス料金+OS料金+ストレージ+データ転送の超過分+パブリックIPv4」で揃えて比べます。データ転送は月100GBまで無料です。
AWSのGPU料金はドル建て:為替の影響と円換算
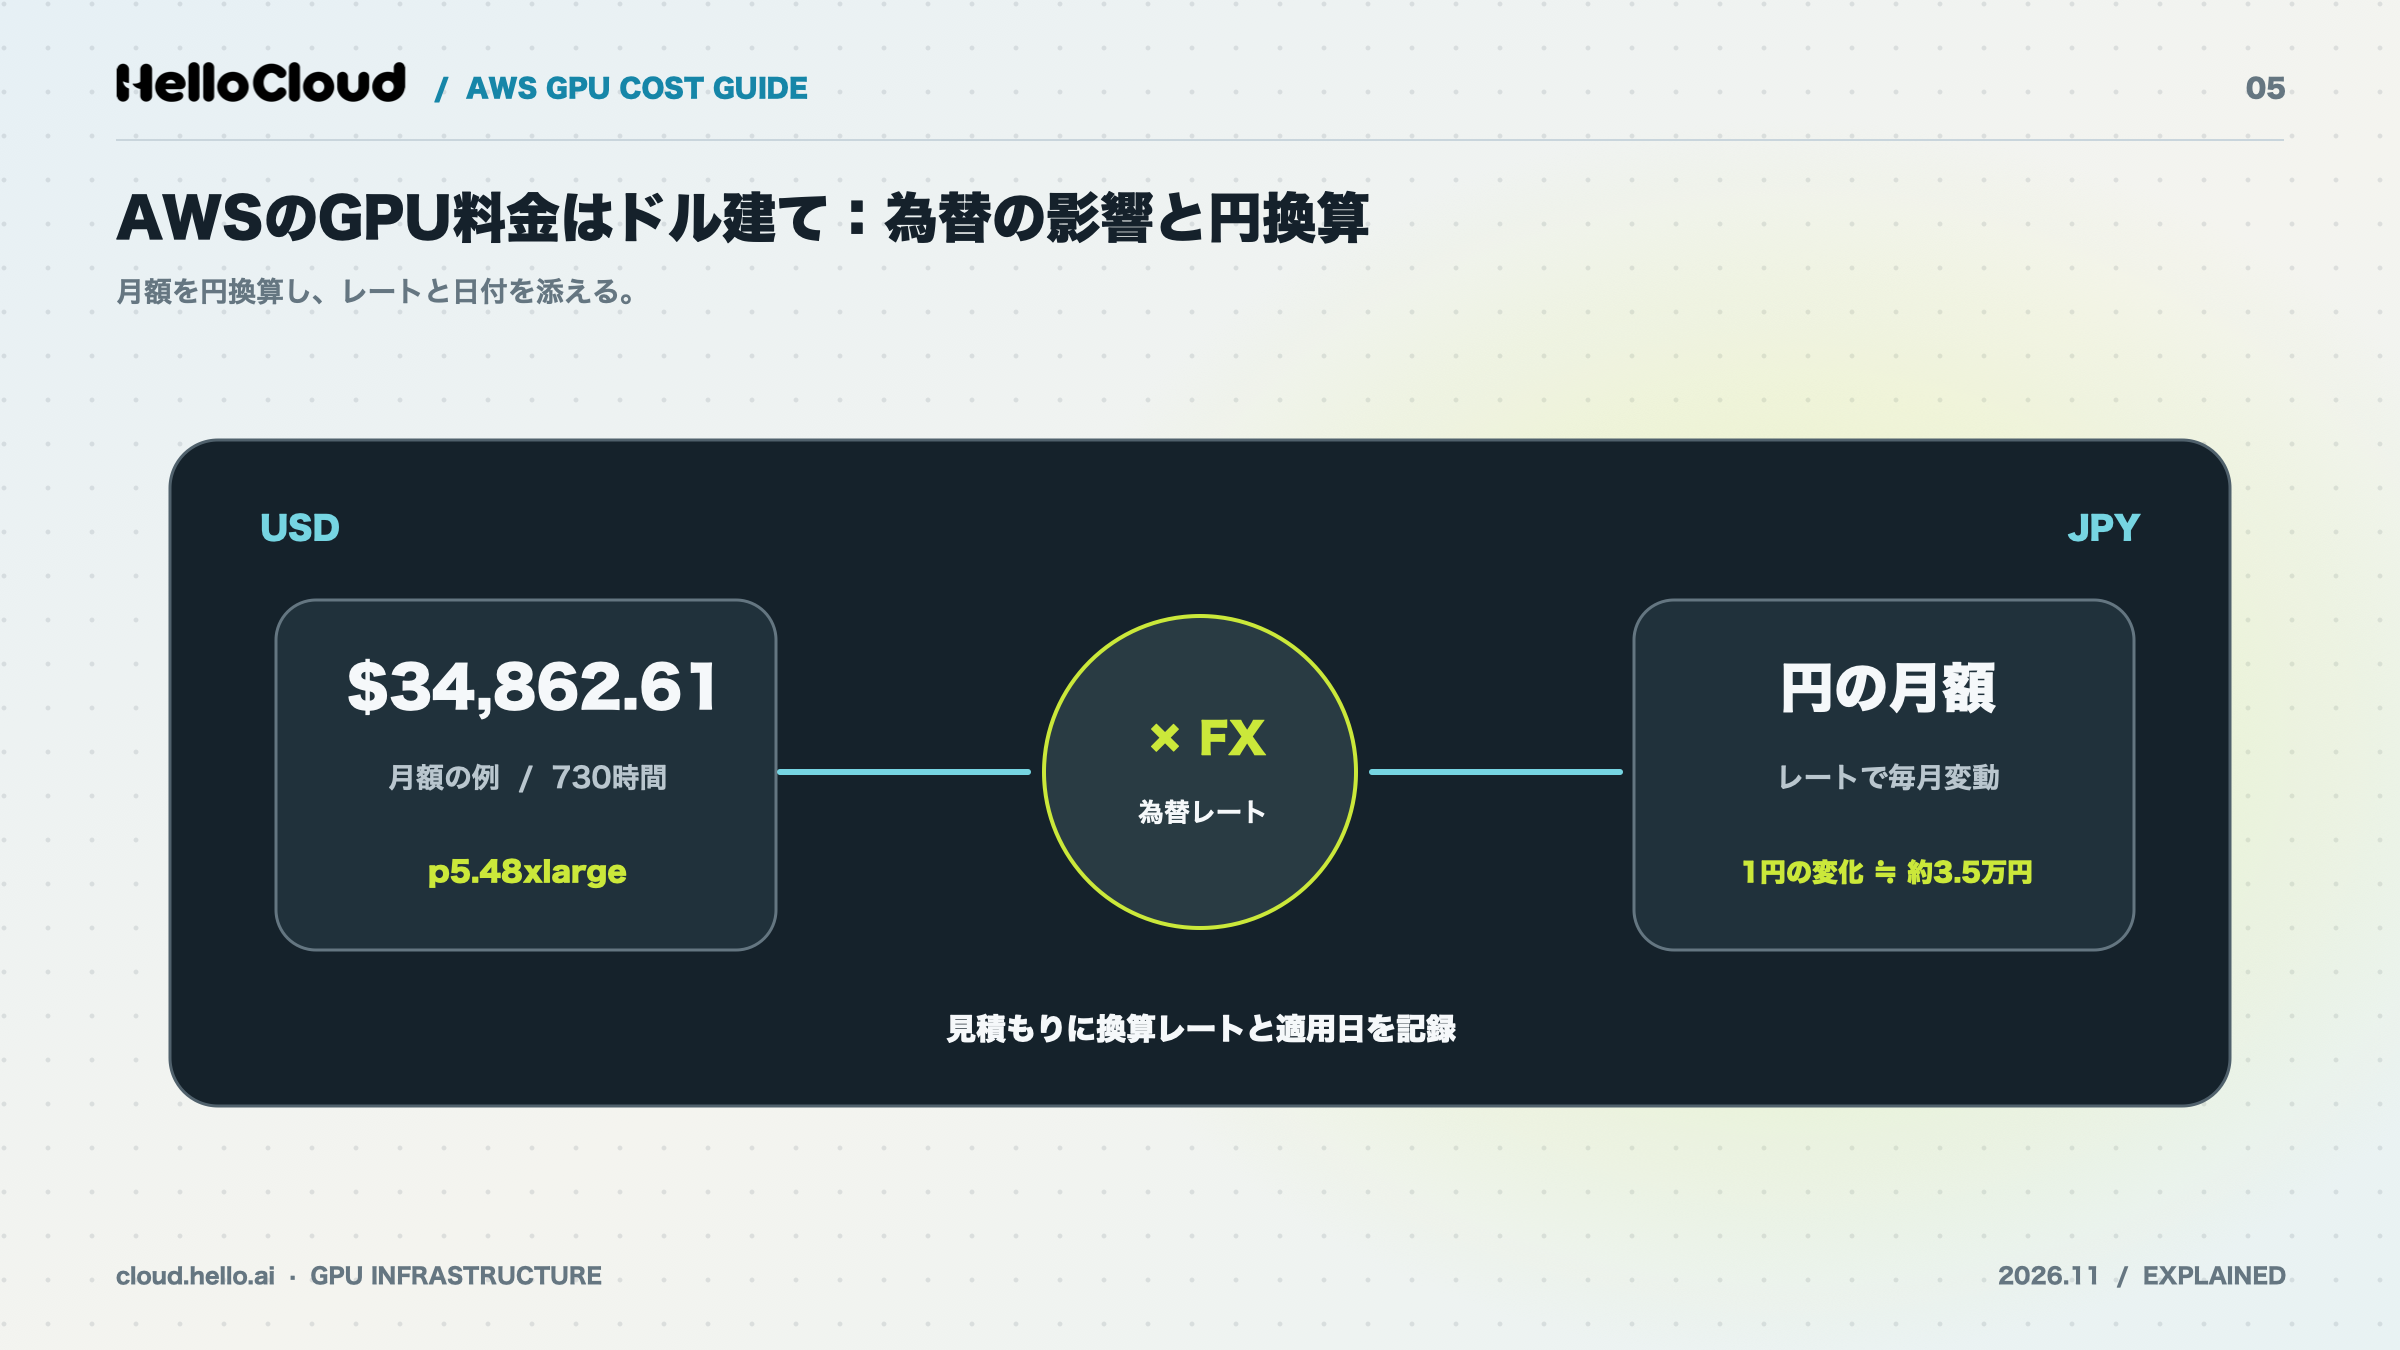
AWSのGPUインスタンス料金は米ドル建てのため、同じ使い方でも、円での支払額は為替レートによって月ごとに変わります。p5.48xlargeを730時間使う場合、為替が1円動くと月額は約3.5万円動きます。円で予算を組むなら、換算レートとその日付を見積もりに書き添えてください。
円換算の式と為替1円あたりの月額の変化
円での月額は「米ドルの月額×換算レート」で求めます。東京のp5.48xlargeをCapacity Blocksで730時間使う場合、米ドルの月額は34,862.61米ドルです。次の表は、換算レートを仮に3段階置いたときの円の月額です。
換算レート(仮の例) | 月額(USD) | 月額(円) |
|---|---|---|
1米ドル=150円 | 34,862.61 | 約5,229,392円 |
1米ドル=155円 | 34,862.61 | 約5,403,705円 |
1米ドル=160円 | 34,862.61 | 約5,578,018円 |
出典:AWS「Amazon EC2 Capacity Blocks for ML 料金」の単価から計算(2026年11月6日確認)。換算レートは計算のための仮の値で、実際の相場ではありません。
1米ドル=150円と160円の差は、月額で約35万円です。実際の予算化では、日本銀行などが公表する直近の為替相場と、社内で使う予算レートを確認したうえで換算してください。ドル建ての費用を稟議書でどう説明するかは、GPUクラウドの稟議書の書き方で解説しています。
予算化の注意:Capacity Blocksは前払い
Capacity Blocksは予約時に前払いし、購入した時点の単価が適用されます。予約した時点で米ドルの金額が確定するため、単価の更新による変動は避けられます。円での支払額のほうは、支払い時の為替条件しだいです。
注意:
Capacity Blocksの単価は需給に応じて定期的に更新され、次回は2027年1月に予定されています。更新の前後どちらで予約するかで米ドルの単価が変わるため、予約のタイミングも予算計画に含めます。
ポイント:
p5.48xlargeを730時間使う場合、為替が1円動くと月額は約3.5万円動きます。見積もりには換算レートとその日付を必ず書きます。
AWSのGPUインスタンスの値上げ・値下げの履歴
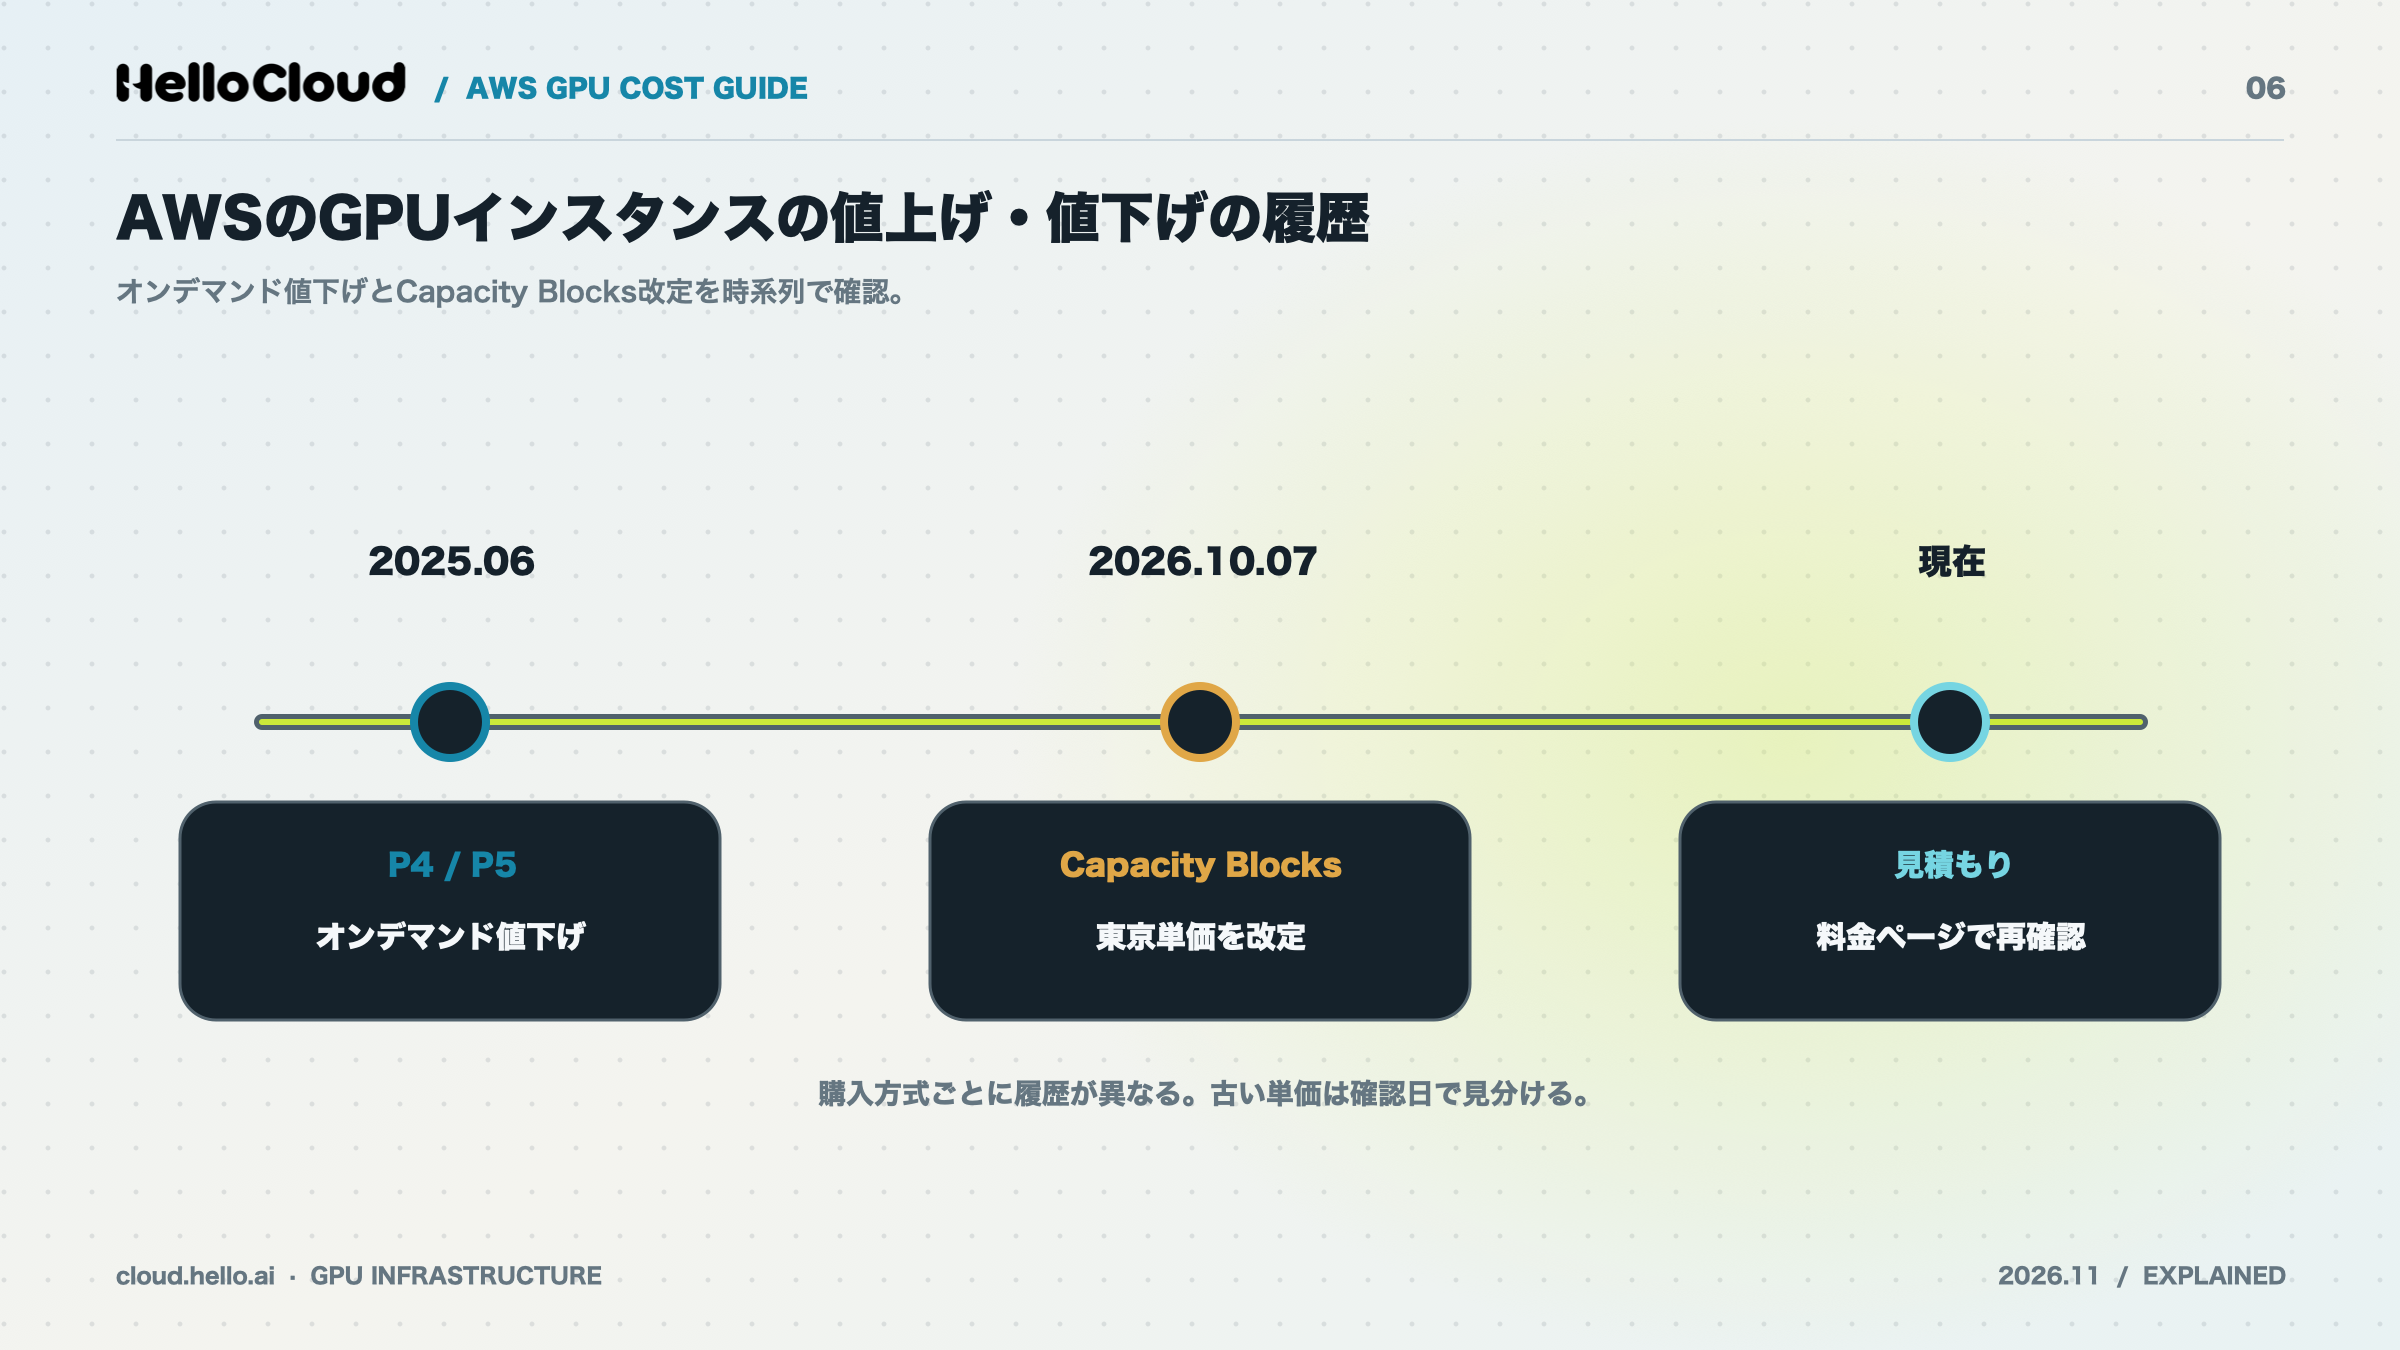
AWSのGPU料金は、2025年6月にP4・P5のオンデマンドとSavings Plansが値下げされ、2026年10月7日にはCapacity Blocksの単価が引き上げられました。値下げと値上げが別の購入方式で起きているため、見積もりに使う単価は購入方式ごとに確認日を見ます。
2025年6月:P4・P5のオンデマンドを値下げ
AWSは2025年6月、P4(P4d・P4de)とP5(P5・P5en)の料金を最大45%引き下げると発表しました。最大45%はP5のEC2 Instance Savings Plans(3年)の値で、オンデマンドの値下げ率は次のとおりです。
インスタンス | GPU | オンデマンドの値下げ率 |
|---|---|---|
P4d | A100 | 33% |
P4de | A100 | 33% |
P5 | H100 | 44% |
P5en | H200 | 25% |
出典:AWS公式ブログ「Amazon EC2 NVIDIA GPU 高速インスタンスの料金を最大 45% 引き下げることを発表」(2025年6月13日)
値下げは2025年6月1日以降のオンデマンド購入と、6月4日以降に有効になるSavings Plansの購入に適用されています。
2026年10月:Capacity Blocksの単価を改定
2026年10月7日のCapacity Blocksの改定で、東京リージョンのGPU 1基あたりの単価は次のように変わりました。
インスタンス | 改定前(USD/GPU 1基・時間) | 改定後(USD/GPU 1基・時間) | 改定率 |
|---|---|---|---|
P5(米国外) | 4.720 | 5.970 | +26.48% |
P5en(米国外) | 6.241 | 7.895 | +26.50% |
P5e | 5.97 | 6.866 | +15.01% |
出典:クラスメソッド DevelopersIO「Amazon EC2 Capacity Blocks for ML の価格改定 2026 年 10 月版」(2026年10月16日)、AWS「Amazon EC2 Capacity Blocks for ML 料金」(2026年11月6日確認)
改定後は、GovCloudのP6-B300・P6-B200を除き、全リージョンで同じ単価になりました。
古い記事の単価を使うときの注意
インターネット上の記事や社内資料のGPU単価は、次の順で確認してから見積もりに使います。
確認日を見る:2025年5月以前のオンデマンド単価は、値下げ前の値です。
購入方式を見る:Capacity Blocksの単価は、2026年10月7日以前のものなら改定前の値です。
公式ページで再確認する:AWSの料金ページで、同じリージョン・同じインスタンスの現行単価を確かめます。
ポイント:
2025年6月に値下げ、2026年10月7日にCapacity Blocksの値上げがありました。単価は購入方式と確認日をセットで扱います。
AWS・Azure・GCPのGPUインスタンス料金比較
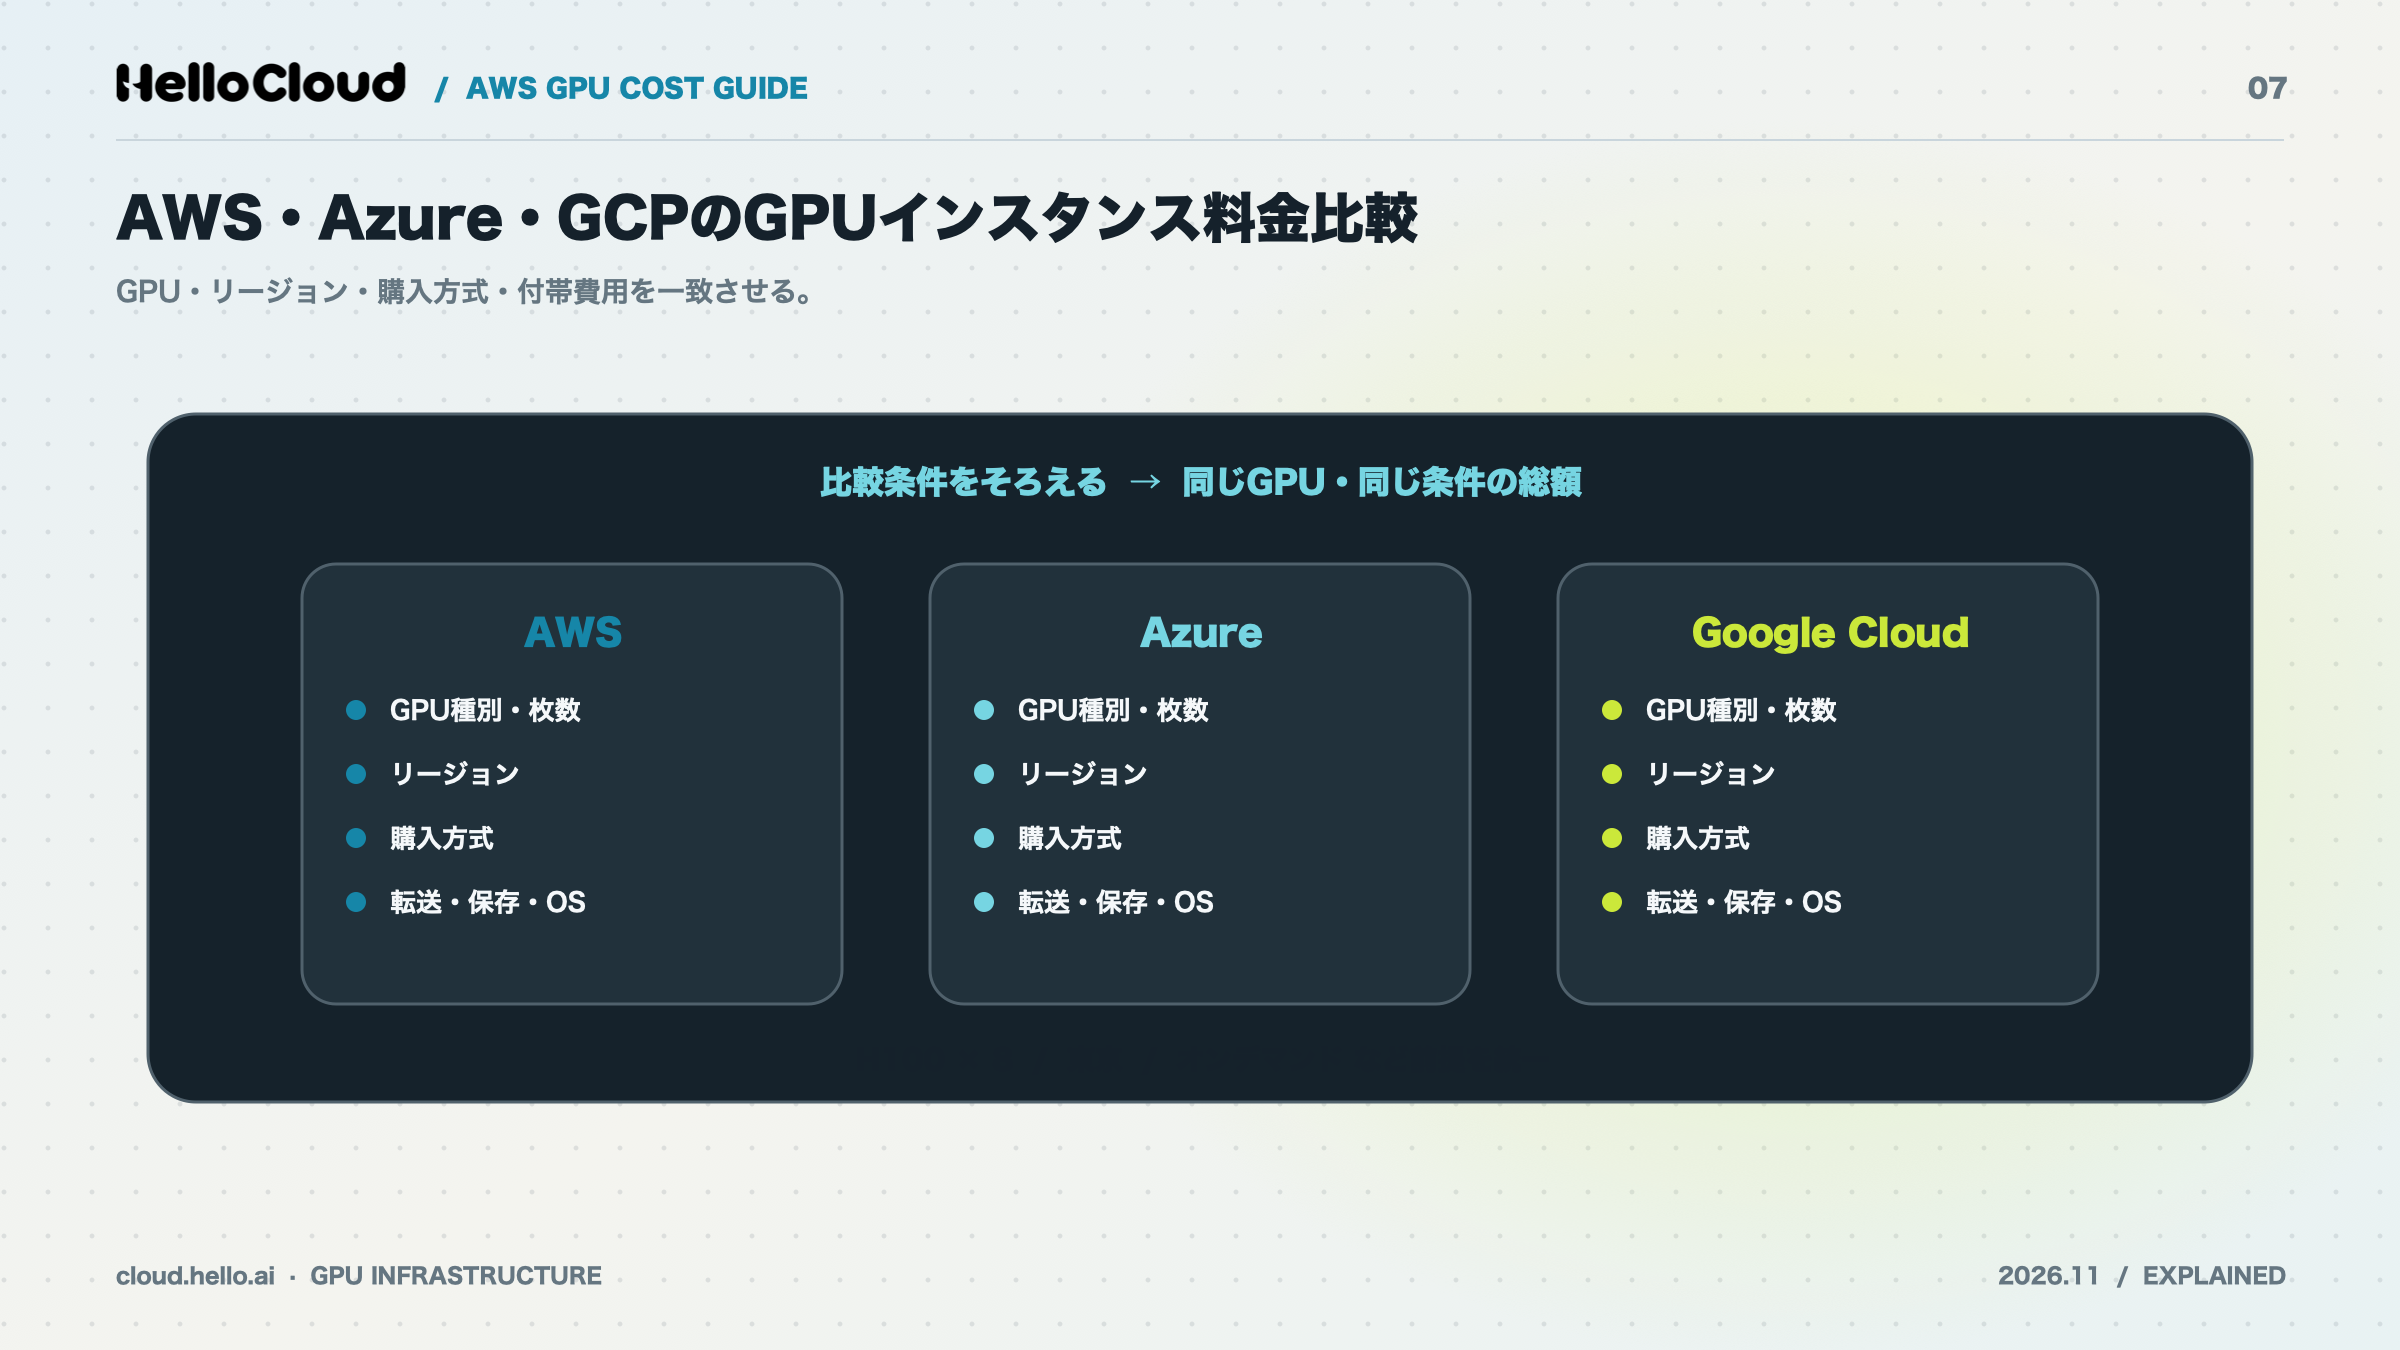
AWS・Azure・Google CloudのGPU料金は、GPUの種類・リージョン・購入方式・付帯費用を揃えないと、正しく比べられません。3社とも料金ページの表示条件が異なるため、1時間あたりの単価だけを並べると、比べる前提がずれたまま結論を出すことになります。
国内のGPUクラウドを含めた比較は、GPUクラウドの料金を比較した記事で扱っています。
比較の前提を揃える4項目
GPUの種類と枚数を揃える:H100×8同士、H200×8同士のように、同じGPU・同じ枚数が前提です。
リージョンを揃える:東京で使うなら、各社の東京リージョンの単価同士で比べます。
購入方式を揃える:オンデマンド同士、1年コミット同士のように、割引条件も揃えます。
付帯費用を揃える:ストレージ、データ転送、OS料金も同じ前提で足し、総額で比較。
AzureのGPUインスタンスと料金
AzureでH100を8基使う仮想マシンには、ND H100 v5シリーズのStandard_ND96isr_H100_v5があります。Microsoftのドキュメントによると、Standard_ND96isr_H100_v5の構成はH100(GPUあたり80GB)×8基、vCPU 96、メモリ1,900GiBです。
Microsoftの価格データでは、東日本リージョン(Japan East)のStandard_ND96isr_H100_v5は、従量課金(Linux)で1時間142.564米ドルです。1年予約は1年分で799,271米ドル(1時間あたり約91.24米ドル)、3年予約は3年分で1,644,749米ドル(1時間あたり約62.59米ドル)です。ほかの条件の単価は、Azureの料金計算ツールで調べられます。
出典:Microsoft Learn「ND H100 v5-series」(2026年11月6日確認)、Microsoft Learn「Azure Retail Prices REST API の概要」の価格データ(2026年11月9日取得)
GCPのGPUインスタンスと料金
Google CloudでGPUを使う仮想マシンは、アクセラレータ最適化マシン(A4X、A4、A3、A2)と、グラフィックと推論向けのG4・G2です。Google Cloudの料金ページによると、vCPUとメモリはマシンタイプ単位ではなく個別に課金されます。vCPU・GPU・メモリには1分の最小課金時間があり、その後は1秒単位の課金です。
割引は、Spot VMが通常オンデマンドから最大91%、確約利用割引が1年のコミットでvCPU・メモリ最大37%です。リソースベースの確約利用割引は、アクセラレータ最適化ではA2・A3・G2のマシンタイプが対象です。
東京リージョン(asia-northeast1)でH100を8基積むa3-highgpu-8gは、1時間約126.64米ドルです。Google Cloudが公開しているSKU単価(GPU・vCPU・メモリ・ローカルSSD)を足して算出しました。
計算式:H100 8基×14.204998米ドル+vCPU 208個×0.03274454米ドル+メモリ1,872GiB×0.002851361米ドル+ローカルSSD 6,000GiB×0.104米ドル÷730時間=約126.64米ドル/時間
同じ計算でアイオワ(us-central1)の単価を出すと88.49米ドルになり、料金ページに載っている値と一致します。
出典:Google Cloud「VM インスタンスの料金」(2026年11月6日確認)、Google Cloud「アクセラレータ最適化 VM の料金」、Google Cloud「SKU」(いずれも2026年11月9日確認)
3社の料金比較表(同じGPU・同じ条件)
東京でH100を8基使う構成をオンデマンドで1時間使う場合、単価はAWSが68.800米ドル、Google Cloudが約126.64米ドル、Azure(東日本)が142.564米ドルです(2026年11月9日確認)。3社ともUSD表記で、730時間の月額にストレージやデータ転送などの付帯費用は含みません。
クラウド | H100×8の構成例 | 東京の時間単価(オンデマンド、USD) | 730時間の月額(USD) | 主な割引 |
|---|---|---|---|---|
AWS | p5.48xlarge | 68.800(Capacity Blocksは47.757) | 50,224.00 | Savings Plans最大72%、スポット最大90%(EC2全体の最大値) |
Azure | Standard_ND96isr_H100_v5(東日本) | 142.564 | 104,071.72 | 1年予約で1時間あたり約91.24、3年予約で約62.59 |
Google Cloud | a3-highgpu-8g(東京) | 約126.64(SKU単価から算出) | 約92,449.68 | Spot VM最大91%、確約利用割引(A2・A3・G2が対象) |
出典:AWS「EC2 オンデマンドインスタンスの料金」(2026年11月9日確認)、AWS「Amazon EC2 Capacity Blocks for ML 料金」(2026年11月6日確認)、AWS「Amazon EC2 料金」(2026年11月6日確認)、Microsoft Learn「Azure Retail Prices REST API の概要」の価格データ(2026年11月9日取得)、Google Cloud「SKU」(2026年11月9日確認)、Google Cloud「VM インスタンスの料金」(2026年11月6日確認)
ポイント:
東京のH100×8をオンデマンドで1時間使うと、AWSは68.800米ドル、Google Cloudは約126.64米ドル、Azure(東日本)は142.564米ドルです。比べるときは、GPU・リージョン・購入方式・付帯費用の4項目を揃えます。
PoCから本番まで:フェーズ別の購入方式の選び方
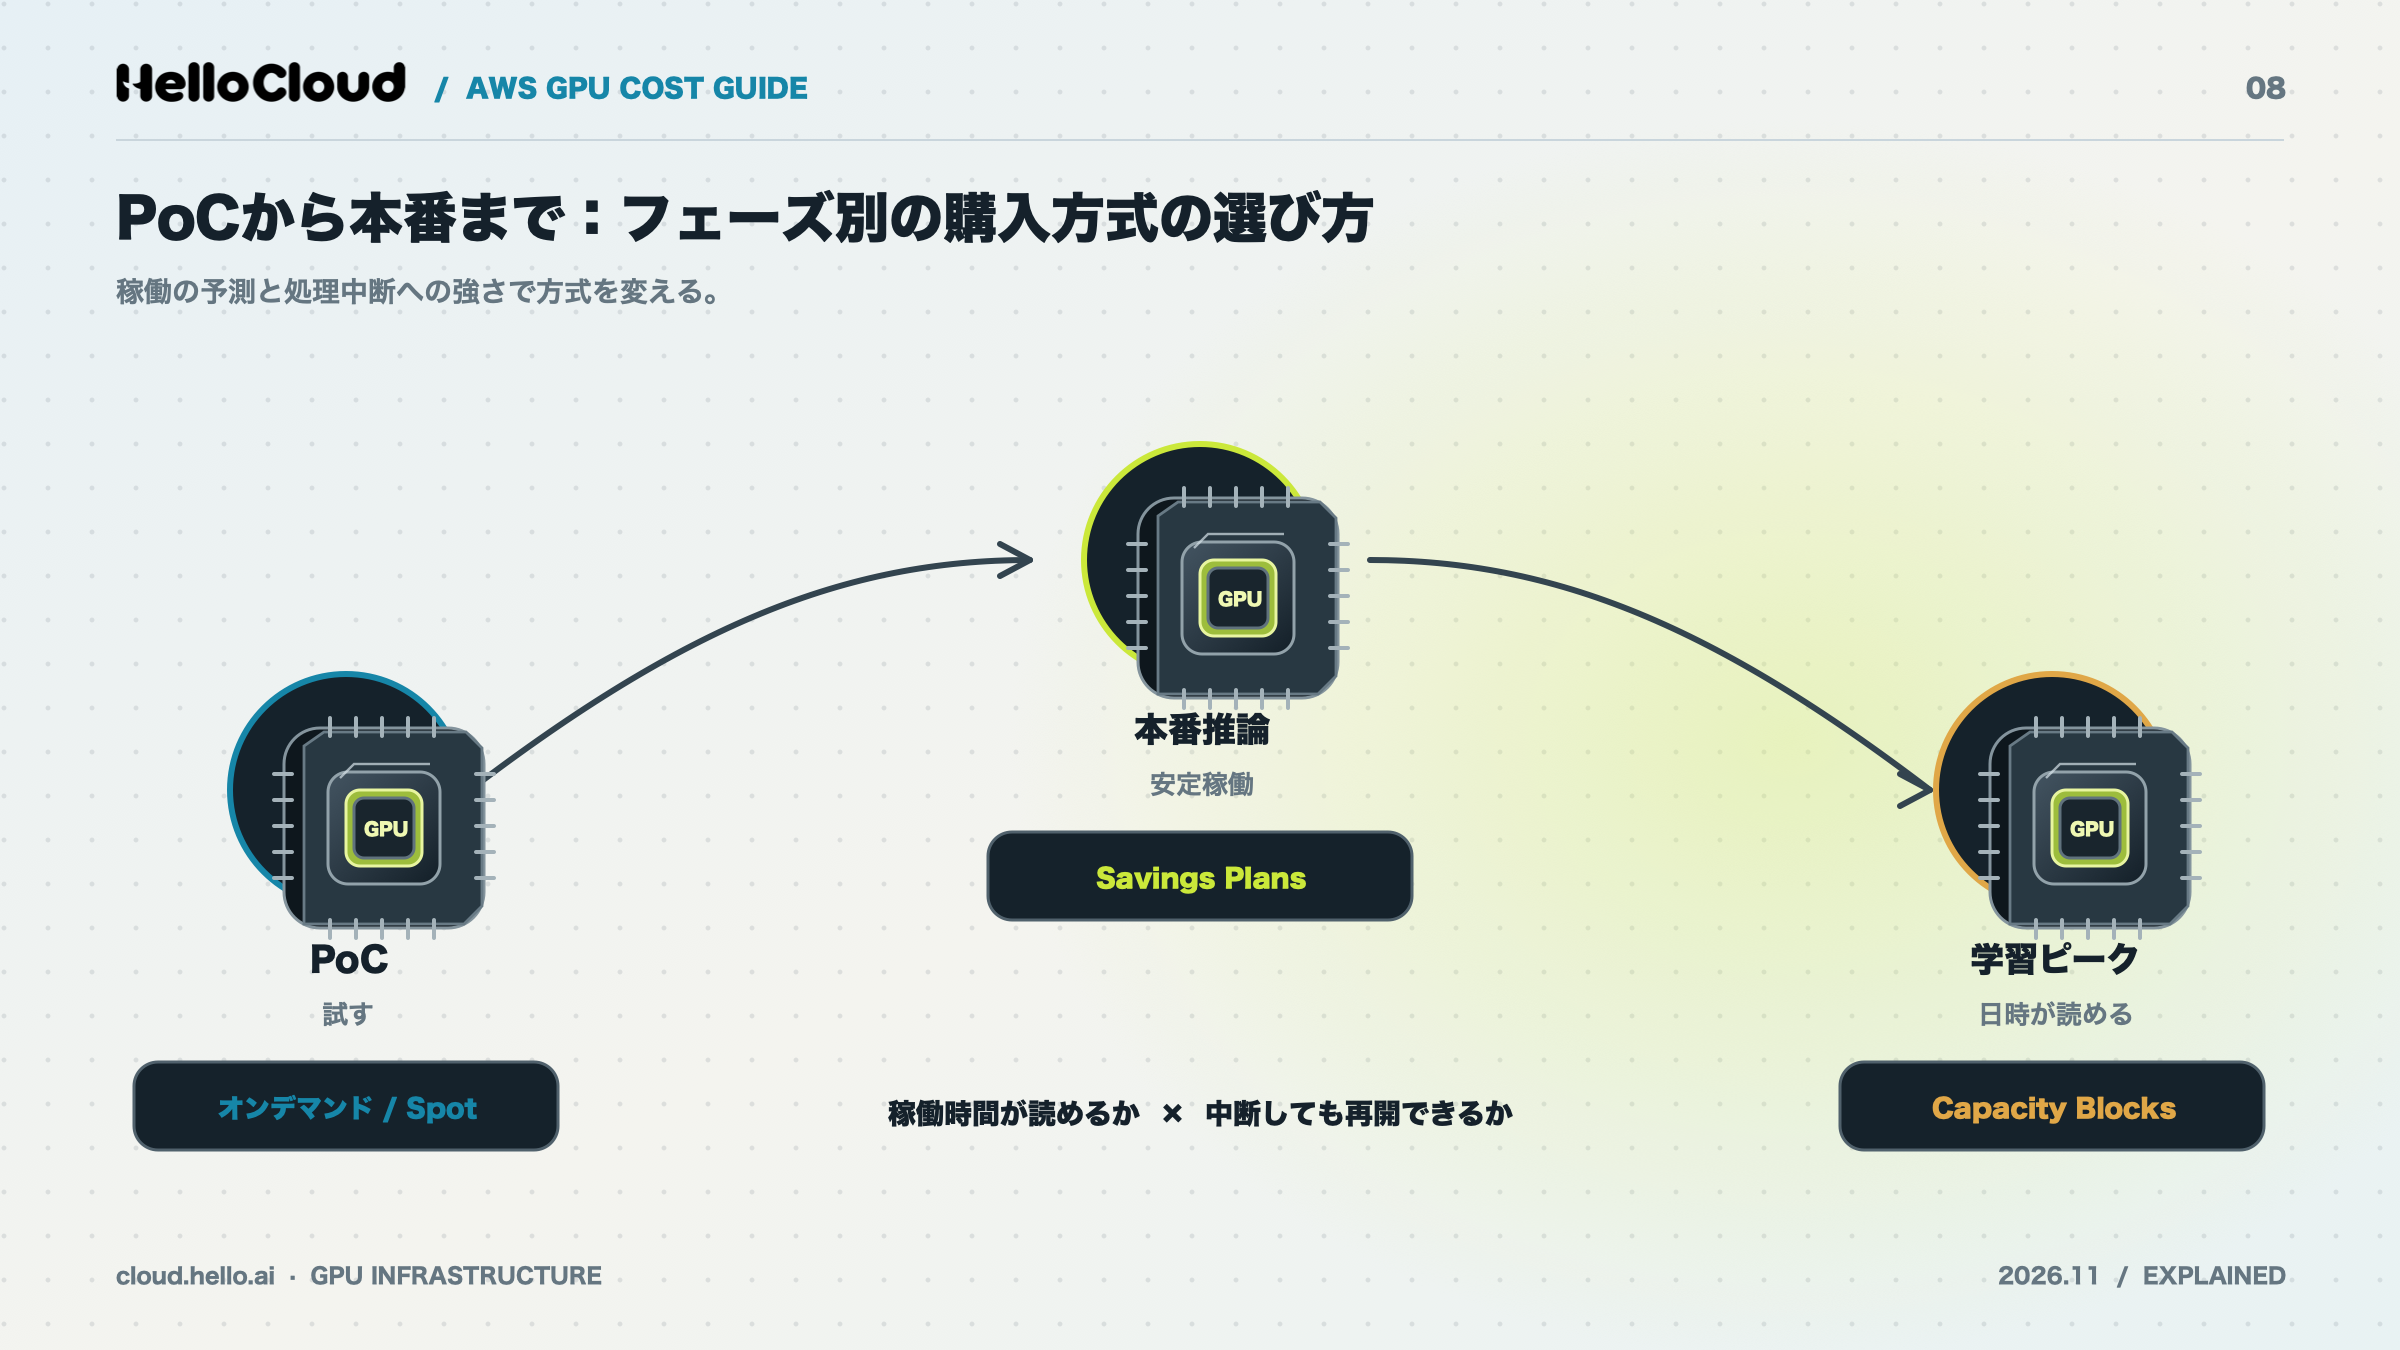
PoCはオンデマンドとスポット、本番推論はSavings Plans、学習のピークはCapacity Blocksが、AWSのGPUインスタンスの基本的な使い分けです。判断の軸は、GPUを使う時間が読めるか、処理が途中で止まっても再開できるかの2つです。
PoC:オンデマンドとスポットで小さく試す
PoCでは、稼働時間もGPUの種類もまだ決まっていないため、契約不要のオンデマンドが基本になります。学習の途中経過を保存して再開できる処理なら、スポットインスタンスを使うとオンデマンド比で最大90%割引になります。1年や3年のコミットは、稼働時間が見えてから検討しても遅くありません。
本番推論:稼働が読めるならSavings Plans
本番で推論を常時動かし、1時間あたりの利用額が読めるようになったら、Savings Plansが選択肢になります。1年または3年の利用額をコミットすると、料金はオンデマンド比で最大72%下がる仕組みです。コミット額は、PoCとリリース直後の実績から、必ず使う量だけに絞ります。推論サーバーの同時接続数と、100万トークンあたりのコストの出し方は、vLLMの使い方の解説で扱っています。
学習のピーク:Capacity Blocksで確保する
モデルの学習でH100やH200を数日〜数週間まとめて使う場合は、Capacity Blocksで日時を指定して予約します。予約料金は前払いで、購入時の単価が適用されるため、学習の日程が決まった時点で予算を確定できます。
スポットを使える処理・使えない処理
処理の種類 | 処理の例 | 理由 |
|---|---|---|
使える処理 | 途中経過を保存する学習、バッチ推論、データ前処理 | 中断されても保存した地点から再開できる |
使えない処理 | ユーザーに応答するリアルタイム推論API | 中断の2分前通知はベストエフォートで、応答が止まる |
出典:AWS「スポットインスタンスの中断通知」(2026年11月6日確認)
スポットインスタンスの中断通知は、Amazon EventBridgeの「EC2 Spot Instance Interruption Warning」イベントと、インスタンスメタデータのspot/instance-actionで受け取れます。AWSのドキュメントでは、IMDSv2(インスタンスメタデータサービスのバージョン2)で次のように取得する例が示されています。
TOKEN=`curl -X PUT "http://169.254.169.254/latest/api/token" -H "X-aws-ec2-metadata-token-ttl-seconds: 21600"` \
&& curl -H "X-aws-ec2-metadata-token: $TOKEN" http://169.254.169.254/latest/meta-data/spot/instance-action出典:AWS「スポットインスタンスの中断通知」(2026年11月6日確認)
AWSは中断通知を5秒ごとに確認することを推奨しています。通知を受けたら途中経過を保存する処理を、学習コードに組み込んでおきます。
ポイント:
使う時間が読めない段階はオンデマンド、読めたらSavings Plans、日程が決まった学習はCapacity Blocksです。スポットは中断しても再開できる処理に限ります。
AWSのGPUインスタンスの使い方と本番移行の注意点
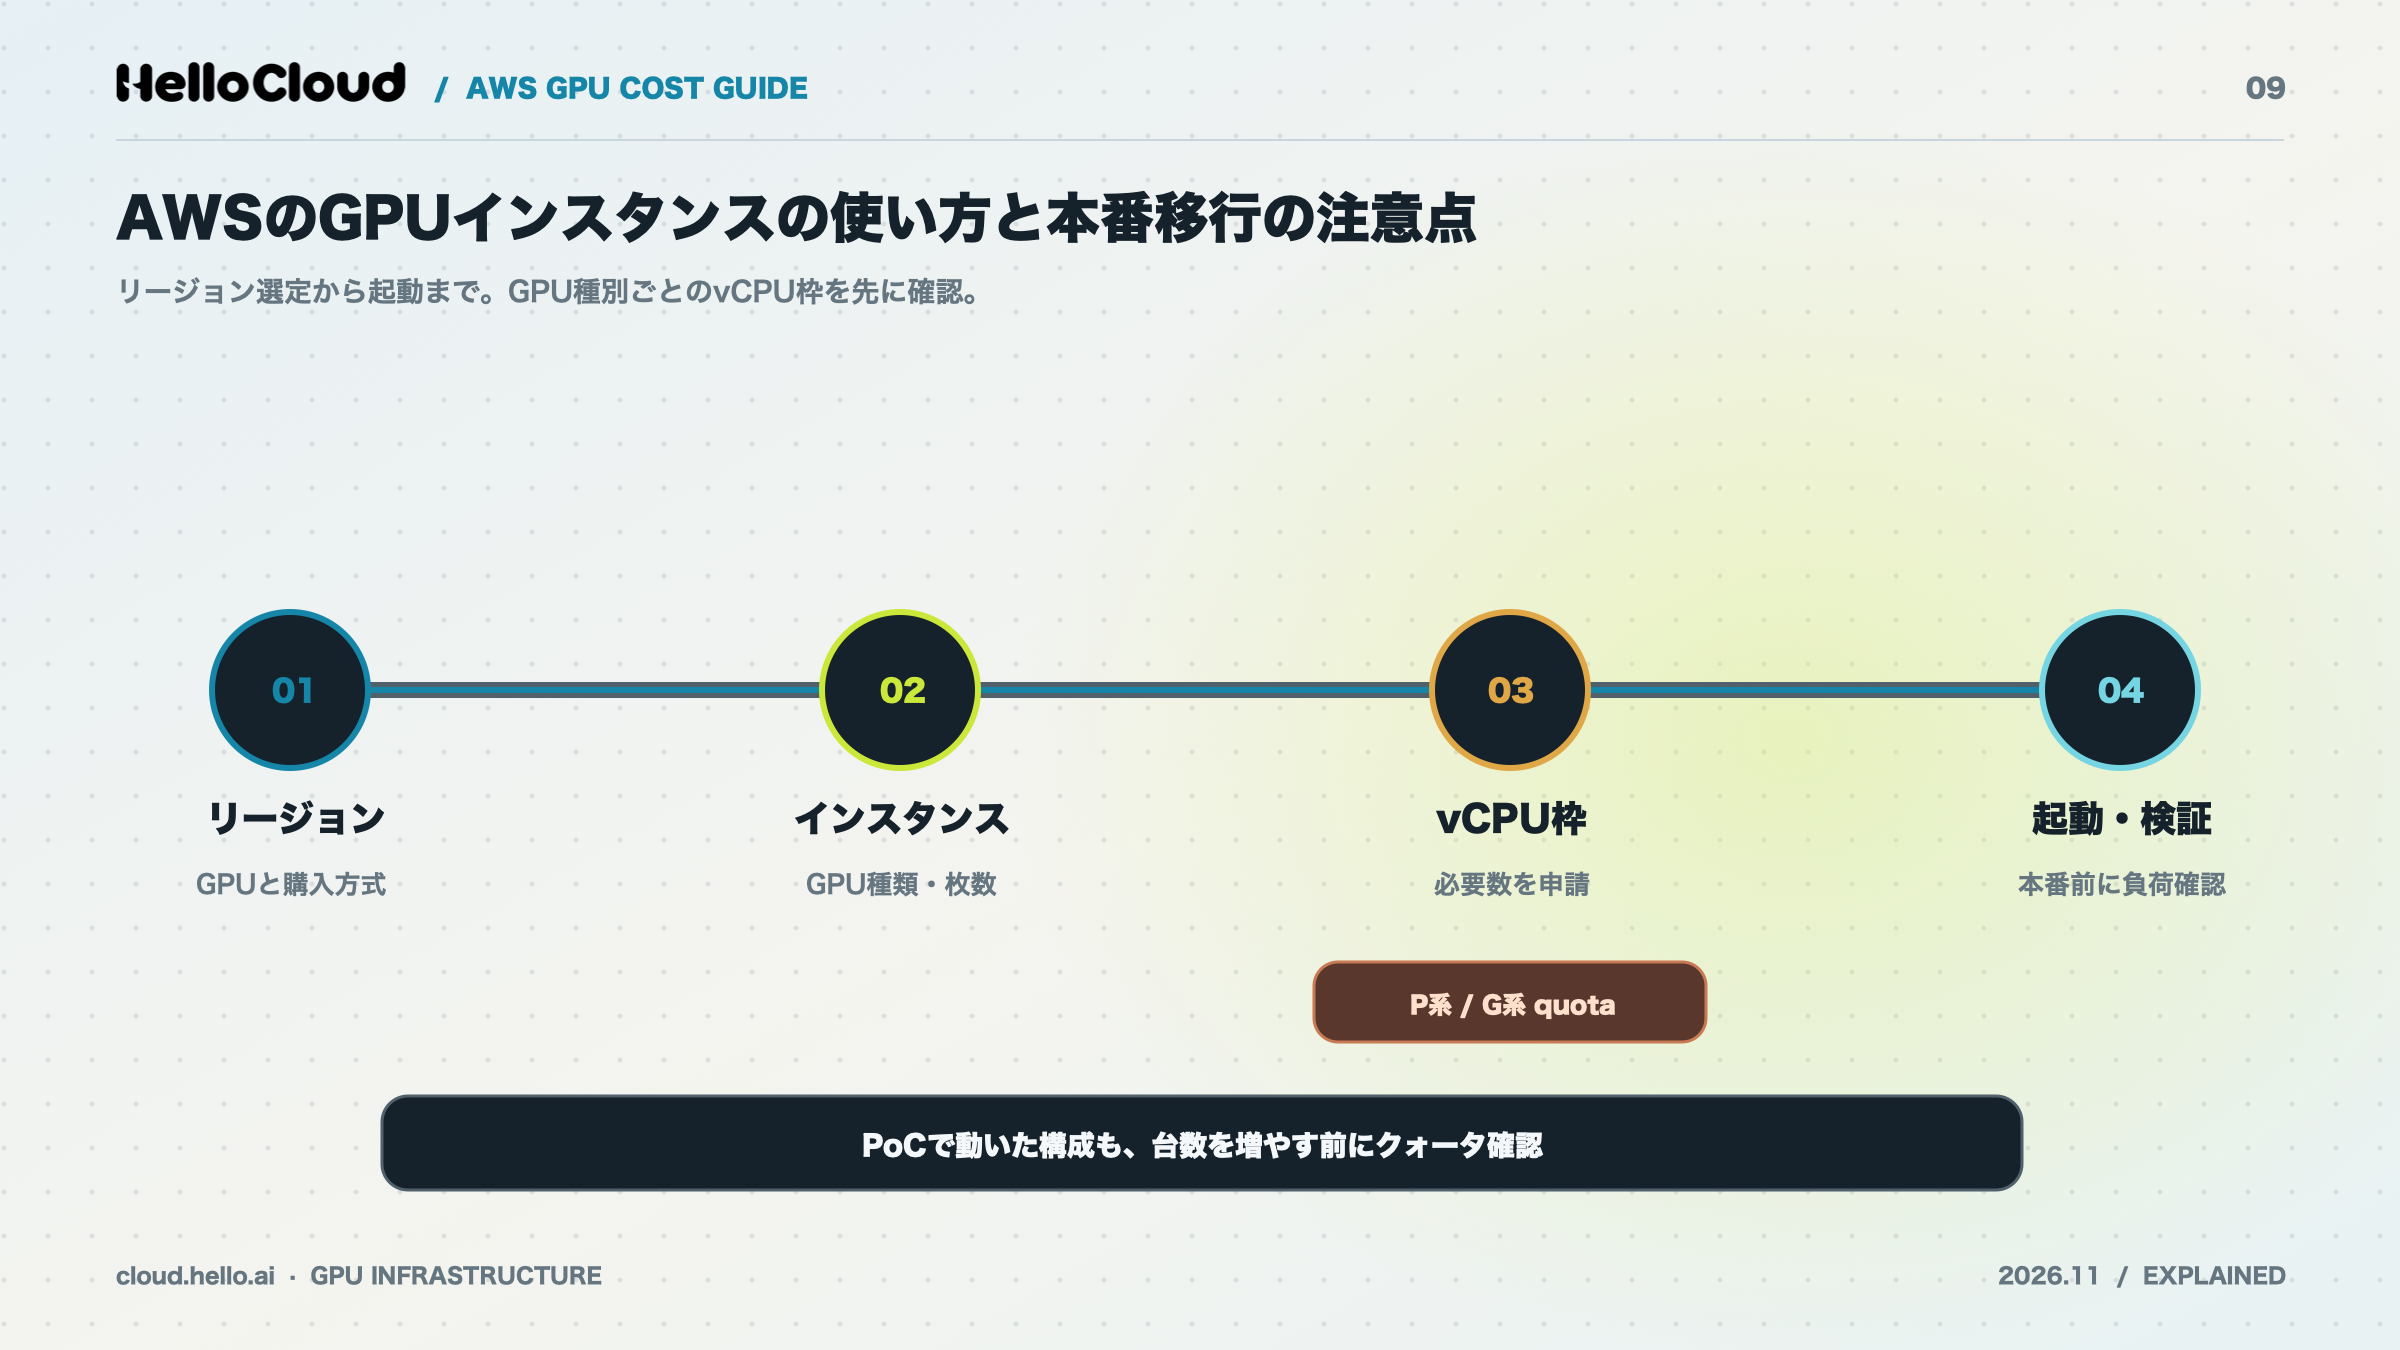
AWSでGPUインスタンスを使い始めるときは、リージョンとインスタンスタイプを決めたあと、起動の前にGPU種別ごとのvCPUクォータを確認します。PoCでは動いた構成が、本番の台数に増やした時点で起動できなくなるケースは、クォータの確認で防げます。
使い始める手順:リージョン選択から起動まで
リージョンを決める:使いたいGPUと購入方式が、そのリージョンで提供されているかを料金ページで確認します。
インスタンスタイプを決める:推論ならG系、大規模な学習ならP系が候補です。GPUの種類と枚数もここで決めます。
vCPUクォータを確認する:Service Quotasで、使うGPU種別のクォータが必要なvCPU数に足りているかを見ます。
インスタンスを起動する:決めたリージョンとインスタンスタイプで起動。起動後にGPUが正常に動くかは、GPUテストの方法で確かめられます。
料金を確認する:AWS料金計算ツールで月額を見積もり、実際の請求と照らし合わせます。
GPU種別ごとのvCPUクォータを確認する
AWSは、オンデマンドインスタンスで同時に使えるvCPUの上限(クォータ)を、インスタンスの種別ごとに設定しています。GPUインスタンスに関係するクォータの名前は、「オンデマンド G および VT インスタンスの実行」と「オンデマンド P インスタンスの実行」です。
クォータは使用量に応じて自動で引き上げられるほか、Service Quotasのコンソールから引き上げをリクエストできます。
出典:AWS「Amazon EC2 インスタンスタイプのクォータ」(2026年11月6日確認)
注意:
クォータは「同時に使えるvCPUの合計」で数えます。p5.48xlargeを複数台に増やす計画なら、本番の台数分のvCPUがクォータの範囲に収まるかを、リリース日より前に確認しておきます。
GPUの在庫と提供リージョン
H100やH200は、リージョンやアベイラビリティーゾーン(リージョン内のデータセンターの区画)によって、提供状況が異なります。在庫切れで起動できないときの見分け方と対処法は、GPUクラウドの在庫切れ対策で解説しています。
ポイント:
起動の前に、GPU種別ごとのvCPUクォータ(「オンデマンド G および VT インスタンスの実行」「オンデマンド P インスタンスの実行」)を本番の台数分確認します。
円建てで使える国内GPUクラウドという選択肢
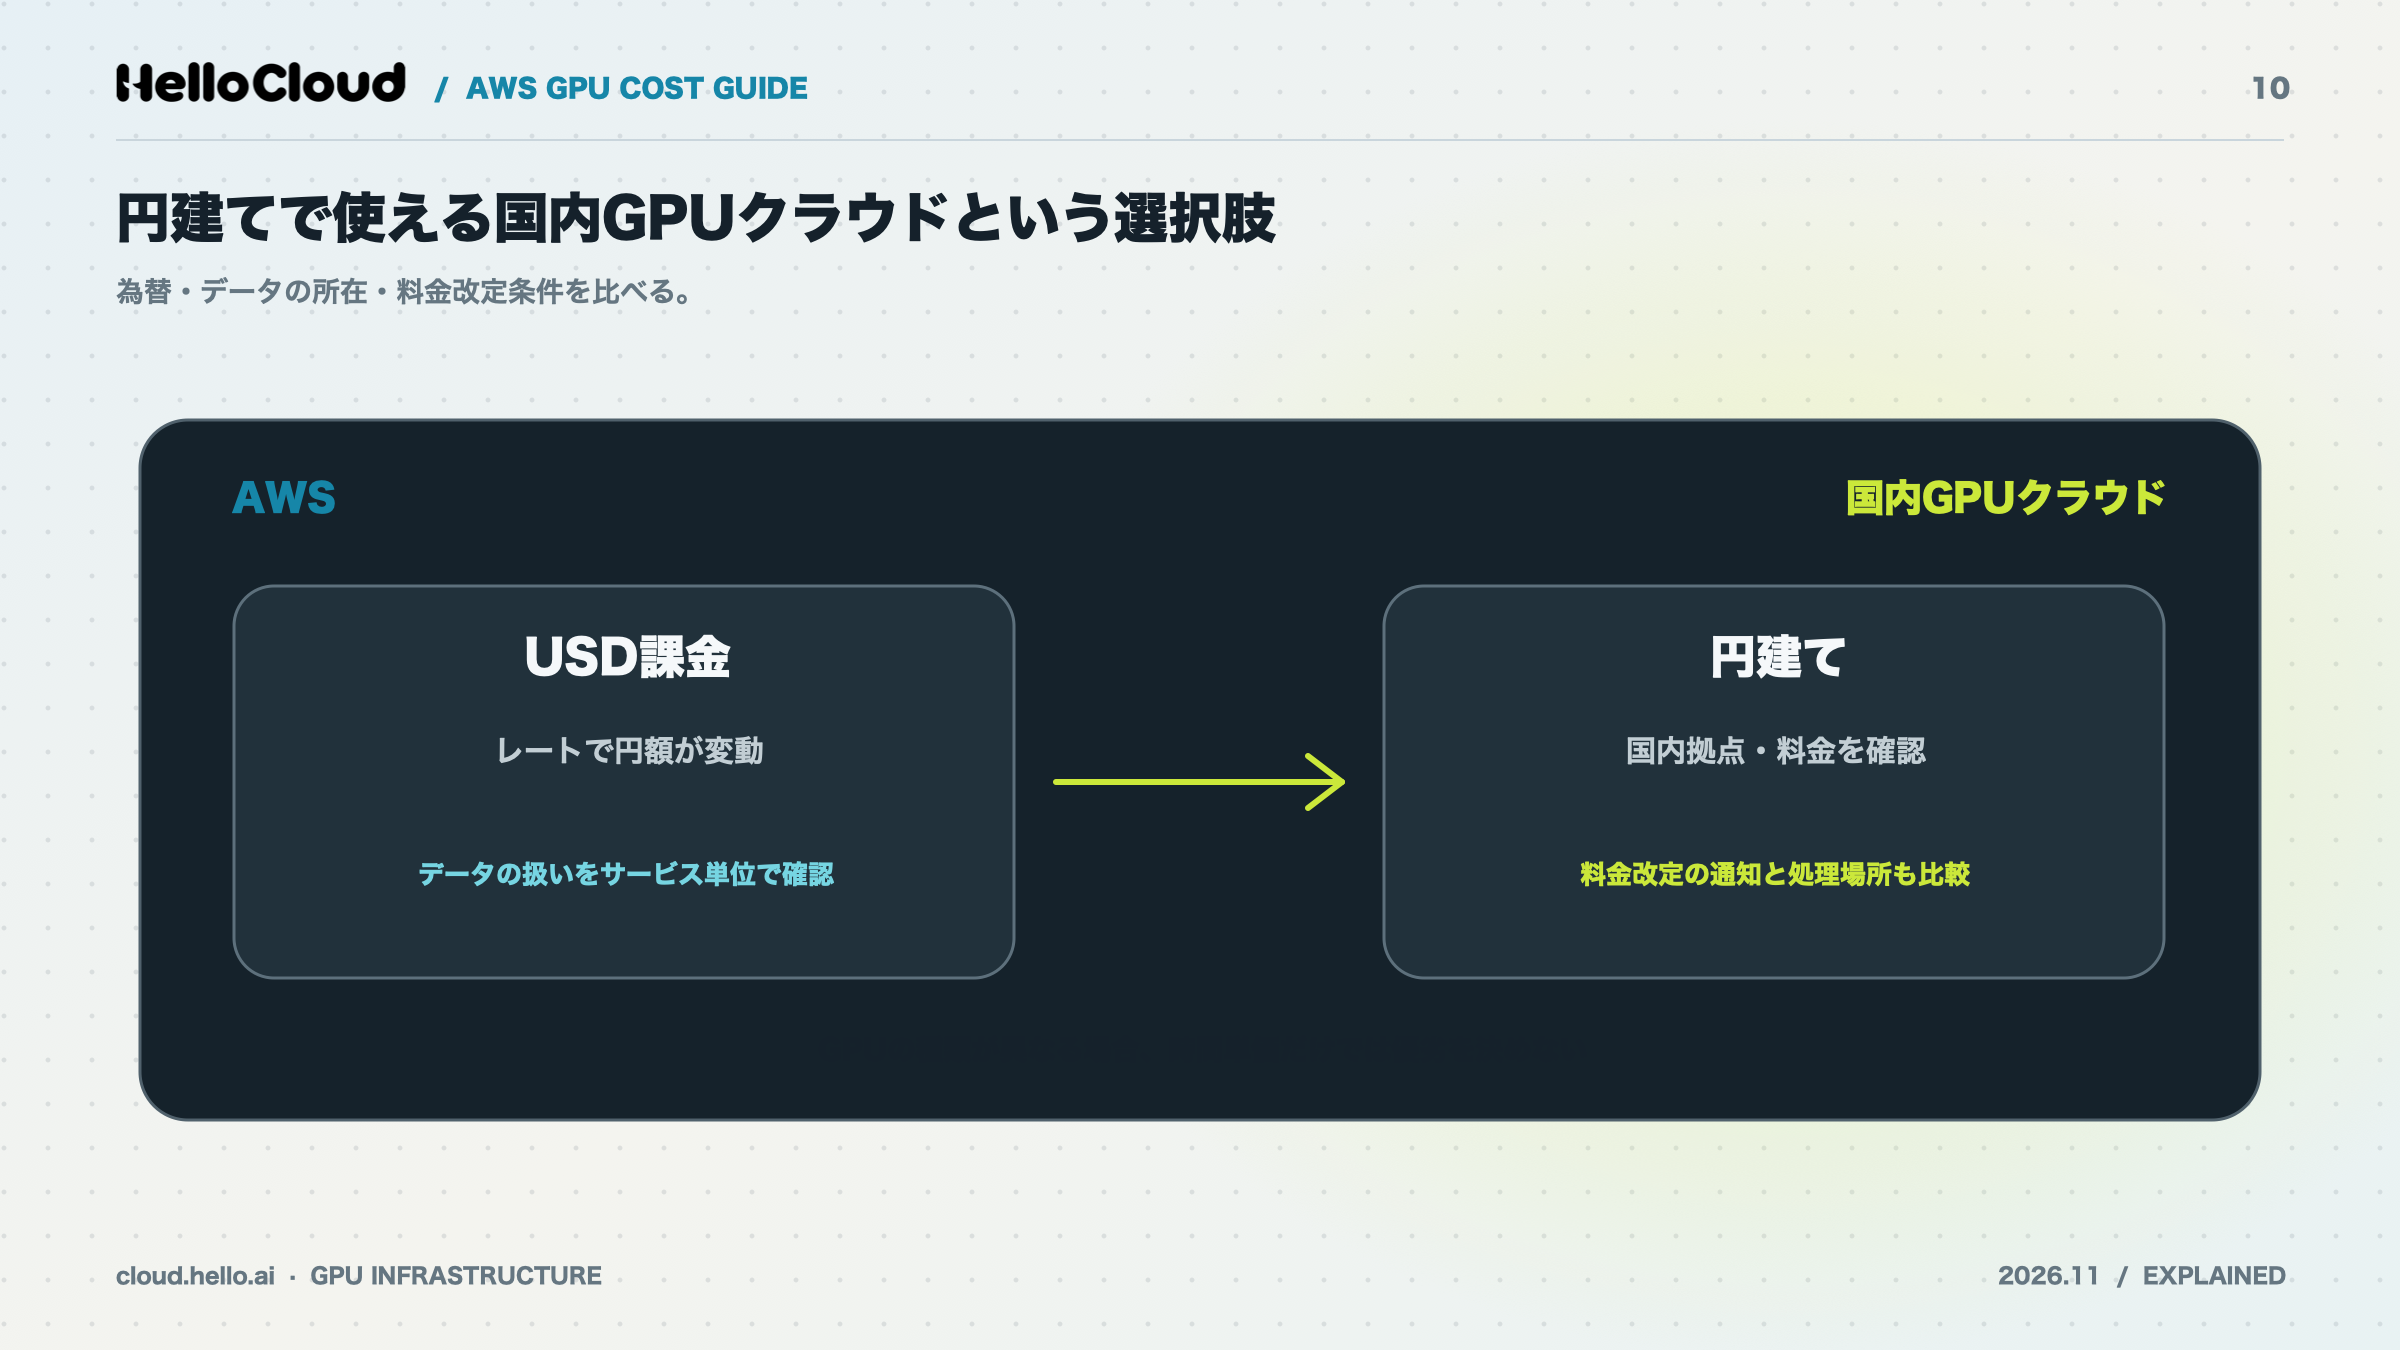
ドル建て課金による月額の変動を避けたい場合や、データの保存先を国内に決めたい場合は、円建てで料金を公開している国内GPUクラウドも比較の対象になります。AWSとはGPUの種類が違うため、時間単価で高い・安いは比べず、課金通貨・値上げの通知・データの扱いで比べます。
AWSで総額が読みにくくなる3つの場面
ドル建て課金:p5.48xlargeを730時間使う場合、為替が1円動くと月額が約3.5万円動きます。
単価の更新:Capacity Blocksの単価は需給に応じて定期的に更新され、2026年10月7日には東京のP5が+26.48%改定されました。
データの所在:リージョンを選んでも、どのサービスでどのデータを扱うかを社内で整理する必要があります。
HelloCloudの料金体系とデータの扱い
HelloCloudは、株式会社HelloCloudが提供する国産のGPUクラウドです。日本国内のデータセンターでAIモデルの実行・学習ができ、東京の2拠点でGPUインスタンスとサーバーレスGPU実行環境が稼働しています。
HelloCloudのGPUはRTX 6000とB300で、AWSのH100・H200とは種類が異なるため、下の表の料金をAWSの単価と直接比べることはできません。
項目 | 内容 |
|---|---|
料金(参考価格) | RTX 6000:1時間380円、B300:1時間1,480円(1インスタンスあたりの参考価格。税込・税別の記載なし) |
課金方式 | 従量課金で使った分だけ支払う。初期費用は不要 |
値上げの通知 | 利用中のサービスの値上げや新たな費用の追加は、30日以上前に通知(利用規約 第3条) |
データの保存先 | 利用者が保存先のリージョンを選べる。法令や政府機関の拘束力ある命令への対応を除き、選択されたリージョンの外へ移動しない(利用規約 第1条1.4) |
利用開始 | 申し込みの当日からGPUを使える |
SLA | APIのリクエスト成功率で、月間稼働率99.9%以上の維持に向けて努力する目標(保証ではない)。GPU上の計算精度・処理時間は対象外 |
出典:株式会社HelloCloud「HelloCloud」公式サイト、HelloCloud SLA(2026年11月5日確認)
ストレージやデータ転送の料金、課金の単位などの詳しい条件は資料請求で確認できます。
導入事例:株式会社ラス恋・Aimy株式会社
HelloCloudの公式サイトでは、2社の導入事例が紹介されています。
株式会社ラス恋(CEO 山口様):会員の個人情報を扱うため推論も国外のサーバーに出せない前提で、処理を国内に閉じられる点が決め手になり、申し込んだ日のうちに検証を始め、レコメンドのモデルを本番に載せている。
Aimy株式会社(CEO 平野様):AIキャラクターとの対話サービスで推論を常時動かしながら、同じ環境でモデルの学習も進めている。
出典:株式会社HelloCloud「HelloCloud」公式サイト(2026年11月5日確認)
ポイント:
国内GPUクラウドとは時間単価ではなく、課金通貨・値上げの通知期間・データの保存先で比べます。HelloCloudは円建ての参考価格を公開し、値上げは30日以上前に通知すると利用規約に定めています。
円建てでGPUを使える環境を比較している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。LLM推論・モデル学習・バッチ処理での活用方法もまとめています。
資料請求(HelloCloudの特徴と料金)
よくある質問
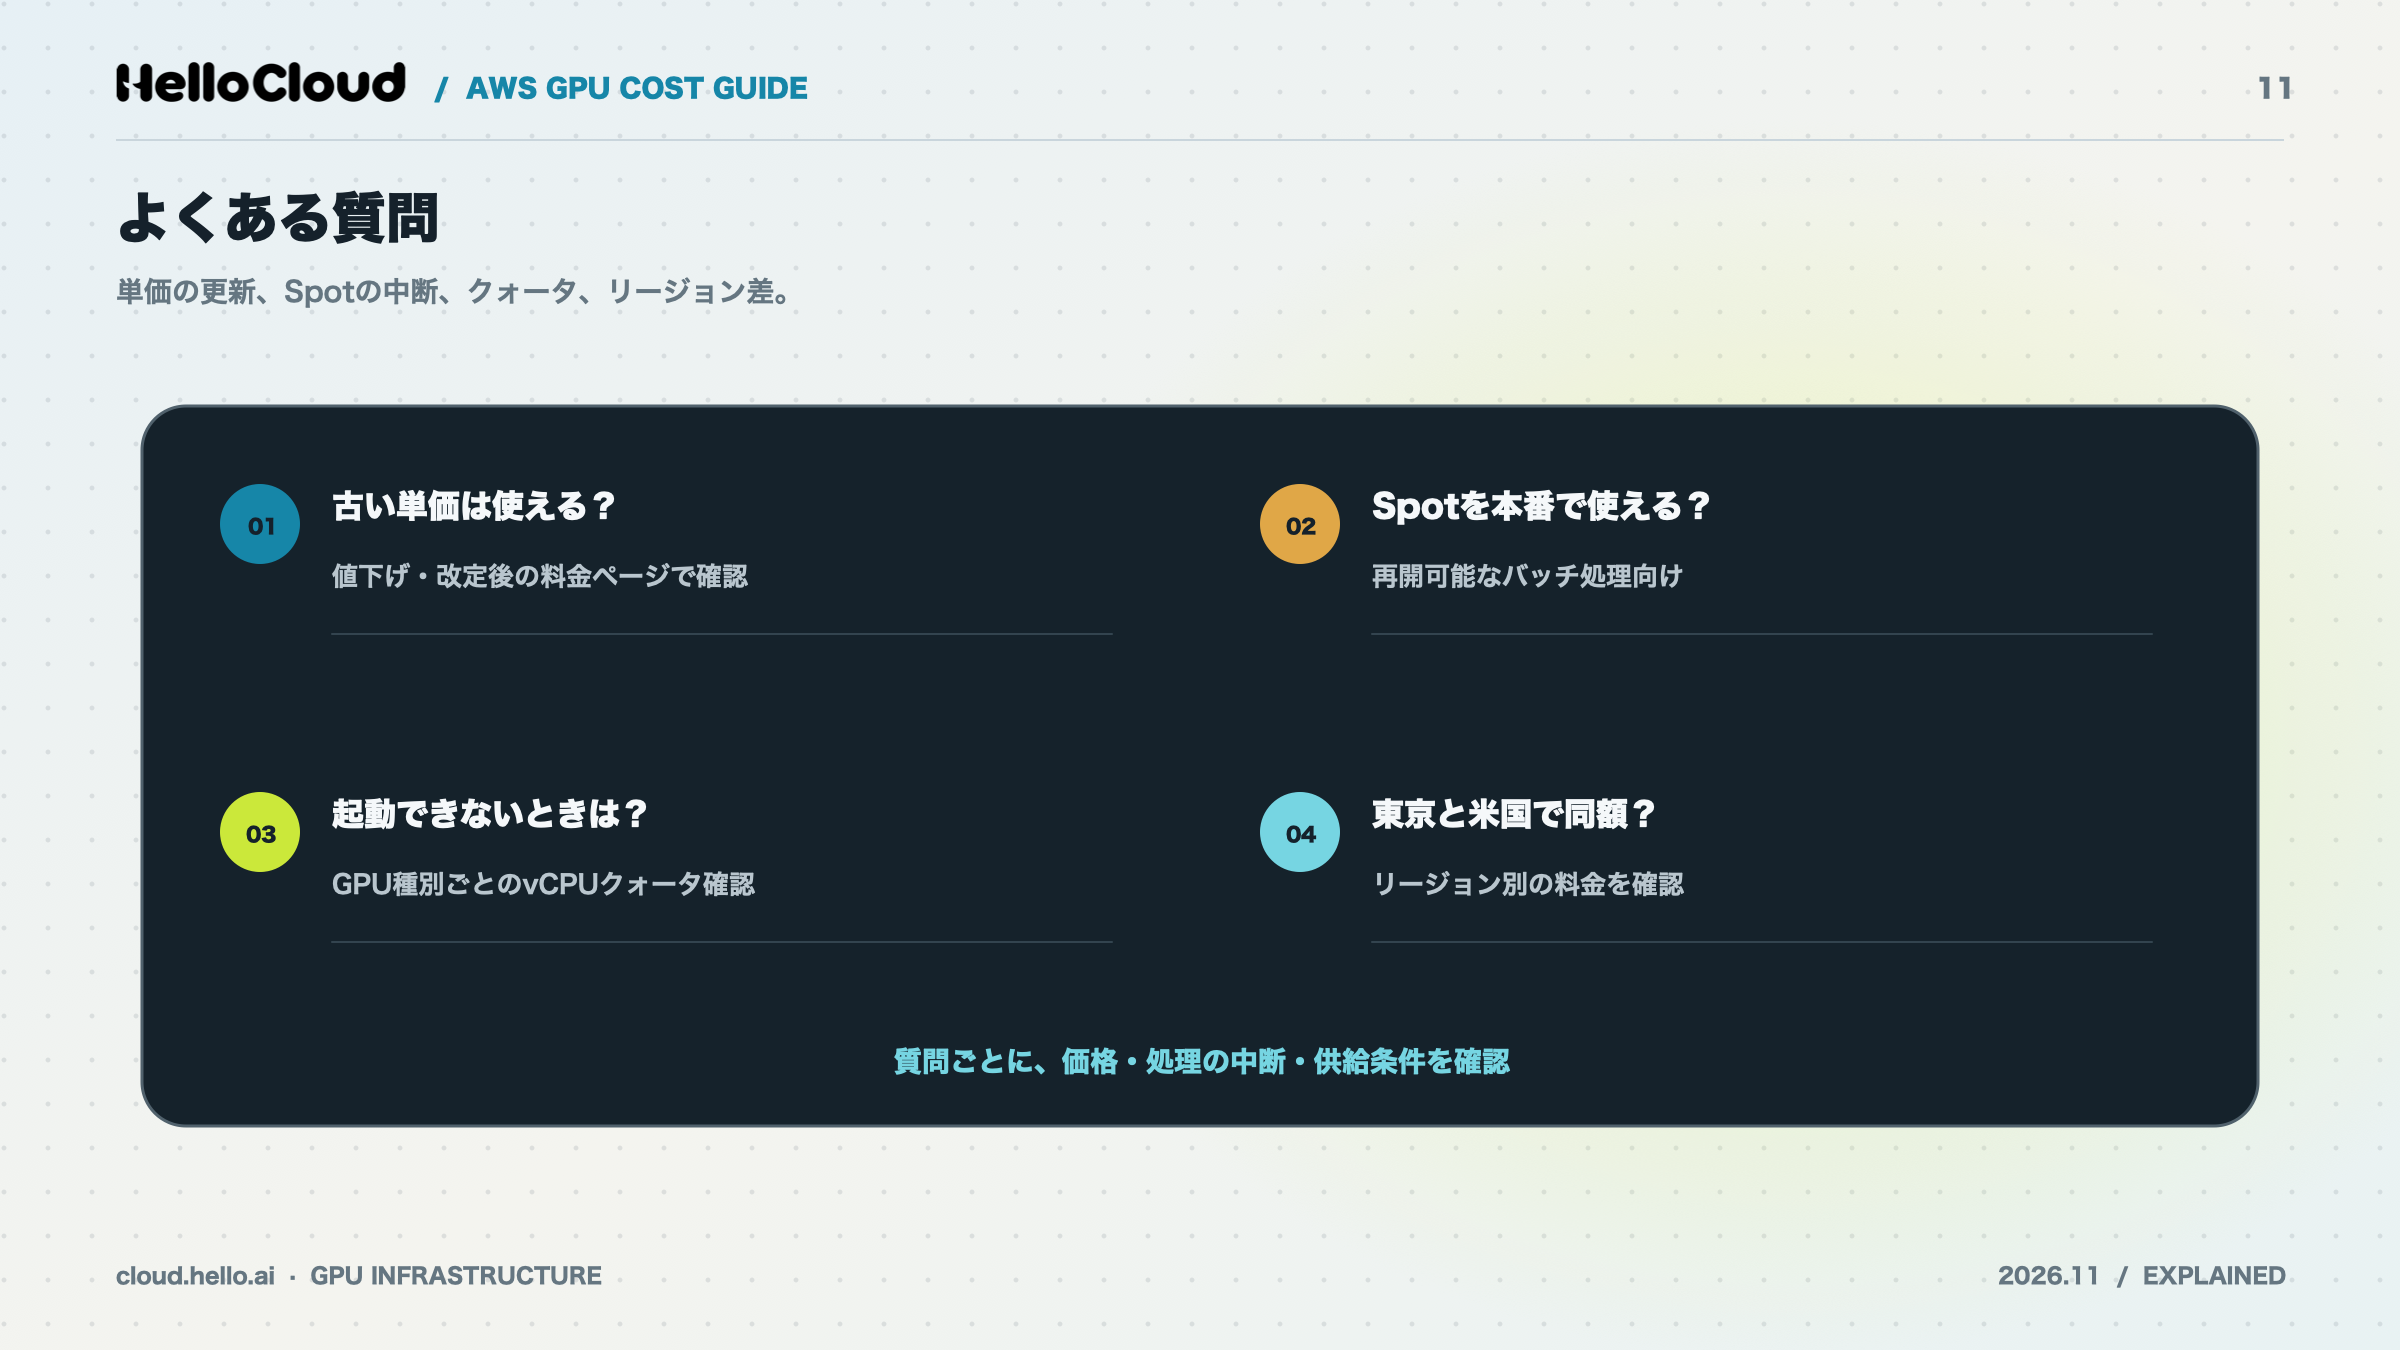
AWSのGPUインスタンス料金について、単価の新しさ・スポット・クォータ・予約単価の更新・リージョン差・無料利用枠の6つの質問に答えます。
2025年以前の記事の単価は使えますか?
2025年5月以前のP4・P5のオンデマンド単価は値下げ前の値のため、見積もりには使えません。P5のオンデマンドは2025年6月に44%引き下げられ、Capacity Blocksの単価も2026年10月7日に改定されています。現行の単価は、AWSの料金ページで確認してください。
スポットインスタンスは本番環境で使えますか?
スポットインスタンスは、中断されても途中から再開できる本番のバッチ処理には使えますが、ユーザーに応答し続ける推論APIには向きません。中断通知は停止・終了の2分前に出ますが、ベストエフォートのため、応答が止まると困る処理はオンデマンドかSavings Plansで動かします。
GPUインスタンスが起動できないときは?
GPUインスタンスが起動できないときは、まずService Quotasで「オンデマンド G および VT インスタンスの実行」または「オンデマンド P インスタンスの実行」のvCPUクォータを確認します。必要なvCPU数に足りなければ、引き上げをリクエストします。
Capacity Blocksの価格はいつ変わりますか?
Capacity Blocksの予約単価は需給に応じて定期的に更新され、次回の更新は2027年1月に予定されています。購入した時点の単価が適用されるため、開始日が更新後でも、更新前に購入した予約は購入時の単価のままです。
東京とバージニア北部で料金は違いますか?
オンデマンドの単価は違います。2026年11月9日時点のオンデマンド単価(Linux)は、p5.48xlargeが東京68.800米ドル・バージニア北部55.040米ドル、g4dn.xlargeが東京0.710米ドル・バージニア北部0.526米ドルです。Capacity Blocksの単価は、2026年10月7日の改定後、GovCloudのP6-B300・P6-B200を除いて全リージョンで同じです。
出典:AWS「EC2 オンデマンドインスタンスの料金」(2026年11月9日確認)
AWSの無料利用枠でGPUインスタンスは使えますか?
AWSの無料利用枠で無料になるインスタンスタイプに、G系・P系のGPUインスタンスは含まれていません。対象は、2025年7月15日以降に作成したアカウントではt3.micro、t3.small、t4g.micro、t4g.small、c7i-flex.large、m7i-flex.large、それより前に作成したアカウントではt2.micro(t2.microがないリージョンではt3.micro)です。
出典:AWS「Amazon EC2 インスタンスの起動」(2026年11月9日確認)
まとめ:AWSのGPU料金は総額と確認日で判断する
AWSのGPUインスタンス料金は、確認日つきの単価をもとに、付帯費用と為替を足した総額で判断します。
総額の計算式:時間単価×稼働時間+データ転送料+ストレージ料金+OS料金。東京のp5.48xlargeはCapacity Blocksで1時間47.757米ドル、730時間で34,862.61米ドルです(2026年11月6日確認)。
確認日つきの単価:2025年6月にP4・P5のオンデマンドが値下げ、2026年10月7日にCapacity Blocksが改定されました。古い単価は使わず、公式ページで確認します。
フェーズ別の購入方式:PoCはオンデマンドとスポット、本番推論はSavings Plans(最大72%削減)、学習のピークはCapacity Blocksです。
GPU費用を円建てで見通したい方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。HelloCloudは従量課金で、初期費用は不要です。
資料請求(HelloCloudの特徴と料金)
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


