この記事の結論
GPUクラウドの在庫は時間・ゾーン・GPUの型で変わり、クォータを引き上げても在庫があるとは限りません。エラー名で原因を切り分け、在庫切れなら再試行、予約、別の調達先の順に検討します。
GPUクラウドの在庫とは?クォータ(上限)との違い
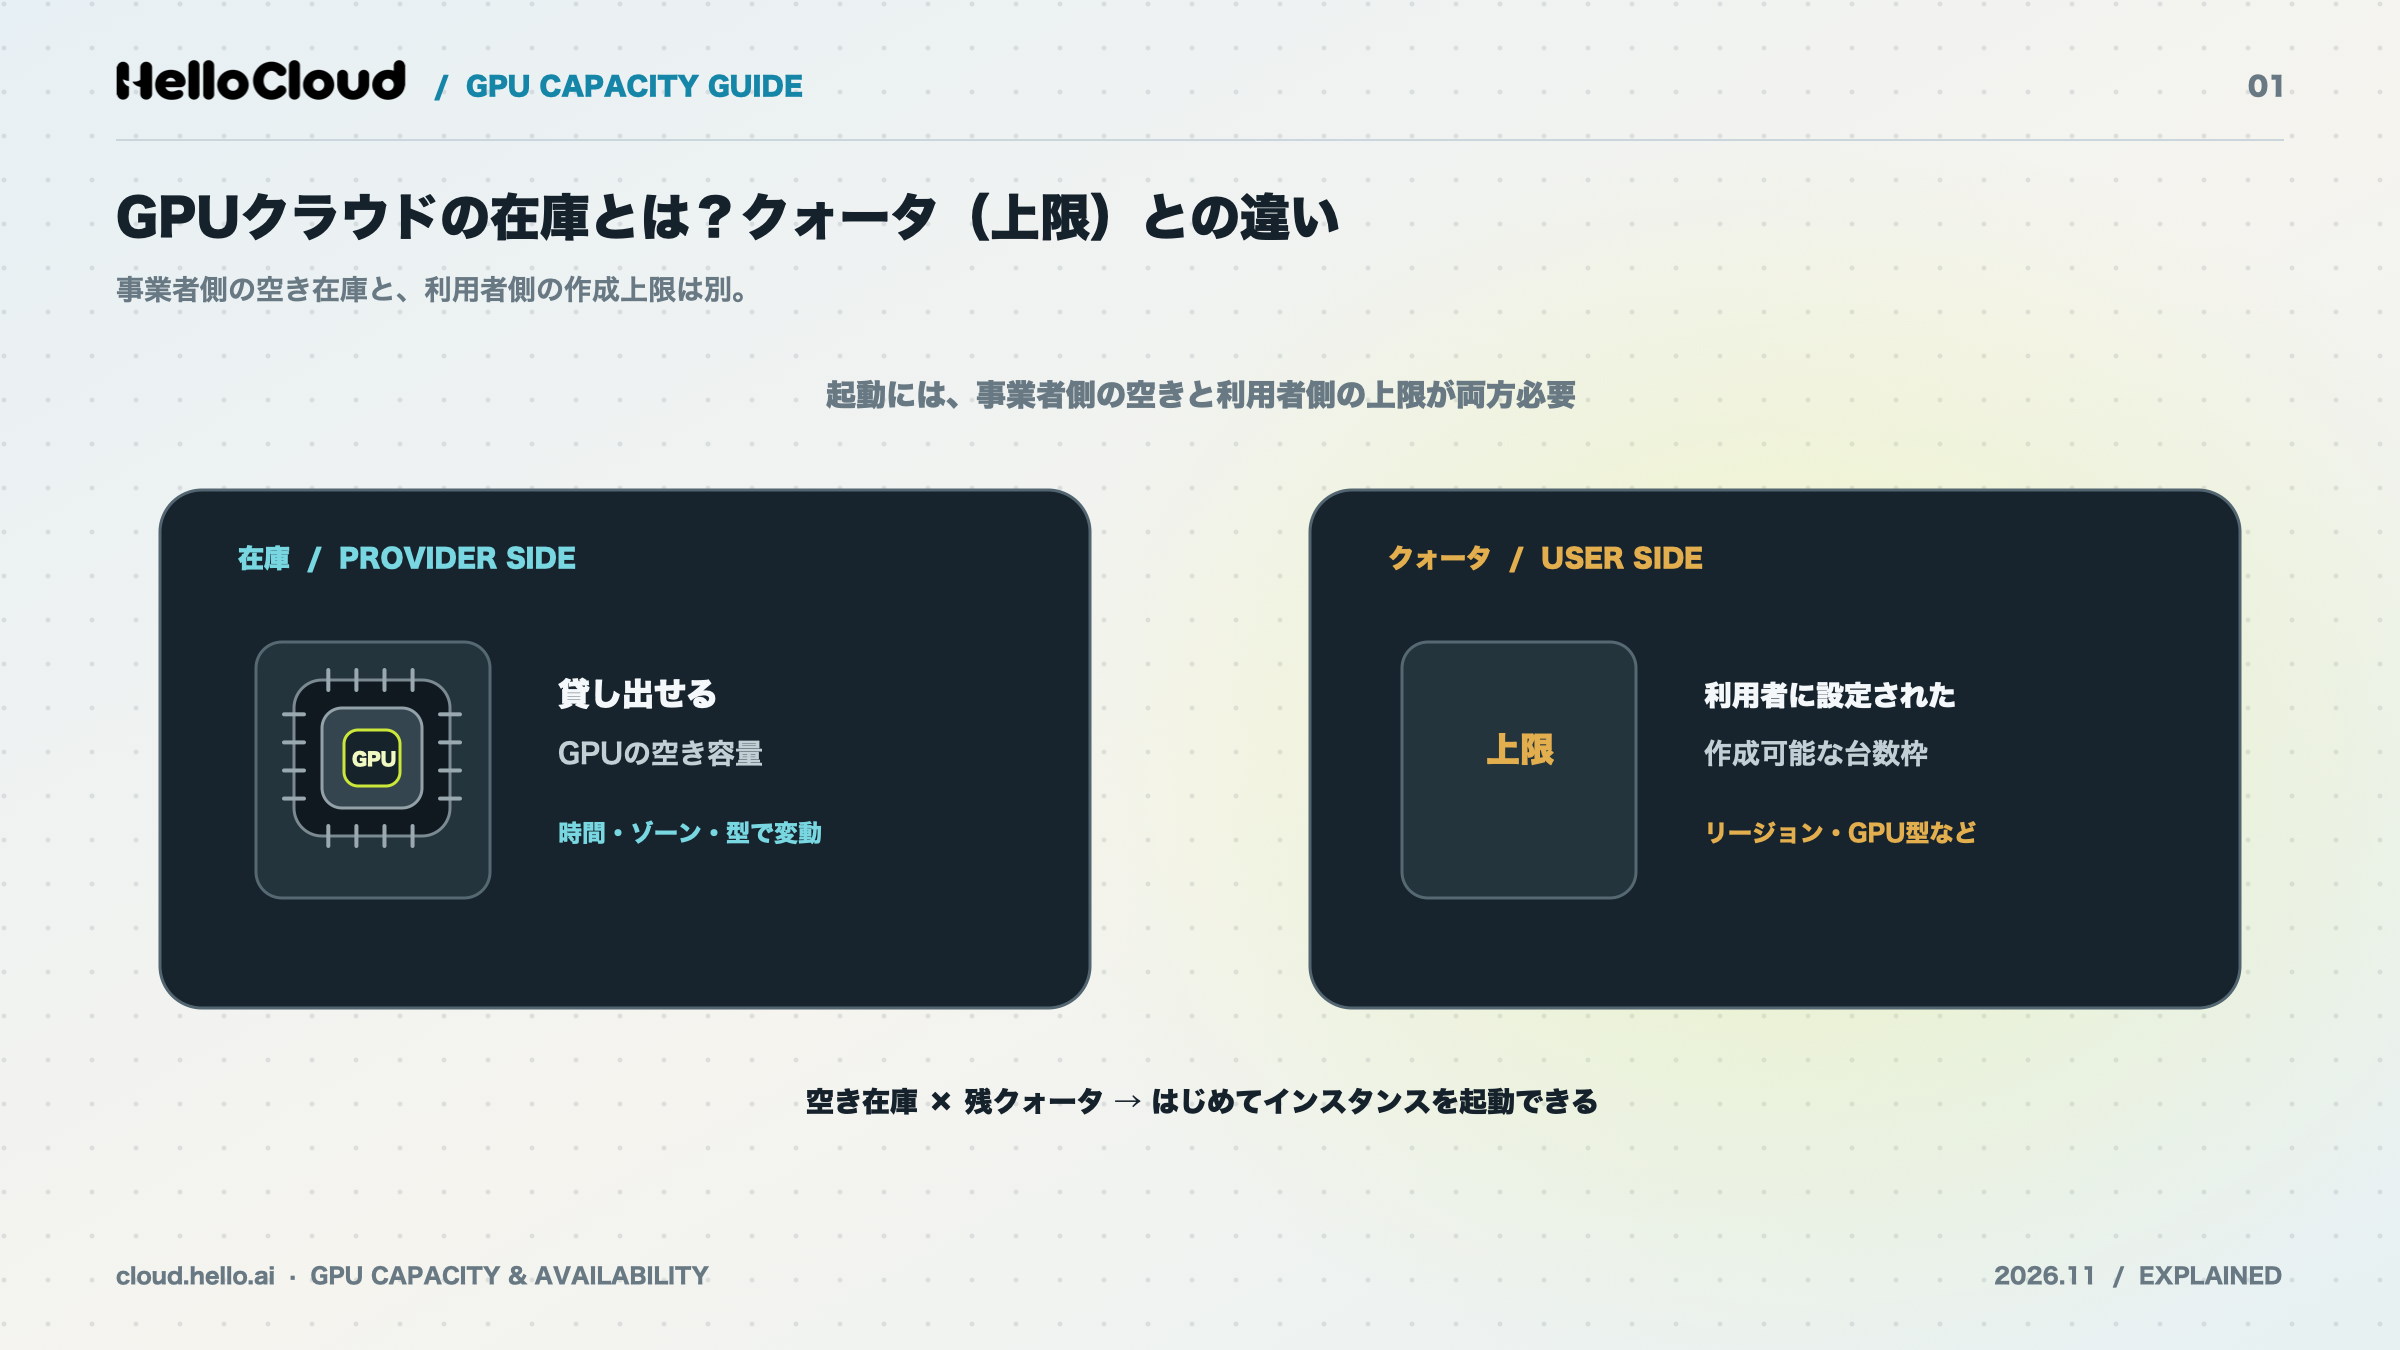
GPUクラウドの在庫とは、事業者側でいま貸し出せるGPUの空き容量のことで、アカウントごとの上限であるクォータとは別のものです。在庫は事業者の設備で決まり、クォータは利用者側の設定で決まります。
在庫は事業者の空き容量で、時間・ゾーン・型で変わる
GPUクラウドの在庫は、同じ事業者でも時間・ゾーン・GPUの型によって変わります。ゾーンはリージョン(データセンターのある地域)の中の区画で、AWSではアベイラビリティーゾーン(AZ)と呼ぶ区画です。
AWSの公式ドキュメントにも、オンデマンド(使う時に借りる通常の利用方法)の容量は頻繁に変動するとあります。GPUの空き状況は、起動を試したときのエラーで確かめられます(出典:EC2の起動エラーの解説(AWS)、2026年11月9日確認)。
クォータは使える数の上限で、在庫を保証しない
クォータは「リソースがあれば作成できる上限の数」で、在庫を保証しません。Google Cloudの公式ドキュメントによると、ゾーンの在庫が尽きると、クォータが残っていてもそのゾーンでは作成できない場合があります。
区分 | 何を表すか | 足りないときのエラー(AWSの場合) | 最初の対処 |
|---|---|---|---|
在庫 | 事業者側の空き容量 | InsufficientInstanceCapacity | 時間・台数・ゾーン・型を変えて再試行 |
クォータ | 利用者側の上限 | InstanceLimitExceeded | 上限の引き上げを申請 |
出典:EC2の起動エラーの解説(AWS)、Compute Engineのクォータの解説(Google Cloud)(2026年11月9日確認)
ポイント:
クォータを引き上げても、在庫がなければGPUは起動できません。
GPUクラウドの在庫が足りなくなる理由
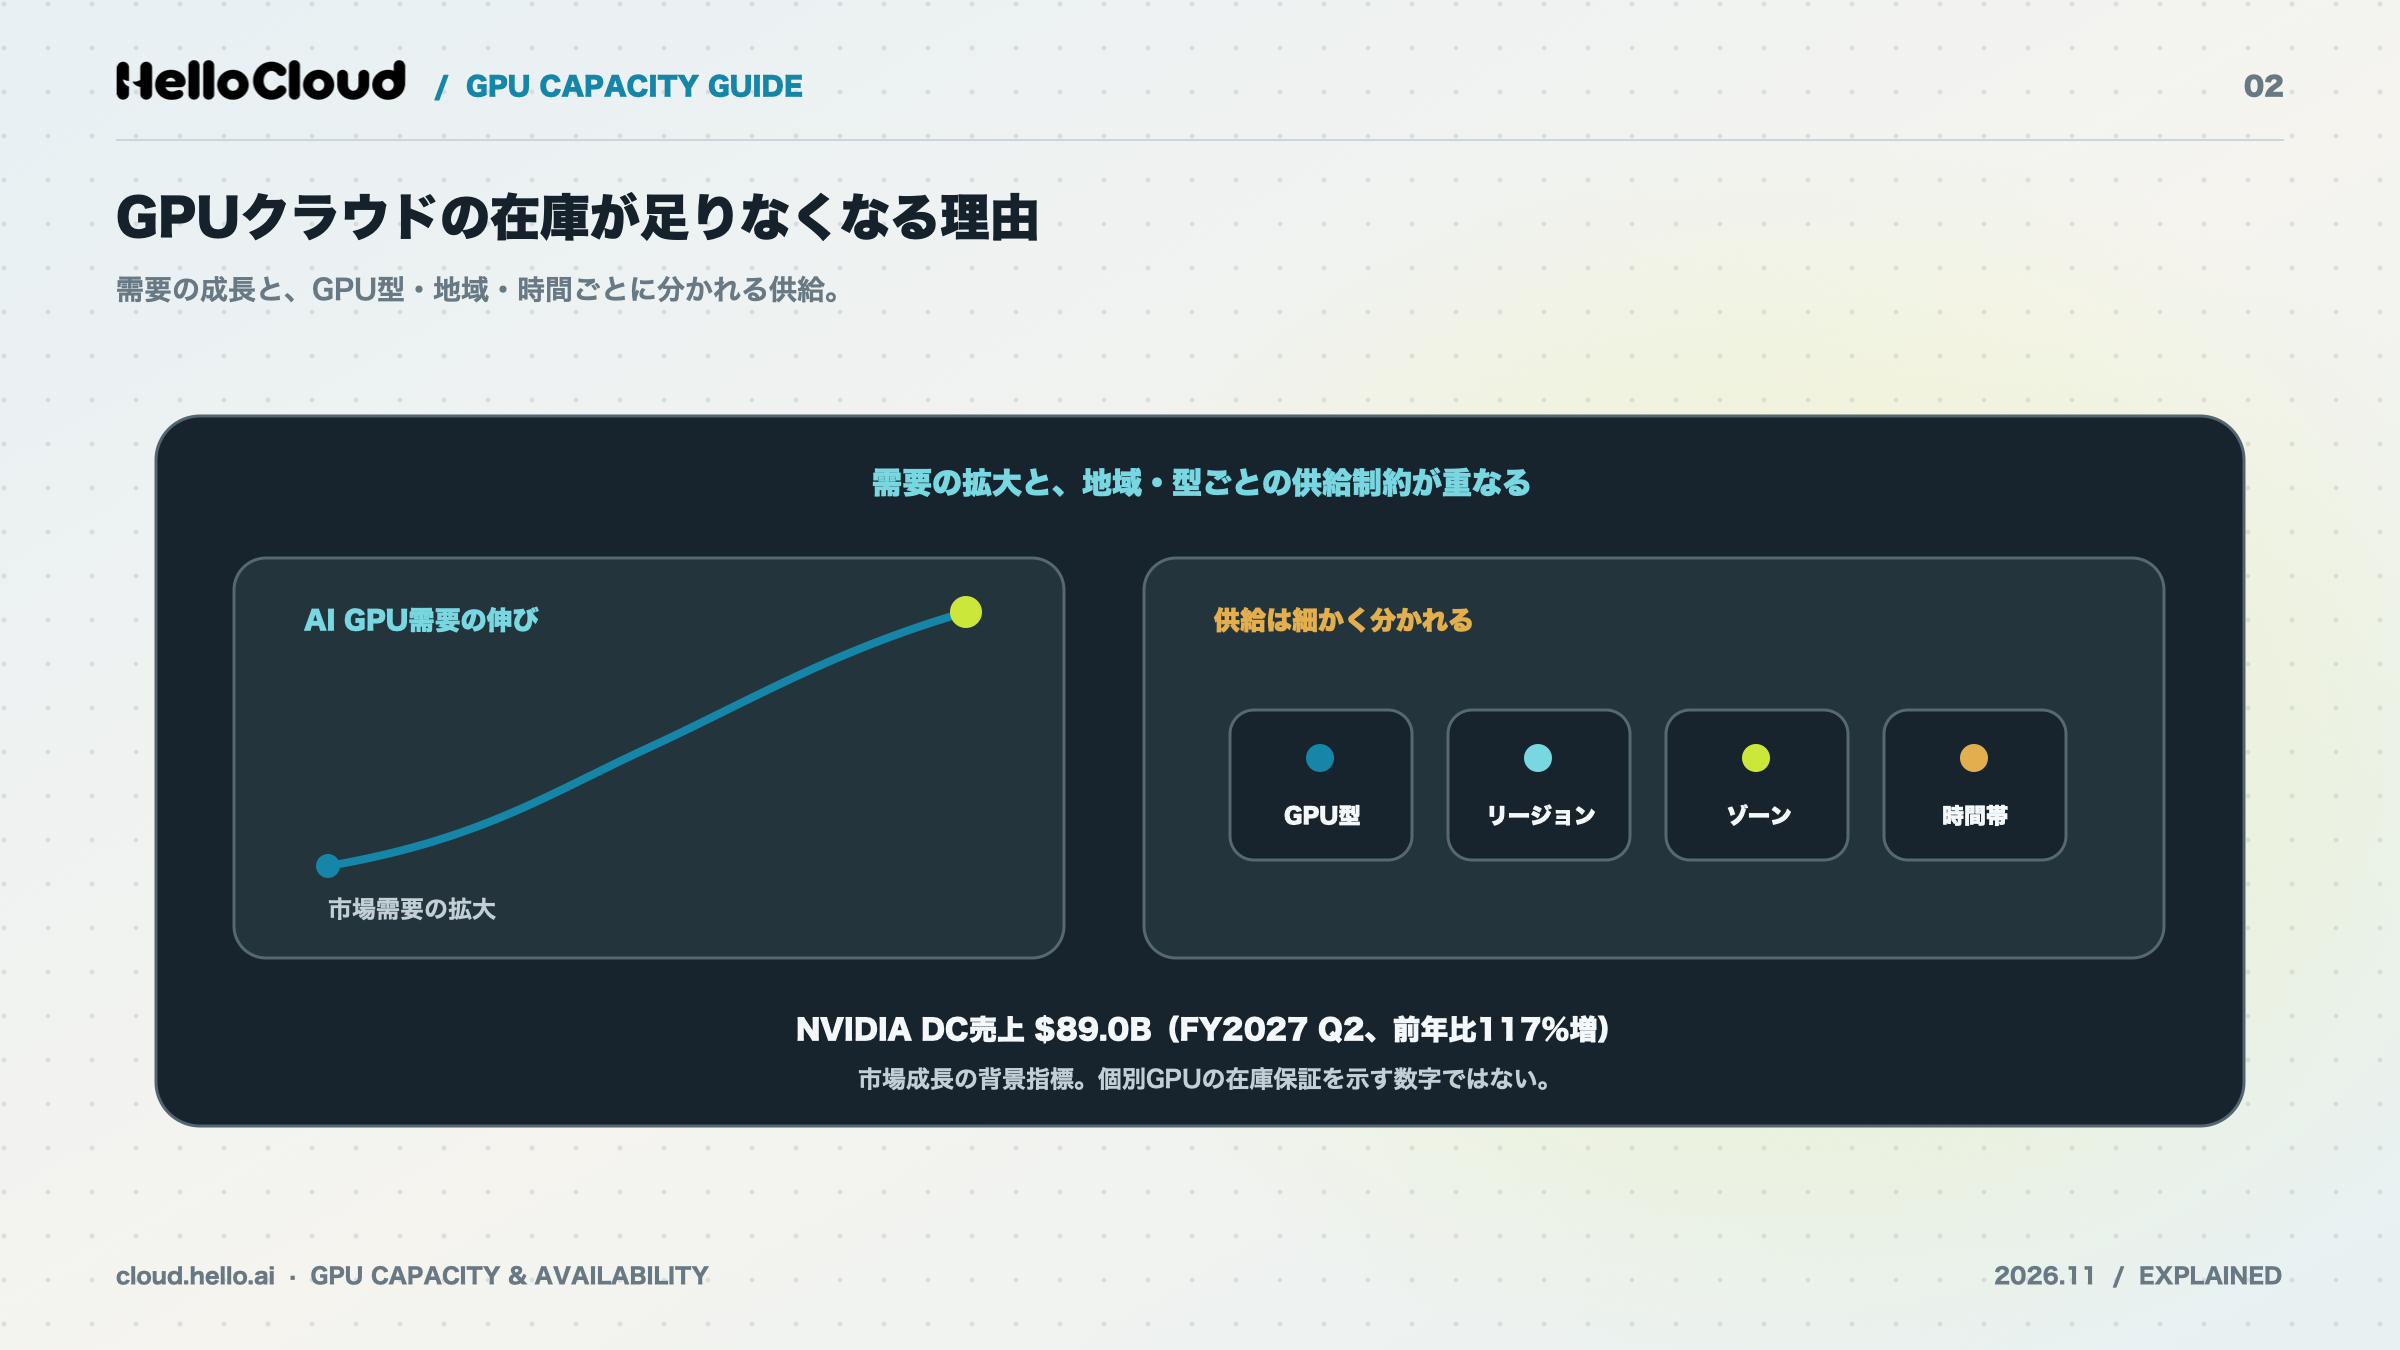
NVIDIAの2027会計年度第2四半期(2026年7月26日終了)のデータセンター部門の売上高は$89.0Bで、前年同期比117%増でした。NVIDIAの売上が大きく伸びる一方で、国内のデータセンターは数が限られ、立地も偏っています。
AI向けGPUの需要が大きく伸びている
NVIDIAの2027会計年度第2四半期の売上高は$96.2B(前年同期比106%増)で、うちデータセンター部門が$89.0Bを占めます。第3四半期の売上高の見通しは$108.0B±2%です(出典:NVIDIAの2027会計年度第2四半期決算、2026年8月)。
国内のデータセンターは少なく、関東・関西に集中
総務省の「令和7年版 情報通信白書」は、日本では計算資源の確保が重要な課題の1つだとしています(出典:情報通信白書の主な課題の概要、2025年)。2025年3月時点のデータセンター数は、米国の5,426に対して日本は222で、米国の4%程度でした(出典:情報通信白書のデータセンターの節、2025年)。
2023年時点では、国内のデータセンターの約90%(面積換算)が関東・関西に立地しています(出典:情報通信白書の主な課題の概要、2025年)。
ポイント:
NVIDIAのデータセンター部門の売上高は、前年同期比で2倍以上(117%増)です。国内のデータセンターは米国の4%程度で、関東・関西に集中しています。
GPUクラウドの在庫切れか上限到達かをエラーで見分ける
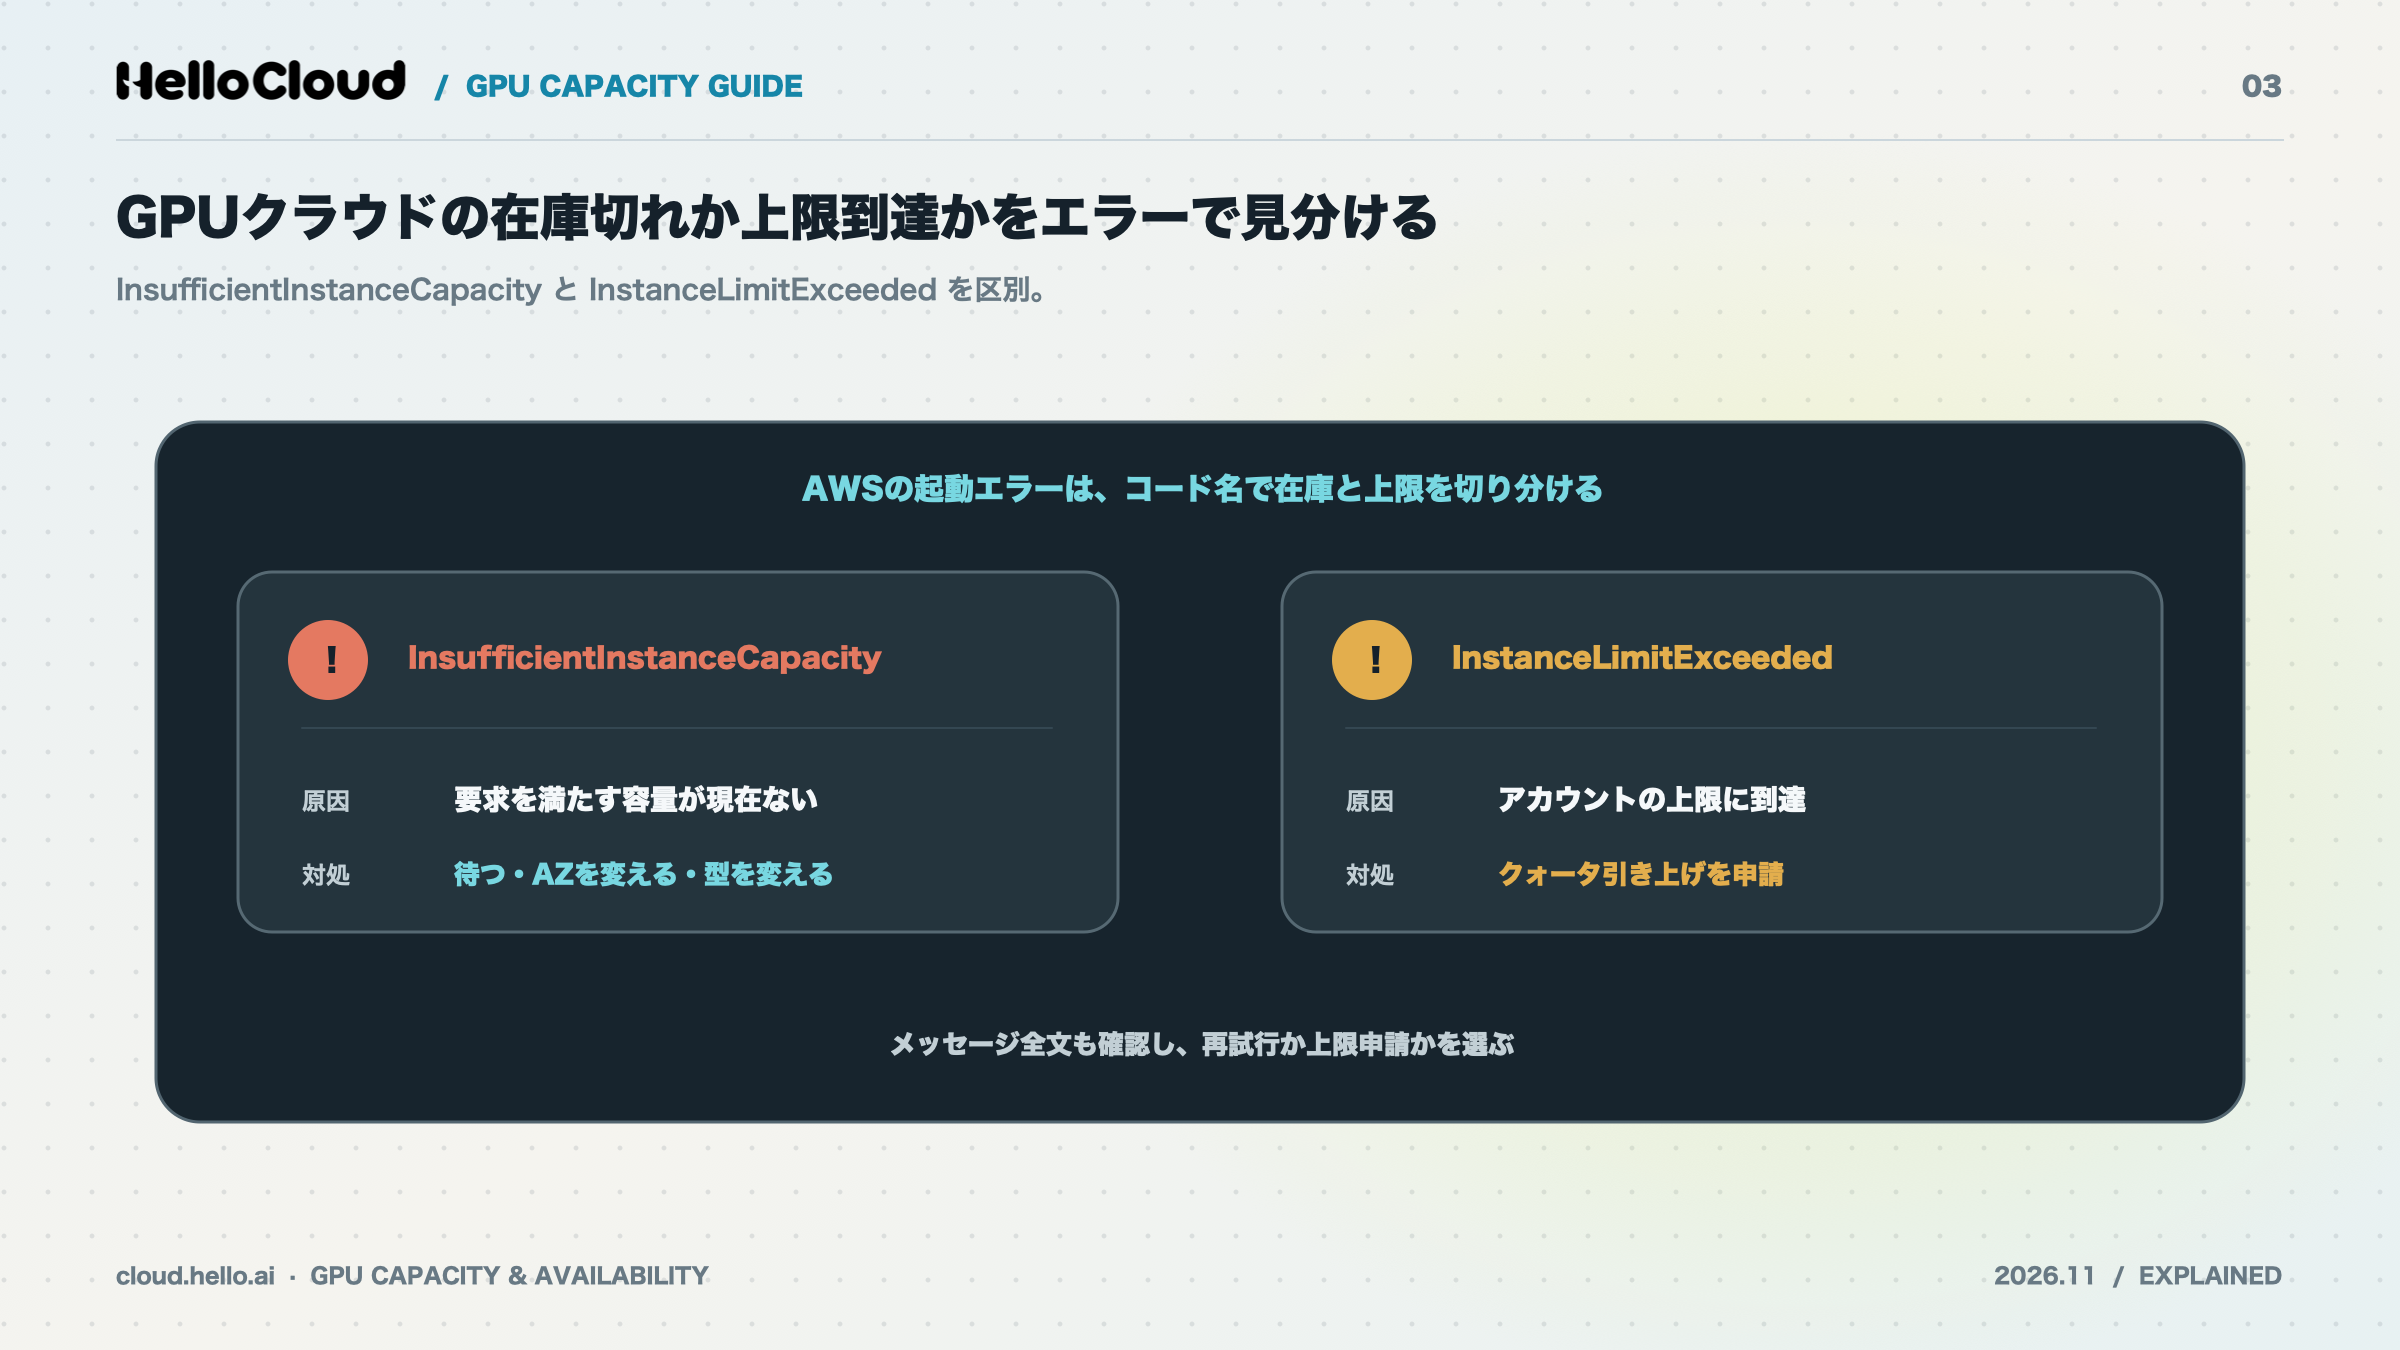
AWSでGPUインスタンス(クラウド上の仮想サーバー)が起動できないときは、エラー名で原因が分かります。InsufficientInstanceCapacityなら在庫切れ、InstanceLimitExceededなら上限到達です。
在庫切れのエラー:InsufficientInstanceCapacity
InsufficientInstanceCapacityは、AWSにリクエストを満たすオンデマンドの容量が現在ないことを示すエラーです。AWS re:Postが示すメッセージの例は次のとおりです(出典:在庫切れエラーの対処(AWS re:Post)、2026年11月9日確認)。
"We currently do not have sufficient capacity in the Availability Zone you requested."
事業者側の空き容量の問題のため、クォータを引き上げても解決しません。
上限到達のエラー:InstanceLimitExceeded
InstanceLimitExceededは、リージョンごとのインスタンス数の上限に達したことを示すエラーです。InstanceLimitExceededが出たときは、リージョン単位で上限の引き上げを申請します(出典:EC2の起動エラーの解説(AWS)、2026年11月9日確認)。
早見表:エラー名・原因・最初にやること
エラー名 | 原因 | 最初にやること |
|---|---|---|
InsufficientInstanceCapacity | オンデマンドの容量が現在ない(在庫切れ) | 数分待つ、台数を減らす、AZを指定しない、別の型で再試行 |
InstanceLimitExceeded | リージョンごとの上限に達した(上限到達) | リージョン単位で上限の引き上げを申請 |
出典:EC2の起動エラーの解説(AWS)、在庫切れエラーの対処(AWS re:Post)(2026年11月9日確認)
ポイント:
InsufficientInstanceCapacityは在庫切れ、InstanceLimitExceededは上限到達です。エラー名で、待つか申請するかを決めましょう。
GPUクラウドの在庫とクォータを確認・申請する手順
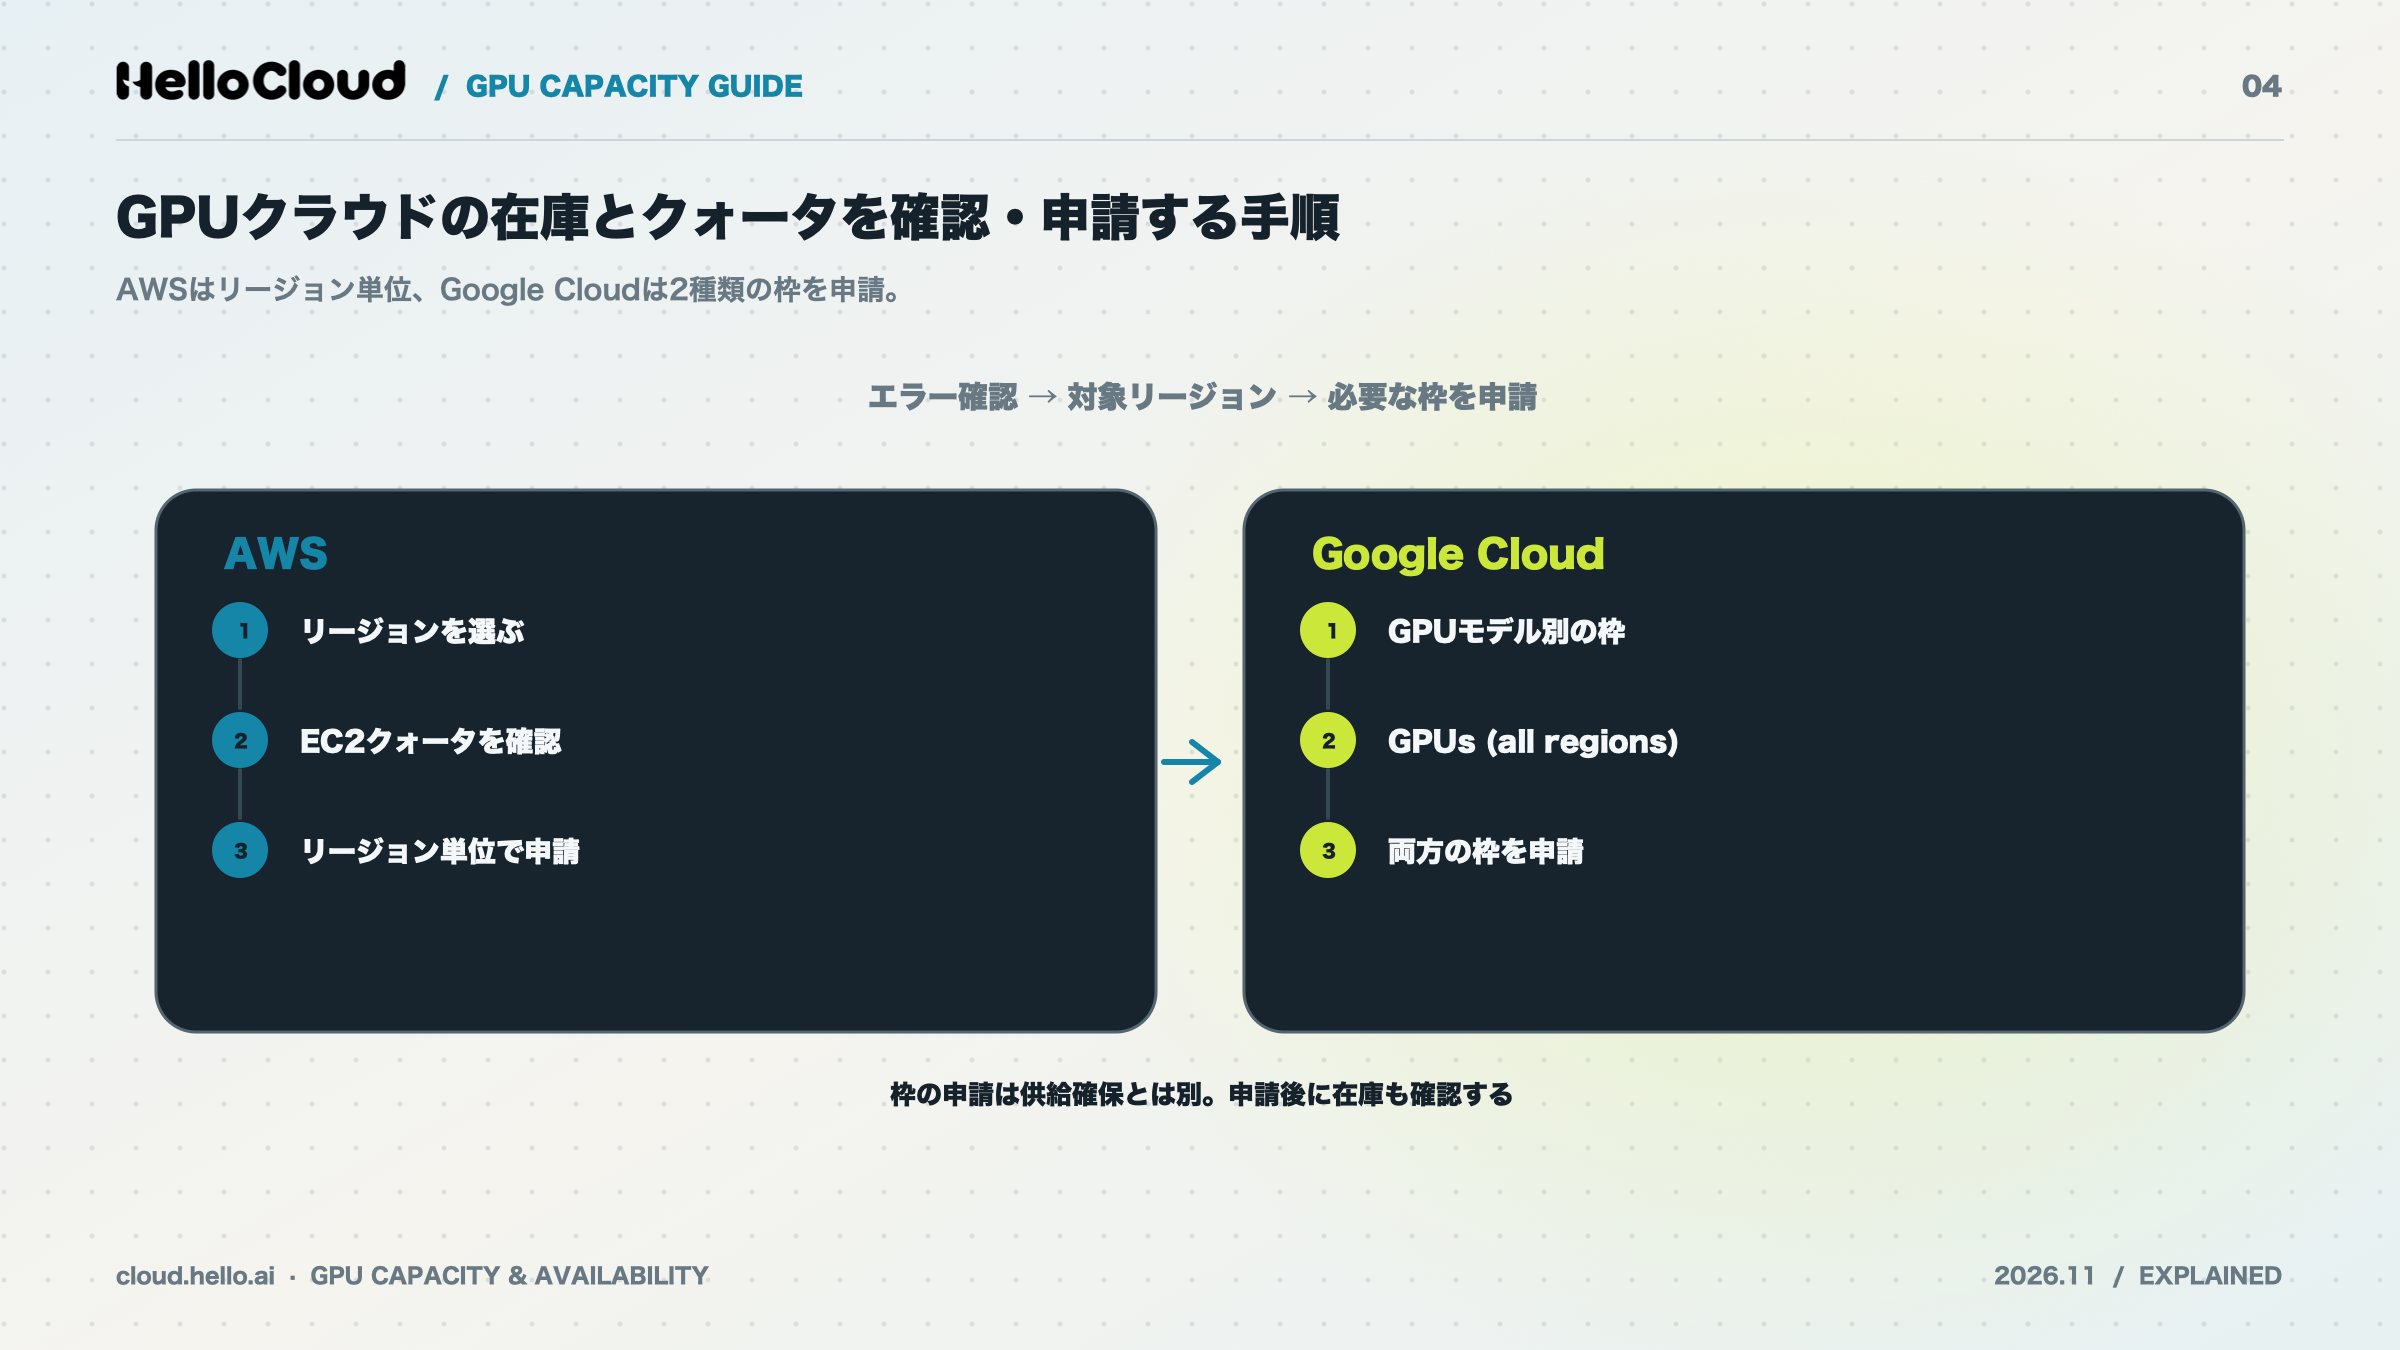
AWSはリージョン単位で上限の引き上げを申請し、Google CloudはGPUのモデル別クォータと「GPUs (all regions)」の両方を申請します。内容は2026年11月9日時点の公式ドキュメントの記載で、仕様は変わることがあります。
AWS:リージョンの上限を確認し、引き上げを申請する
エラー名を確かめる:InstanceLimitExceededなら上限到達。
リージョンを決める:上限はリージョン単位で設定。
引き上げを申請する:Amazon EC2のサービスクォータとして、リージョン単位で申請。
出典:EC2の起動エラーの解説(AWS)(2026年11月9日確認)
Google Cloud:モデル別と全リージョンの枠を申請する
新しいアカウントとプロジェクトには、全リージョン共通のGPUのグローバルクォータがあります。
モデル別クォータを申請する:使うリージョンで、使うGPUモデルの枠を申請。
GPUs (all regions)を申請する:全種類のGPUの合計数の枠も別に申請。
Cloud Quotas APIで申請する場合、公式ドキュメントの例ではサービスに「compute.googleapis.com」を指定します。クォータIDの例は「GPUS-PER-GPU-FAMILY-per-project-region」です。
出典:Compute Engineのクォータの解説(Google Cloud)(2026年11月6日更新)、Cloud Quotas APIの概要(Google Cloud)(2026年10月26日更新、2026年11月9日確認)
申請前に確認:Spot用・コミット用の枠は別
Google Cloudでは、標準のインスタンス、Spot VM、コミット利用(リソースベースのコミットメント)で別々のクォータが適用されます。リソースベースのコミットメントを購入する前には、対象リージョンのクォータが必要です(出典:Compute Engineのクォータの解説(Google Cloud)、2026年11月6日更新)。
注意:
Spot VMなどのプリエンプティブル(途中で停止されることがある)用クォータを申請すると、対象のリソースは標準のクォータに戻りません。
ポイント:
AWSはリージョン単位の上限、Google Cloudはモデル別とGPUs (all regions)の2つを申請します。Spot用・コミット用の枠は別です。
GPUクラウドの在庫切れで確保できないときの対処法
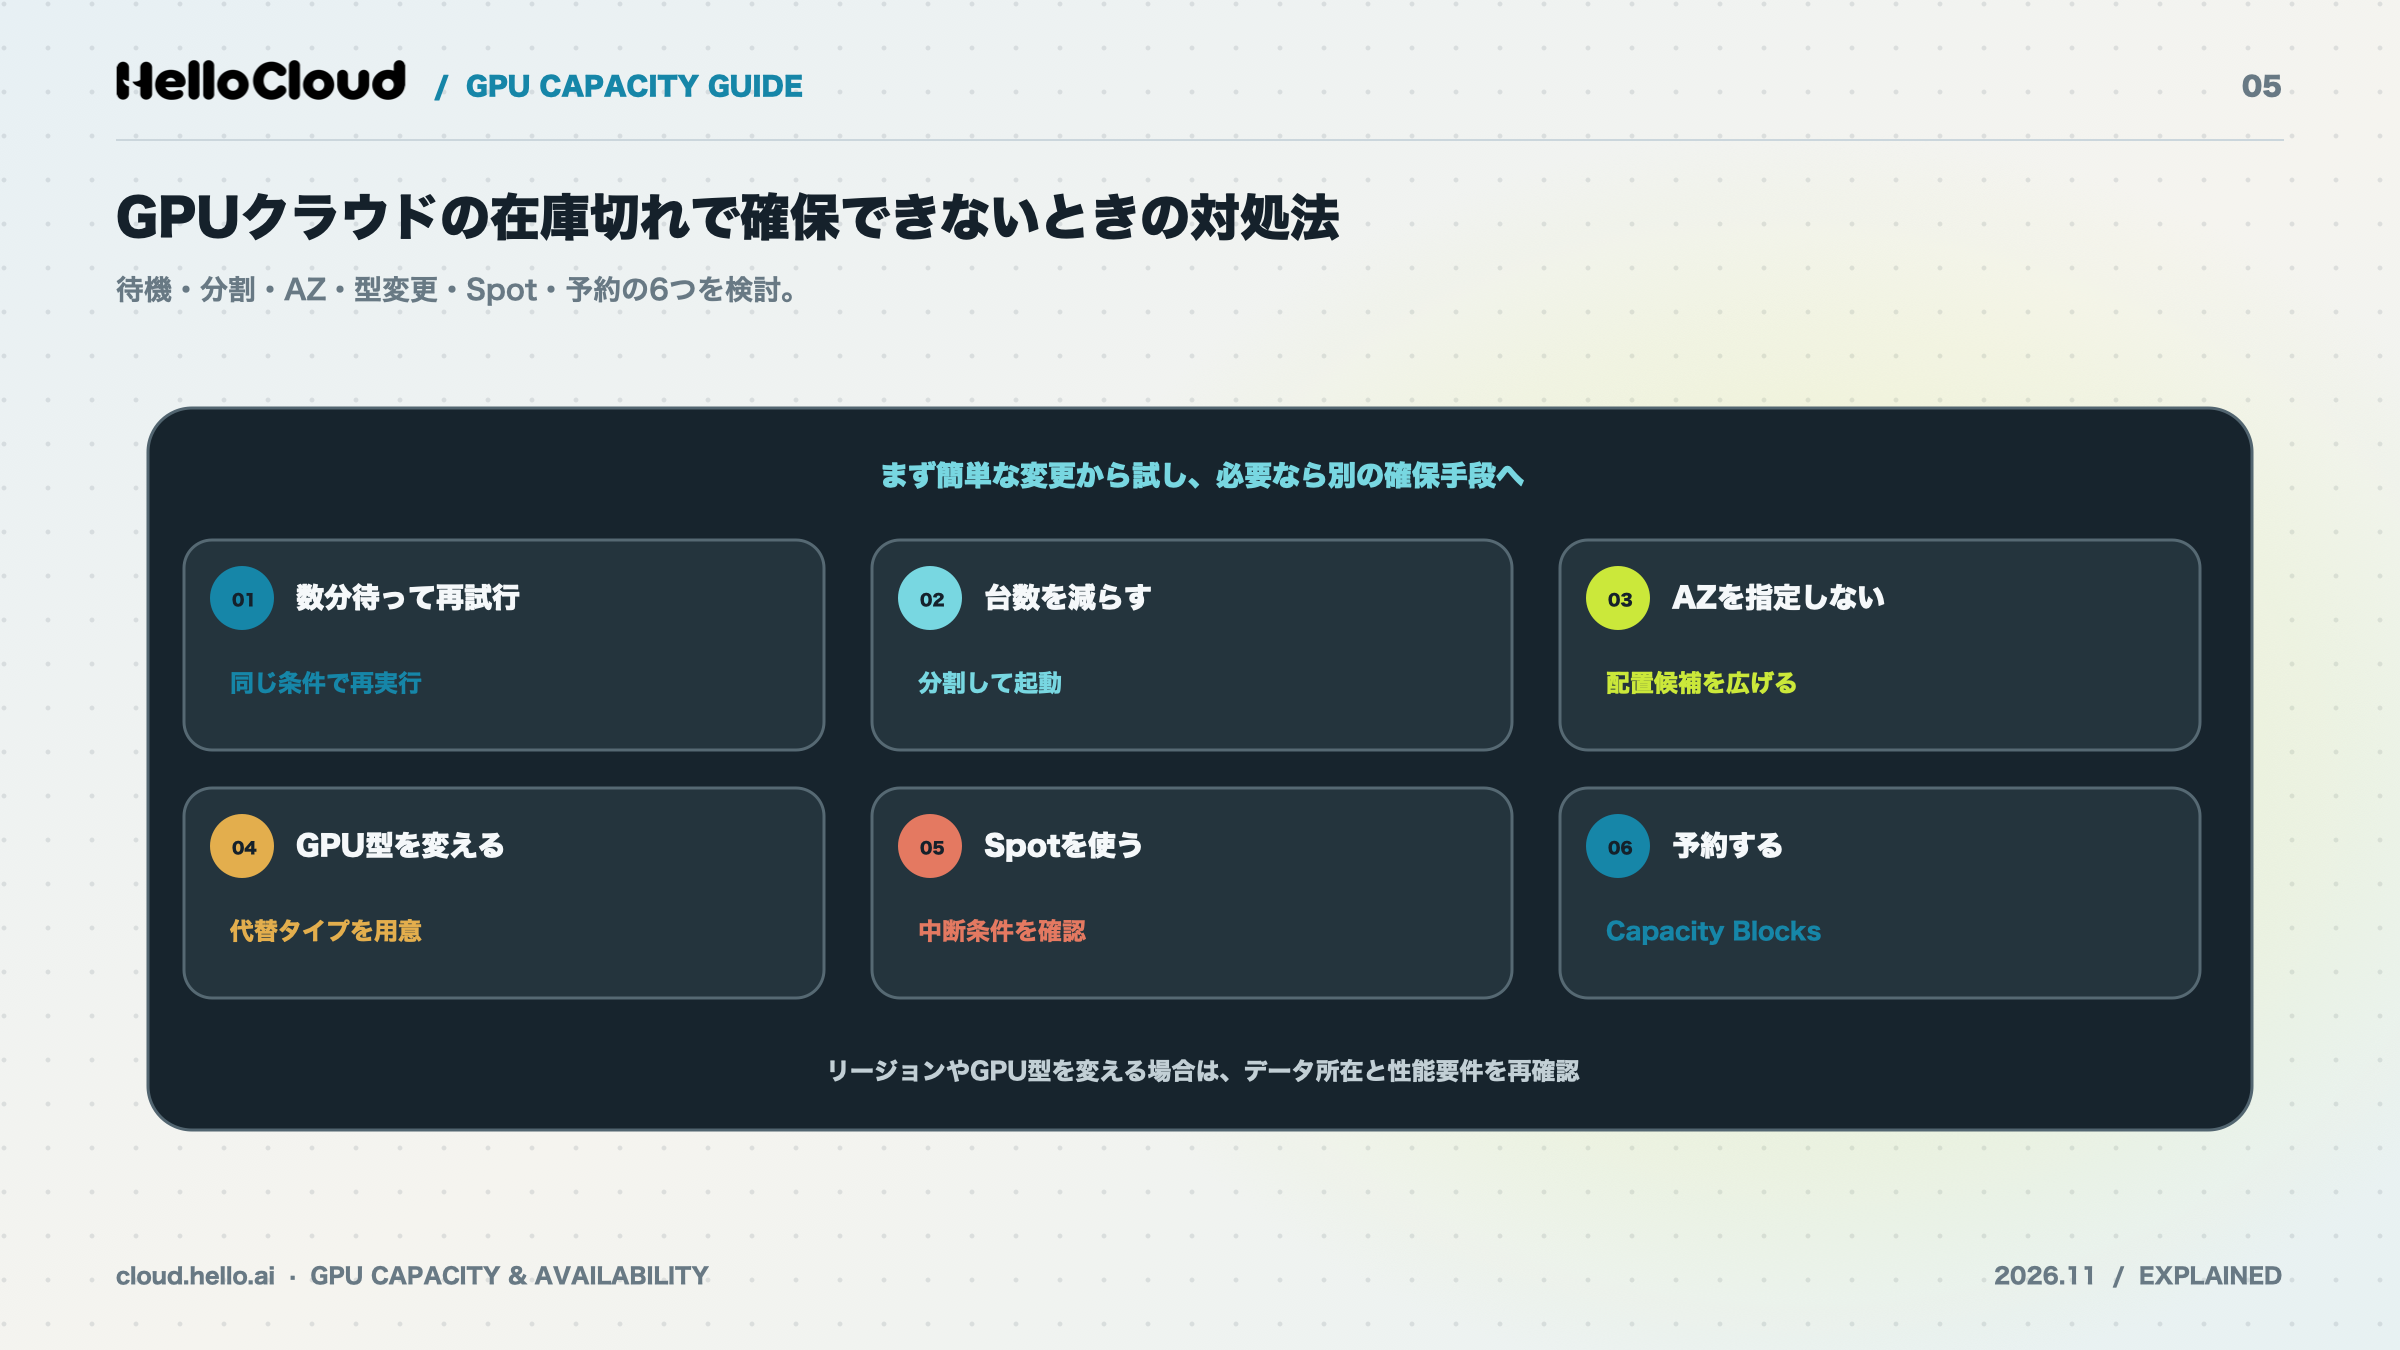
AWSの公式ドキュメントは、在庫切れの対処として、数分待って再試行する、台数を減らす、AZを指定しない、別のインスタンスタイプにする、の4つを挙げています。スポットと予約を加えると、選べる対処法は6つです。
数分待つ・台数を分けて再試行する
AWSの容量は頻繁に変動するため、数分待って同じリクエストを送り直すと起動できる場合があります。
台数を分けるのも有効です。AWSは15台を一度に起動する代わりに、5台ずつ3回に分ける例を示しています(出典:EC2の起動エラーの解説(AWS)、2026年11月9日確認)。
ゾーンを指定せずに申し込む
AWSでインスタンスを新しく起動するときは、AZを指定せずにリクエストし直す方法もあります。AWS re:Postによると、AZを指定しない方法はデフォルトVPCの場合で、それ以外のVPCでは別のAZのサブネットを選ぶ形です(出典:在庫切れエラーの対処(AWS re:Post)、2026年11月9日確認)。Google Cloudも、ゾーンの在庫が尽きた場合は別のゾーンで作成し直すよう案内しています(出典:Compute Engineのクォータの解説(Google Cloud)、2026年11月6日更新)。
GPUの型を変える・スポットを使うときの注意
GPUの型を変えると、性能やVRAM(GPUのメモリ)が変わるため、バッチサイズなど学習の設定を見直してください。スポットは、空き容量を安く借りる代わりに中断されることがある利用方法を指します(出典:Spot VMの解説(Google Cloud)、2026年11月9日確認)。
注意:
スポットは事業者の都合で中断されることがあります。長時間の学習では、チェックポイント(途中経過の保存)をこまめに取ってください。
対処法ごとのメリット・デメリット比較
対処法 | メリット | デメリット |
|---|---|---|
数分待って再試行 | 設定を変えずに済む | 起動できる保証はない |
台数を分ける | 少ない台数なら通りやすい | 全台そろうまで時間がかかる場合がある |
AZを指定しない | 容量のあるAZで起動できる | データと別のAZになる場合がある |
GPUの型を変える | 空いている型を使える | 性能・VRAMが変わり、設定の見直しが必要 |
スポットを使う | 空き容量を安く使える | 中断されることがある |
予約する | 使う日のGPUを確保できる | キャンセル不可、対象が限られる |
出典:EC2の起動エラーの解説(AWS)、Capacity Blocks for MLの解説(AWS)、Spot VMの解説(Google Cloud)(2026年11月9日確認)
ポイント:
すぐ試せるのは、再試行、台数の分割、AZの指定なし、型の変更、スポットの5つです。使う日が決まっているなら予約も候補になります。
GPUクラウドの在庫を予約で確保する方法
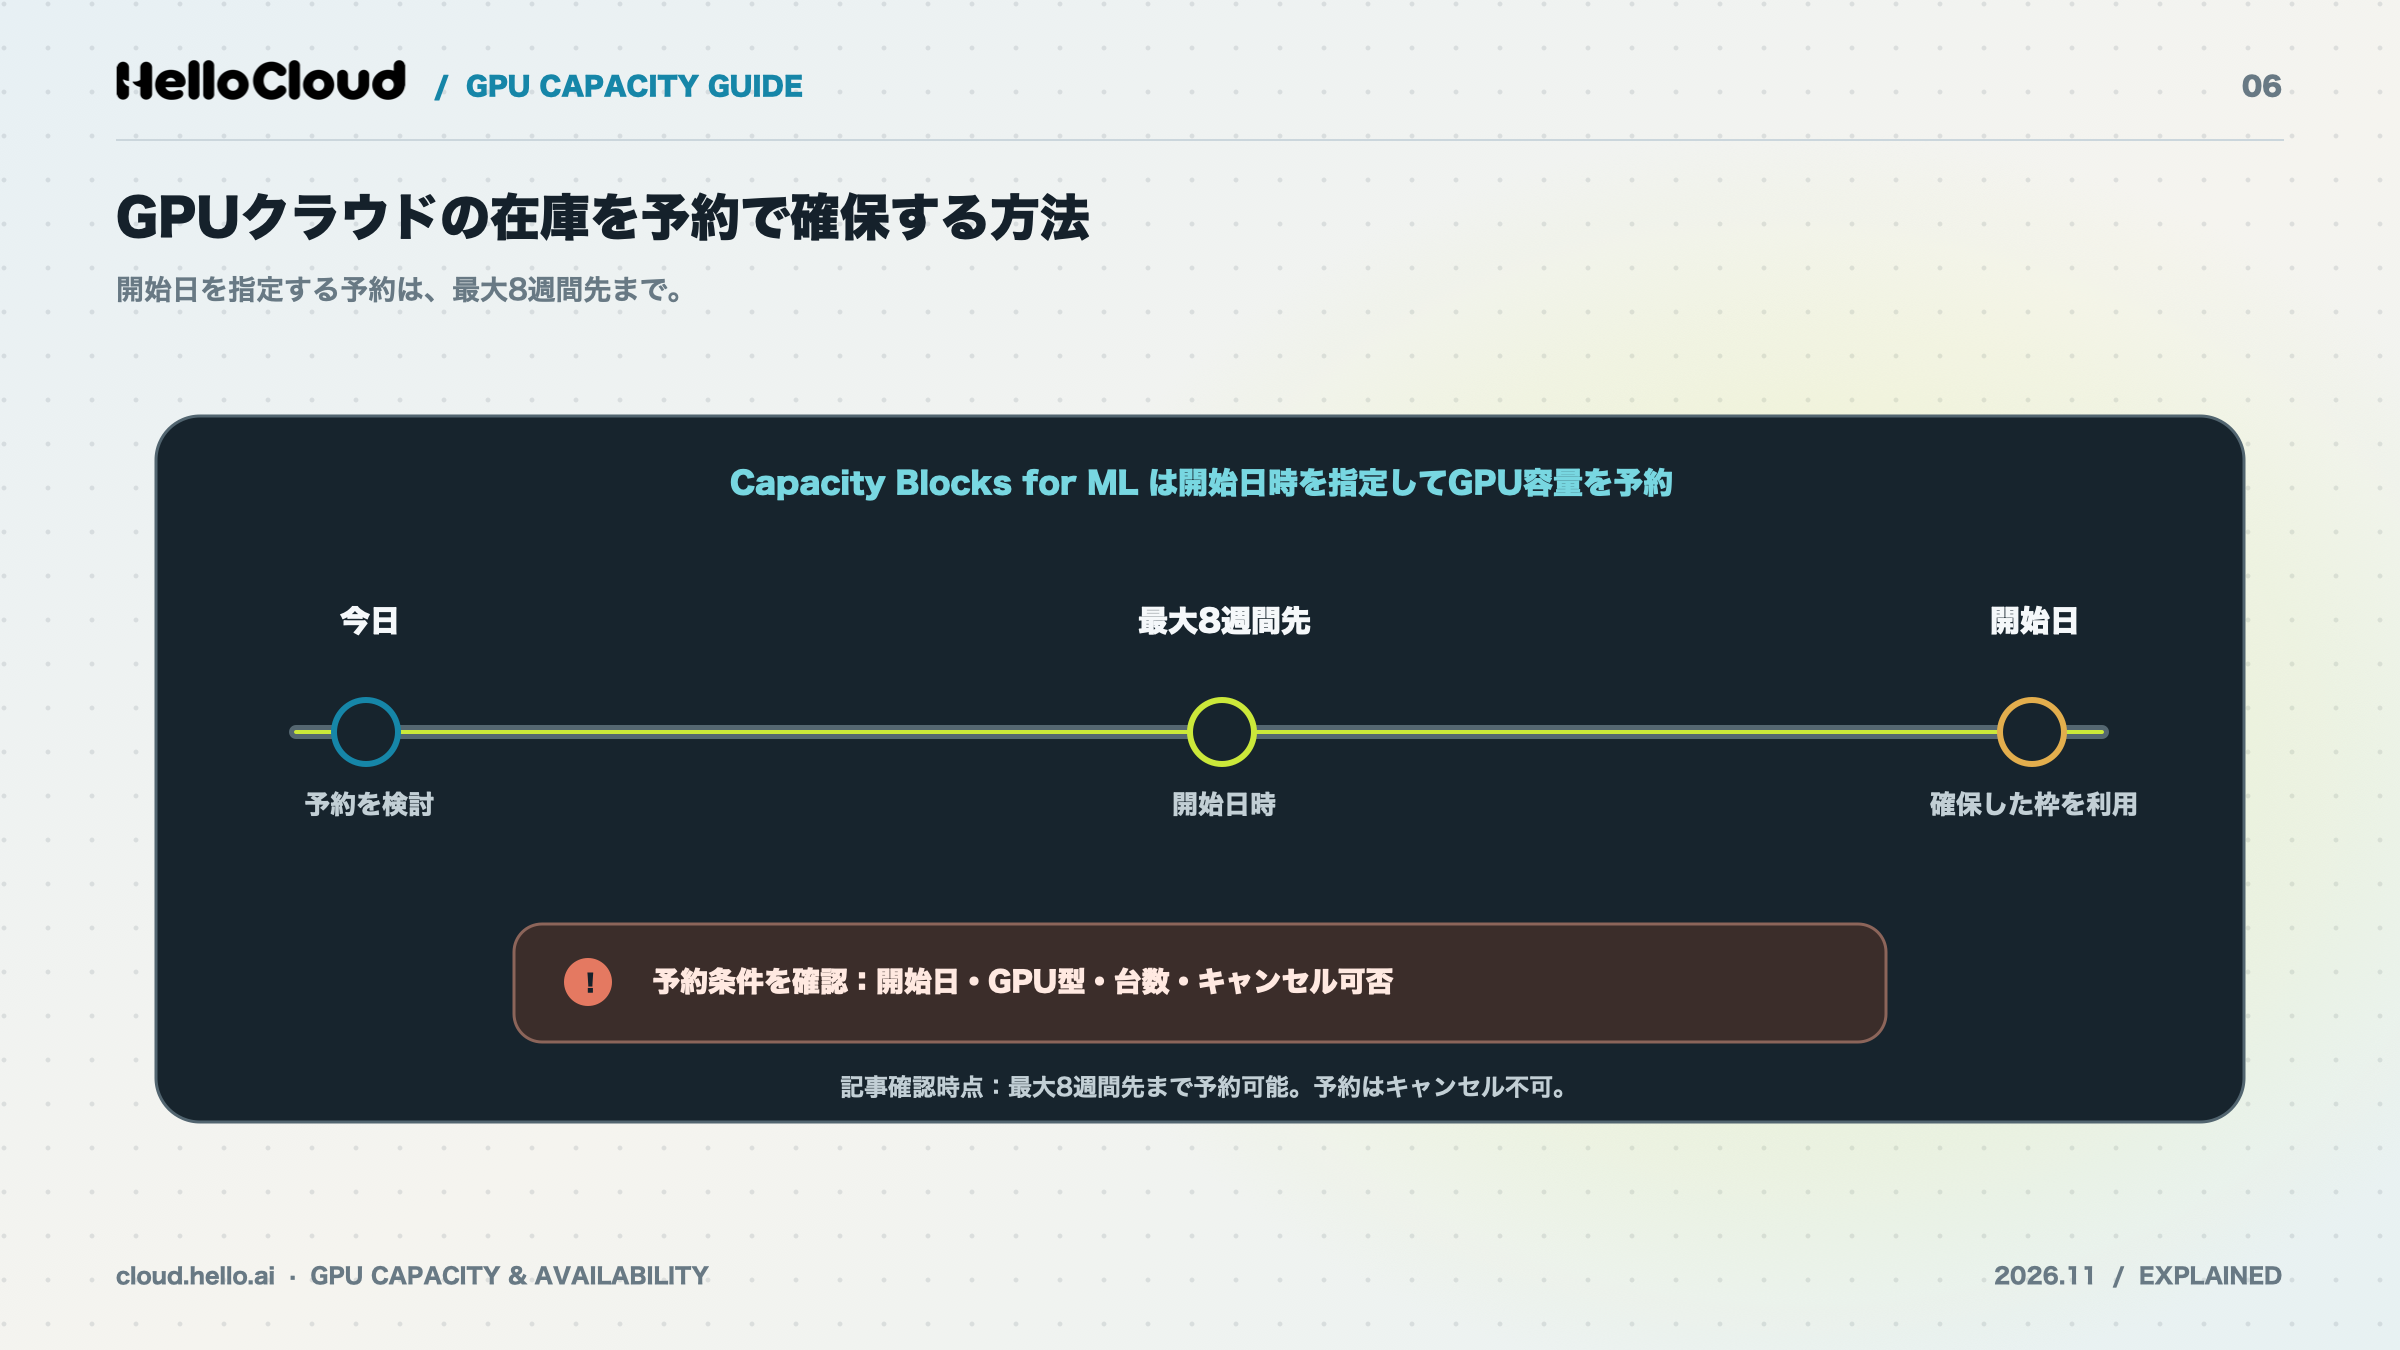
AWSのCapacity Blocks for ML(GPUの日時指定の予約)を使うと、最大8週間先の開始日で予約できます。
AWS Capacity Blocks for MLで予約できる条件
項目 | 内容 |
|---|---|
開始日の指定 | 最大8週間先まで |
1ブロックの台数 | 最大64インスタンス(64は一部で非対応) |
合計の上限 | 最大256インスタンス(同じ日付・組織全体の合計) |
東京リージョンの対象 | p5.4xlarge、p5.48xlarge、p5e.48xlarge、p5en.48xlarge |
出典:Capacity Blocks for MLの解説(AWS)(2026年11月9日確認)
予約の注意点:キャンセル不可・対象が限られる
Capacity Blocks for MLの対象は、一部のインスタンスタイプとリージョンのみです。8週間より先の日程は、2026年11月9日時点の仕様では予約の対象外です(出典:Capacity Blocks for MLの解説(AWS)、2026年11月9日確認)。Capacity Blocksの単価と、ほかの購入方式の料金は、AWSのGPUインスタンス料金の解説で扱っています。
注意:
Capacity Blocks for MLは購入後にキャンセルできません。学習の日程とインスタンスタイプが確定してから購入してください。
ポイント:
使う日が決まっているなら、最大8週間先まで予約できます。キャンセルできないため、日程を固めてから購入しましょう。
学習の締め切りから逆算するGPUクラウドの在庫確保
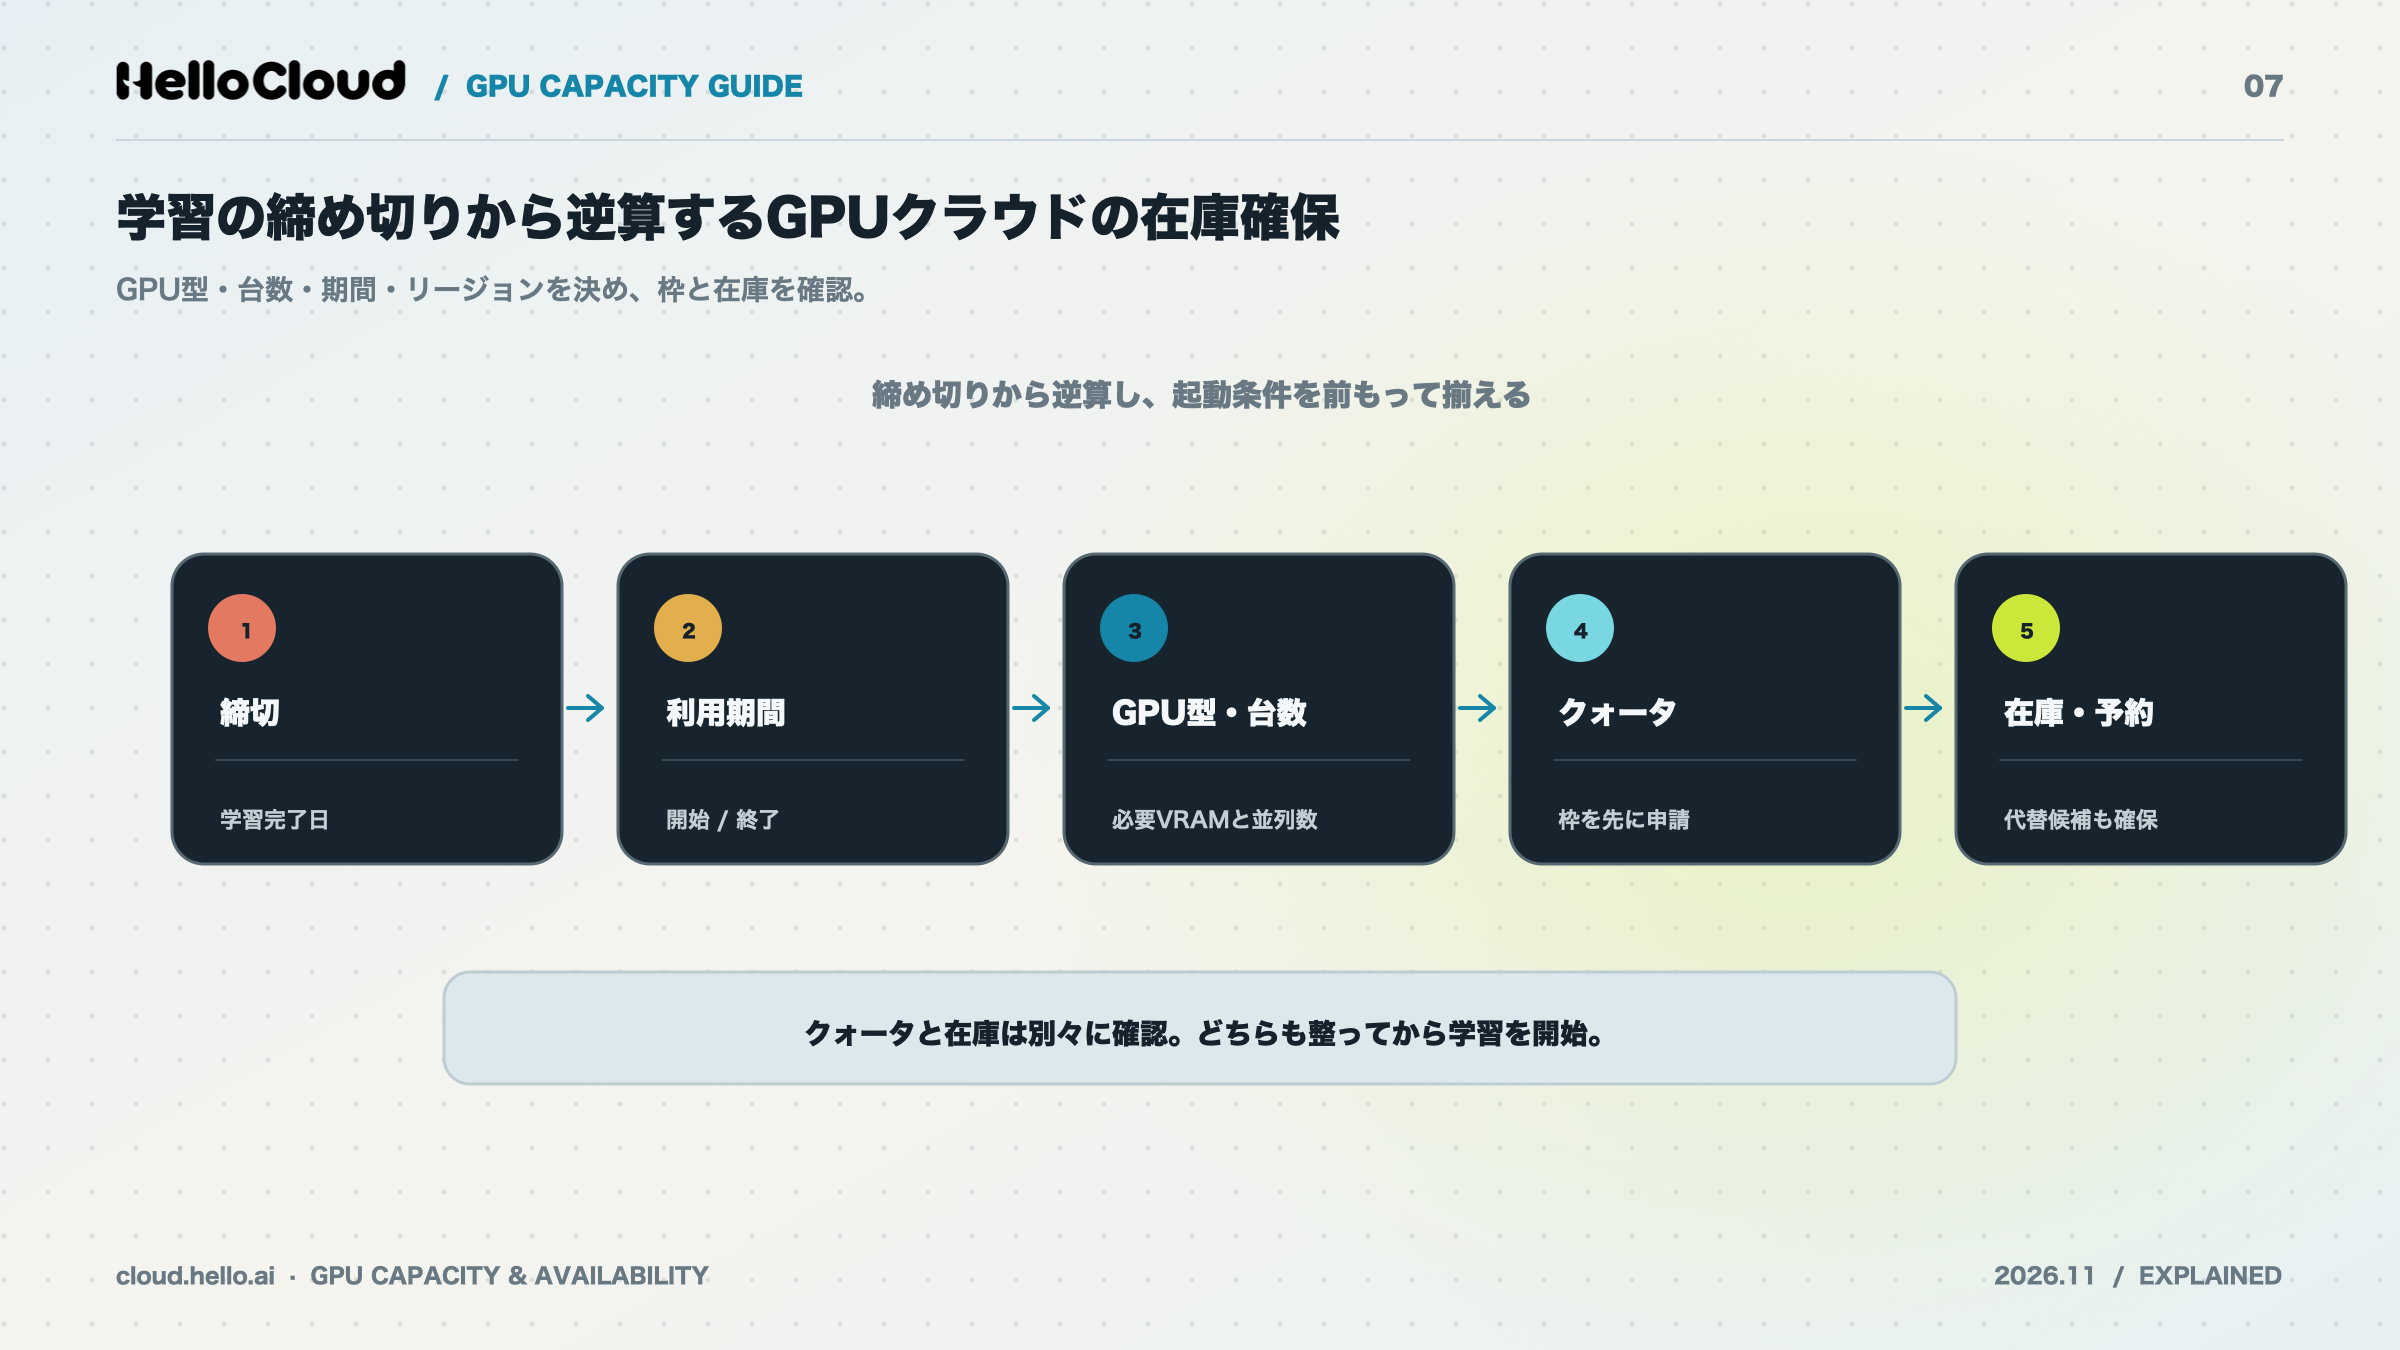
学習の締め切りに間に合わせるには、GPUの型と台数を決め、クォータを先に申請し、在庫を確かめてから予約か代替先を決めます。クォータと在庫は別物で、両方がそろって初めてGPUが起動します。
必要なGPUの型と台数を決める
GPUの型を決める:モデルの大きさから必要なVRAMを見積もり、候補の型を2つ以上挙げる。
台数を決める:並列で使う台数と、最低限必要な台数を分けておく。
期間を決める:開始日と終了日を決める。AWSの予約は開始日が最大8週間先まで。
リージョンを決める:データの保存先に制約がある場合は、使えるリージョンを先に確認。
クォータを確認し、足りなければ先に申請する
クォータが足りないと、在庫があってもGPUは起動できません。AWSはリージョン単位の上限、Google Cloudはモデル別クォータとGPUs (all regions)を最初に確認してください。
在庫を確認し、予約か代替先を決める
クォータがそろったら、起動を試して在庫を確かめます。InsufficientInstanceCapacityが続く場合は、再試行、台数の分割、AZの指定なし、型の変更を順に試してください。
それでも起動できず、使う日が決まっているなら予約に切り替えます。予約の条件に合わないときは、別の調達先も並行して探しましょう。
ポイント:
型・台数・期間・リージョンを決め、クォータの申請を最初に進めます。在庫は起動を試して確かめ、足りなければ予約か別の調達先を選びます。
GPUクラウドの在庫を国内で探すという選択肢
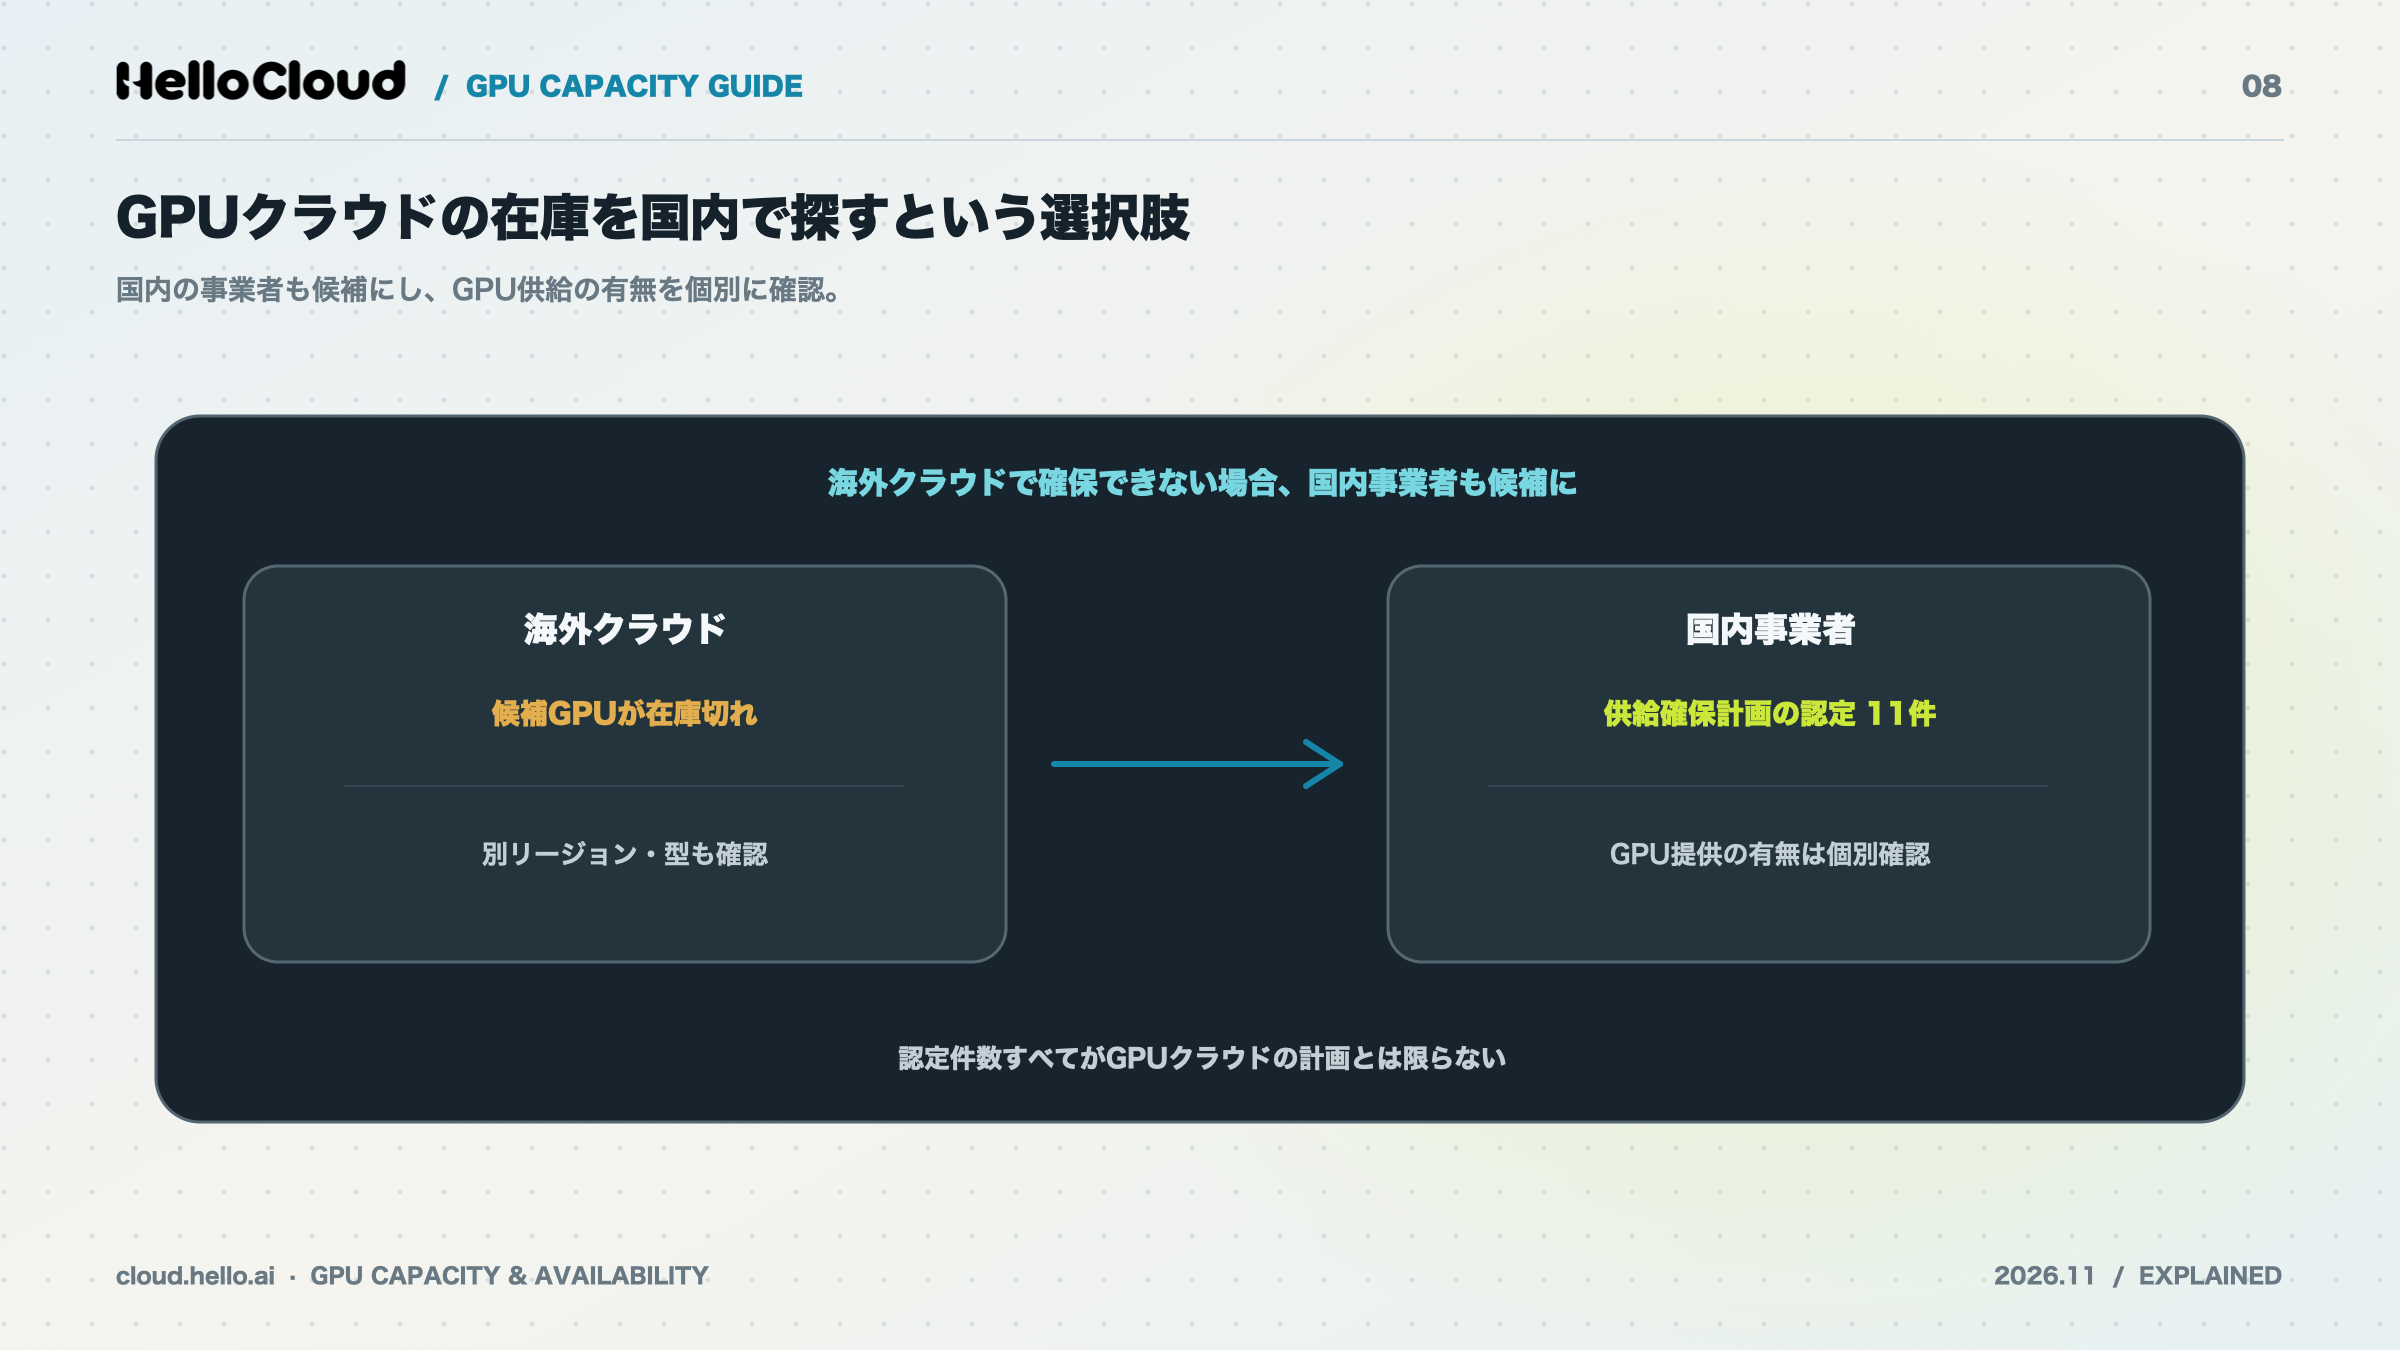
経済産業省は、経済安全保障推進法に基づく「クラウドプログラム」の供給確保計画を11件認定済みです。海外の大手クラウドで確保できないときは、国内の事業者も候補です。国内サービスの料金・サポート・契約条件は、国内GPUクラウドの料金比較で同じ軸に並べています。
国が供給確保を支援するGPUクラウド事業者
一覧に載っているのは区分・認定日・事業者名で、計画の内容は各社の発表で確認できます。
認定事業者 | 認定日 |
|---|---|
東京大学 | 2023年4月14日 |
さくらインターネット | 2023年6月16日、2024年2月20日、2024年4月15日 |
ソフトバンク | 2023年7月7日、2024年5月10日 |
ゼウレカ | 2023年11月2日 |
GMOインターネットグループ | 2024年4月15日 |
RUTILEA、AI福島 | 2024年4月19日 |
KDDI | 2024年4月19日 |
ハイレゾ、ハイレゾ香川 | 2024年4月19日 |
出典:経済安全保障推進法に基づく認定供給確保計画の一覧(経済産業省)(2026年11月9日確認)
国内事業者の間でGPUを融通する動き
KDDI、さくらインターネット、ハイレゾの3社は、2025年10月21日に「日本GPUアライアンス」を設立しました。3社は、各社のGPUクラウドを相互に再販するなどの協業を行うとしています(出典:日本GPUアライアンス設立の記事(IT Leaders)、2025年10月)。国内のGPUクラウド事業者の動向は、GPUクラウドとネオクラウドの基本を解説した記事でも整理しています。
HelloCloudで使えるGPUと利用開始までの流れ
株式会社HelloCloudのHelloCloudは、日本国内のデータセンターでAIモデルの実行・学習ができる国産のGPUクラウドです。GPUインスタンスは東京の2拠点(JPTY01/JPTY02)で稼働し、申し込みの当日から使えます。
GPUインスタンス | VRAM | RAM | vCPU | 参考価格 | 想定用途 |
|---|---|---|---|---|---|
RTX 6000 | 96GB | 96GB | 16 | ¥380/時間 | 軽量〜中規模LLMの推論、画像・音声のバッチ処理、開発・プロトタイピング |
B300 | 288GB | 384GB | 24 | ¥1,480/時間 | 大規模モデルの学習、高負荷な推論ワークロード、生成AIの本番運用 |
出典:HelloCloud公式サイト(2026年11月9日確認。1インスタンスあたりの参考価格)
公式サイトの導入事例によると、株式会社ラス恋(CEO 山口様)は、会員の個人情報を扱うため推論も国外のサーバーに出せない前提でした。処理を国内に閉じられる点が決め手になり、申し込んだ日のうちに検証を始め、レコメンドのモデルも調達を待たずに本番へ載せています。
同じく公式サイトの導入事例では、Aimy株式会社(CEO 平野様)が、AIキャラクターとの対話サービスで推論を常時動かしながら、同じ環境でモデルの学習も進めています。
料金は従量課金で、初期費用は不要です。公開されているGPUインスタンスは2種類で、サーバーレスGPU実行環境ではコードでGPUの種類と枚数を指定して実行できます。
国内でGPUを使える環境を検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。モデル学習での活用方法も紹介しています。
資料請求(HelloCloudの特徴と料金)
ポイント:
国内では、クラウドプログラムの認定事業者や日本GPUアライアンスの参加社も候補です。
GPUクラウドの在庫に関するよくある質問
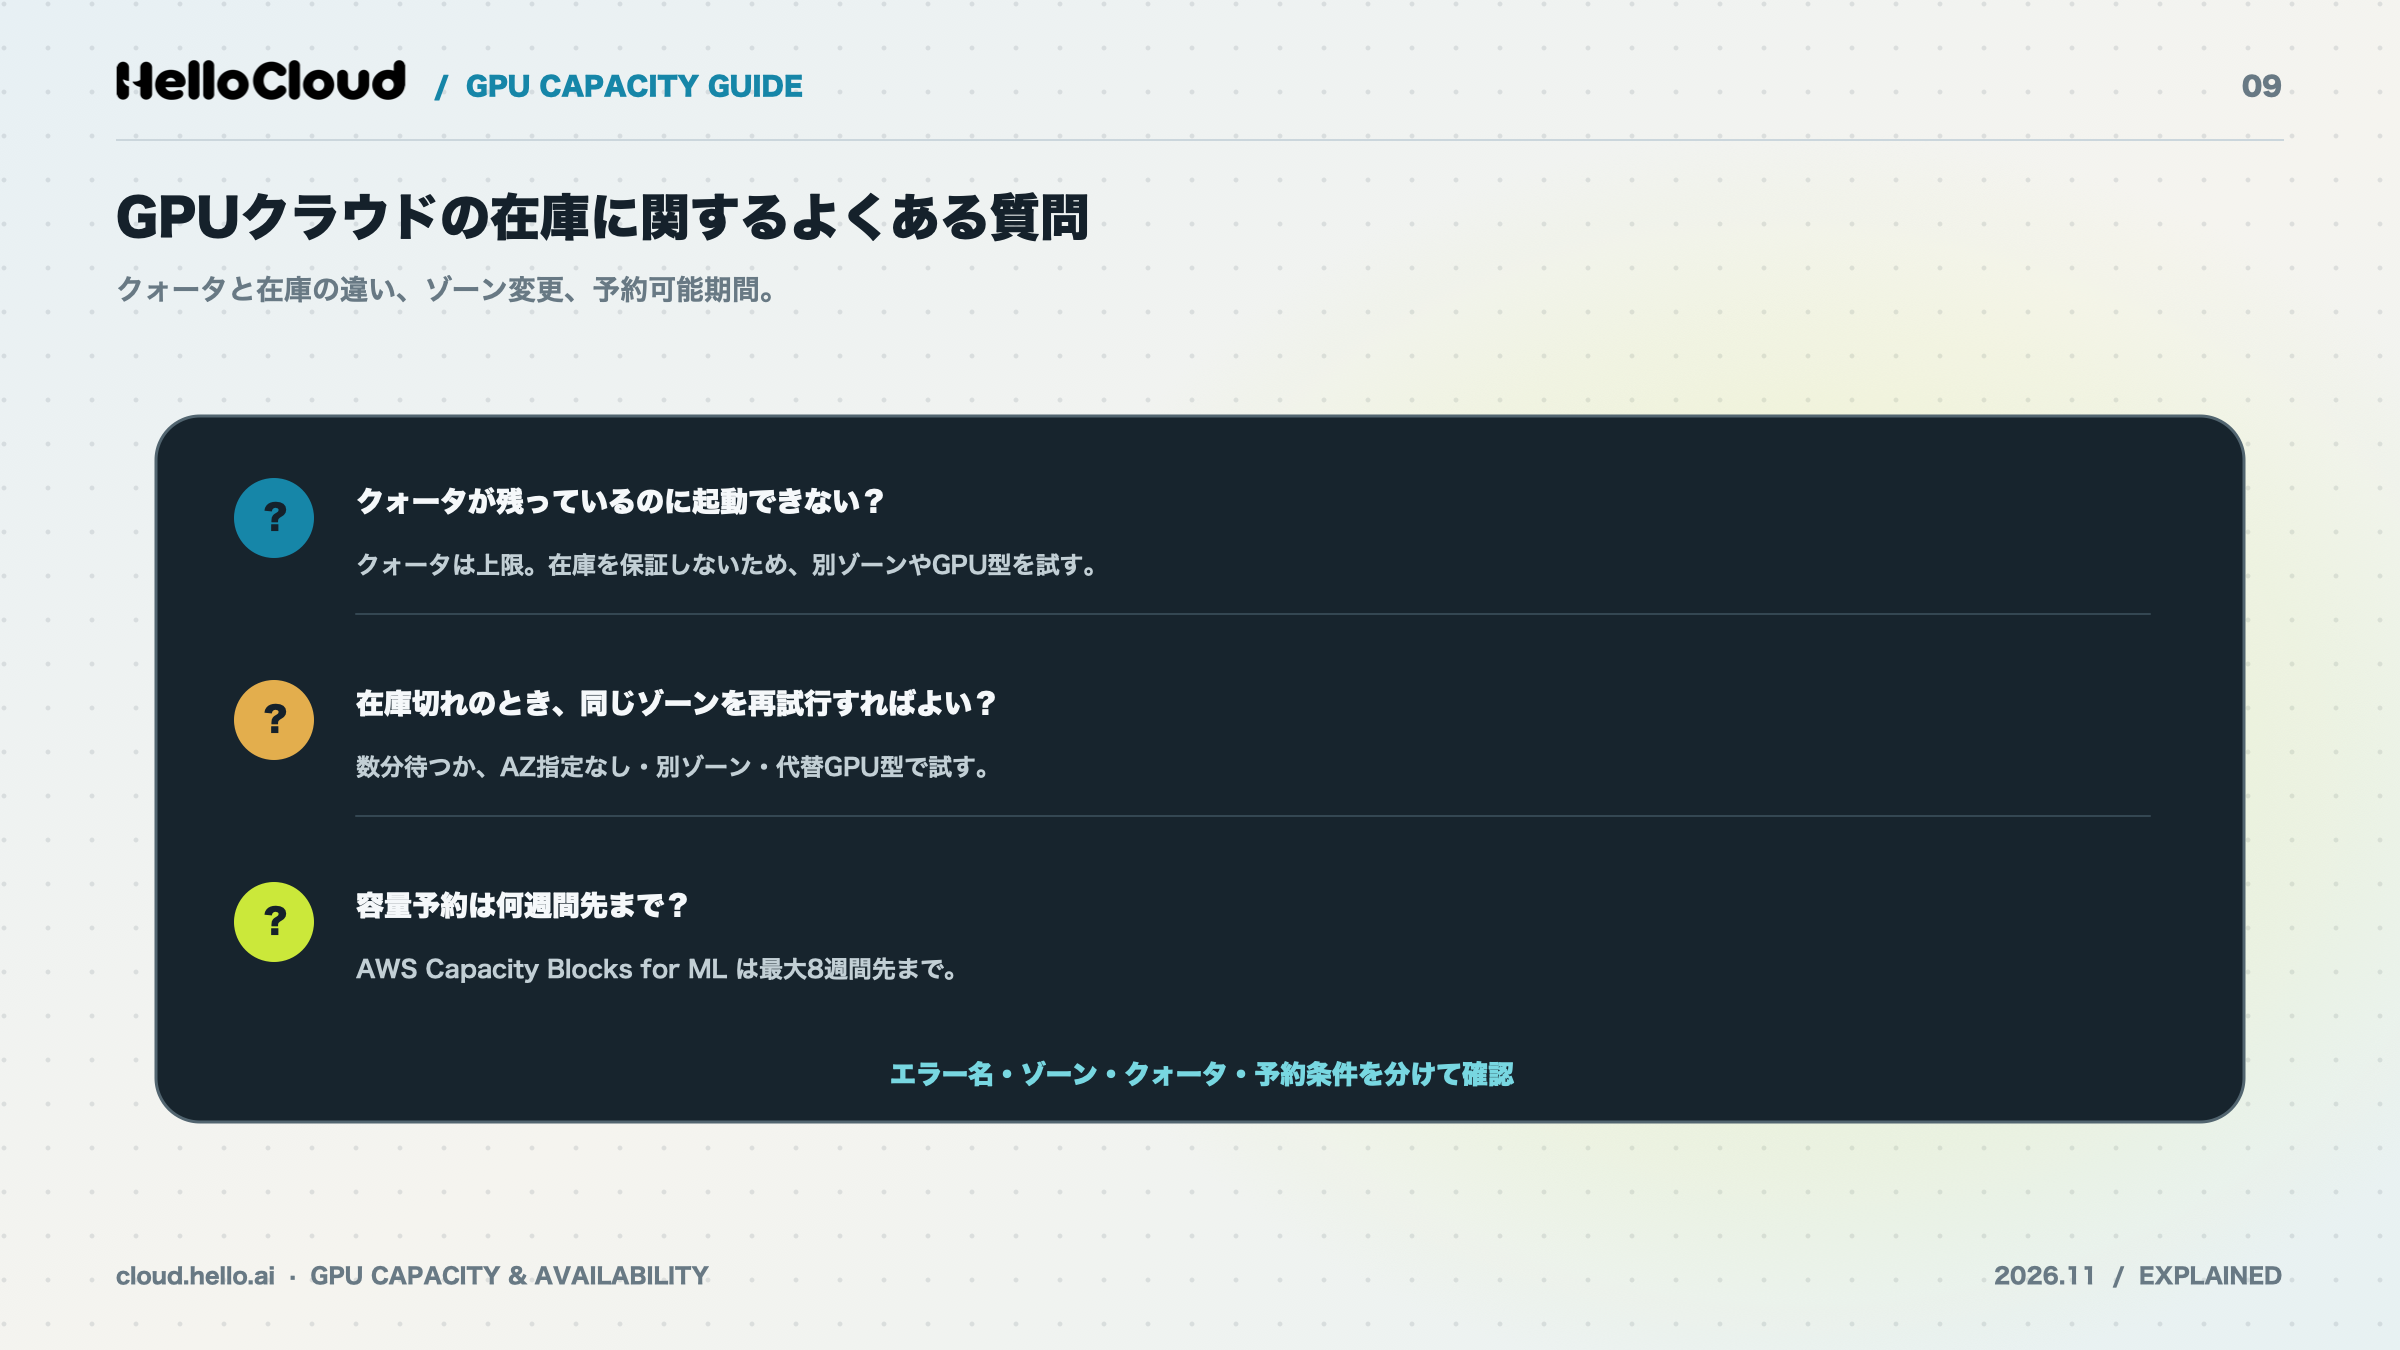
クォータが残っているのに起動できないのはなぜ?
クォータは作成できる上限の数で、在庫を保証しないためです。
ゾーンの在庫が尽きていると、クォータが残っていても作成できません。Google Cloudの公式ドキュメントは、別のゾーンで作成し直す方法を案内しています(出典:Compute Engineのクォータの解説(Google Cloud)、2026年11月6日更新)。GPUの型を変えて試す手もあります。
H100など人気のGPUを確実に確保する方法は?
在庫は時間・ゾーン・型で変わるため、使う日が決まっているなら予約が現実的な手段です。
AWSのCapacity Blocks for MLなら、最大8週間先まで予約できます(出典:Capacity Blocks for MLの解説(AWS)、2026年11月9日確認)。予約できない場合は、型の変更や国内事業者など別の調達先を並行して探してください。
確保を待つ間、停止中のインスタンスに料金はかかる?
停止中も、ストレージの保存料などがかかる場合があります。停止中に残る費用の内訳は、GPUクラウドの停止中の課金の解説で比べています。Runpodでは、停止中にGPUが他の利用者に割り当てられ、再開時にGPUなしでしか起動できなくなることがあります。原因と対処はRunpodのGPU在庫なしの解説で扱っています。
社内の稟議で確保が遅れる場合はどうする?
稟議と並行して、GPUの型・台数・期間を決め、クォータの確認と申請を進めておく方法があります。稟議書に書く項目は、GPUクラウドの稟議書の書き方にまとめています。
予約はキャンセルできないため、購入は承認が下りてから行ってください。
まとめ:GPUクラウドの在庫は原因を切り分けて確保する
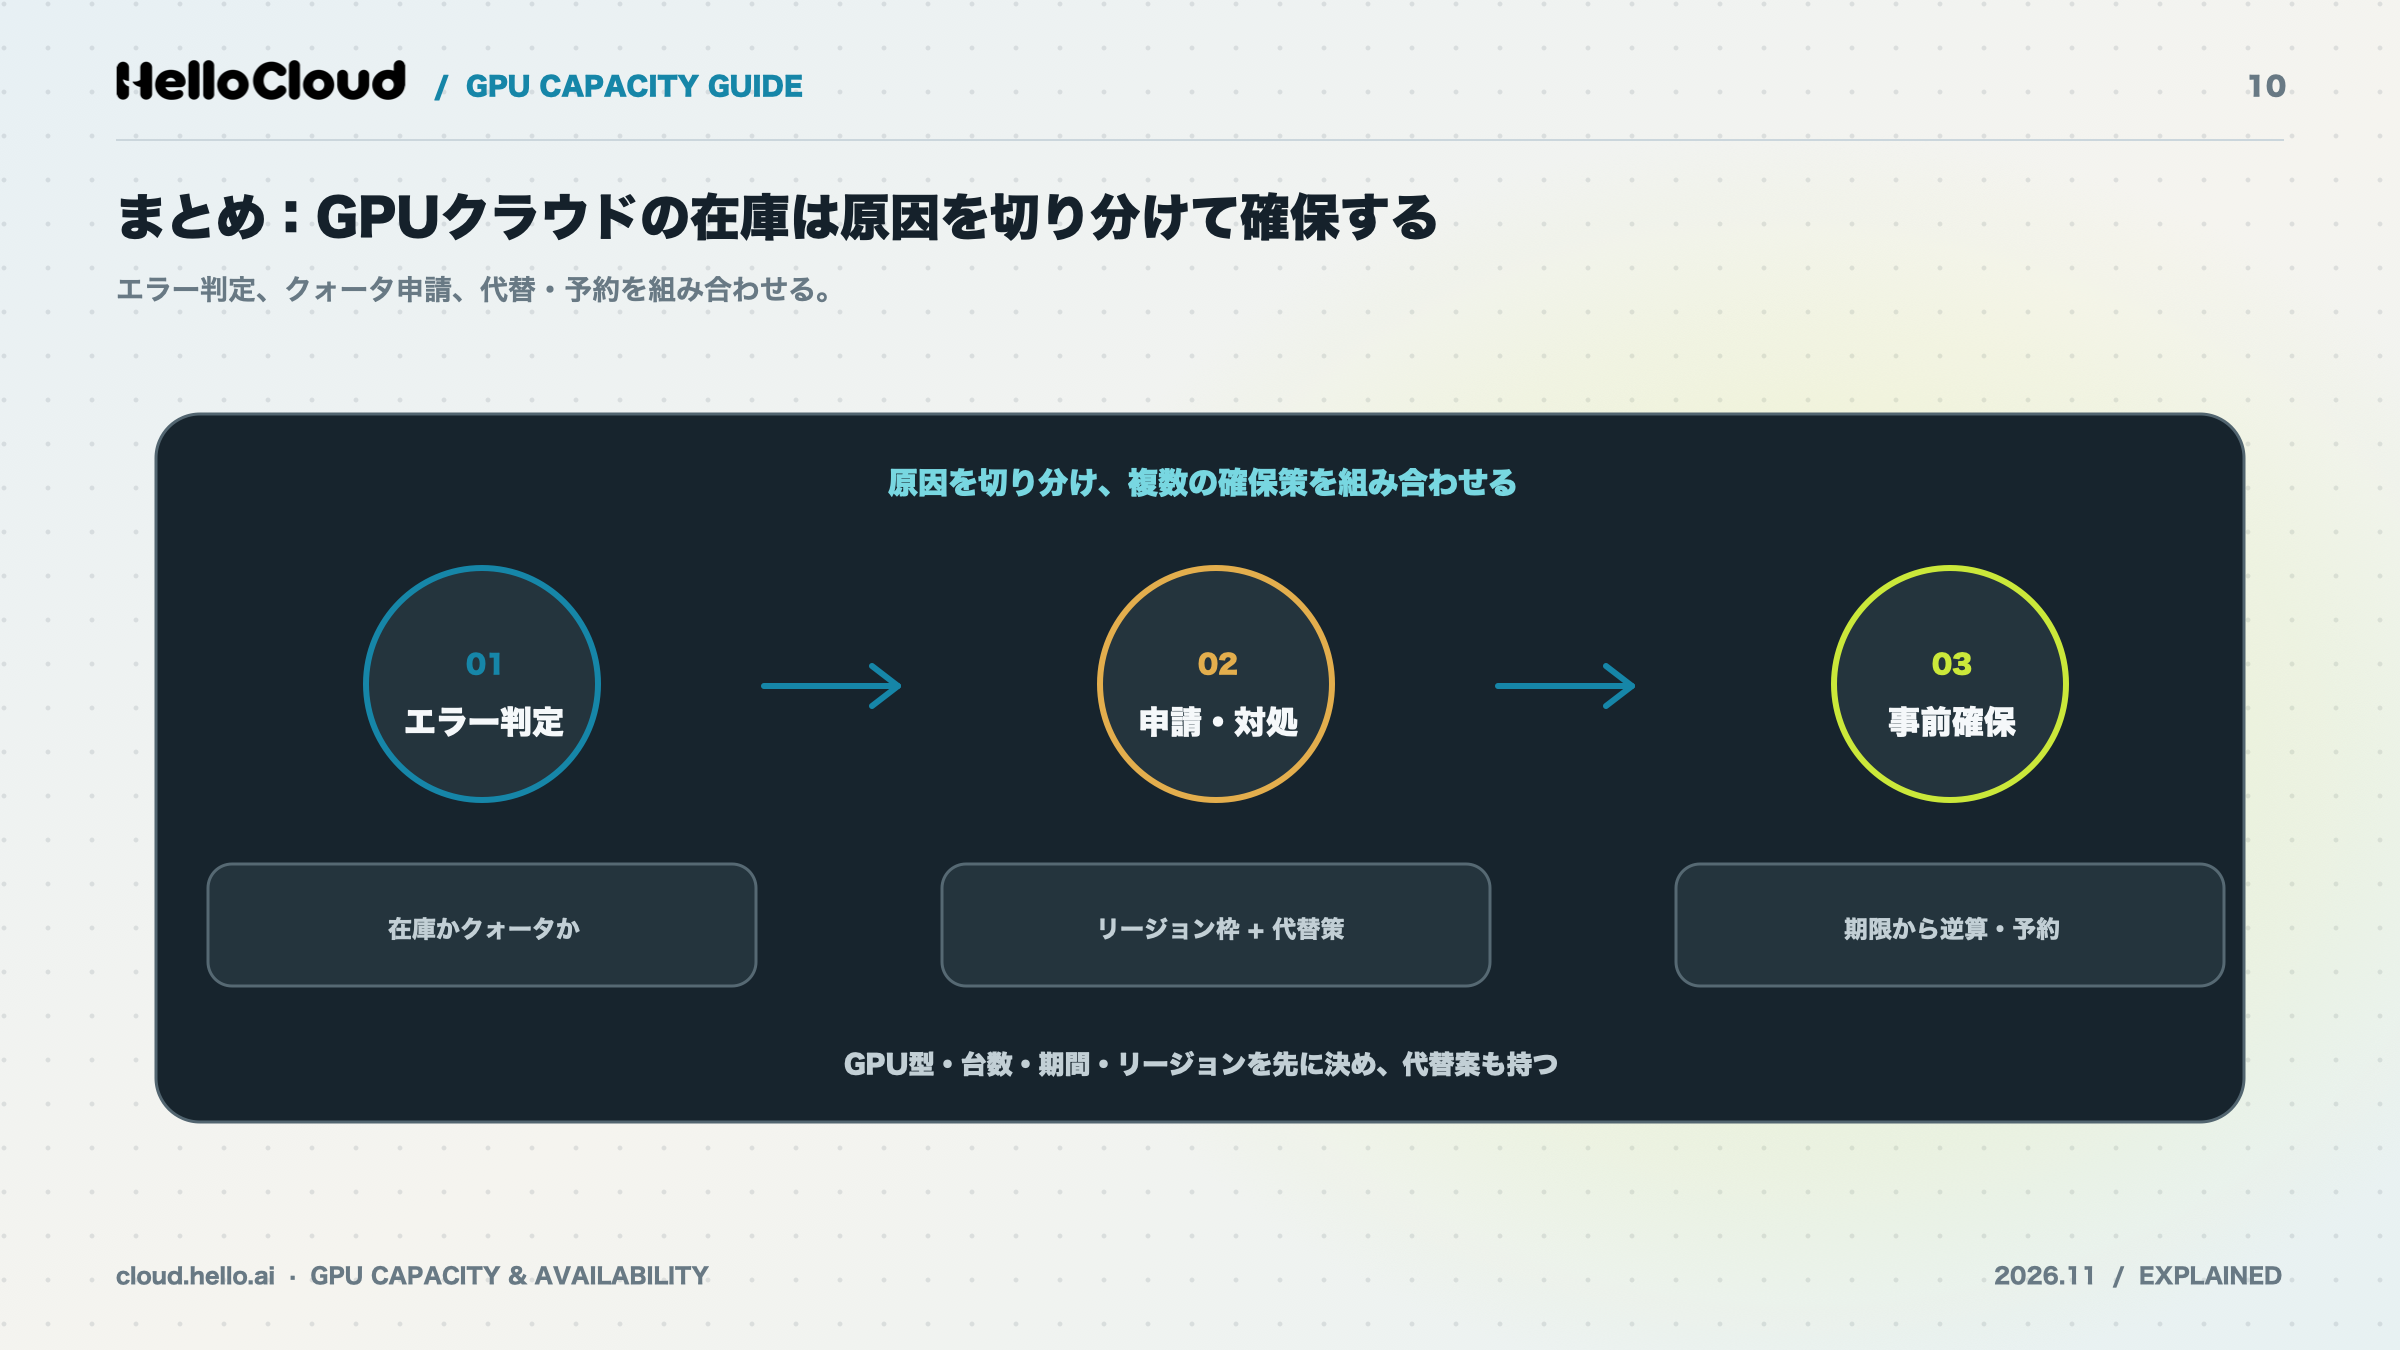
GPUクラウドの在庫不足は、エラー名で原因を切り分けてから対処します。
切り分け:InsufficientInstanceCapacityは在庫切れ、InstanceLimitExceededは上限到達。
申請:AWSはリージョンの上限、Google Cloudは2種類の枠。
対処:再試行、台数の分割、AZの指定なし、型の変更、スポット。
予約:最大8週間先まで。キャンセル不可。
段取り:型・台数・期間・リージョンを決め、クォータの申請を最初に。
学習用のGPUを国内で確保したい方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。GPUインスタンスは申し込みの当日から使えます。
資料請求(HelloCloudの特徴と料金)
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


