この記事の結論
Runpodの課金が止まらないときは、停止中のPodのVolume Disk(停止中は1GBあたり月0.20ドル)やNetwork Volumeの保管料を確認します。GPUが割り当てられないときは、公式の4つの対処から状況に合うものを選び、次からはデータをNetwork Volumeに置いて再発を防ぎましょう。
Runpod(RunPod)とは?できることと運営会社
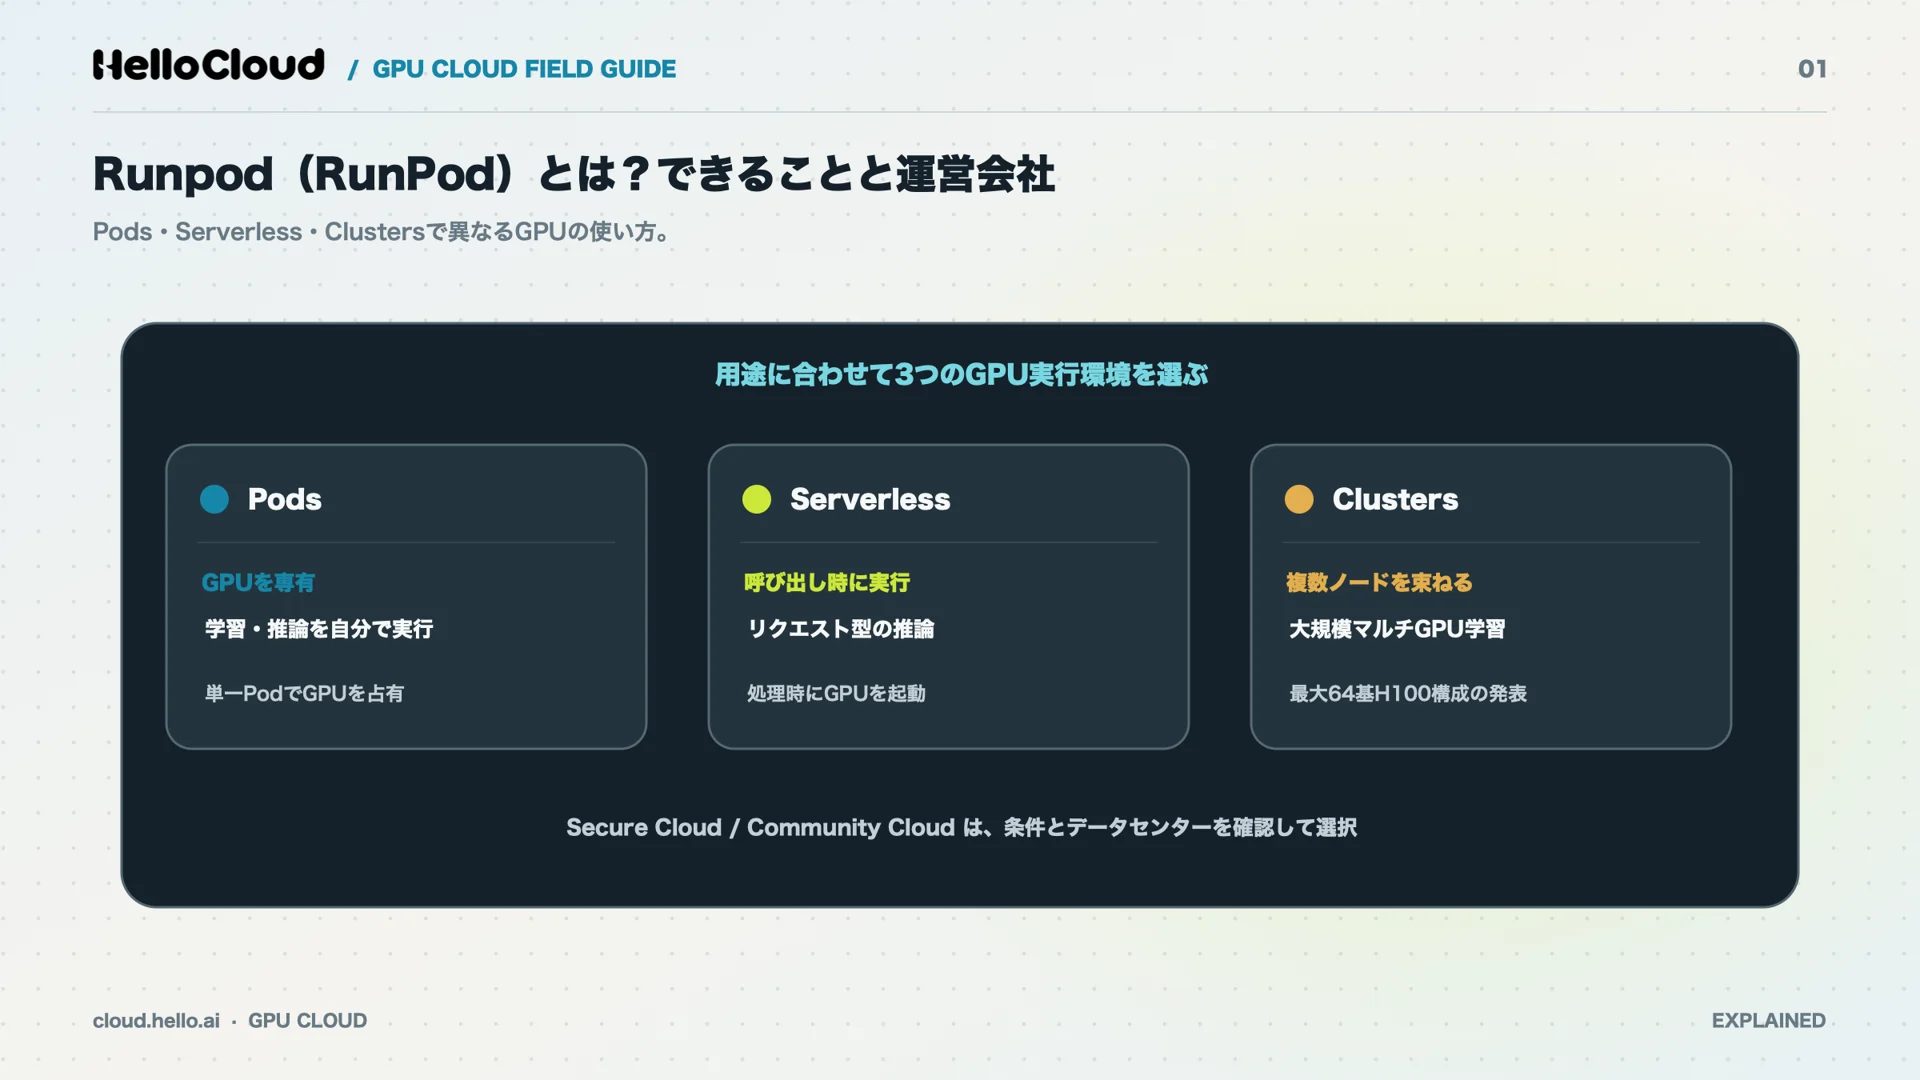
Runpodは、GPUを積んだ実行環境を、前払いのクレジットから秒単位で料金を引く方式で借りられるGPUクラウドです(出典:Runpod公式ドキュメント「Billing overview」、2026年11月7日確認)。
GPUクラウドの仕組みや使い方の全体像は、GPUクラウドの仕組みと使い方の解説で説明しています。
主なサービス:Pods・Serverless・Clusters
Runpodの主なサービスは、GPUを借りて自分で動かす「Pods」、リクエストに応じて処理を動かす「Serverless」、複数ノードのGPUをまとめて使う「Clusters」の3つです。
サービス | 何に使うか | 公式の記載 |
|---|---|---|
Pods | GPUを借りて、学習や推論を自分で動かす | Podは特定の物理マシンのGPUに割り当てられ、稼働中はそのGPUを占有する |
Serverless | リクエストが来たときに推論などの処理を動かす | Pods・ストレージと同じく、クレジットから利用料が引かれる |
Clusters | 複数ノードのGPUで大規模な学習を動かす | オンデマンドで最大64基のH100によるマルチノード構成(2026年1月の発表) |
出典:Runpod公式ドキュメント「Zero GPU Pods on restart」・「Billing overview」(2026年11月7日確認)、Runpodプレスリリース(2026年1月20日)
学習を数時間から数日かけて回す使い方なら、GPUを占有できるPodsが基本です。推論のAPIのように、リクエストがあるときだけGPUを動かしたい場合はServerlessが候補になります。
Secure CloudとCommunity Cloudの違い
Runpodでは、GPUを借りる環境としてSecure CloudとCommunity Cloudの2種類が用意されています。2つの環境の運営主体や料金、使える機能の違いは、申し込む前に公式の料金ページとドキュメントで確かめてください。
業務データを扱う場合は、データセンターの準拠状況も確認の対象です。Runpodによると、準拠状況はデータセンターごとに異なる可能性があります。デプロイ時に「Security & compliance」フィルターで、条件を満たすデータセンターを選ぶよう案内しています(出典:Runpodプレスリリース、2026年2月6日)。
運営会社と事業の規模
Runpodの発表によると、年間経常収益(ARR)は2026年1月に1億2,000万ドルを超え、2026年10月には3億2,500万ドルを超えました。
発表日 | ARR(年間経常収益) | 開発者数 | 出典 |
|---|---|---|---|
2026年1月20日 | 1億2,000万ドル超 | - | |
2026年10月13日 | 3億2,500万ドル超 | 120万人以上(1年前は約49万5,000人) |
出典:Runpodプレスリリース(2026年1月20日)・Runpodプレスリリース(2026年10月13日)(2026年11月7日確認)
いずれもRunpodの自己発表で、監査を経た数値かどうかは発表に書かれていません。数値を引用するときは、発表日も一緒に示してください。
ポイント:
Runpodは、Pods・Serverless・Clustersの3つでGPUを貸し出すGPUクラウドで、Runpodの発表ではARRが2026年10月に3億2,500万ドルを超えています。
Runpodの料金の仕組みと支払い方法
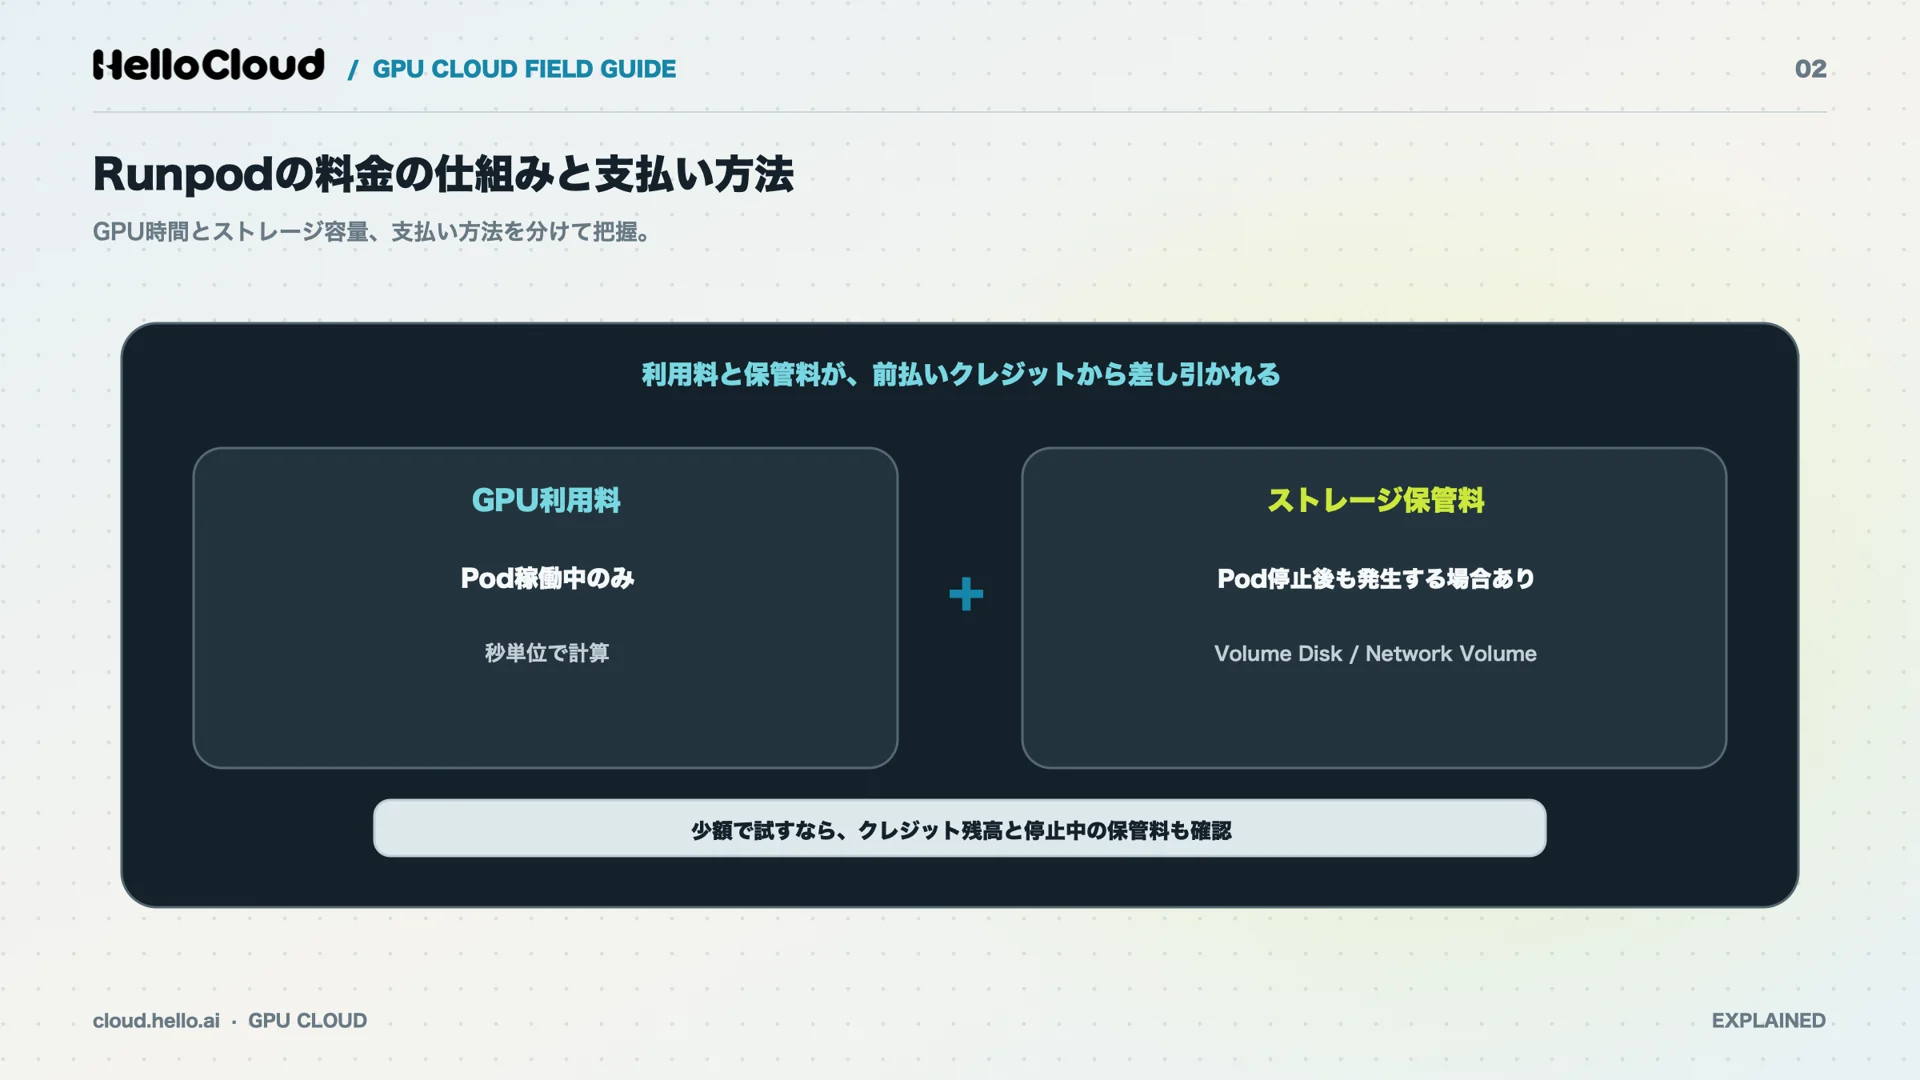
Runpodの料金は「GPUの利用料」と「ストレージの保管料」の2つで決まり、どちらも前払いのクレジットから秒単位で引かれます(出典:Runpod公式ドキュメント「Billing overview」、2026年11月7日確認)。
課金が止まらない、GPUが割り当てられないという2つのトラブルは、どちらもストレージの扱いと関係があります。
GPUは秒単位の従量課金
RunpodのGPUの利用料は、Podが動いている時間に応じて秒単位で計算する方式です。公式ドキュメント「Billing overview」によると、残高の監視と課金は5分ごとに行われ、データ転送の料金はかかりません。
GPU別の時間単価は、Runpodの料金ページに一覧があります。料金ページは2026年11月4日更新の表示で、価格は改定されることがあるため、申し込む直前に最新の単価を確認してください。
ストレージ3種の料金(稼働中・停止中)
Runpodのストレージは、Container Disk・Volume Disk・Network Volumeの3種類で、停止中の料金とデータの残り方がそれぞれ違います。
種類 | 稼働中の料金 | 停止中の料金 | 停止・削除したときのデータ | 課金の単位 |
|---|---|---|---|---|
Container Disk | $0.10/GB/月 | 課金なし | 停止すると消える | 秒 |
Volume Disk | $0.10/GB/月 | $0.20/GB/月 | Podを削除するまで残る | 秒 |
Network Volume(1TB未満) | $0.07/GB/月 | $0.07/GB/月 | Podを削除しても残り、別のPodにつなげる | 時間 |
Network Volume(1TB超) | $0.05/GB/月 | $0.05/GB/月 | Podを削除しても残り、別のPodにつなげる | 時間 |
出典:Runpod料金ページ(2026年11月4日更新の表示)、Runpod公式ドキュメント「Pricing」(2026年11月7日確認)
Container Diskは、Podの中の一時的な作業領域です。Volume DiskはPodに付く保存領域で、停止中は稼働中の2倍にあたる1GBあたり月0.20ドルがかかります。Network Volumeは、Podとは別に置いておける保存領域です。
料金ページには、より高速なHigh-Performance Network Storage($0.14/GB/月)も載っています。ホストマシンが利用できない間は、ストレージの料金はかかりません。
支払い方法と最初に入れる金額
Runpodは、クレジットカード・暗号資産・請求書払いで前払いのクレジットを入れる方式で、公式ドキュメントでは評価目的なら10ドルから始められると案内しています。
支払い方法 | 条件 |
|---|---|
クレジットカード | Visa、Mastercard、American ExpressなどStripeが対応するカード |
プリペイドカード | 1回あたり100ドル以上の入金が必要 |
暗号資産 | 初回の支払いの前に本人確認(KYC)が必要 |
請求書払い | 5,000ドルを超える取引が対象。ACH・銀行振込・カードに対応し、営業への問い合わせが必要 |
出典:Runpod公式ドキュメント「Billing overview」(2026年11月7日確認)
入金したクレジットは返金できず、引き出しもできません。Runpodのサービスにだけ使えるため、試すだけなら10ドルから入れ、停止中の保管料も含めた引き落としを見てから入金を増やしましょう。
ポイント:
Runpodの料金はGPUの利用料とストレージの保管料の2つで、Volume Diskは停止中に1GBあたり月0.20ドルと、稼働中の2倍になります。
Runpodの課金が止まらない原因と止め方
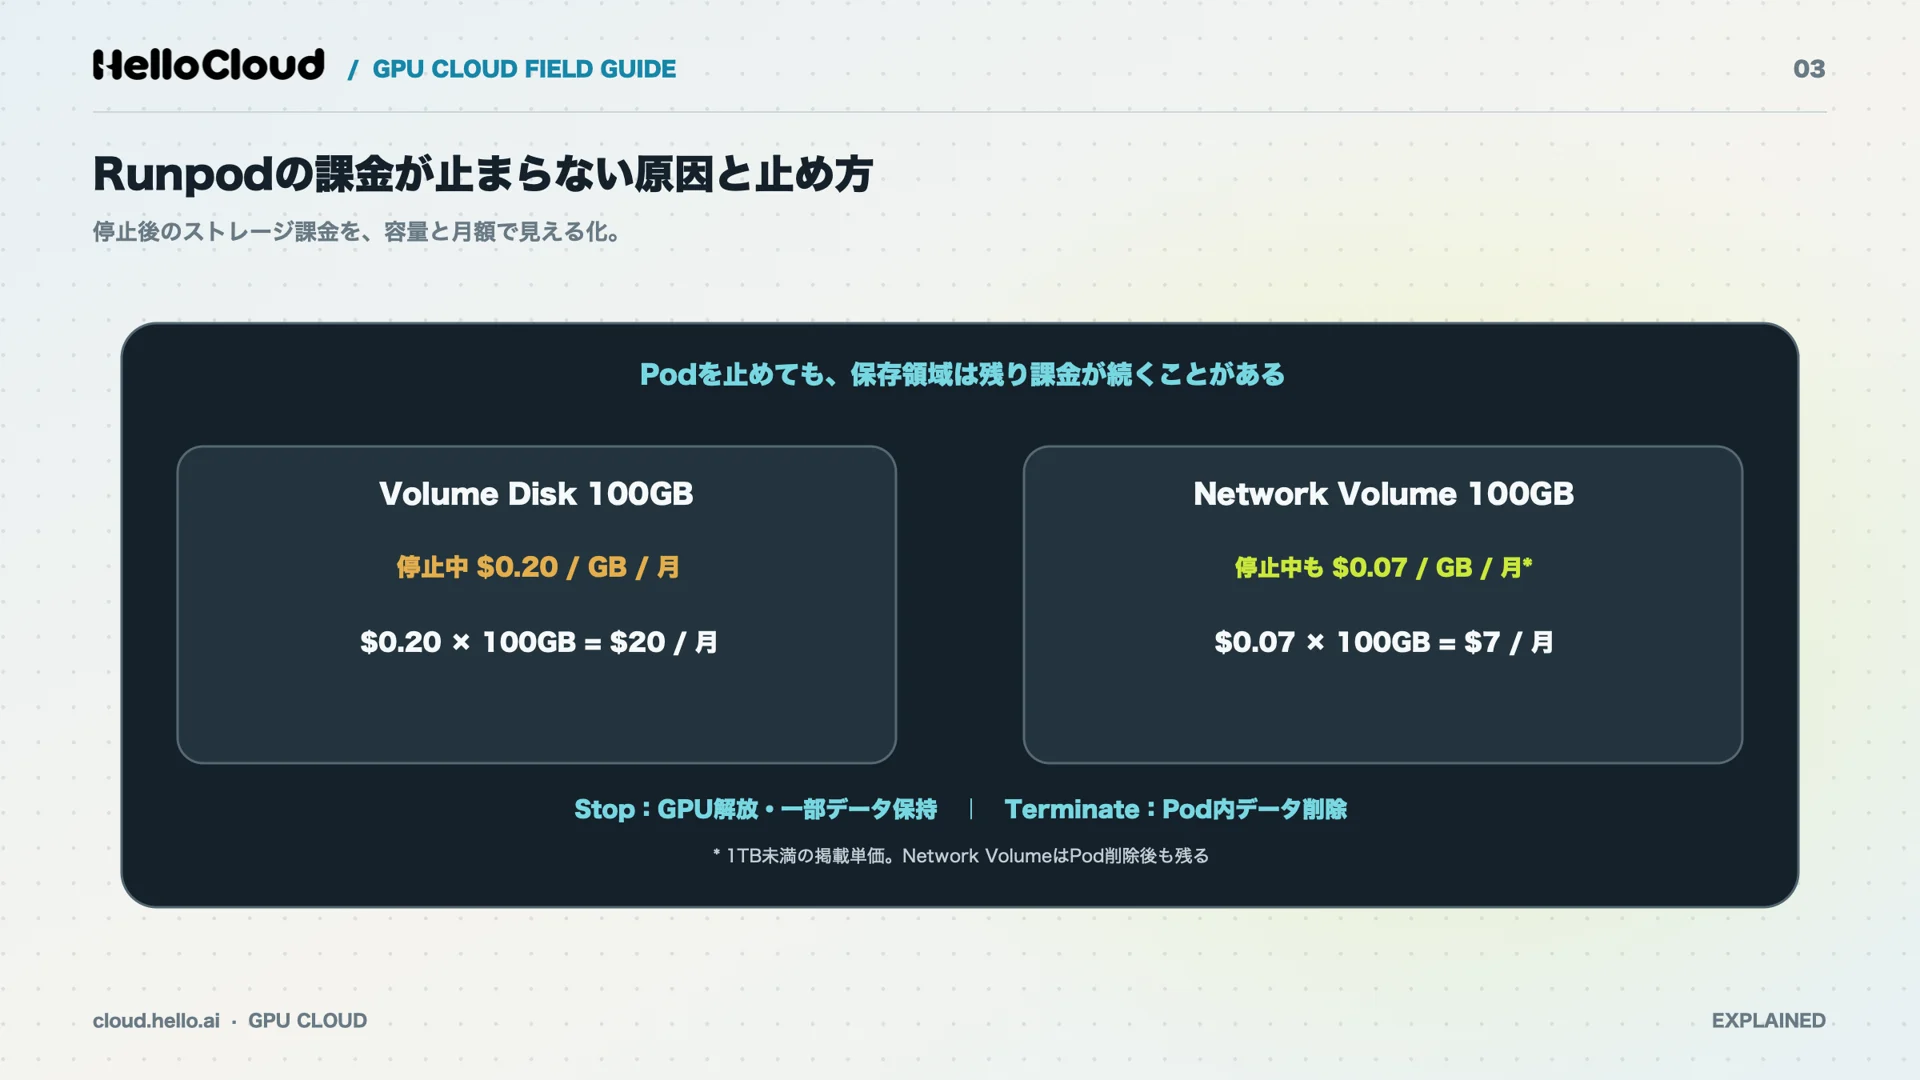
Runpodの課金が止まらない原因は、Podを止めた後も、Volume DiskやNetwork Volumeの保管料がクレジットから引かれ続けることです。
GPUの利用料はPodを止めた時点で止まります。データを残すためのストレージはPodを止めても残り、保管料もかかり続ける仕組みです。
Podを止めてもストレージの料金は続く
Volume Diskを100GB付けたPodを停止したまま30日置くと、ストレージだけで20ドルかかります。
計算式は「$0.20(停止中のVolume Diskの単価)×100GB=$20/月」です(1か月を30日として計算)。稼働中の単価は$0.10なので、同じ100GBでも月10ドルです。止めると保管料が2倍になるため、止めたのに残高が減ったように見えます。
Network Volumeを100GB使っている場合は、「$0.07×100GB=$7/月」の保管料が、Podの稼働・停止にかかわらずかかります(出典:Runpod公式ドキュメント「Pricing」、2026年11月7日確認)。Podを停止したまま3か月置くと、Volume Disk 100GBだけで「$20×3か月=$60」です。
Stop(停止)とTerminate(削除)の違い
Stop(停止)はGPUを手放してデータを残す操作で、Terminate(削除)はPodごとデータを消す操作です。
操作 | GPU | Container Disk | Volume Disk | Network Volume | 操作後にかかる料金 |
|---|---|---|---|---|---|
Stop(停止) | 解放される | 消える | 残る | 残る | Volume Disk($0.20/GB/月)とNetwork Volume |
Terminate(削除) | 解放される | 消える | 消える | 残る | Network Volumeだけ |
出典:Runpod公式ドキュメント「Pricing」・「Zero GPU Pods on restart」(2026年11月7日確認)
Network Volumeを付けたPodでは、Volume Diskの代わりにNetwork Volumeが/workspaceにつながります。Network Volumeを使う場合、Podを停止しても削除しても、/workspaceのデータは残ります(出典:Runpod公式ドキュメント「Network volumes」・「Manage Pods」、2026年11月7日確認)。
Stopは、同じPodで作業を再開したいときの操作です。ただし、Stopした時点でGPUは他の利用者に貸し出せる状態になるため、再開のときにGPUが割り当てられないことがあります。
注意:
Terminateすると、Network Volumeに置いていないデータは消えます。Network Volumeの保管料まで止めたい場合は、残したいデータを手元へ移してから、Network Volume自体を削除してください。
残高が0ドルになると起きること
Runpodでは、クレジットの残高が0ドルになると、実行中のPodがすべて自動で停止します(出典:Runpod公式ドキュメント「Billing overview」、2026年11月7日確認)。
Network Volumeを付けたPodは停止し、データはNetwork Volumeに残ります。Network Volumeを付けていないPodは終了(削除)され、データは復旧できません。停止中もNetwork Volumeの保管料は発生し続け、残高が0ドルのまま払えない状態が続くと、Network Volumeも削除されてデータを戻せなくなる場合があります(出典:Runpod公式ドキュメント「Network volumes」、2026年11月7日確認)。
注意:
残高が0ドルになると、Network Volumeを付けていないPodは終了し、データは復旧できません。長時間の学習を回す前に、残高とデータの置き場所を確認してください。
使いすぎを防ぐ仕組みとして、アカウント全体に既定で1時間あたり80ドルの支出上限が設定されています。支出上限は利用履歴に応じて自動で上がり、すぐに上げたい場合はサポートへの連絡が必要です。
課金を止めるときの確認リスト
Runpodの課金を止めるときは、次の4つの順に確認すると、データを失わずに保管料を止められます。
残したいデータの置き場所を確かめる:Container DiskとVolume Diskにあるデータは、Terminateで消えます。残すデータは、手元か外部のストレージに移しておきましょう。次に作るPodにNetwork Volumeを付けておけば、データをPodから切り離せます。
使い終わったPodを停止か削除か決める:再開の予定がなければTerminateが確実です。Stopのままだと、Volume Diskの保管料($0.20/GB/月)が続きます。
不要なNetwork Volumeを削除する:Network VolumeはPodを削除しても残り、保管料がかかり続ける領域です。
残高と支出上限を確かめる:Billingのページで残高と直近の利用額を見て、想定外の引き落としがないかを確認してください。
AWSやGoogle Cloudなど、ほかのGPUクラウドで停止中に残る費用は、停止中に残るGPUクラウドの費用の解説で比べています。
ポイント:
Runpodの課金が止まらないときは、停止中のVolume DiskやNetwork Volumeの保管料を疑い、不要なPodはTerminate、不要なNetwork Volumeは削除するのが確実です。
RunpodのGPU在庫なし(Zero GPU)の原因と対処
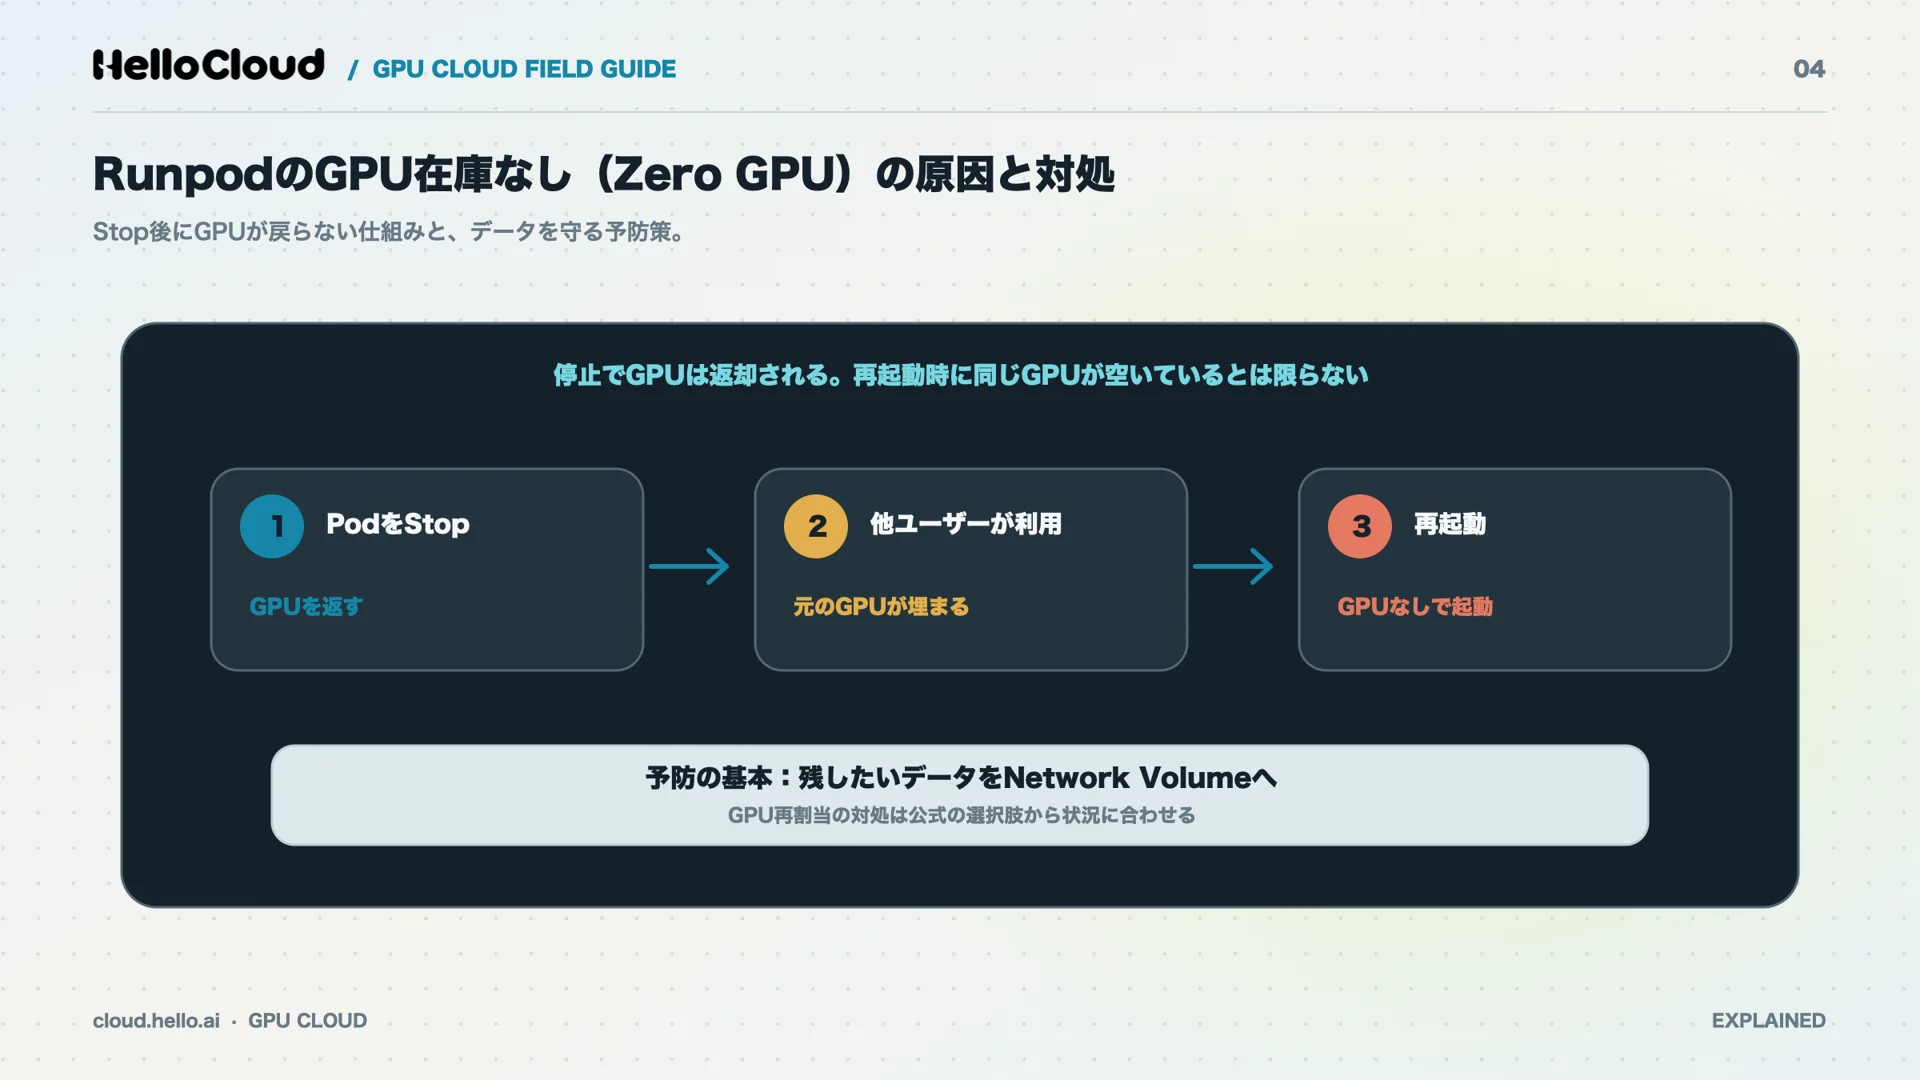
Runpodで止めたPodを再起動したときにGPUが割り当てられない原因は、停止中に元の物理マシンのGPUが他の利用者に借りられたことです。
Runpodの公式ドキュメントは、GPUなしでしか起動できないPodを「Zero GPU Pods」と呼び、4つの対処と予防策を示しています。
Zero GPUが起きる仕組み
RunpodのPodは、特定の物理マシンのGPUに割り当てられ、Podが動いている間はそのGPUを占有します(出典:Runpod公式ドキュメント「Zero GPU Pods on restart」、2026年11月7日確認)。
Podを停止した時点で、そのGPUは他の利用者が借りられる状態に戻る仕組みです。停止中に別の利用者がそのGPUを借りると、再起動のときに元のマシンでGPUを使えません。Volume Diskのデータは元のマシンに残っているため、PodはGPUなしでしか起動できない状態になります。
Runpod全体でGPUがなくなったわけではなく、元のマシンのGPUが埋まっている状態です。同じGPUの種類でも、別のマシンであれば空いていることがあります(出典:Runpod公式ドキュメント「Pod migration」、2026年11月7日確認)。
公式が案内する4つの対処(状況別の早見表)
Zero GPUになったときの対処は公式ドキュメントに4つあり、Volume Diskのデータが必要かどうかで選び方が変わります。
対処 | 向いている状況 | Volume Diskのデータ | 注意点 |
|---|---|---|---|
CPUのみで起動する | データだけ取り出したい | 取り出せる | CPUは限られ、計算には向かない |
待って再試行する | 同じPodのまま再開したく、急がない | そのまま残る | GPUが空く時期の保証はない |
Podを移行する(ベータ) | すぐにGPUで再開し、/workspaceのデータも使いたい | 新しいPodにコピーされる | ベータ版の機能。新しいPodのIDとIPアドレスが変わり、/workspace以外のデータは移らない |
同じ構成で再デプロイする | データが不要で、すぐにGPUが必要 | 使わない前提 | データが不要な場合に限る |
出典:Runpod公式ドキュメント「Zero GPU Pods on restart」・「Pod migration」(2026年11月7日確認)
学習の途中経過を残したまま急いで再開したい場合は、Podの移行が候補です。移行では、空いているGPUを持つマシンに新しいPodを作り、/workspaceのデータをコピーします。
データを取り出してから環境を作り直す場合は、CPUのみで起動してデータを手元や外部のストレージへ移し、そのあと同じ構成で再デプロイしてください。
Network Volumeで再発を防ぐ
Zero GPUを防ぐ方法として、Runpodの公式ドキュメントはNetwork Volumeの利用を挙げています。
Network Volumeは、/workspaceのデータを特定の物理マシンから切り離して保存する領域です。Podを削除しても、空いているGPUのあるマシンに新しいPodを作り、同じNetwork Volumeをつなげば作業を再開できます。
Network Volumeを使うには、次の3つの条件があります(出典:Runpod公式ドキュメント「Network volumes」、2026年11月7日確認)。
Secure CloudのPodでしか使えない
Podをデプロイするときに付ける必要がある
選べるGPUは、Network Volumeを置いた場所によって変わる
注意:
Network VolumeはPodを停止・削除しても残り、保管料(1TB未満は$0.07/GB/月)がかかり続けます。使い終わったら、不要なNetwork Volumeを削除してください。
GPUの価格と供給の状況
Runpodが公表したレポートでは、B200のリスト価格が2026年1月から8月にかけて31%上がったとしています(出典:Runpodプレスリリース、2026年9月29日)。
同じレポートによると、量子化(モデルの数値の精度を落として軽くすること)した版を使うPodの割合は、動かすモデルの大きさで次のように違います。
70Bパラメータを超えるモデル:40.7%
8B〜70Bのモデル:32.5%
8B未満のモデル:11.6%
Runpodは、HBM(GPUに載せる高速なメモリ)が2027年まで実質的に売り切れているとの見方も示しています。AWSやGoogle Cloudなど、ほかのGPUクラウドで在庫が足りないときの見分け方と対処は、GPUクラウドの在庫切れ対策で扱っています。
レポートのデータは、約120万ユーザーの匿名化したRunpodのプラットフォームデータ(2025年4月1日〜2026年8月31日)です。Runpod自身が、Runpod上の活動にもとづくもので市場全体を代表するものではないと明記しています。
ポイント:
RunpodのGPU在庫なしは、停止中に元のマシンのGPUが借りられることで起き、公式の4つの対処から選んで再開でき、再発防止の手段はNetwork Volumeです。
学習用途でRunpodを使う前に確認すること
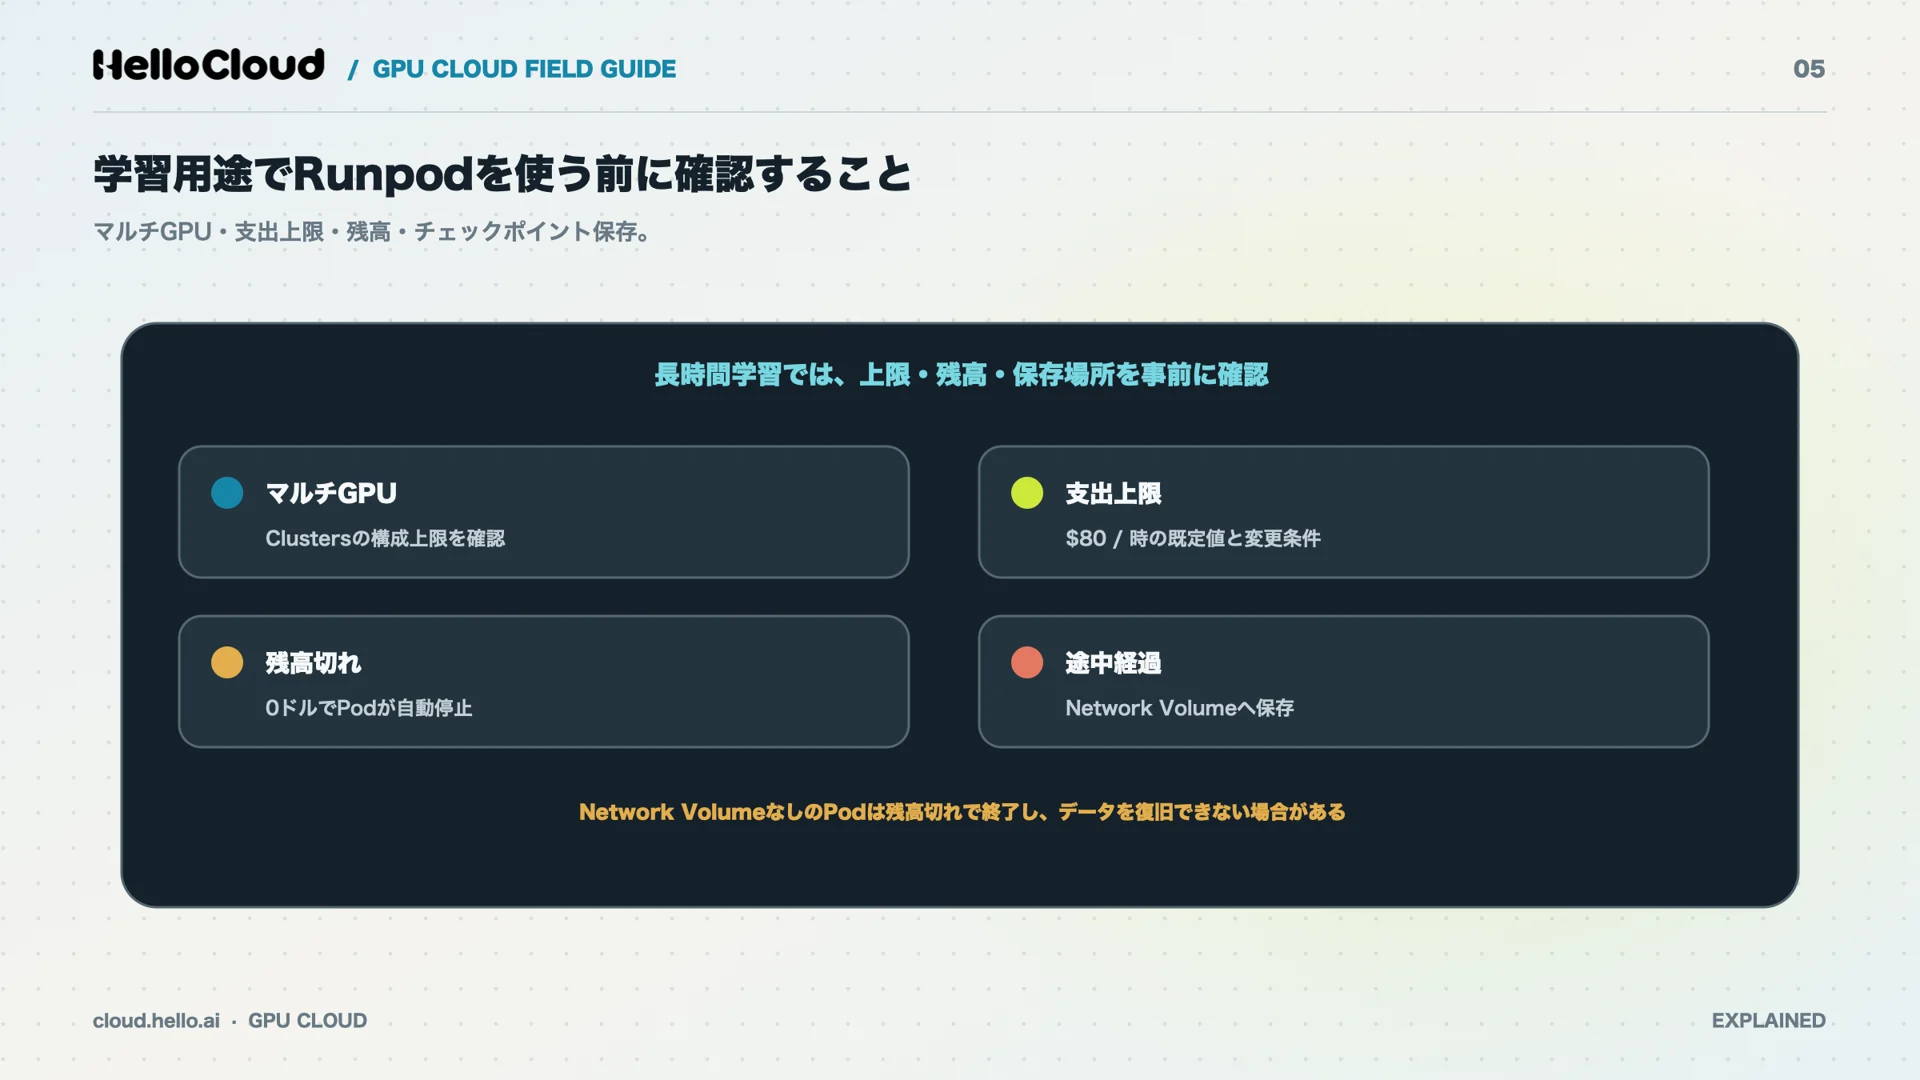
Runpodで長時間の学習を回す前に、マルチGPUの上限、支出上限、残高切れのときの挙動の3点を公式の条件で確かめれば、学習の途中停止を防げます。
学習は推論と違い、同じGPUを長く占有し、途中経過のデータもたまっていく作業です。停止と再開、残高、データの置き場所が、そのまま学習の継続を左右します。
長時間・マルチGPUの学習で確認すること
長時間・マルチGPUの学習では、次の4つの条件が学習の途中停止につながります。
確認項目 | 公式の条件 | 学習への影響 |
|---|---|---|
マルチGPUの構成 | Clustersはオンデマンドで最大64基のH100によるマルチノード構成(2026年1月の発表) | 64基を超える規模は、別の確保方法を検討する |
支出上限 | 既定でアカウント全体の合計が1時間80ドル。利用履歴に応じて自動で上がる | GPUを増やすと上限に達することがある。すぐ上げたい場合はサポートに連絡する |
残高切れ | 残高0ドルで全Podが自動停止し、Network VolumeのないPodは終了する | 途中経過のデータが失われることがある |
停止と再開 | 停止するとGPUが解放され、再開時に割り当てられないことがある | 途中で止めると、同じPodで再開できないことがある |
出典:Runpodプレスリリース(2026年1月20日)、Runpod公式ドキュメント「Billing overview」・「Zero GPU Pods on restart」(2026年11月7日確認)
学習の途中経過(チェックポイント)はNetwork Volumeに保存し、学習期間の分のクレジットは開始前に入れておきましょう。必要なGPUの台数やVRAM(GPUのメモリ)の量は、モデルの大きさから見積もってください。見積もり方は、LLMの必要VRAMの計算方法で解説しています。
国内のGPUで学習環境を用意する場合の条件は、後半の「Runpodの国内の代替:HelloCloudとの条件の違い」で比べています。
公開されている学習の事例
Runpodの発表によると、Civitaiは、Runpod上で月80万件以上のLoRAを、500基以上の同時GPUで学習しています(出典:Runpodプレスリリース、2026年1月20日)。
LoRAは、学習済みモデルの重みを固定したまま、追加した小さな行列だけを学習させる手法です(出典:Hu et al.「LoRA: Low-Rank Adaptation of Large Language Models」、2021年6月)。発表には使ったGPUの種類や学習時間の条件が書かれていないため、同じ規模を自分の学習で確保できるかは、支出上限や確保の方法とあわせて確かめてください。
ポイント:
Runpodで学習を回す前に、マルチGPUの上限(Clustersは最大64基のH100)、支出上限(既定で1時間80ドル)、残高切れの挙動を確かめ、途中経過はNetwork Volumeに保存します。
法人・研究機関でRunpodを使うときの確認点
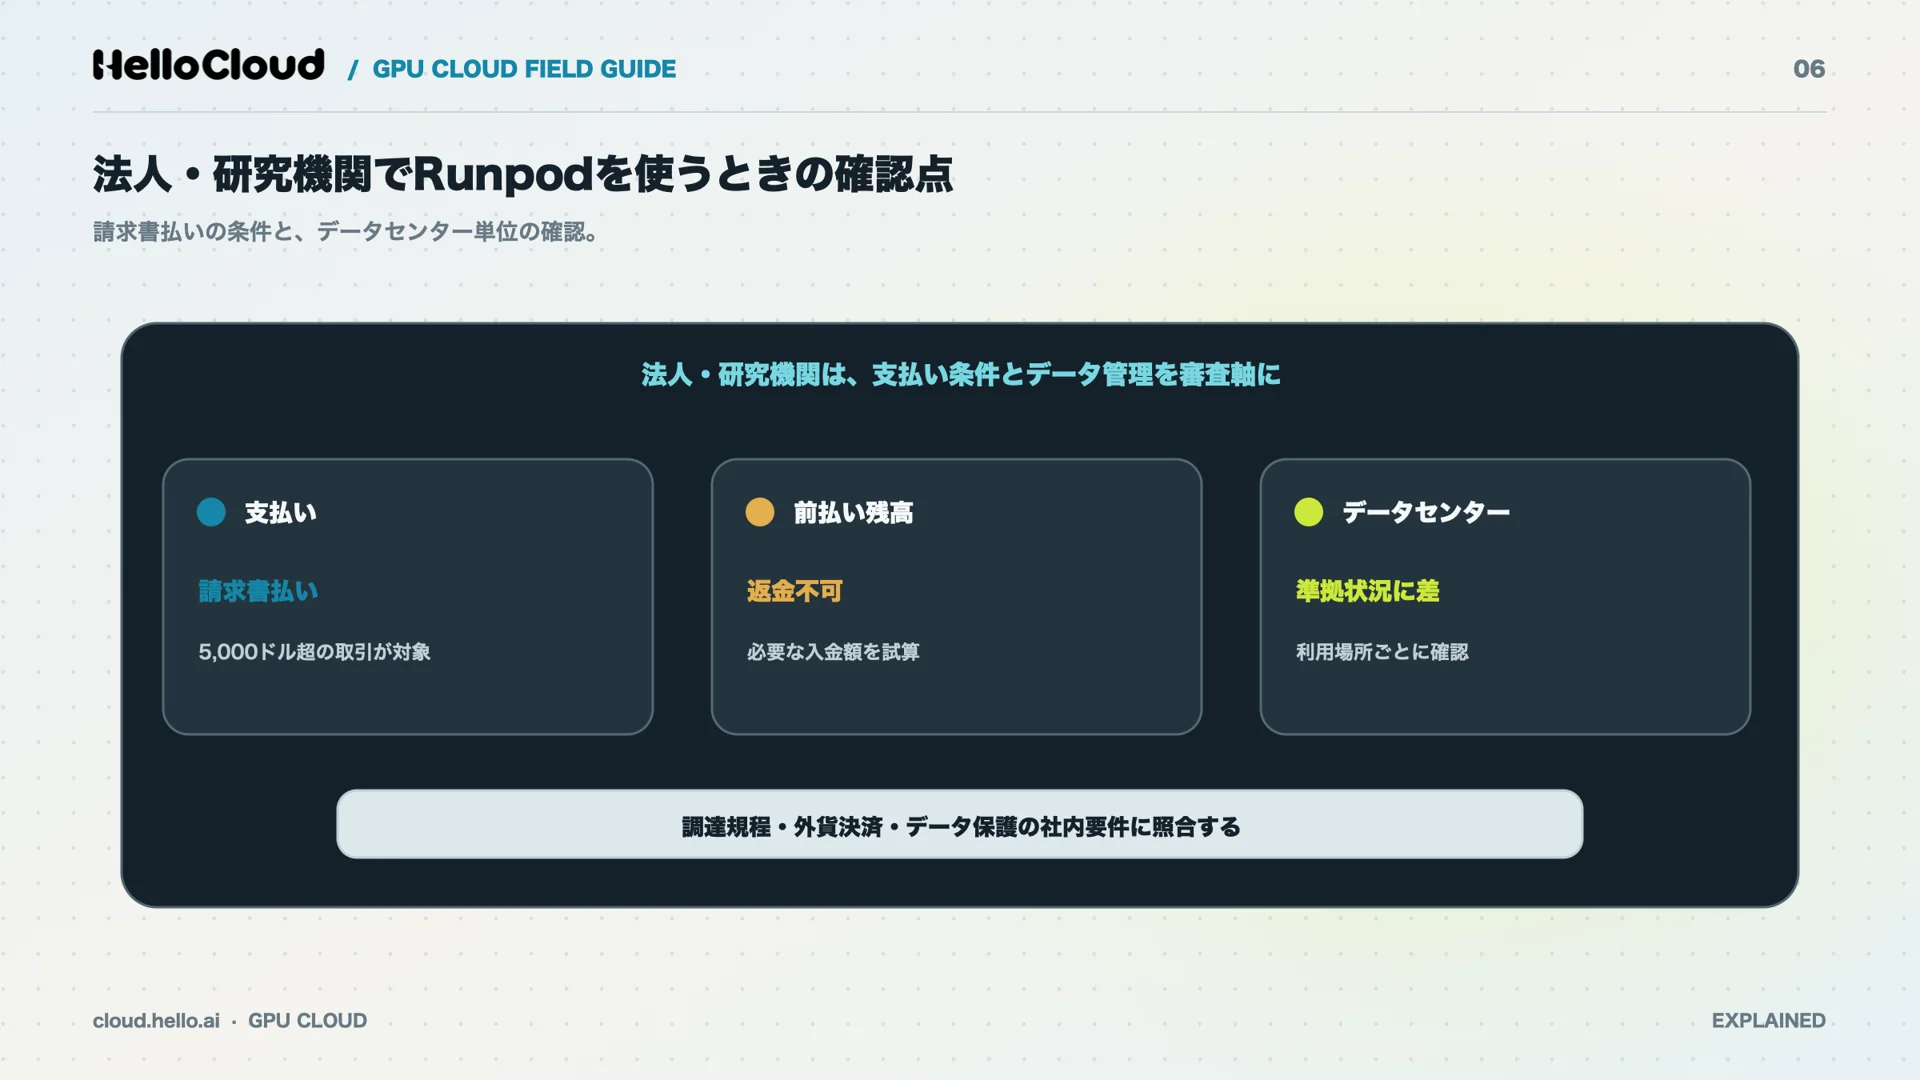
Runpodを法人や研究機関で使う場合、請求書払いが5,000ドルを超える取引に限られる点と、データセンターごとに準拠状況が違う可能性がある点を先に確かめます。
どちらも、個人で試すときには気にならなくても、組織の購買規程やデータ管理の規程で承認の可否を分ける条件です。
支払い・請求の条件
Runpodの支払いは、ドル建ての前払いクレジットで、請求書払いは5,000ドルを超える取引が対象です(出典:Runpod公式ドキュメント「Billing overview」、2026年11月7日確認)。
5,000ドル以下の利用ではカードか暗号資産での前払いになるため、組織のカードで外貨建ての前払いができるかを確かめておく必要があります。入金したクレジットは返金できないので、入金額は学習を回す期間に必要な分を見積もってから決めてください。
稟議書に書く項目や、ドル建ての為替・請求書払いの書き方は、GPUクラウドの稟議書の書き方にまとめています。
データの保管場所と準拠状況
Runpodは、HIPAA(米国の医療情報の規則)とGDPR(EU一般データ保護規則)について、独立した監査で準拠が確認されたと発表しています(出典:Runpodプレスリリース、2026年2月6日)。
同じ発表では、準拠状況がデータセンターごとに異なる可能性も示されました。準拠が必要な場合の手順として、PodやClusterのデプロイ時に「Security & compliance」フィルターで条件を満たすデータセンターを選ぶよう案内があります。監査を行った機関の名前は、発表に書かれていません。
注意:
個人情報や社外秘のデータを海外のGPUクラウドで扱う場合は、社内の情報管理部門・法務に確認してから利用してください。
ポイント:
法人でRunpodを使う前に、5,000ドル以下はカードか暗号資産での前払いになる点と、準拠状況はデータセンターごとに違う可能性がある点を確かめます。
Runpodの国内の代替:HelloCloudとの条件の違い
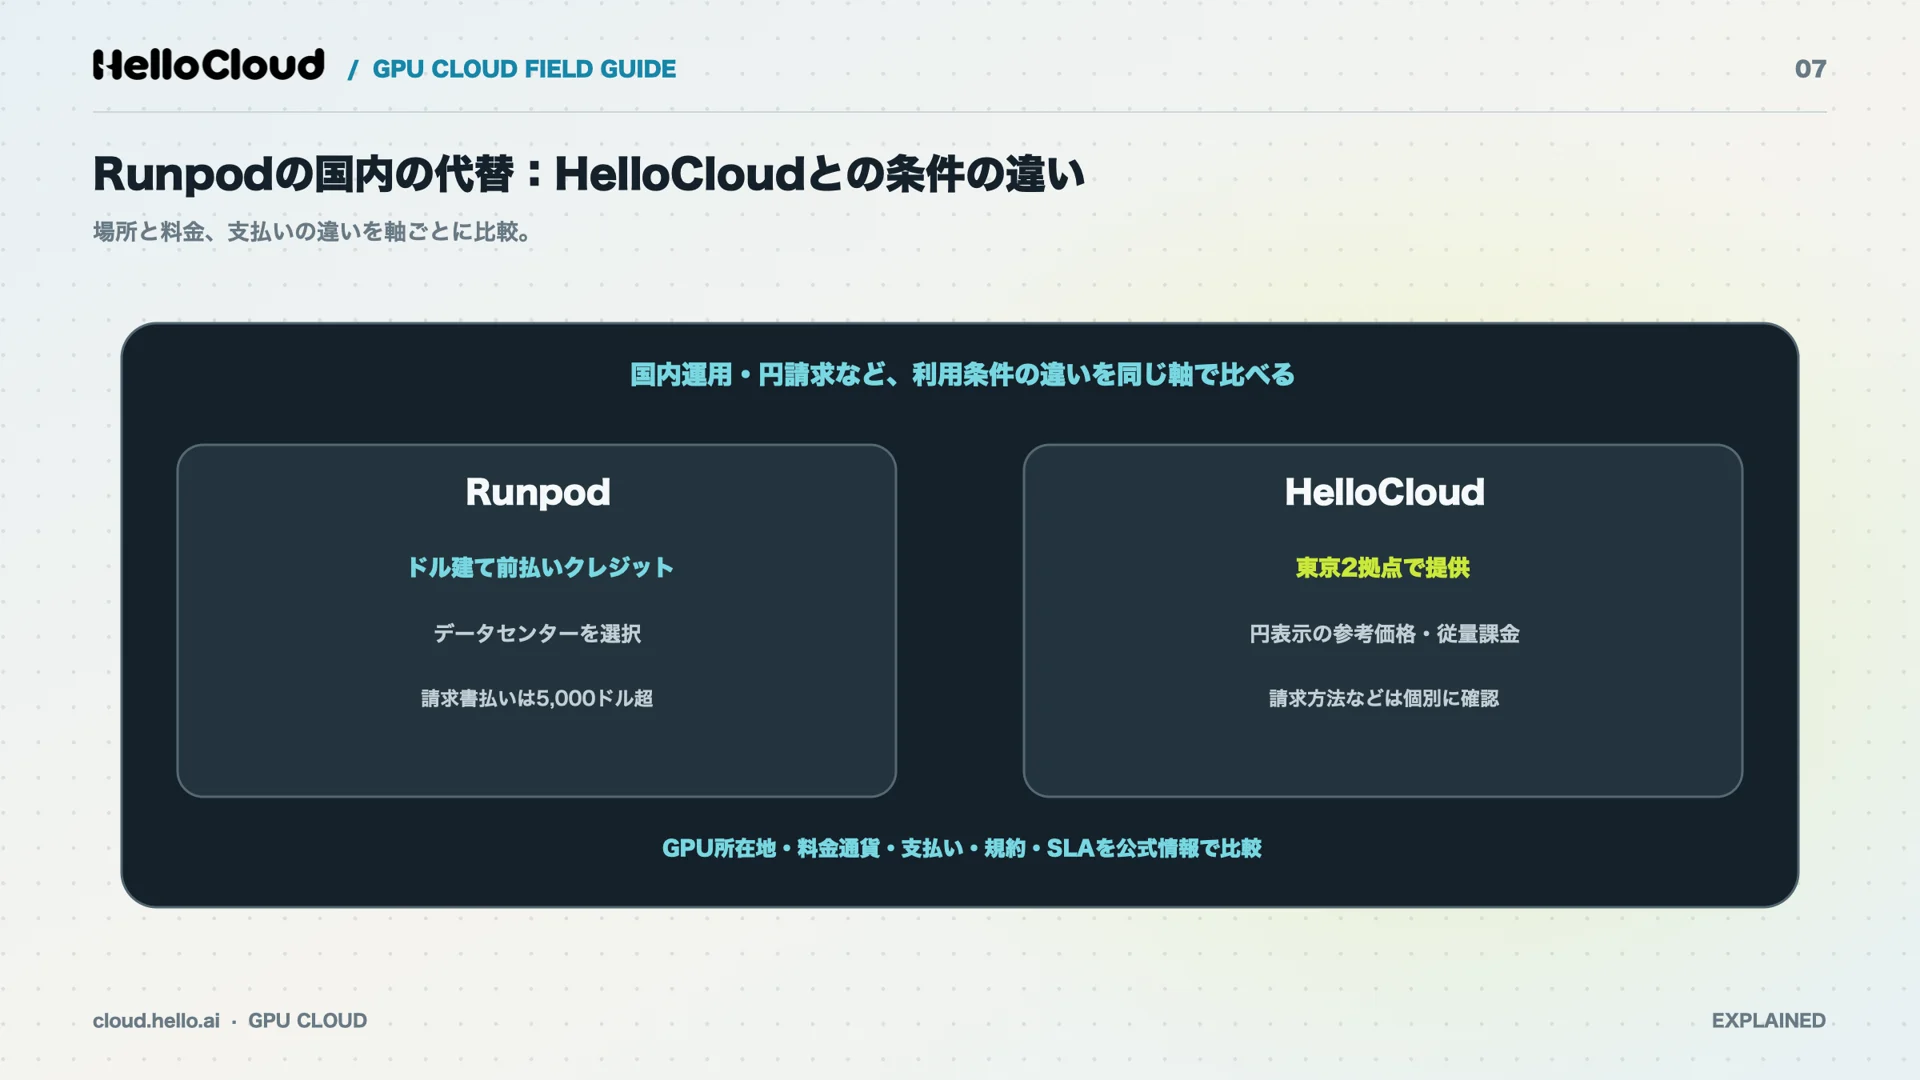
国内のデータセンターでGPUを使いたい場合の選択肢の1つが、この記事を運営する株式会社HelloCloudのGPUクラウド「HelloCloud」です。
HelloCloudは、日本国内のデータセンターでAIモデルの実行・学習ができるGPUクラウドです。東京の2拠点(JPTY01/JPTY02)で、GPUインスタンスとサーバーレスGPU実行環境が稼働しています(出典:HelloCloud公式サイト、2026年11月5日確認)。比較は、公式の記載で同じ軸に並べられる条件に絞りました。
RunpodとHelloCloudの条件比較表
RunpodとHelloCloudの大きな違いは、GPUを動かす場所の選び方と、料金の払い方です。
項目 | Runpod | HelloCloud |
|---|---|---|
GPUを動かす場所 | デプロイ時にデータセンターを選ぶ(準拠状況はデータセンターごとに異なる可能性あり) | 東京の2拠点(JPTY01/JPTY02)でGPUインスタンスとサーバーレスGPU実行環境が稼働 |
料金の払い方 | ドル建ての前払いクレジットから、秒単位で引かれる | 従量課金で、毎月の利用料金を計算して請求(利用規約 第3条) |
支払い方法 | カード、暗号資産、請求書払い(5,000ドル超の取引) | 公式サイトに記載なし(資料請求で確認) |
データの保管場所 | データセンターを選んでデプロイする | 保存先のリージョンを選べ、法令などへの対応を除き、選んだリージョンの外へ移動しない(利用規約 第1条1.4) |
利用開始 | 評価目的なら10ドルから始められる | 申し込みの当日からGPUを使える |
出典:Runpod公式ドキュメント「Billing overview」(2026年11月7日確認)、Runpodプレスリリース(2026年2月6日)、HelloCloud公式サイト・HelloCloud利用規約(2026年11月5日確認)
HelloCloudの公式サイトに載っているGPUインスタンスは、RTX 6000(VRAM 96GB、¥380/時間)とB300(VRAM 288GB、¥1,480/時間)の2種類です。どちらも1インスタンスあたりの参考価格で、税込・税別の記載はありません。通貨とGPUの型番がRunpodと異なるため、この記事では単価の高い・安いを比べていません。
HelloCloudの利用規約では、利用中のサービスの値上げや新たな費用の追加は30日以上前に通知するとしています(第3条)。準拠法は日本法です(第11条)。SLAは、APIのリクエスト成功率について月間稼働率99.9%以上の維持に向けて努力する目標で、保証ではありません。GPU上で実行するプログラムの計算精度や処理時間は対象外です(出典:HelloCloud SLA、2026年11月5日確認)。
公式サイトの導入事例
HelloCloudの公式サイトでは、推論と学習を同じ環境で回す事例と、処理を国内に閉じる事例が紹介されています。
Aimy株式会社(CEO 平野様)は、AIキャラクターとの対話サービスで推論を常時動かしながら、同じ環境でモデルの学習も進めています。
株式会社ラス恋(CEO 山口様)は、会員の個人情報を扱うため推論も国外のサーバーに出せない前提でした。処理を国内に閉じられる点が決め手になり、申し込んだ日のうちに検証を始め、レコメンドのモデルを本番に載せています(出典:HelloCloud公式サイト、2026年11月5日確認)。
ほかの国内GPUクラウドと比べるには
HelloCloud以外の国内GPUクラウドも比べる場合は、上の比較表と同じ5つの軸(GPUを動かす場所、料金の払い方、支払い方法、データの保管場所、利用開始)で、各社の公式サイトの記載を確かめてください。
主な国内サービスの総額・サポート・契約条件は、国内GPUクラウドの料金比較で同じ軸に並べています。
ポイント:
国内のデータセンターでGPUを使いたい場合の選択肢として、HelloCloudは東京の2拠点でGPUインスタンスとサーバーレスGPU実行環境を提供しています。
学習データを国内に置いたままGPUを使いたい方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。LLMの推論やモデルの学習、バッチ処理での活用方法もまとめた資料です。
資料請求(HelloCloudの特徴と料金)
Runpodに関するよくある質問
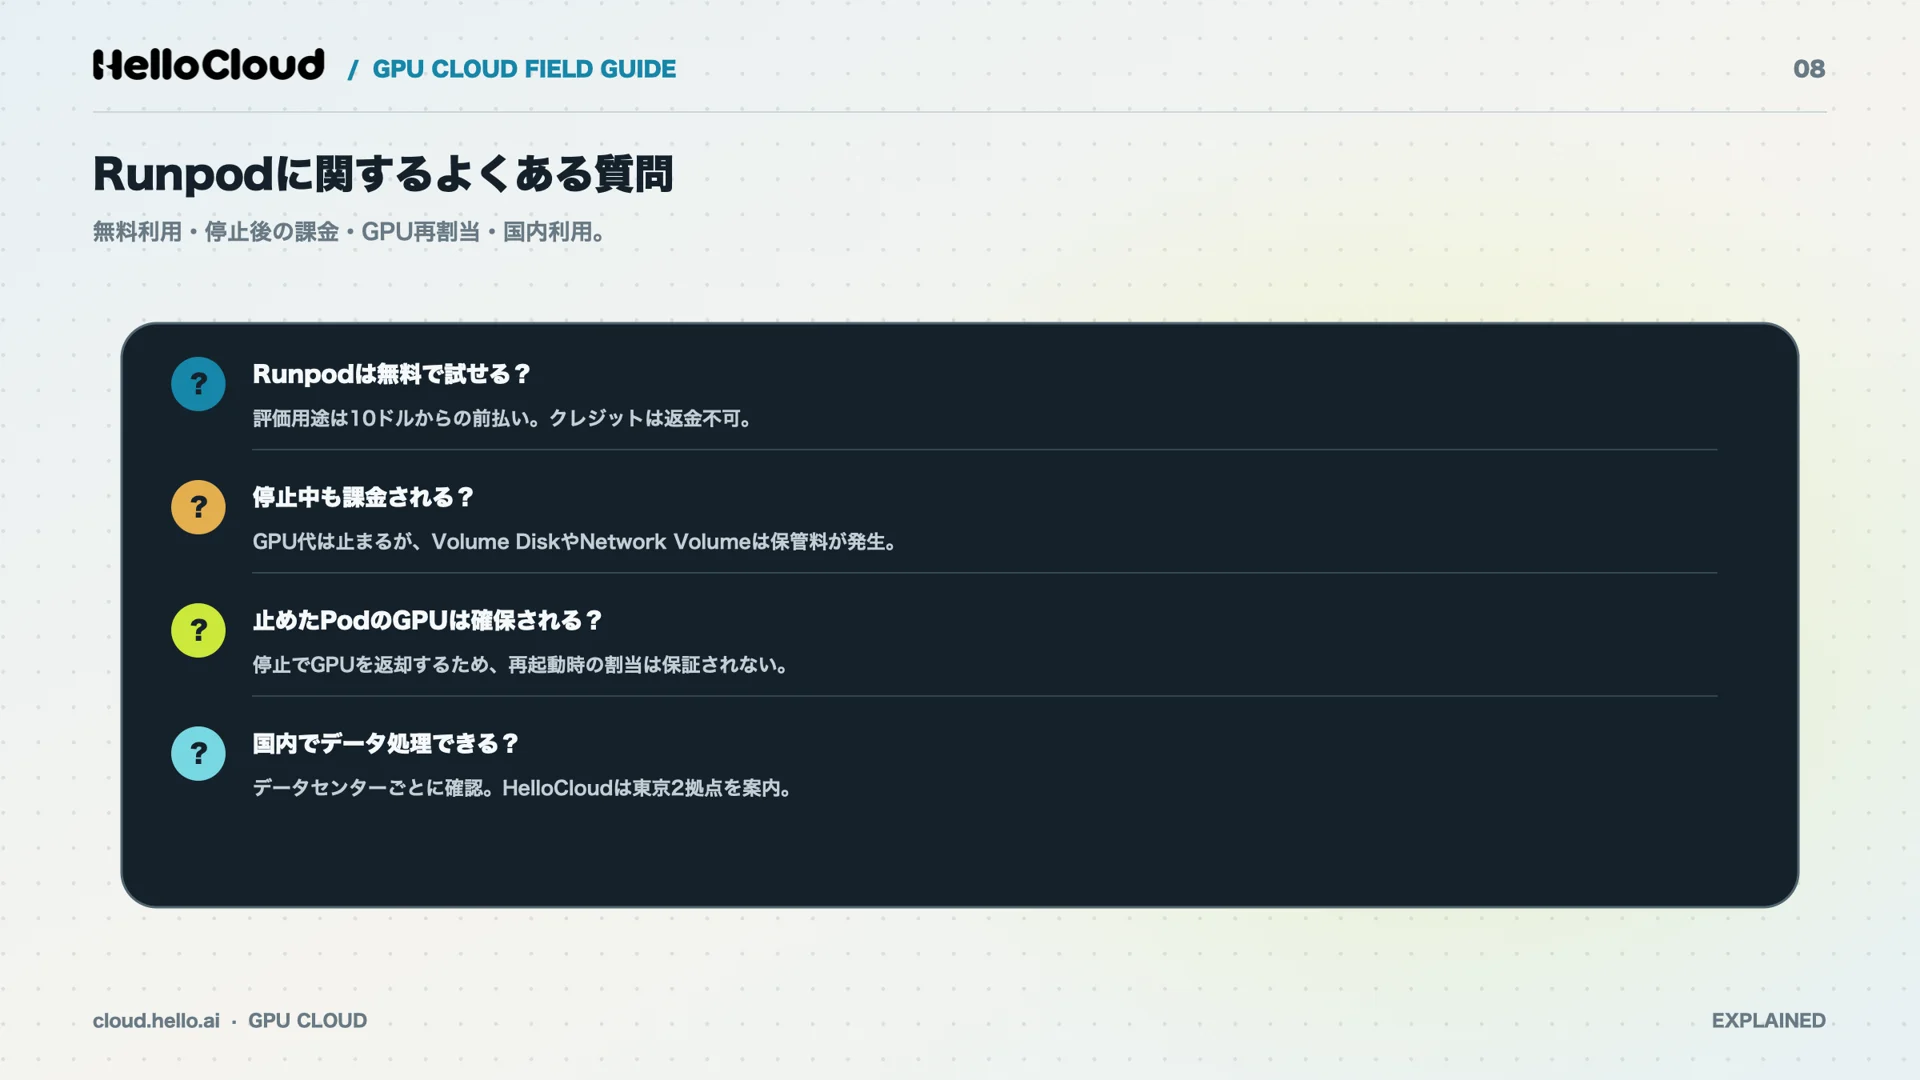
料金・データ・使い分けについての疑問に、公式の記載をもとに答えます。
Runpodは無料で使える?
Runpodは前払いのクレジット制で、公式ドキュメントでは評価目的なら10ドルから始められると案内しています。入金したクレジットは返金できません。試す段階では少額から入れ、停止中のストレージの料金も含めた利用額をBillingのページで確かめてください。
Podを止めている間も料金はかかる?
Podを止めている間も、Volume Diskの保管料(1GBあたり月0.20ドル)やNetwork Volumeの保管料はかかります。GPUの利用料は止まりますが、ストレージの料金まで止めるには、PodのTerminateとNetwork Volumeの削除が必要です。Runpod以外のGPUクラウドで停止中に残る費用は、GPUクラウドの停止中の課金の解説で比べています。
残高がなくなるとデータは消える?
残高が0ドルになると、Network Volumeを付けていないPodは終了し、データは復旧できません。Network Volumeを付けたPodは停止してデータが残る一方、Network Volumeの保管料は発生し続けます。長時間の学習では、途中経過をNetwork Volumeに保存しておきましょう。残高切れでPodが止まっても、データはNetwork Volumeに残ります。
PodsとServerlessはどちらを使えばいい?
学習のように同じGPUを長く使う作業はPods、リクエストが来たときだけ推論を動かす使い方はServerlessが向いています。迷う場合は、GPUを動かす時間の長さと、処理が来るタイミングの2点で選んでください。Podsで推論APIを自分で立てる場合の手順と同時接続数の測り方は、vLLMの使い方の解説で扱っています。
請求書払いはできる?
Runpodの請求書払いは、5,000ドルを超える取引が対象で、利用には営業への問い合わせが必要です。5,000ドル以下の利用は、カードか暗号資産での前払いになります。
Vast.aiやGoogle Colabとの違いは?
Vast.aiやGoogle Colabと比べるときは、課金の単位、停止中のストレージの扱い、支払い方法の3点をそろえて並べてください。Runpodの3点は、この記事の料金と課金の見出しで公式の数字とともに整理しています。
まとめ:Runpodを使う前に確認したい3つのこと
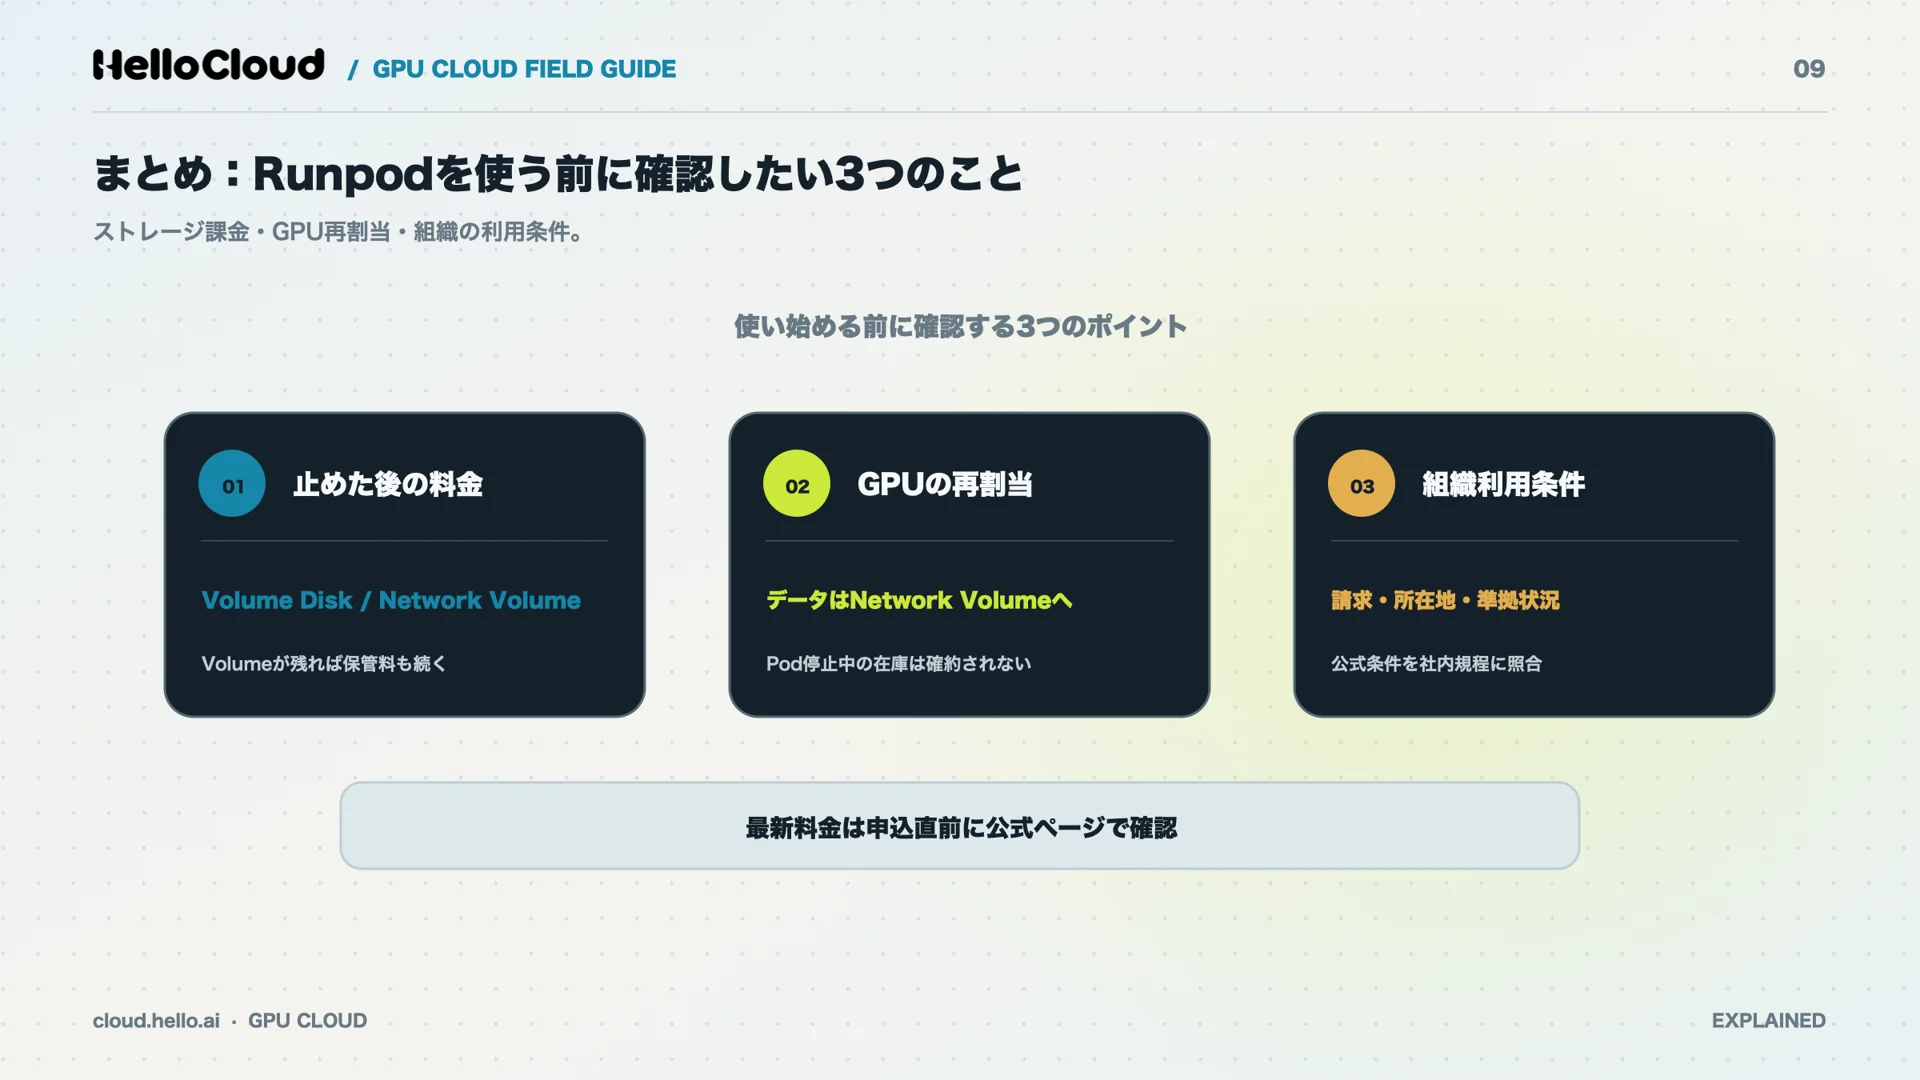
Runpodを使う前に、次の3つを確認してください。
停止中のストレージの料金:Podを止めても、Volume Disk(停止中は1GBあたり月0.20ドル)やNetwork Volumeの保管料は続く仕組みです。
GPUが割り当てられないときの対処と予防:Zero GPUになったら公式の4つの対処から選び、データはNetwork Volumeに置くのが予防策です。
法人で使う場合の支払いとデータの条件:請求書払いは5,000ドルを超える取引が対象で、準拠状況はデータセンターごとに違う可能性があります。
国内でGPUを使える環境を検討している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。LLMの推論やモデルの学習、バッチ処理での活用方法と、料金・導入の進め方をまとめた資料です。
資料請求(HelloCloudの特徴と料金)
Runpodの料金は改定される場合があるため、最新の料金はRunpodの料金ページで確認してください。
引用・参考文献
360iResearch「クラウドGPUレンタル市場:世界市場予測、2026年~2032年」(グローバルインフォメーション)、2026年10月、https://www.gii.co.jp/report/ires2165440-cloud-gpu-rental-market-global-forecast.html
Runpod「Pricing」(料金ページ)、2026年11月4日更新の表示、https://www.runpod.io/gpu-instance/pricing
Runpod公式ドキュメント「Pricing」、2026年11月7日確認、https://docs.runpod.io/pricing
Runpod公式ドキュメント「Billing overview」、2026年11月7日確認、https://docs.runpod.io/accounts-billing/billing
Runpod公式ドキュメント「Zero GPU Pods on restart」、2026年11月7日確認、https://docs.runpod.io/pods/troubleshooting/zero-gpus
Runpod公式ドキュメント「Pod migration」、2026年11月7日確認、https://docs.runpod.io/pods/troubleshooting/pod-migration
Runpod公式ドキュメント「Network volumes」、2026年11月7日確認、https://docs.runpod.io/storage/network-volumes
Runpod公式ドキュメント「Manage Pods」、2026年11月7日確認、https://docs.runpod.io/pods/manage-pods
Runpodプレスリリース「Runpod AI Cloud Surpasses $120M in ARR」、2026年1月、https://www.runpod.io/press/runpod-ai-cloud-surpasses-120m-in-arr
Runpodプレスリリース「Runpod independently verified as meeting HIPAA and GDPR standards」、2026年2月、https://www.runpod.io/press/runpod-meets-hipaa-and-gdpr-standards
Runpodプレスリリース「Runpod Fall 2026 State of AI Compute Report Finds AI Developers Adapting to GPU Crunch」、2026年9月、https://www.runpod.io/press/runpod-fall-2026-state-of-ai-compute
Runpodプレスリリース「Runpod Surpasses $325 Million in ARR, Appoints Brian Erickson as Chief Financial Officer」、2026年10月、https://www.runpod.io/press/runpod-325m-arr-new-cfo
Hu et al.「LoRA: Low-Rank Adaptation of Large Language Models」、2021年6月、https://arxiv.org/abs/2106.09685
株式会社HelloCloud「HelloCloud」公式サイト、2026年11月5日確認、https://cloud.hello.ai/
株式会社HelloCloud「HelloCloud SLA」、2026年11月5日確認、https://cloud.hello.ai/sla/
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


