この記事の結論
Rustだけで学習から推論まで書くならBurn、推論を軽く動かすならCandle、PyTorchの資産を使うならtch-rsが候補です。Rust向けのライブラリはPythonほどそろっていない場合があるため、併用する構成も検討してください。
Rustで機械学習はできる?結論と主な3つの方法
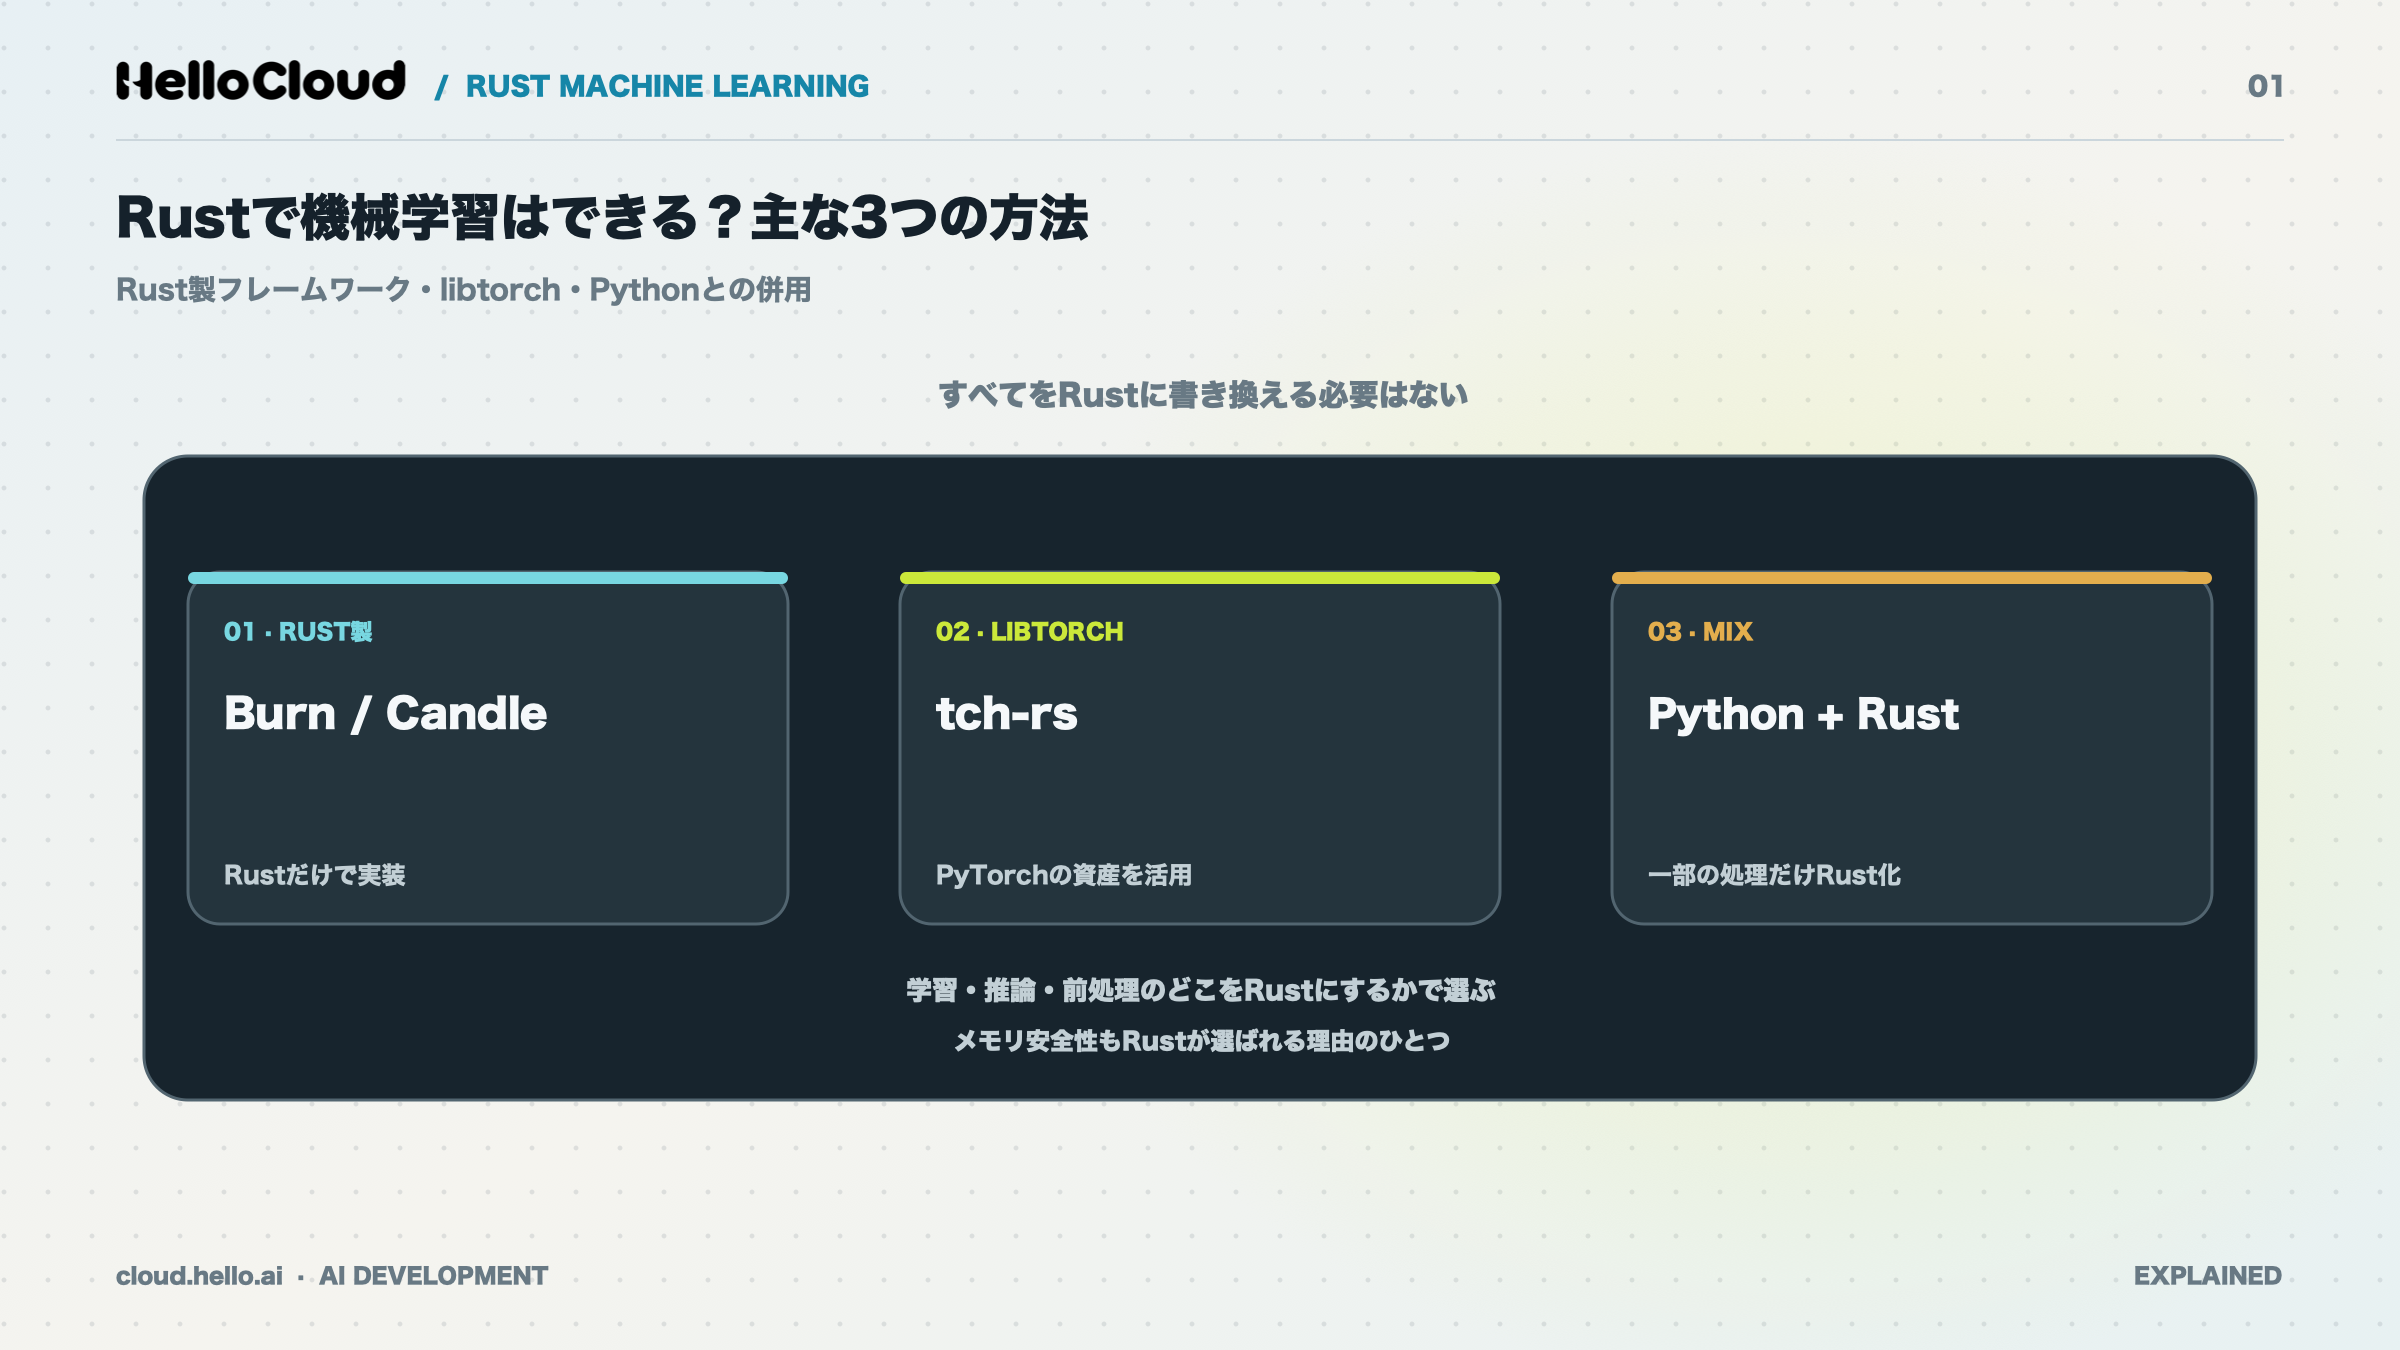
Rustで機械学習をする方法は、Rust製フレームワークを使う、libtorch(PyTorchのC++版ライブラリ)をRustから呼ぶ、Rustで書いた処理をPythonから呼ぶ、の3つです。
Rustで機械学習をする3つの方法
1つ目は、BurnやCandleなどRust製のフレームワークを使う方法で、PyTorchを入れずにRustだけでコードを書けます。2つ目は、tch-rsというクレート(Rustのライブラリ)でlibtorchを呼び出し、PyTorchと同じ計算の仕組みを使う方法です。
3つ目は、前処理や推論など一部だけをRustで書き、Pythonのプログラムから呼び出す方法です。Pythonで作った学習の流れを残したまま、Rustを一部に取り入れられます。
Rustが機械学習で選ばれる理由:安全性と開発効率
Rustが選ばれる理由は、メモリの扱いの不具合をコンパイルの段階で防げる点にあります。Rustの公式サイトは、所有権モデルと型システムがメモリ安全性とスレッド安全性を保証し、多くの種類のバグをコンパイル時に取り除けると明記しています(出典:Rust公式サイト、2026年11月12日確認)。
米国の国家安全保障局(NSA)とサイバーセキュリティ・インフラセキュリティ庁(CISA)は2025年6月、メモリ安全言語の採用を検討するよう促す文書を共同で公開しました。文書では、メモリ安全言語の導入に既存のコードの全面的な書き換えは必要なく、既存のコードと連携させる方法も示しています(出典:NSA・CISAのプレスリリース、2025年6月)。
Googleの公開データでは、Androidで2025年にメモリ安全性に関わる脆弱性が初めて全体の20%を下回り、中・大規模の変更ではRustのロールバック率(変更を取り消す割合)がC++の約4分の1でした。コードレビューにかかる時間も、RustはC++より約25%短い結果です。2025年の数値は、年末の2か月ほど前に集計した暫定値です(出典:Google「Rust in Android」、2025年11月)。
いずれもAndroidの開発での数値で、機械学習で同じ効果が出るとは限りません。
ポイント:
Rustで機械学習をする方法は3つあり、選ばれる理由はメモリの安全性と開発効率です。
Rustの機械学習ライブラリ一覧【2026年11月時点】
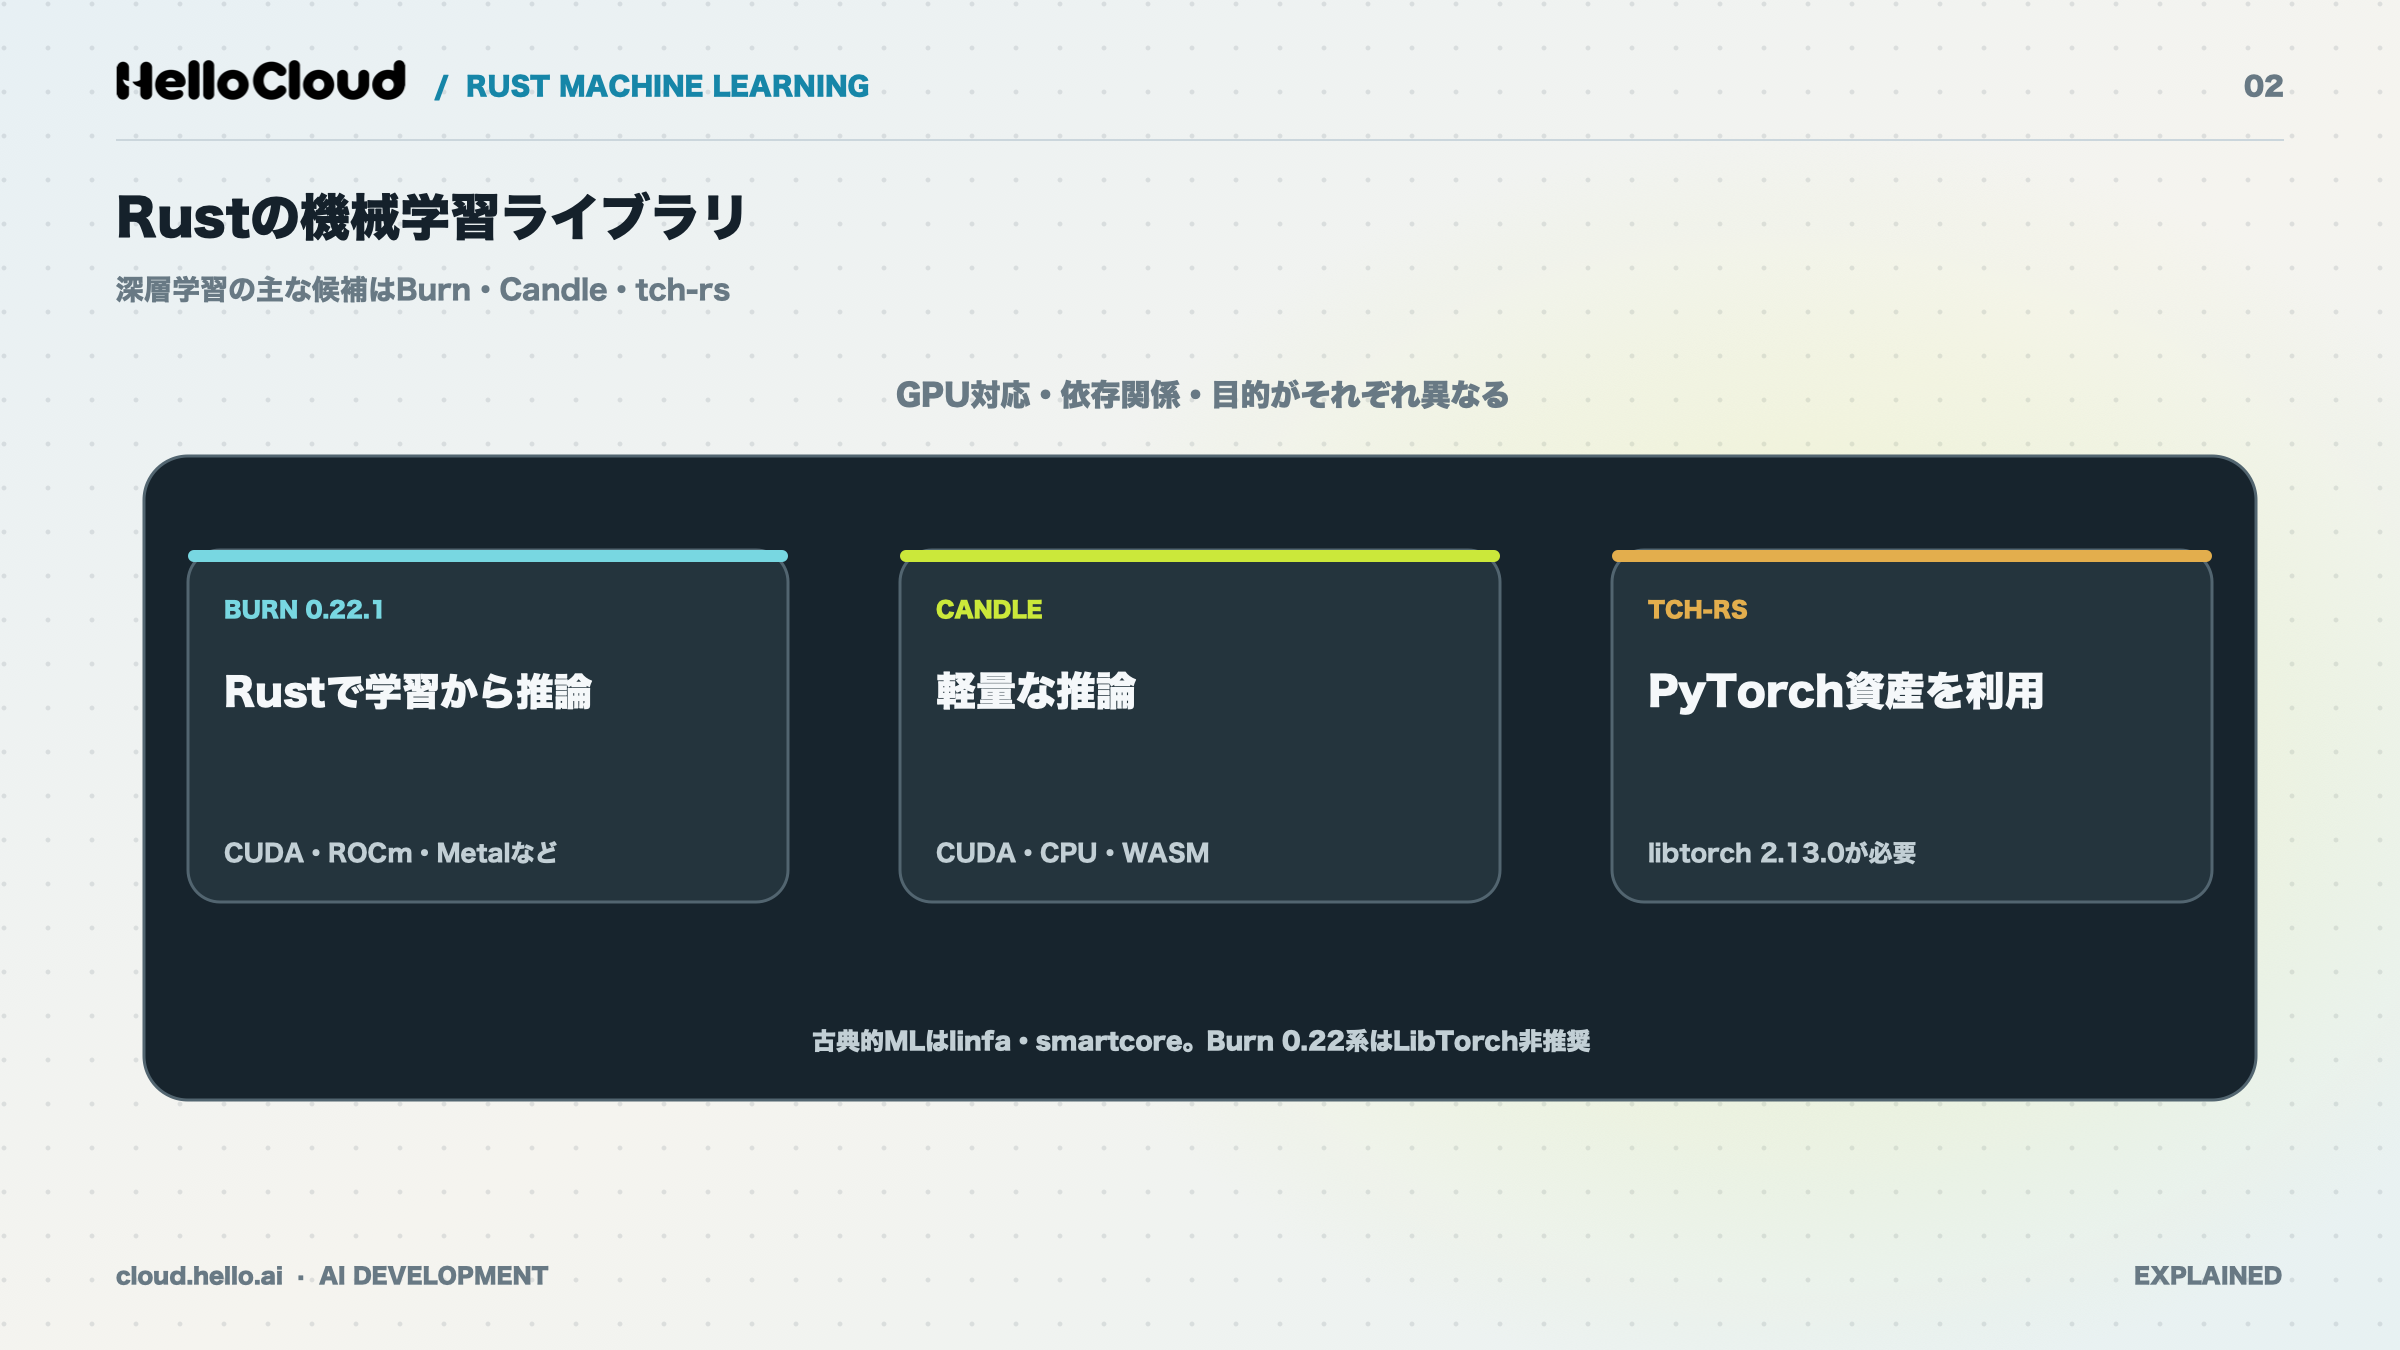
2026年11月時点で、Rustの深層学習の主な選択肢はBurn・Candle・tch-rsの3つです。3つとも、ライセンスはMITとApache License 2.0のどちらかを選べる形で公開されています。仕様はバージョンアップで変わるため、各フレームワークの説明は公式ドキュメントで確認できた内容に絞り、バージョンを添えています。
Burn:学習から推論までRustで書ける
Burnは、Tracel AIが開発する、学習から推論までRustで書ける深層学習フレームワークです。2026年11月12日時点の最新の安定版は0.22.1(2026年10月20日公開)です。libtorchが要らないので、PyTorchを入れていない環境でも学習と推論をRustだけで完結できます。
計算を実行する部分(バックエンド)は、環境に合わせて選ぶ仕組みです。GPUではCubeCLというバックエンドで、CUDA(NVIDIA)・ROCm(AMD)・Metal(Apple)・Vulkan・WebGPUに対応しており、CPUでは、CubeCLのCPUバックエンドと、WASM(ブラウザで動かす仕組み)やno_std(OSなしで動かす設定)にも対応するFlexを使えます。
0.22.0では、PyTorchのライブラリを使うLibTorchバックエンドが非推奨になり、将来削除される予定です。公式ドキュメントには、モデルのコードを変えてもリリースモードで5秒未満で再コンパイルできると書かれています(出典:burn 0.22.1(docs.rs)、2026年10月)。
Candle:Hugging Faceの軽量フレームワーク
Candleは、Hugging Faceが開発する、性能と使いやすさを重視した最小限の機械学習フレームワークです。CPUはx86向けのMKLとmacOS向けのAccelerateに対応し、GPUはCUDAで動かせます。
CUDAバックエンドでは、NCCLという通信ライブラリで複数のGPUに処理を分けることも可能です。WASMにも対応しているため、モデルをブラウザで動かせます(出典:candle(GitHub)、2026年11月12日確認)。
tch-rs:PyTorch(libtorch)をRustから使う
tch-rsは、libtorchをRustから使うためのクレートで、2026年11月時点のREADMEではlibtorch 2.13.0が必要と書かれています。Pythonの環境に入っているPyTorchに、そのままリンクすることも可能です。
一方、CandleのREADMEでは、tch-rsは汎用性が高い反面、torchライブラリ全体を実行時に取り込むと説明されています。実行環境にlibtorchを入れる分、構成は重くなります(出典:tch-rs(GitHub)、2026年11月12日確認)。
古典的な機械学習ならlinfa・smartcore
回帰や分類など深層学習以外の手法を使いたい場合は、linfaやsmartcoreといったクレートがあります。開発の状況は3つのフレームワークと異なるため、使う前に各公式リポジトリで最新版と更新状況を確認してください(出典:linfa(docs.rs)・smartcore(docs.rs)、2026年11月12日確認)。
ポイント:
主な選択肢は、Burn 0.22.1、Candle、tch-rsの3つです。Burnは0.22.0でLibTorchバックエンドを非推奨にしたため、古い記事の手順と違う場合があります。
Rustの機械学習ライブラリの比較と選び方
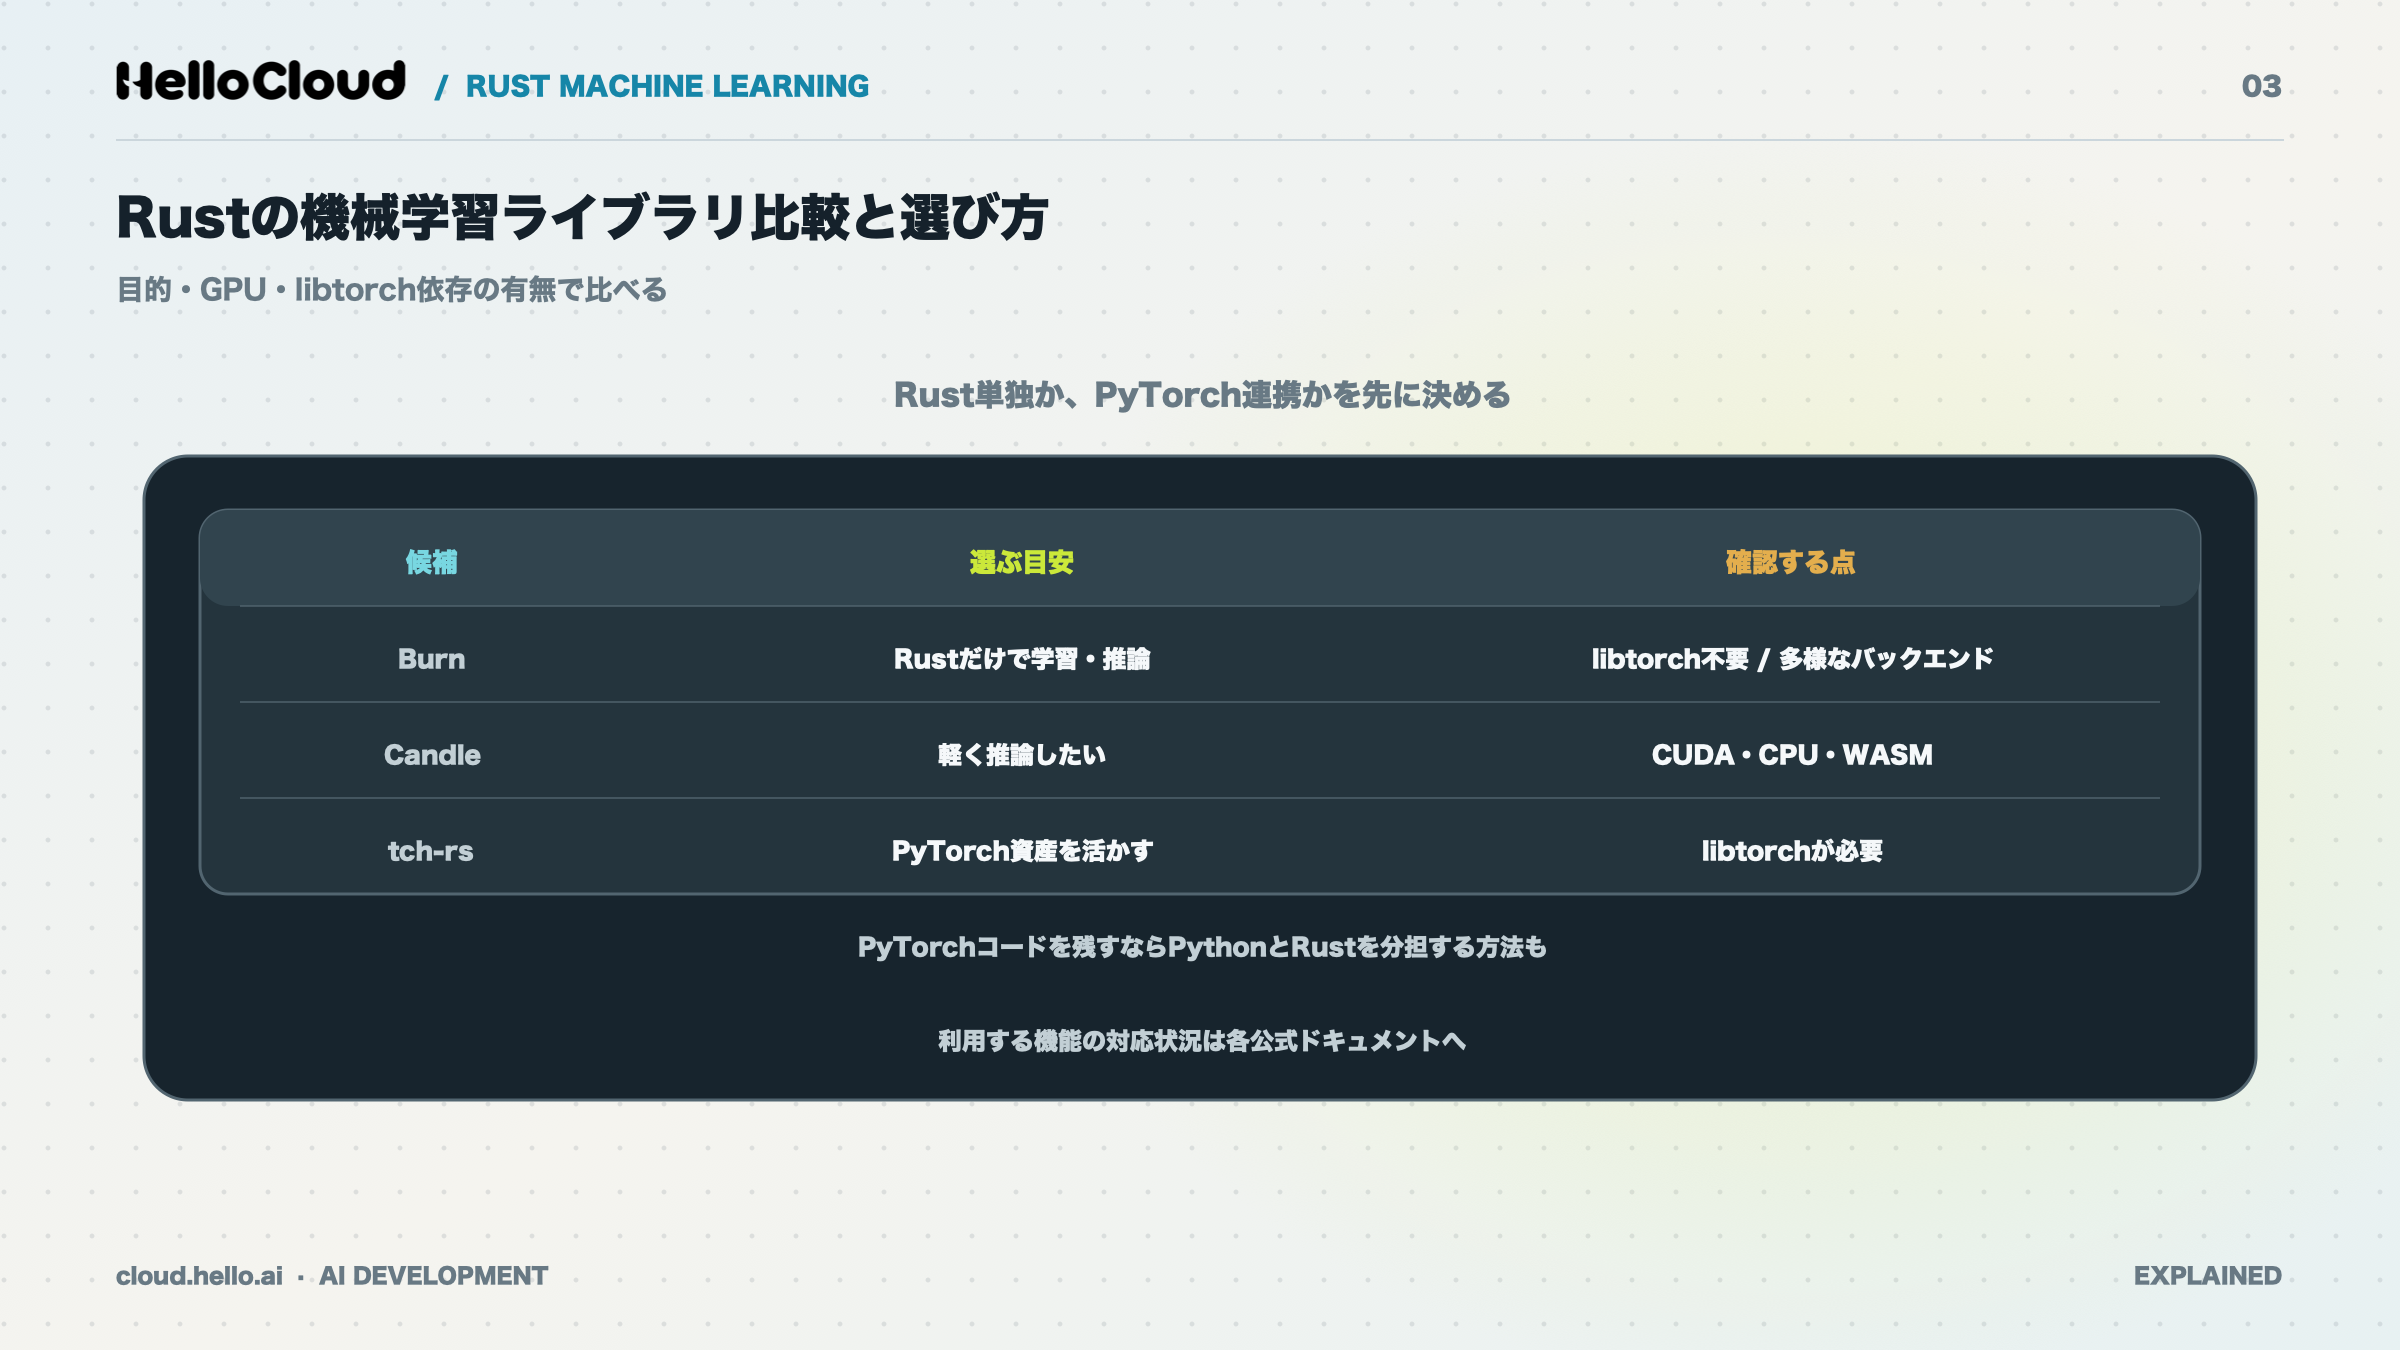
Rustの機械学習ライブラリを選ぶ軸は、PyTorchの資産を使うか、Rustだけで学習まで書くか、推論を軽く動かすかの3点です。3つのフレームワークの違いは、対応するGPUの種類と、libtorchが必要かどうかに表れます。
Burn・Candle・tch-rsの比較表
Burn・Candle・tch-rsを、公式ドキュメントの記載をもとに同じ基準で比べました。
フレームワーク | 開発元 | 対応GPU | CPU・その他の実行先 | 依存関係 | 向く用途 | 注意点 |
|---|---|---|---|---|---|---|
Burn(0.22.1) | Tracel AI | CUDA・ROCm・Metal・Vulkan・WebGPU(CubeCLバックエンド) | CPU(x86・Arm)、Flex(WASM・no_std) | libtorchは不要(LibTorchバックエンドは非推奨) | Rustだけで学習から推論まで書く、NVIDIA以外のGPUやブラウザでも動かす | バージョンアップで仕様が変わることがある |
Candle | Hugging Face | CUDA(NCCLで複数GPUに分散) | CPU(MKL・Accelerate)、WASM | libtorchは不要 | 学習済みモデルの推論を軽く動かす(READMEの機能一覧には学習も記載) | READMEで確認できたGPUバックエンドはCUDA |
tch-rs | Laurent Mazare | CUDA(TORCH_CUDA_VERSIONでCUDA版を指定) | CPU(自動ダウンロードの既定はCPU版) | libtorch 2.13.0が必要 | PyTorchの資産をRustから使う | torchライブラリ全体を実行時に取り込む |
出典:burn 0.22.1(docs.rs)・candle(GitHub)・tch-rs(GitHub)(2026年11月12日確認)
PyTorchの資産を活かすならtch-rsかPythonと併用
PyTorchで作ったモデルやコードを活かすなら、tch-rsを使うか、Pythonと併用する構成が向いています。tch-rsはlibtorchを呼び出すクレートなので、計算の仕組みはPyTorchと同じです。
tch-rsのREADMEでは、LIBTORCH_USE_PYTORCH=1でPythonに入っているPyTorchにリンクする方法も案内しており、Pythonと同じPyTorchを共有できます(出典:tch-rs(GitHub)、2026年11月12日確認)。学習はPythonに残し、推論や前処理だけをRustで書く分け方もできます。Python側のPyTorchを仮想環境に入れる手順は、Minicondaのインストールと仮想環境の作り方で解説しています。
Rustだけで学習から推論まで書くならBurn
Pythonを使わずにRustだけで学習から推論まで書くなら、Burnが第一の候補です。AMD・AppleなどNVIDIA以外のGPUや、ブラウザ・組み込み機器でも動かしたい場合も、CubeCLとFlexのバックエンドを持つBurnが合います。
学習済みモデルの推論を軽く動かすならCandle
学習済みモデルの推論を軽い構成で動かすなら、Candleが向いています。CandleはlibtorchなしでCPU・CUDA・WASMの環境で動く、最小限の構成を重視したフレームワークです。Burnのドキュメントでも、CandleはLLMの推論に重点を置いたプロジェクトとして紹介されています(出典:burn 0.22.1(docs.rs)、2026年11月12日確認)。LLMを多くの同時接続で配信する用途では、推論エンジンのvLLMの使い方と同時接続の測り方も参考にしてください。
ポイント:
PyTorchの資産ならtch-rs、Rustだけで学習まで書くならBurn、推論を軽く動かすならCandleが目安です。libtorchが必要なのは、3つのうちtch-rsだけです。
RustのディープラーニングをGPU(CUDA)で動かす設定
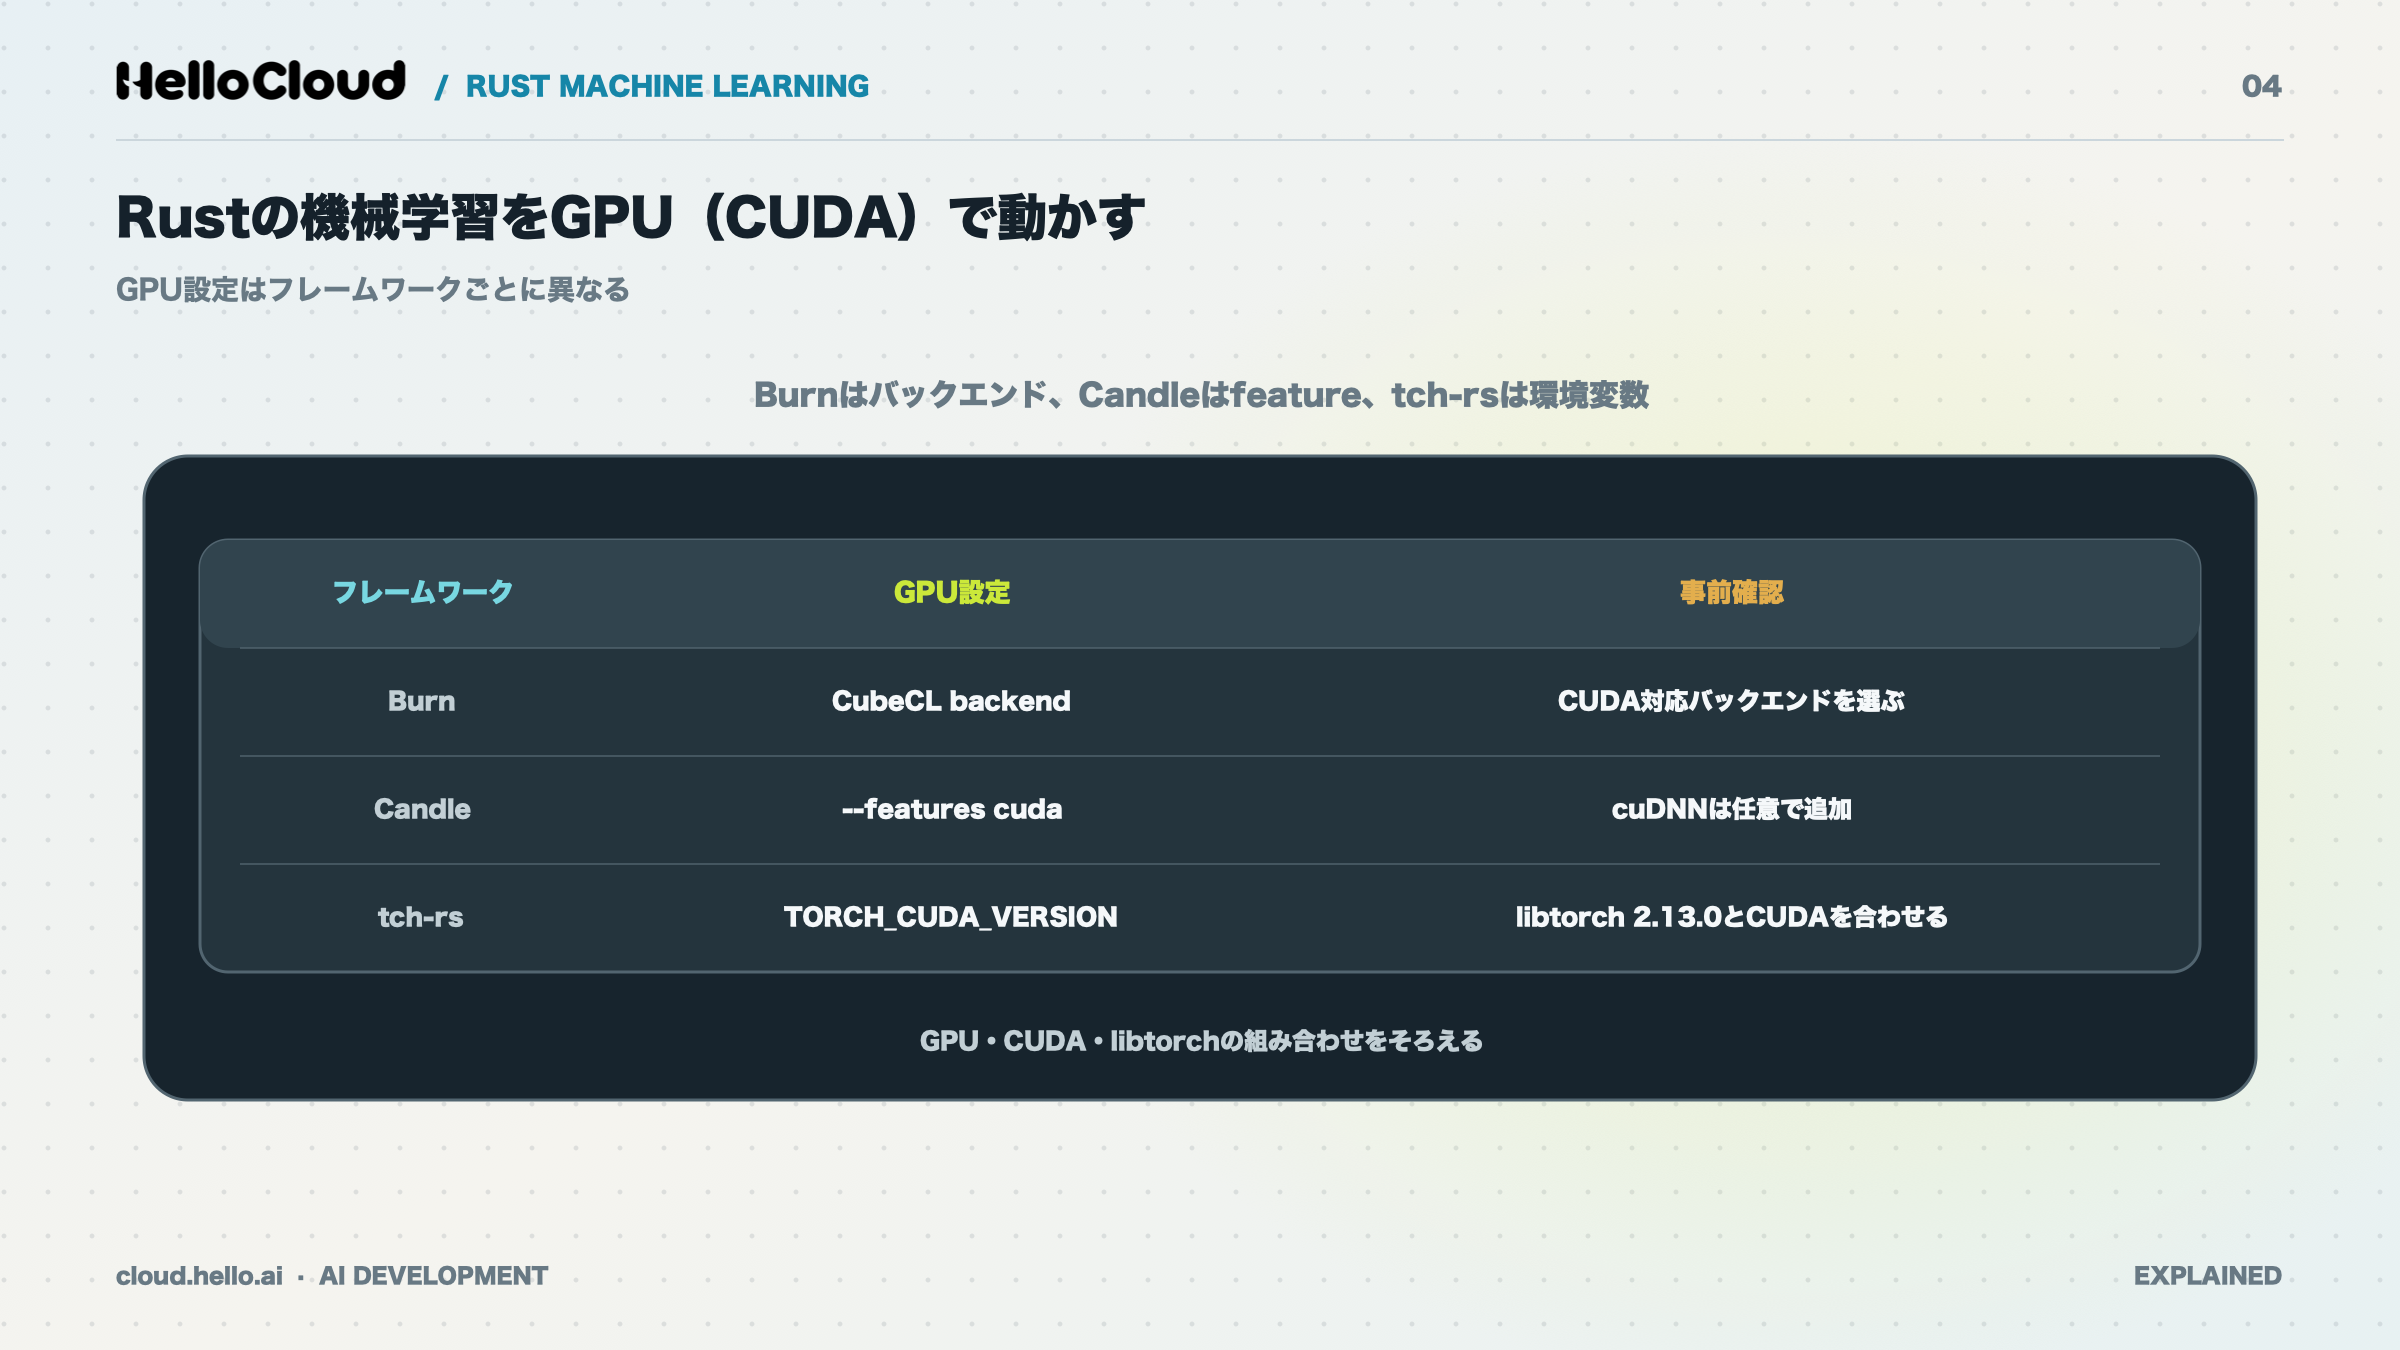
RustのディープラーニングをNVIDIAのGPUで動かすには、フレームワークごとに決められた方法でCUDA(NVIDIA GPUで計算するための開発環境)を有効にします。
フレームワーク | GPUを使う方法 | 事前に必要なもの | 確認したバージョン |
|---|---|---|---|
Burn | CubeCLバックエンド(CUDAなど)を選ぶ | 使うGPUに合ったCubeCLバックエンド | 0.22.1(2026年10月20日公開) |
Candle |
| CUDA(cuDNNは任意) | READMEにバージョンの記載なし |
tch-rs |
| libtorch 2.13.0 | README(2026年11月12日確認) |
出典:burn 0.22.1(docs.rs)・candle(GitHub)・tch-rs(GitHub)(2026年11月12日確認)
Burn:CubeCLバックエンドでCUDAなどを選ぶ
Burnは、使うGPUに合ったCubeCLバックエンドを選ぶとGPUで動きます。
GPUの種類を確認する:NVIDIAならCUDA、AMDならROCm、AppleならMetalです。
CubeCLバックエンドを選ぶ:VulkanとWebGPUは、複数メーカーのGPUに対応しています。
LibTorchバックエンドは新しく使わない:0.22.0で非推奨になり、将来削除される予定です。
Candle:--features cudaとcudnnを付ける
CandleでGPUを使う方法は、サンプルの実行コマンドに--features cudaを付けることです。
CUDAを用意する:NVIDIAのGPUとCUDAが使える環境が前提です。
--features cudaを付けて実行する:サンプルの実行コマンドに加えます。
cuDNNがあれば--features cudnnを使う:cuDNN(深層学習用のNVIDIAのライブラリ)で、さらに速くなるとREADMEで案内されています。
tch-rs:libtorchとTORCH_CUDA_VERSIONを用意する
tch-rsでGPUを使う手順は、libtorch 2.13.0の用意と、環境変数TORCH_CUDA_VERSIONによるCUDA版の指定の2段階です。
libtorchを用意する:
LIBTORCHにパスを設定する、LIBTORCH_USE_PYTORCH=1でPythonのPyTorchにリンクする、download-libtorchフィーチャーで取得する(既定はCPU版)のいずれかです。CUDA版を指定する:
TORCH_CUDA_VERSIONに、使うCUDAの版を設定します。
# tch-rs README(2026年11月12日確認)の例:CUDA 11.7向けを指定する場合
export TORCH_CUDA_VERSION=cu117
動かないときはバージョンの組み合わせを確認する
GPUで動かないときは、最初にバージョンの組み合わせを確認してください。
libtorchのバージョン:tch-rsのREADMEの指定(2026年11月時点で2.13.0)と合っているか
CUDA版の指定:
TORCH_CUDA_VERSIONの値が、使っているCUDAと合っているかフレームワークのバージョン:参考にした手順と、使っているバージョンが同じか
CUDA自体の導入手順は、NVIDIAの公式ドキュメントで確認してください。GPUクラウドでドライバ・CUDA・PyTorchの版をそろえる考え方は、GPUクラウドの環境構築の手順で解説しています。
ポイント:
GPUの設定は、Burnがバックエンドの選択、Candleが--features cuda、tch-rsがTORCH_CUDA_VERSIONです。動かないときは、libtorchとCUDAの組み合わせから確認します。
CUDAとドライバの版の対応は、CUDAのバージョンとドライバの確認手順で解説しています。
Rustで機械学習をするときの注意点・向かない場面
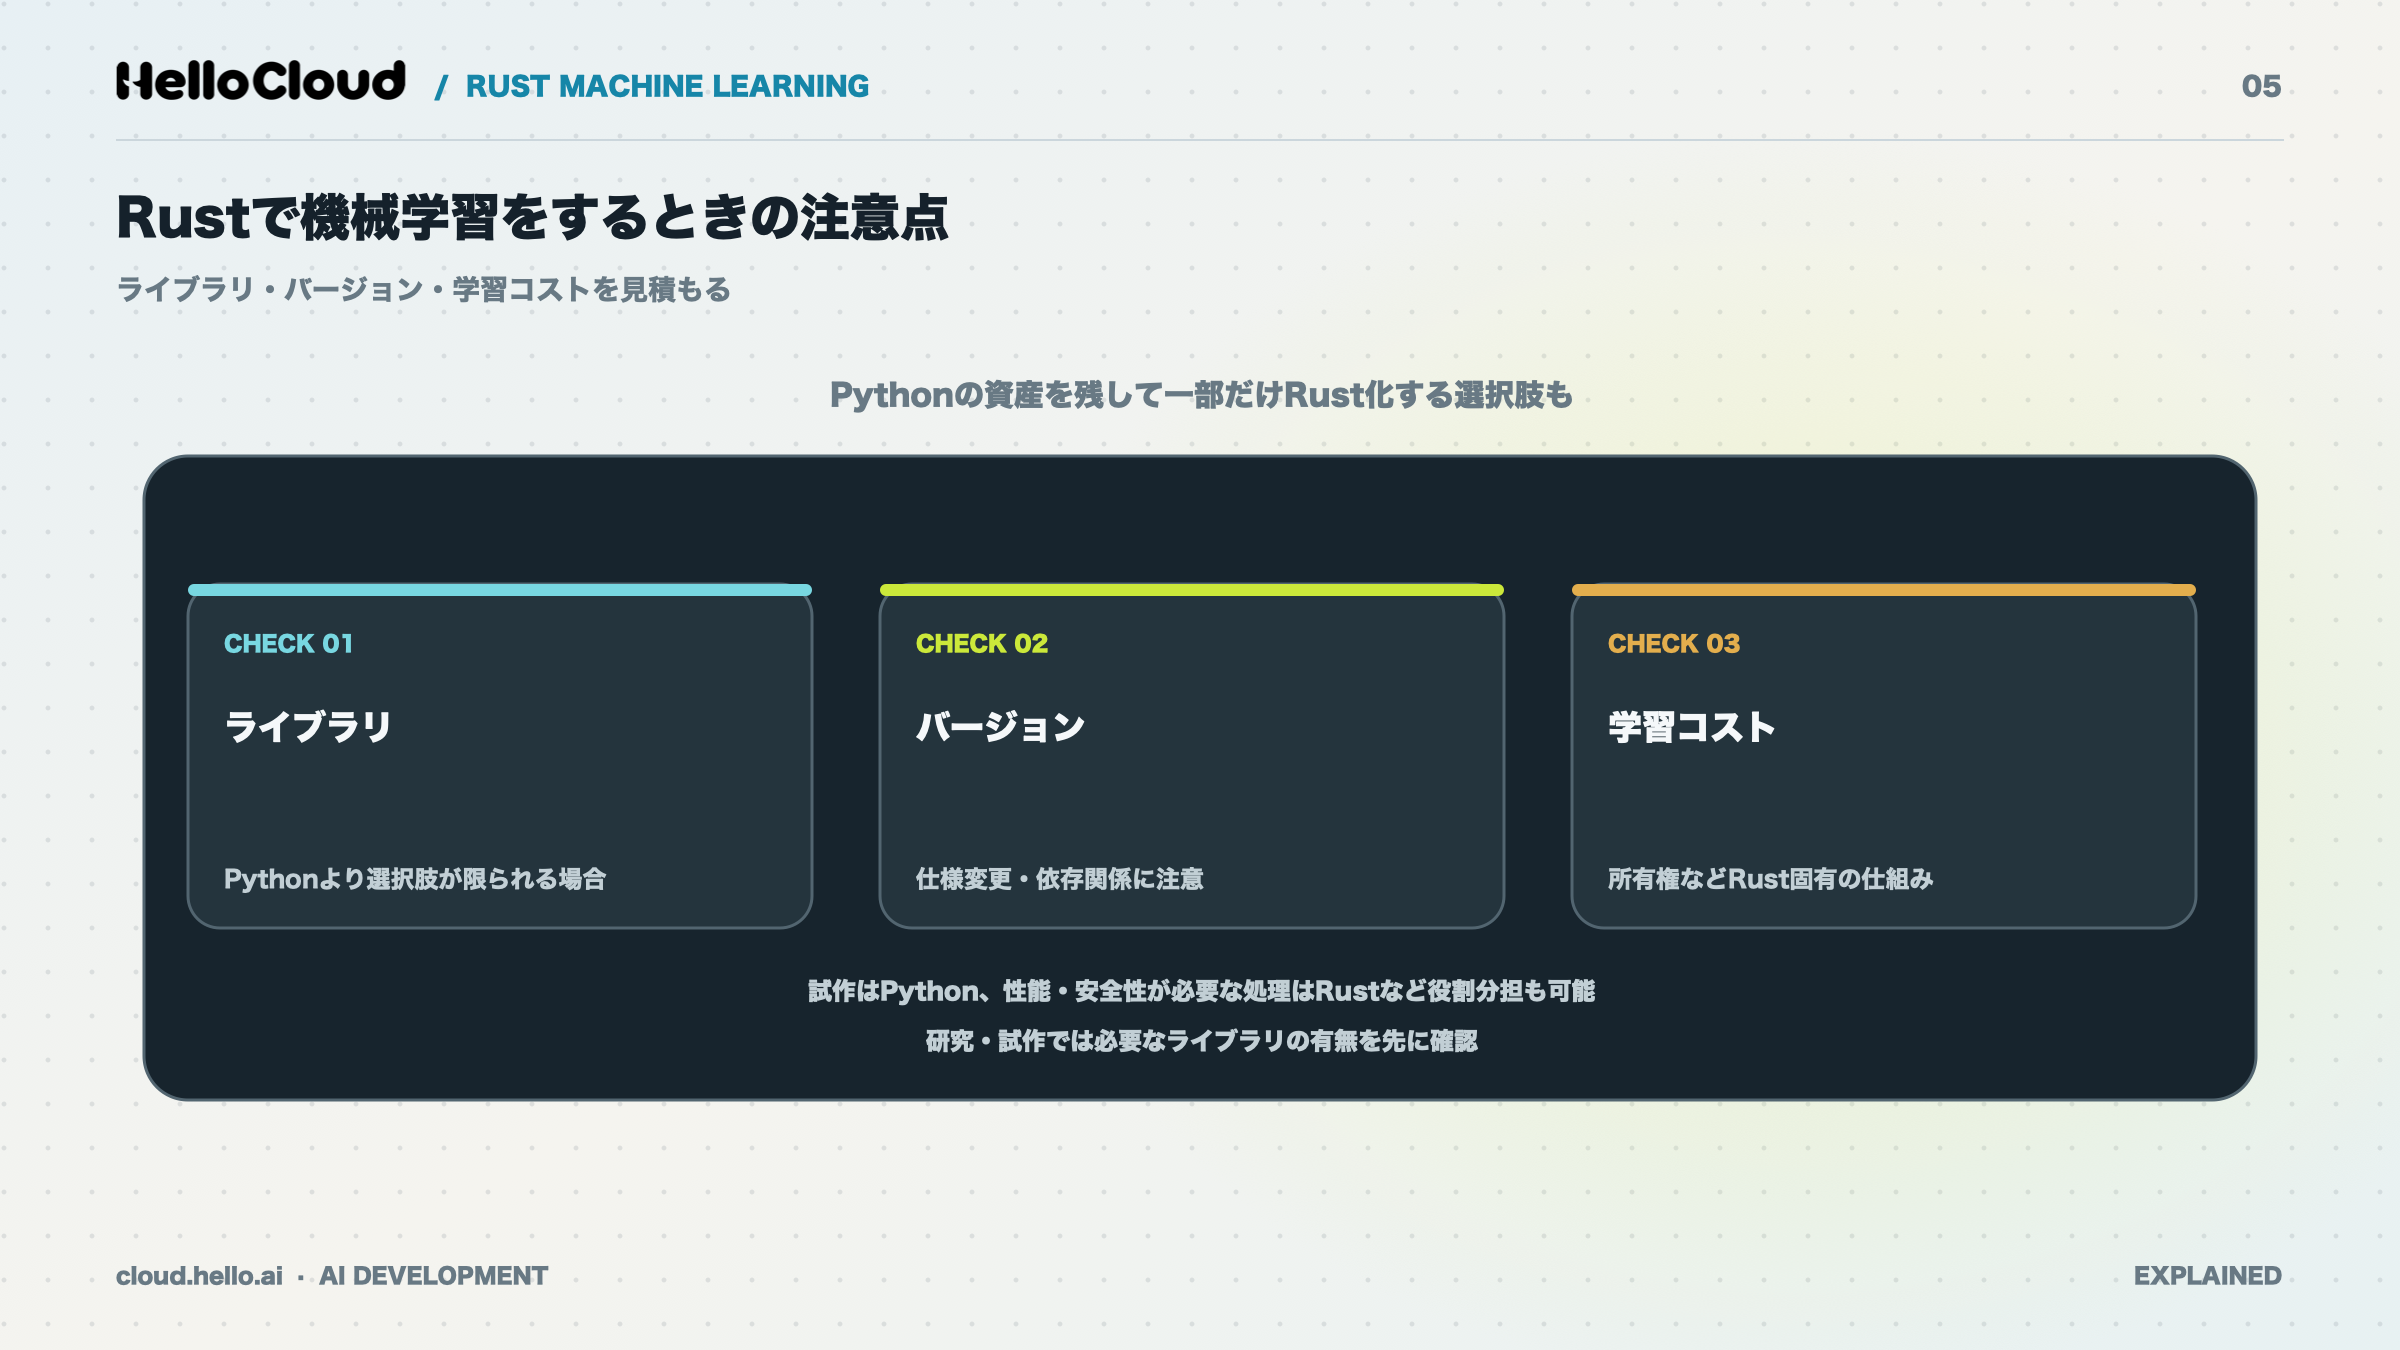
Rustで機械学習をするときの注意点は、Rust向けのライブラリが限られる場合があること、バージョンアップによる仕様の変化、言語の学習コストの3つです。
Rust向けのライブラリや学習済みモデルがない場合がある
Rustの機械学習のエコシステムはPythonに比べて新しく、使いたい手法や学習済みモデルがRust向けに用意されていない場合があります。さまざまな手法を短期間で試す研究や試作では、Pythonと併用する構成も選べます。
Rustが向くのは、推論を組み込み機器やブラウザで動かす場面や、メモリの安全性を重視したい場面です。
バージョンアップで仕様が変わる・バージョン合わせが必要
Rustの機械学習フレームワークは、バージョンアップで仕様が変わることがあります。Burnは0.22.0でLibTorchバックエンドを非推奨にしました。tch-rsはREADMEで指定されたlibtorch(2026年11月時点で2.13.0)に合わせる必要があり、ネットの手順を参考にするときは記事のバージョンも確かめてください。
Rust自体の学習コストが高い
Rustには所有権(メモリを誰が管理するかのルール)という独自の仕組みがあり(出典:Rust公式サイト)、慣れるまでに学習が必要です。Rustの調査チームが2025年11〜12月に行った調査(回答7,156件)でも、言語が複雑になっていくことへの懸念が続いていると報告されました(出典:2025 State of Rust Survey Results、2026年3月)。
ポイント:
Rustでは、使いたいライブラリがあるかの確認と、バージョン合わせ・学習コストへの備えが必要です。試作はPython、推論はRustのように役割で分ける方法もあります。
Rustの機械学習に使うGPU環境の用意の仕方
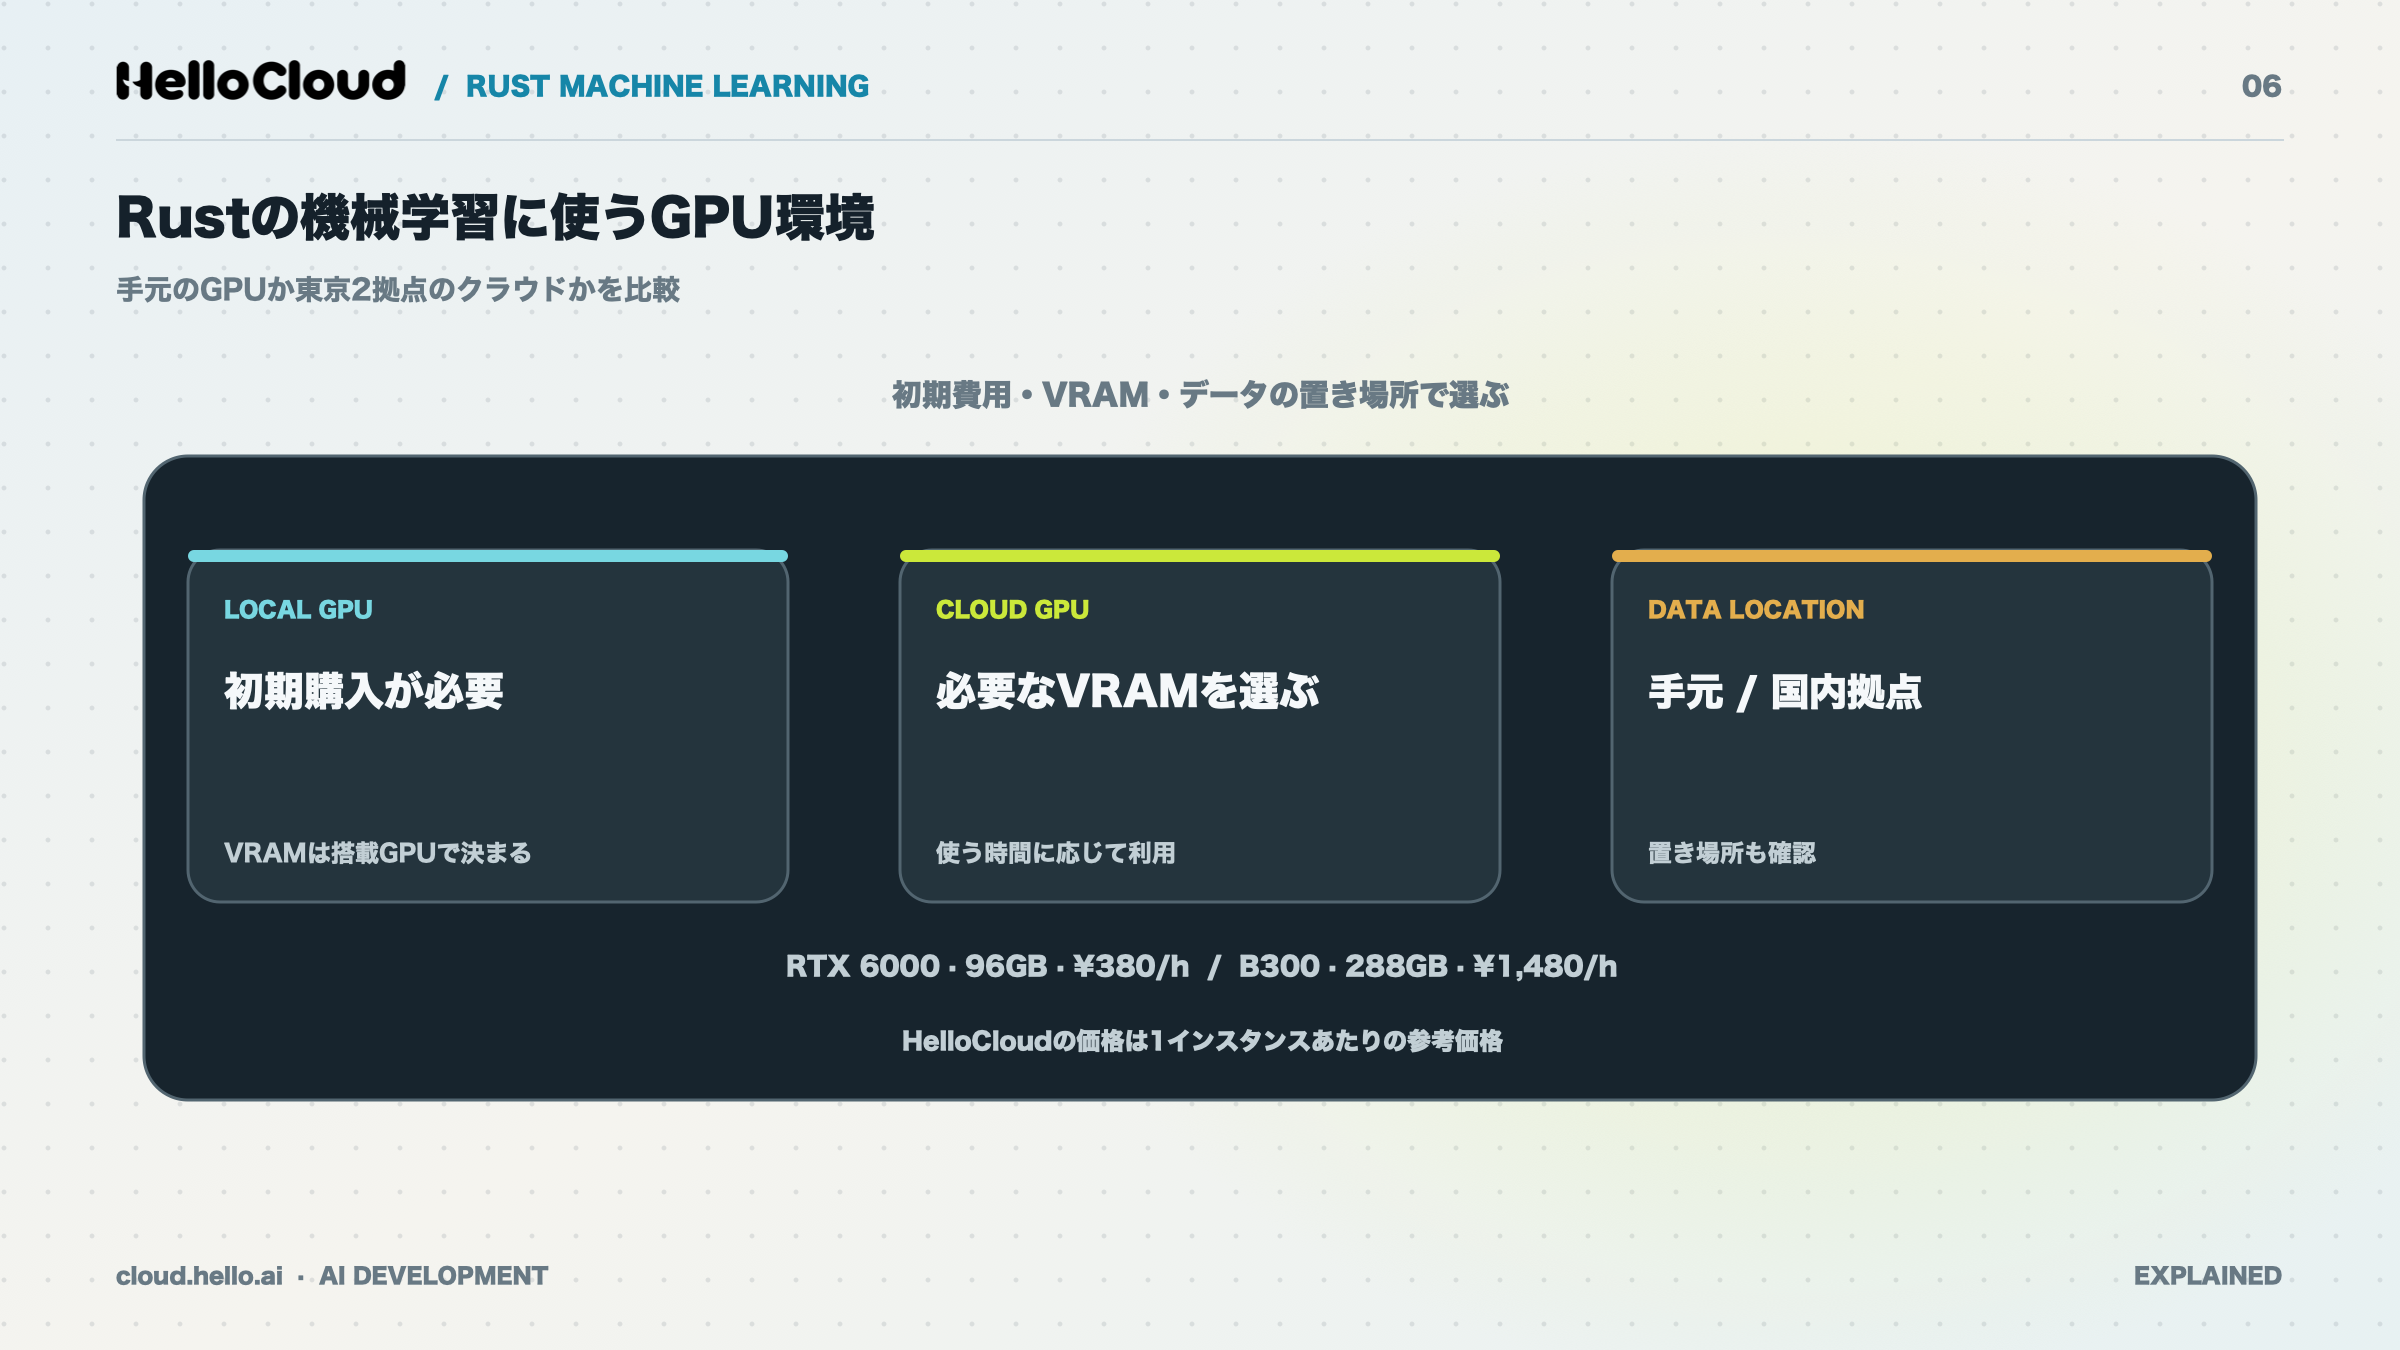
Rustの機械学習を動かすGPUは、手元のPCに用意するか、クラウドで借りるかの2通りです。判断の材料は、初期費用、必要なVRAM(GPUのメモリ)、データの置き場所です。
手元のGPUとクラウドGPUの違い
手元のGPUは購入費がかかり、使えるVRAMは買ったGPUで決まります。クラウドGPUは、インスタンスを選び直せば大きなVRAMも使える点が利点です。動かすLLMに必要なVRAMの見積もり方は、LLMの必要VRAMの計算方法で解説しています。一般的な違いは次のとおりです。
用意の仕方 | 初期費用 | VRAMの上限 | 使い始めるまで | データの置き場所 |
|---|---|---|---|---|
手元のGPU | GPUの購入費がかかる | 買ったGPUで決まる | 購入と設置が必要 | 手元のPC |
クラウドGPU | サービスによる | インスタンスで変えられる | 申し込み後に使える | サービスのデータセンター |
国内のGPUクラウドを使う場合:HelloCloudの例
データを国外に出したくないなら、国内のデータセンターでGPUを使えるクラウドも選択肢の1つです。国産GPUクラウドのHelloCloudは、東京の2拠点でGPUインスタンスとサーバーレスGPU実行環境を提供しています。
GPUインスタンス | VRAM | RAM | vCPU | 参考価格(1時間) | 公式サイトの想定用途 |
|---|---|---|---|---|---|
RTX 6000 | 96GB | 96GB | 16 | ¥380 | 軽量〜中規模LLMの推論、画像や音声のバッチ処理、開発とプロトタイピング |
B300 | 288GB | 384GB | 24 | ¥1,480 | 大規模モデルの学習、高負荷な推論、生成AIの本番運用 |
出典:HelloCloud公式サイト(2026年11月5日確認)
GPUは従量課金で初期費用はかからず、申し込みの当日から利用可能です。サーバーレスGPU実行環境では、GPUの種類と枚数を指定してsupa deployでデプロイすると、指定したGPUでコンテナが起動する仕組みです(出典:HelloCloud公式サイト、2026年11月12日確認)。
公式サイトによると、VMのOSイメージにはGPUのドライバーとCUDAがインストールされています。バージョンは公式サイトに記載がないため、資料請求か問い合わせ(support@supa.ai)で確認してください。
注意:
表の料金は「1インスタンスあたりの参考価格」で、税込・税別の記載はありません。SLAは月間稼働率99.9%以上の維持に向けた努力目標で、保証ではありません(出典:HelloCloud SLA)。
公式サイトに掲載されている導入事例は、次の2社です(出典:HelloCloud公式サイト)。
株式会社ラス恋(CEO 山口様):会員の個人情報を扱うため推論も国外のサーバーに出せない前提で、処理を国内に閉じられる点が決め手になり、申し込んだ日のうちに検証を始め、レコメンドのモデルを本番に載せている。
Aimy株式会社(CEO 平野様):推論を止められないAIキャラクターとの対話サービスで、国内のGPUで推論を常時動かしながら、同じ環境でモデルの学習まで進めている。
データを国外に出さずにGPUで学習・推論したい方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。GPUインスタンスとサーバーレスGPU実行環境は、東京の2拠点で稼働しています。
資料請求(HelloCloudの特徴と料金)
ポイント:
GPU環境を選ぶ基準は、初期費用・VRAM・データの置き場所の3つです。
Rustの機械学習でよくある質問
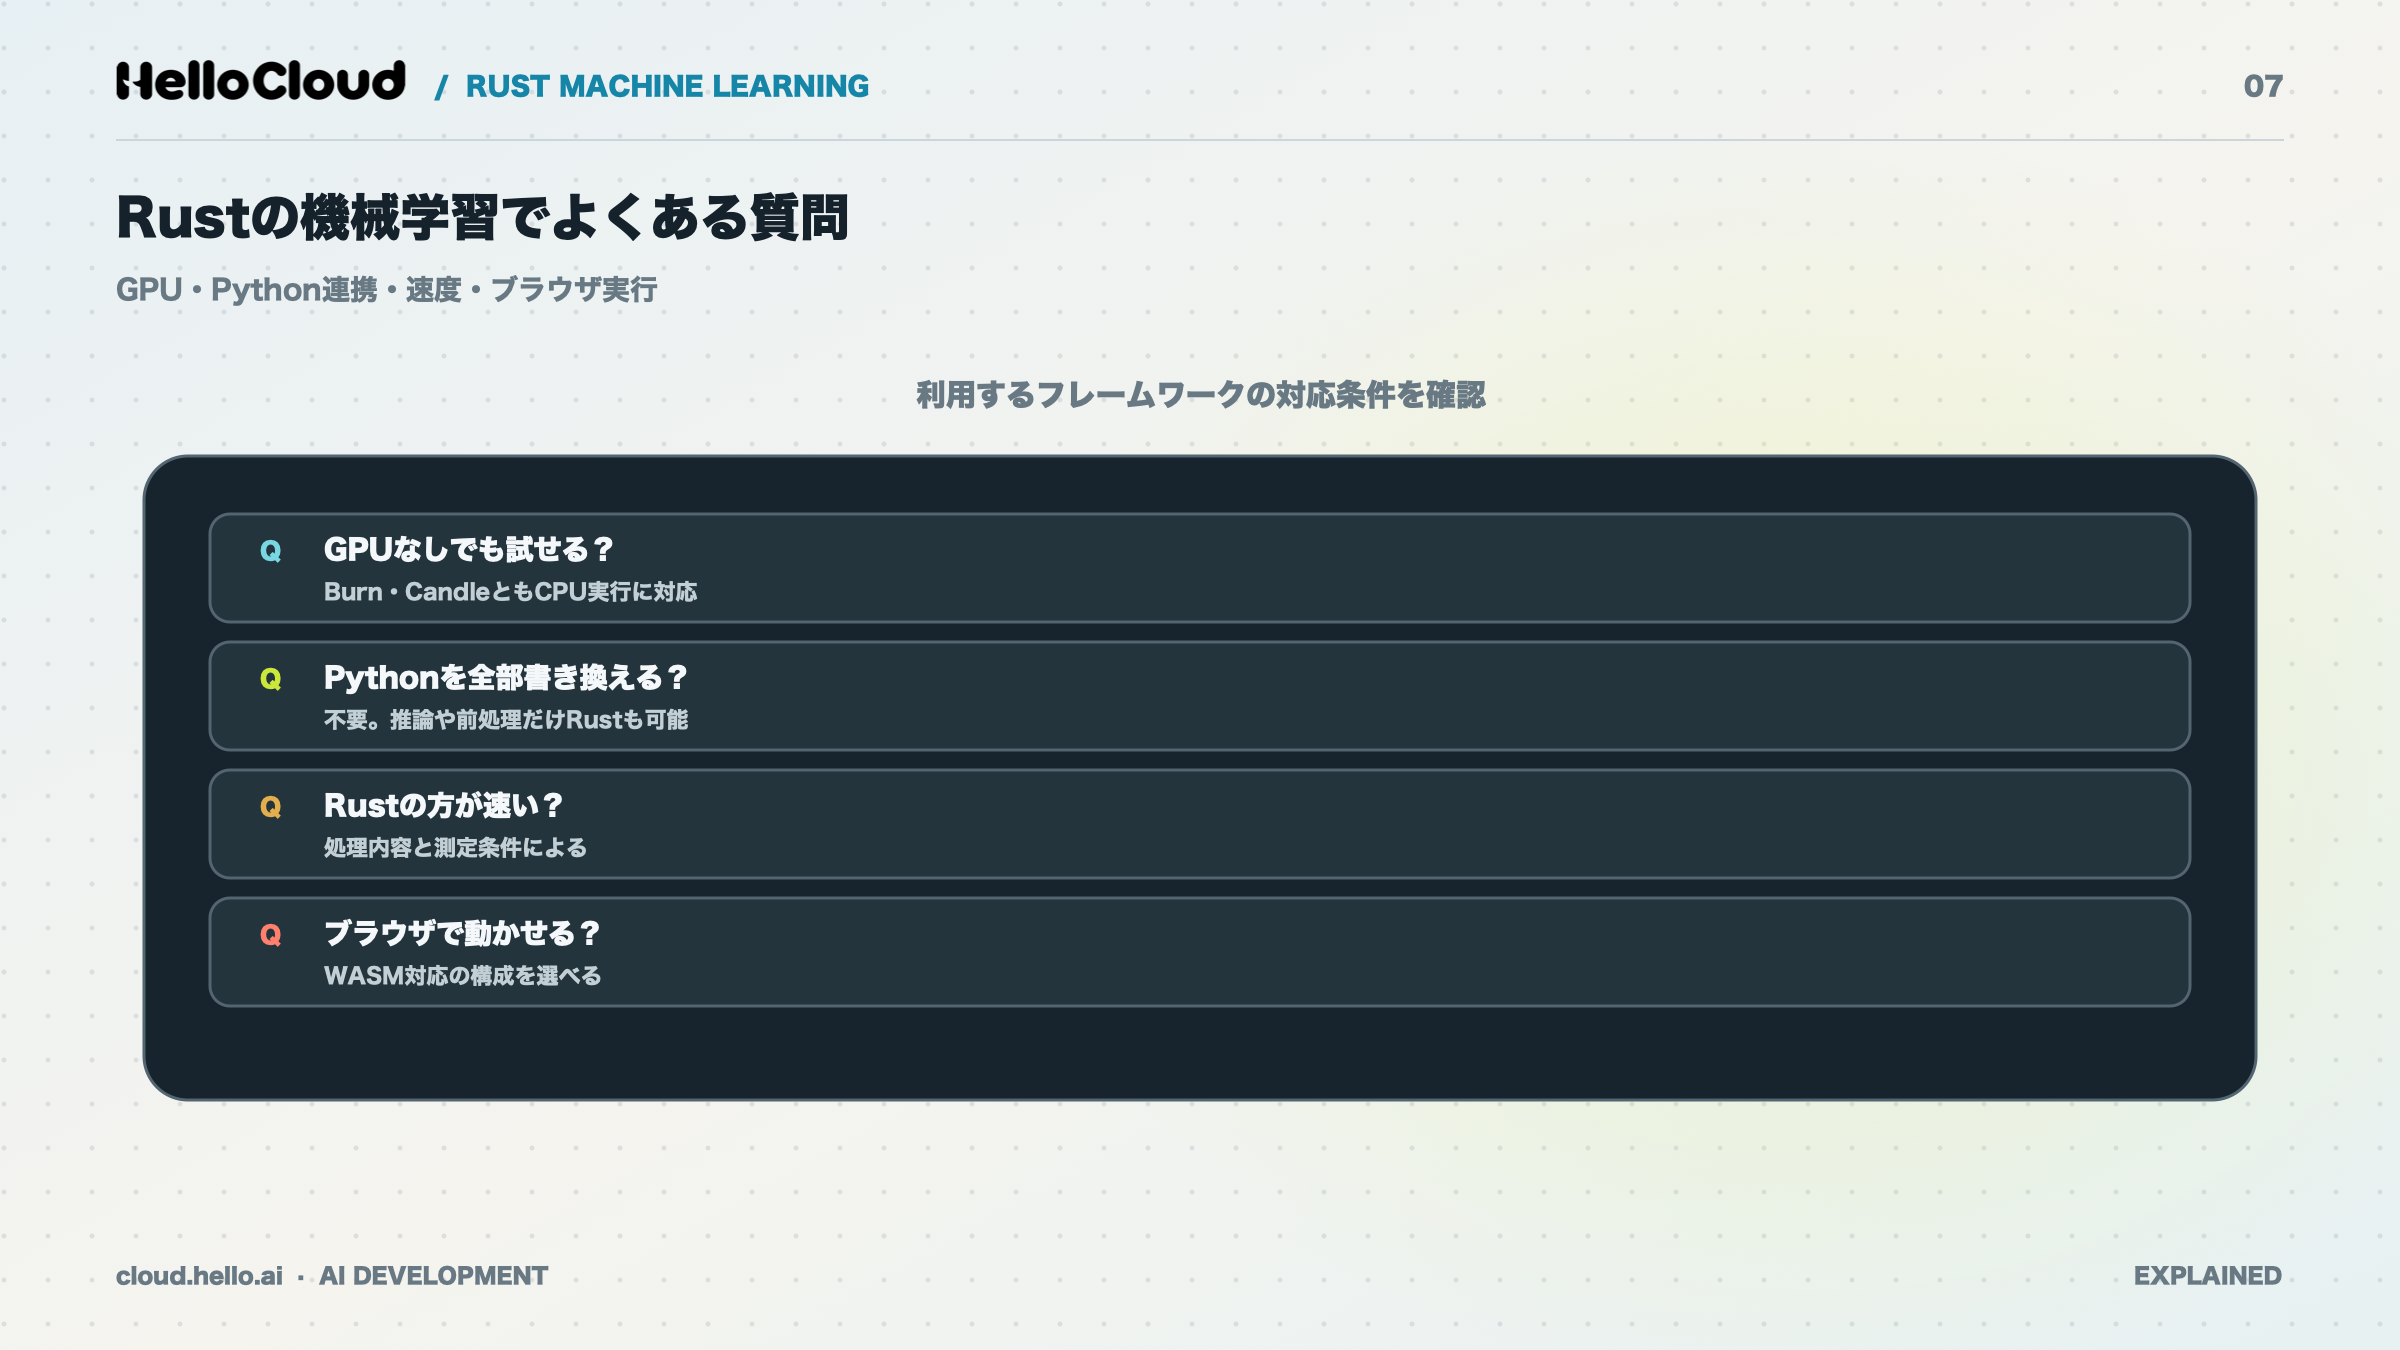
RustはPythonより機械学習の処理が速い?
RustがPythonより速いかどうかは、処理の内容と測定条件によって変わるため、一律には言えません。比べるなら、同じモデル・データ・GPUの条件で測定してください。
既存のPythonコードは書き換えが必要?
既存のPythonコードを、すべてRustに書き換える必要はありません。学習はPythonに残し、推論や前処理だけをRustで書く分け方もできます。tch-rsを使えば、PythonのPyTorchにリンクして使うことも可能です。
AI開発でPythonが中心に使われている理由は、AI開発の言語とGPU環境で解説しています。
GPUがなくてもRustで機械学習はできる?
GPUがなくても、CPUだけでRustの機械学習は試せます。BurnにはCubeCLのCPUバックエンドとFlexがあり、CandleもCPU(MKL・Accelerate)で動くフレームワークです。
Rustでディープラーニングはできる?
Rustでディープラーニングの学習と推論はできます。Burnは学習から推論までRustで書けるフレームワークです。Candleは推論を軽く動かす用途に向き、READMEでは学習にも対応すると案内されています。
Burnの最新バージョンは?
2026年11月12日時点のBurnの最新の安定版は0.22.1で、2026年10月20日に公開されました。次の0.23.0はプレリリース版が公開されている段階のため、使う前にdocs.rsで確認してください。
Rustの機械学習モデルはブラウザで動かせる?
Rustの機械学習モデルは、WASMを使えばブラウザで動かせます。BurnはFlexバックエンドで、CandleもREADMEでWASMへの対応を案内しています。
まとめ:Rustで機械学習を始めるときの判断の順番
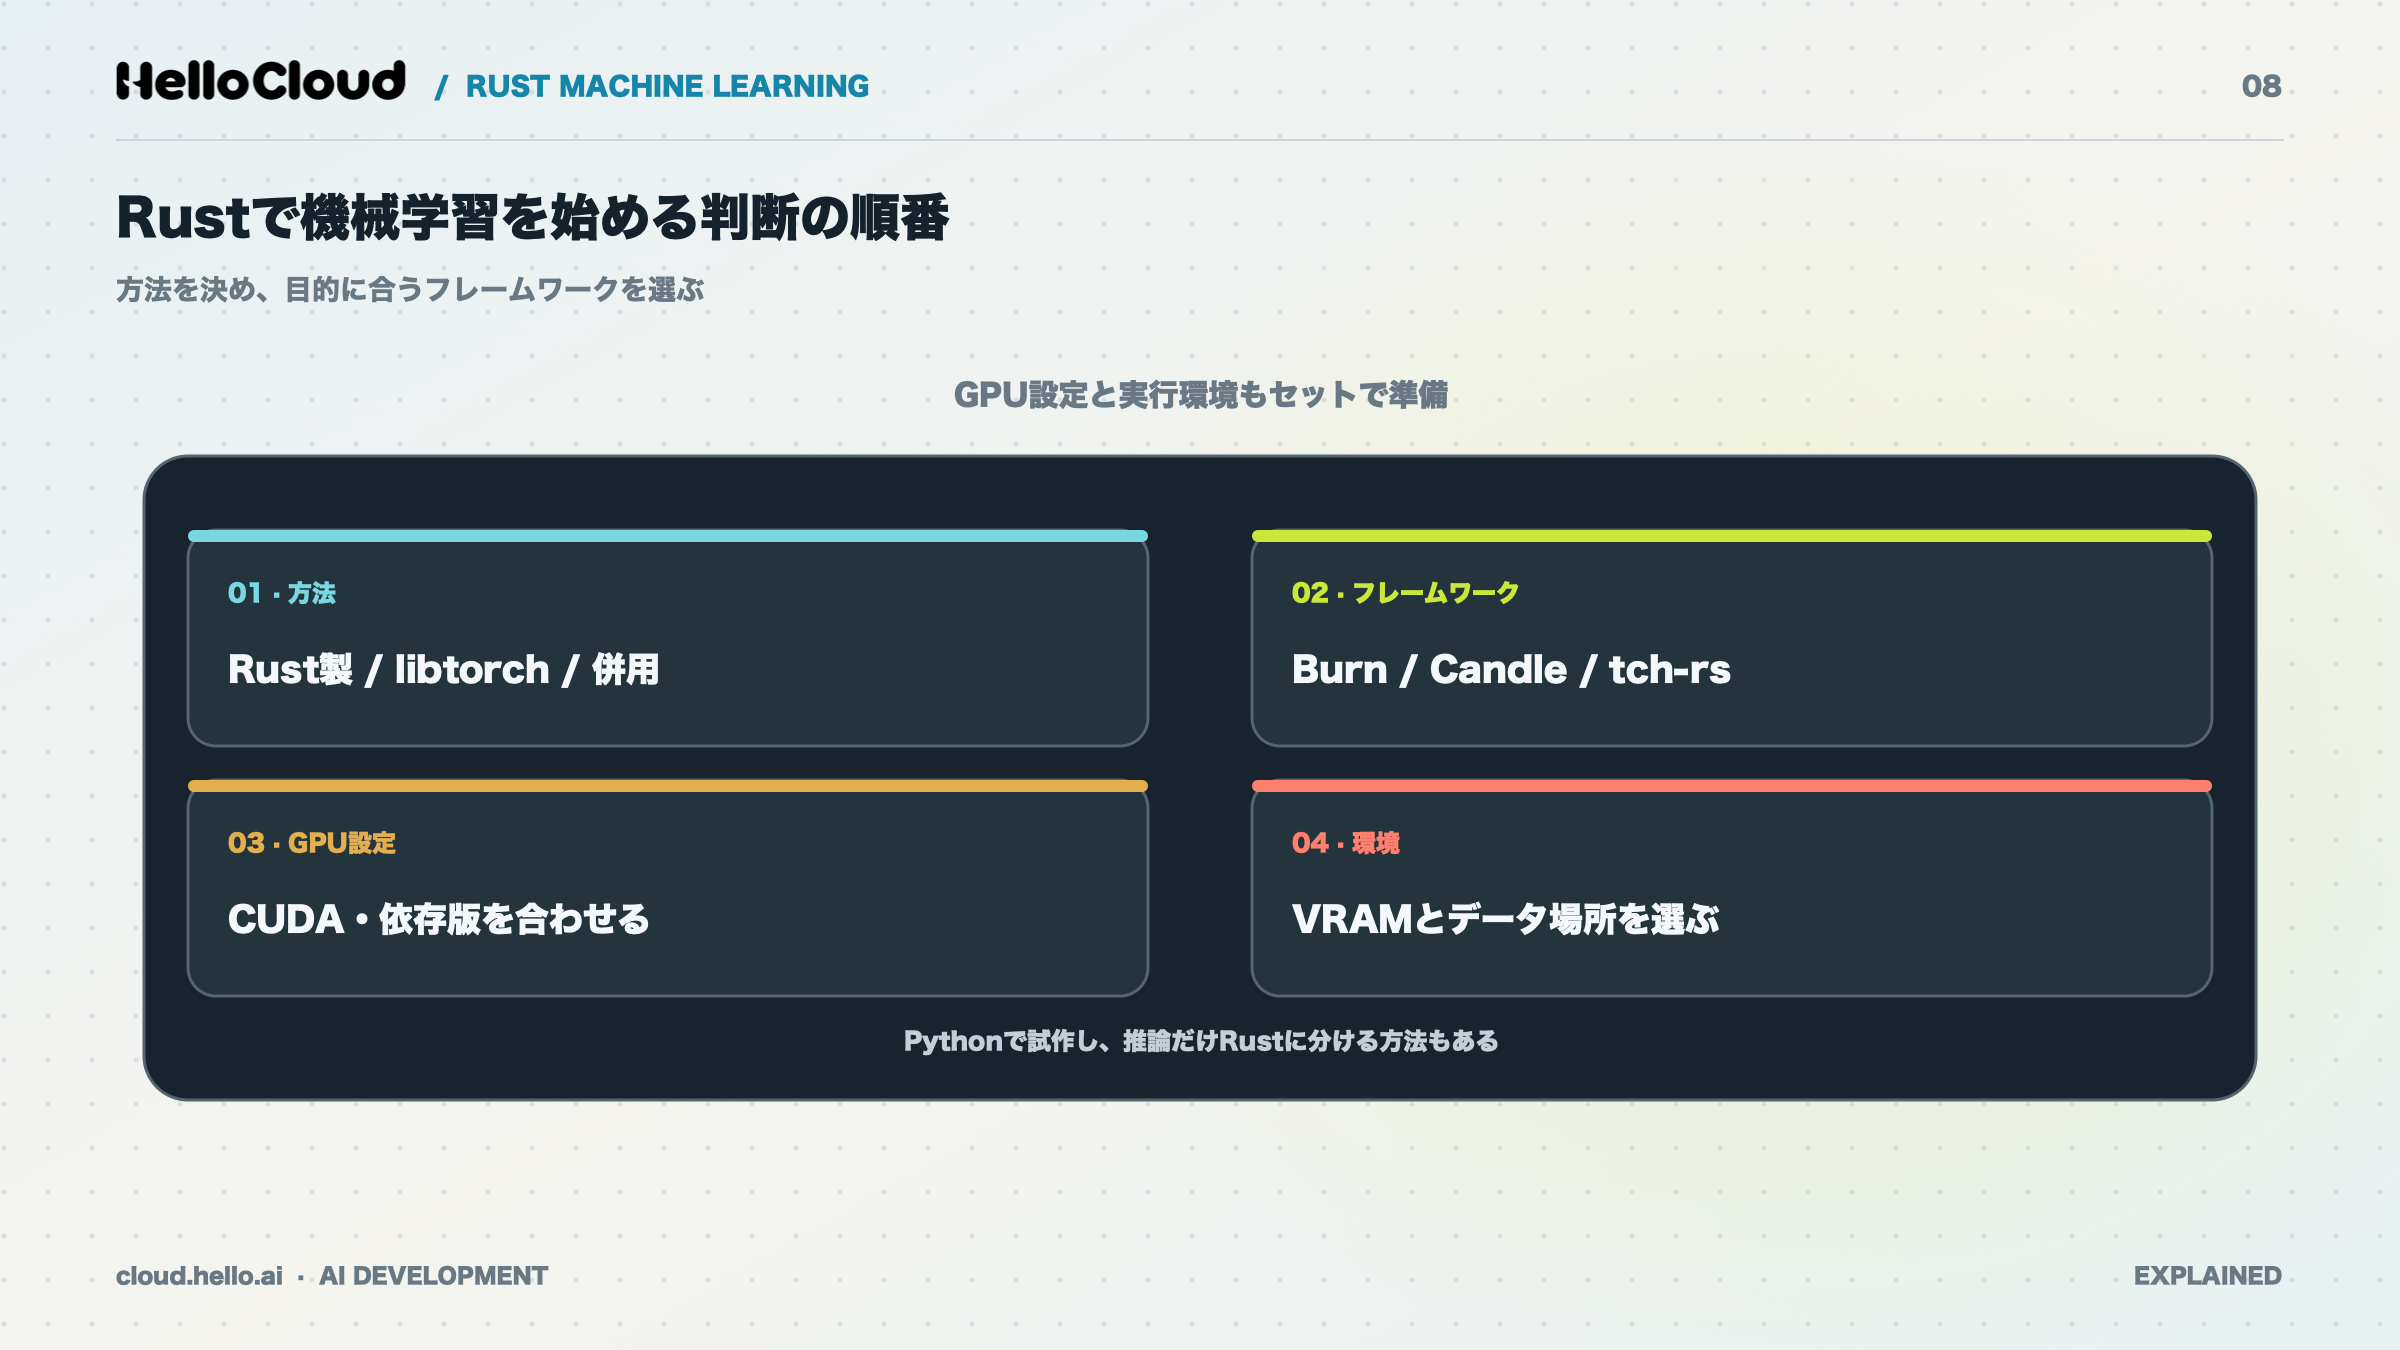
判断の順番は、次の4段階です。
方法を決める:Rust製フレームワーク・libtorch・Pythonとの併用
フレームワークを選ぶ:学習まで書くならBurn、推論ならCandle、PyTorchの資産ならtch-rs
GPUの設定を確認する:バックエンド・
--features cuda・TORCH_CUDA_VERSION役割を分ける:試作はPython、推論はRustという構成も検討
GPUで動かす環境を探している方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。資料では、LLM推論・モデル学習・バッチ処理での活用方法も紹介しています。
資料請求(HelloCloudの特徴と料金)
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


