最終確認日:2026年11月17日(CUDA Toolkit 13.5時点)
この記事の結論
CUDAはNVIDIAのGPUで並列計算をするための開発基盤で、2026年11月時点の最新版はCUDA Toolkit 13.5です。クラウドGPUで使うときは、GPUのCompute Capability、ドライバ版、CUDAの版の順に確認します。
CUDAとは?NVIDIAのGPUで並列処理をする開発基盤
CUDAは、NVIDIAのGPUを描画以外の計算にも使えるようにする開発基盤で、2007年に公開されました。NVIDIAの年次報告書によると、CUDAとNVIDIAのその他のソフトウェアツールを使う開発者は世界で750万人を超えます(Form 10-K、2026年2月提出)。750万人は、CUDA単独の利用者数ではありません。
GPUの並列処理で計算を速くする仕組み
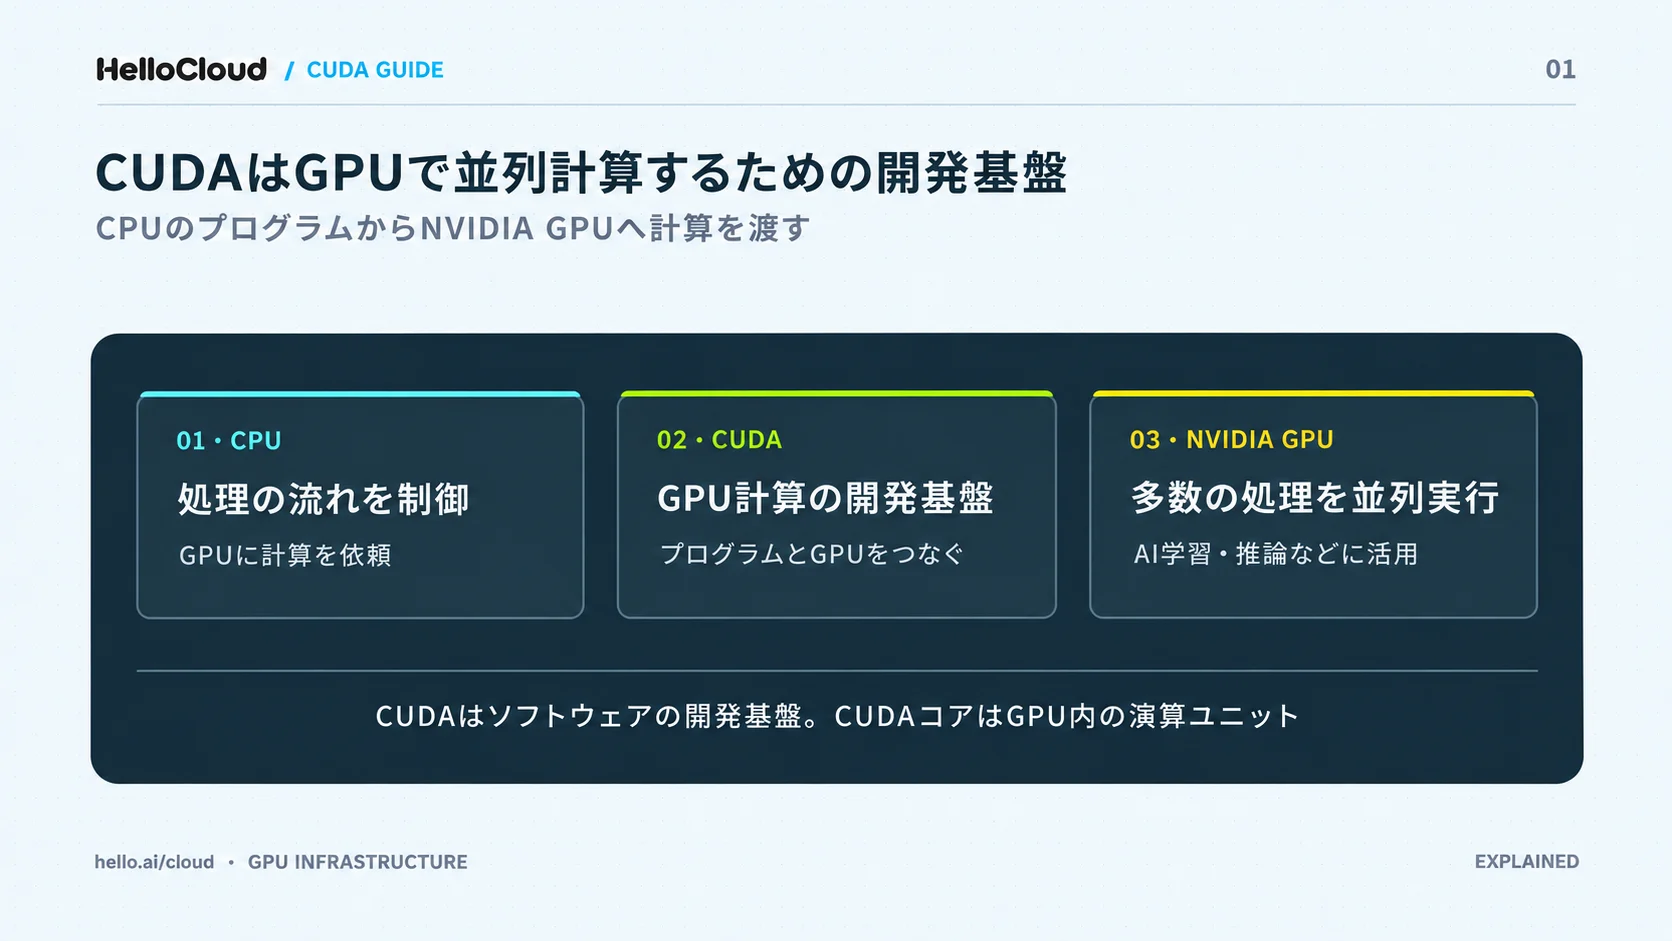
CUDAは、CPUで動くプログラムからGPUへ計算を渡し、GPUの多数の演算ユニットで同時に処理させる仕組みです。NVIDIAのプログラミングガイドは、CPUとGPUの両方を持つシステムが前提です(CUDA Programming Guide、2026年11月確認)。
CUDAの論文によると、CUDAのプログラムでは、順に処理するコードから並列に動く関数(カーネル)を呼び出します。たとえば100万個の数値に同じ足し算をする場合は、1つずつ計算せず、GPUのスレッドに1要素ずつ割り当てて同時に計算させる形です。
2007年にNVIDIAが公開した開発基盤
CUDAは、NVIDIAが2007年に公開した開発基盤です。CUDAの設計者らの2008年の論文に、2007年に公開したと書かれています(CUDAの設計者らの論文、2008年)。
NVIDIAは2018年のプレスリリースで「2006年にCUDA GPUを開発して以来」と述べています(NVIDIAのプレスリリース、2018年8月)。2006年は対応GPUの開発、2007年はソフトウェアの公開と分けると、資料による年の違いで迷いません。
AI開発やスーパーコンピュータでの使われ方
TOP500(2026年6月)では、アクセラレータを使う276システムのうち169が、NVIDIAのHopperかAmpereを使っています。スーパーコンピュータの性能ランキングであるTOP500での内訳は、NVIDIA Hopperが107、NVIDIA Ampereが62です(TOP500、2026年6月)。
NVIDIAの年次報告書によると、NVIDIAのコンピューティングは6,000のアプリケーションに対応しています(CUDAだけの数ではありません)。
AI開発では、PyTorchがCUDAの版ごとにビルドを公開しています(PyTorchの告知(Release 2.12)、2026年4月)。版の選び方は、後半の「PyTorchなどのフレームワークからCUDAを使う場合」で説明します。
開発元のNVIDIAは、2025年3月時点の時価総額が29,450億ドルで、世界のICT企業で2位でした(総務省「令和7年版 情報通信白書」、2025年7月)。
ポイント: CUDAは2007年に公開された、NVIDIAのGPUで並列計算をするための開発基盤です。TOP500(2026年6月)では、アクセラレータを使う276システムのうち169がNVIDIAのHopperかAmpereを使っています。
CUDAの仕組み:GPUアーキテクチャとGPUプログラミング
CUDAでは、GPUをStreaming Multiprocessor(SM)という計算ユニットの集まりとして扱います。処理の割り当ては、スレッド・ブロック・グリッドの3段階です。GPUの機種ごとに中身の配置が違っても、CUDAで書いたプログラムはこの考え方で動きます。
GPUアーキテクチャの基本
CUDAのプログラミングガイドは、GPUをStreaming Multiprocessor(SM)の集まりとして扱います。SMはGPUの中で計算を受け持つ単位で、Graphics Processing Cluster(GPC)というまとまりに分かれています(CUDA Programming Guide、2026年11月確認)。
スレッド・ブロック・グリッドで処理を分ける
CUDAでは、計算をスレッドに分け、スレッドをブロックに、ブロックをグリッドにまとめてGPUに渡します。グリッドの中のブロックは空いているSMに割り振られ、どの順番で実行されてもよい決まりです(CUDA Programming Guide、2026年11月確認)。
ブロックの実行順が決まっていないため、SMの数が違うGPUでも同じプログラムがそのまま動きます。ブロックの中のスレッドを実行する単位は、32個ずつのワープ(warp)というまとまりです(CUDA Programming Guide)。
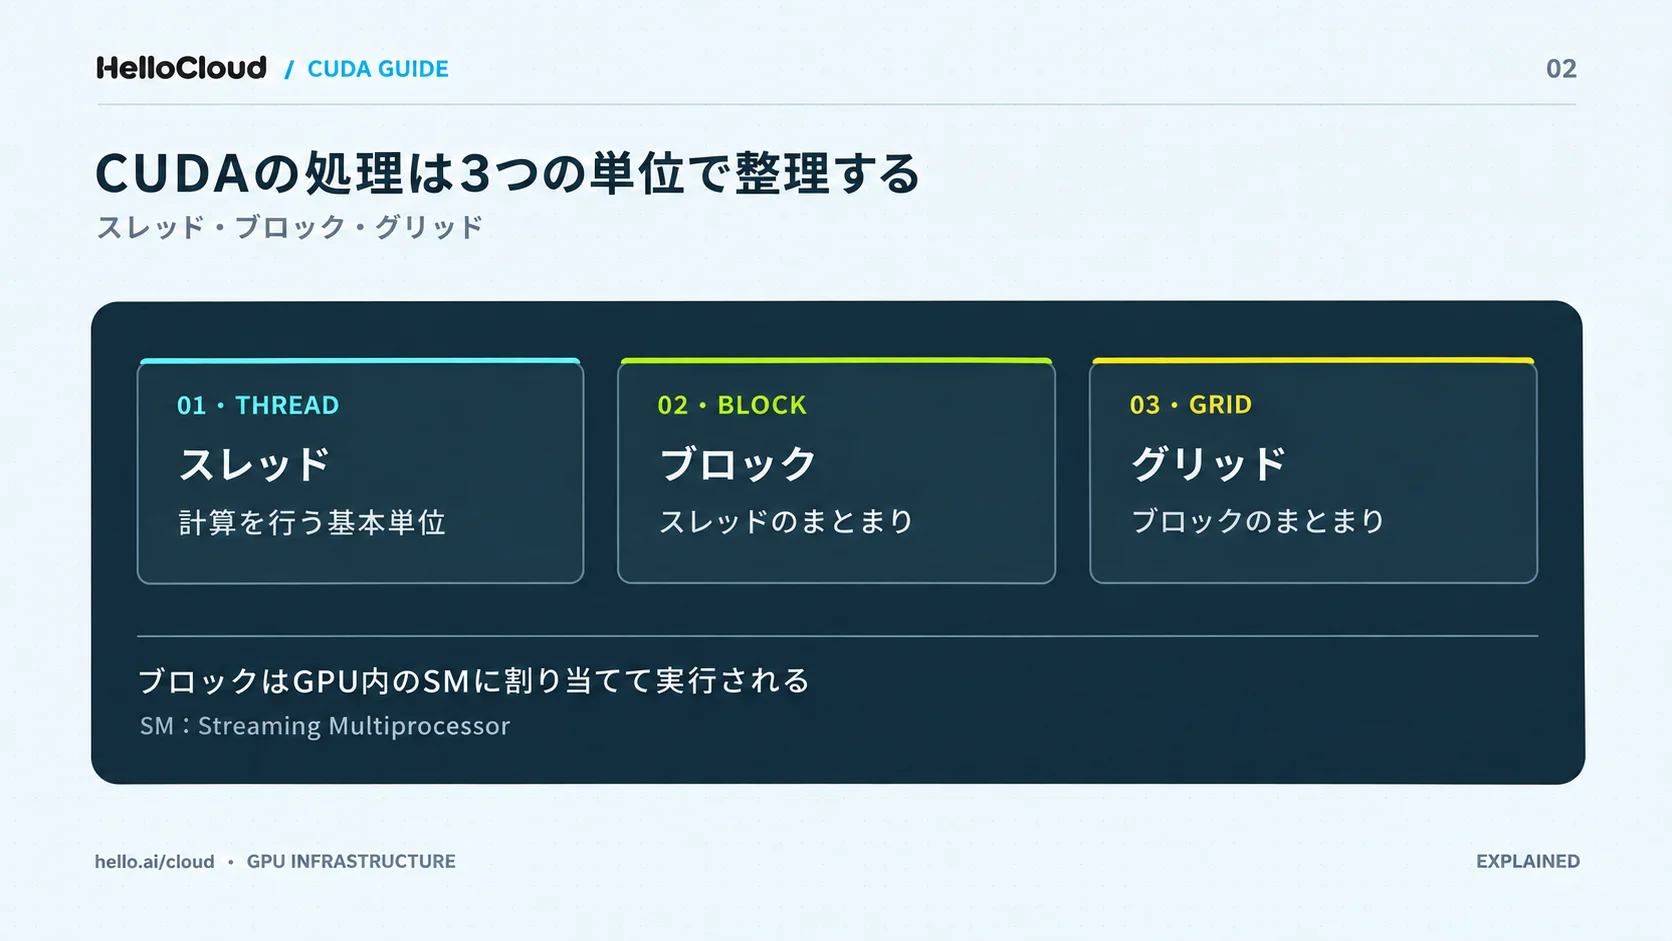
ポイント: CUDAはGPUをSMの集まりとして扱い、計算をスレッド・ブロック・グリッドに分けて割り振る仕組みです。ブロックの実行順は決まっていないため、SMの数が違うGPUでも同じプログラムが動きます。
CUDAコアとは?TensorコアやRTコアとの違い
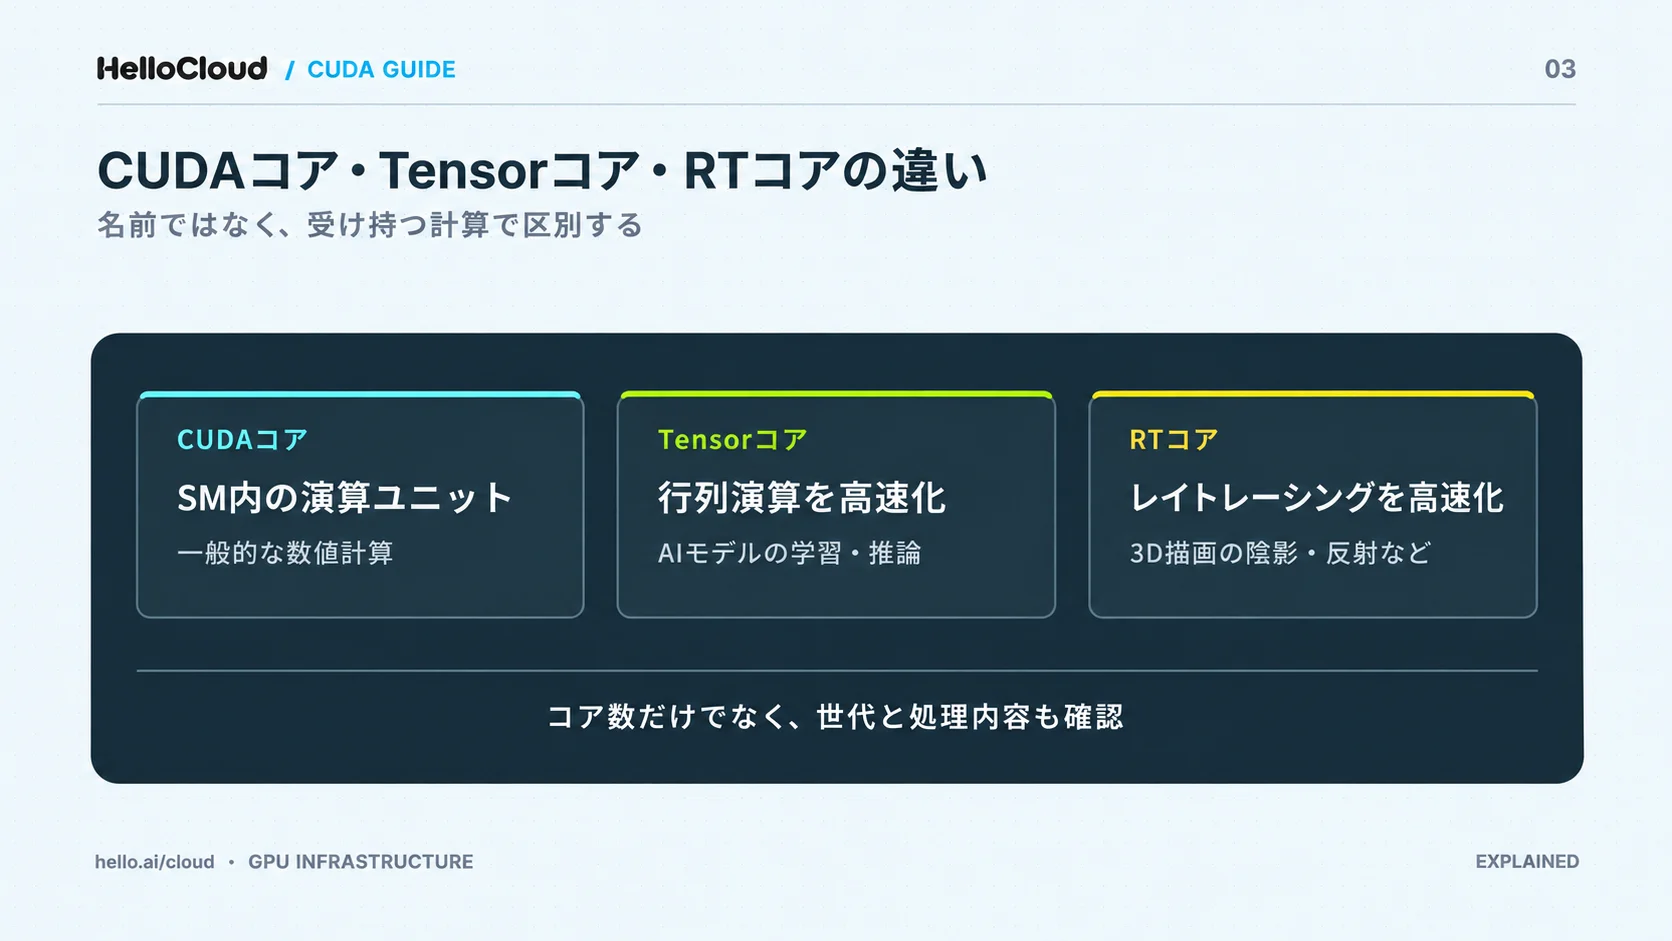
CUDAコアはSMの中にある演算ユニット、TensorコアはAIの計算を速くする専用ユニット、RTコアはレイトレーシング専用のユニットです。GPUの仕様表には、CUDAコア・Tensorコア・RTコアのように名前の似た用語が出てきます。
CUDAコアとは
CUDAコアは、GPUのSMの中にある演算ユニットです。
TensorコアとRTコアの役割
TensorコアはAIの計算を、RTコアはレイトレーシングを、それぞれ専用に受け持つユニットです。NVIDIAは2018年のTuringアーキテクチャで、AIの推論のためのTensorコアと、レイトレーシングを速くするRTコアを初めて同時に搭載しました(NVIDIAのプレスリリース、2018年8月)。
NVIDIAのRTXテクノロジのページによると、第5世代Tensorコアはディープラーニングを速くします。第4世代RTコアは、陰影・反射・屈折を描くレイトレーシングを速くするユニットです(NVIDIA RTX テクノロジ、2026年11月確認)。
3つのコアの比較表
3つのコアは、受け持つ計算の種類で分かれています。
コア | 主な役割 | 主な用途 |
|---|---|---|
CUDAコア | SMの中にある演算ユニット | — |
Tensorコア | AIの計算を速くする専用ユニット | AIモデルの学習・推論 |
RTコア | レイトレーシングを速くする専用ユニット | 陰影・反射・屈折を含む3Dの描画 |
出典:NVIDIA Tensor コア、NVIDIA RTX テクノロジ(確認日 2026-11-17)
ポイント: CUDAコアはSMの中の演算ユニット、TensorコアはAIの計算、RTコアはレイトレーシングを受け持ちます。GPUの仕様表では、CUDAコアの数のほかに、TensorコアやRTコアの世代も見てください。
CUDAを使うのに必要なもの:ドライバとToolkitの違い
CUDAを使うには、NVIDIAのGPU、GPUを動かすドライバ、開発する場合はCUDA Toolkitの3つが必要です。ドライバとCUDA Toolkitは別のソフトウェアで、Toolkitの版ごとにドライバの最低版が決まっています(CUDA Toolkit Release Notes、2026年11月確認)。
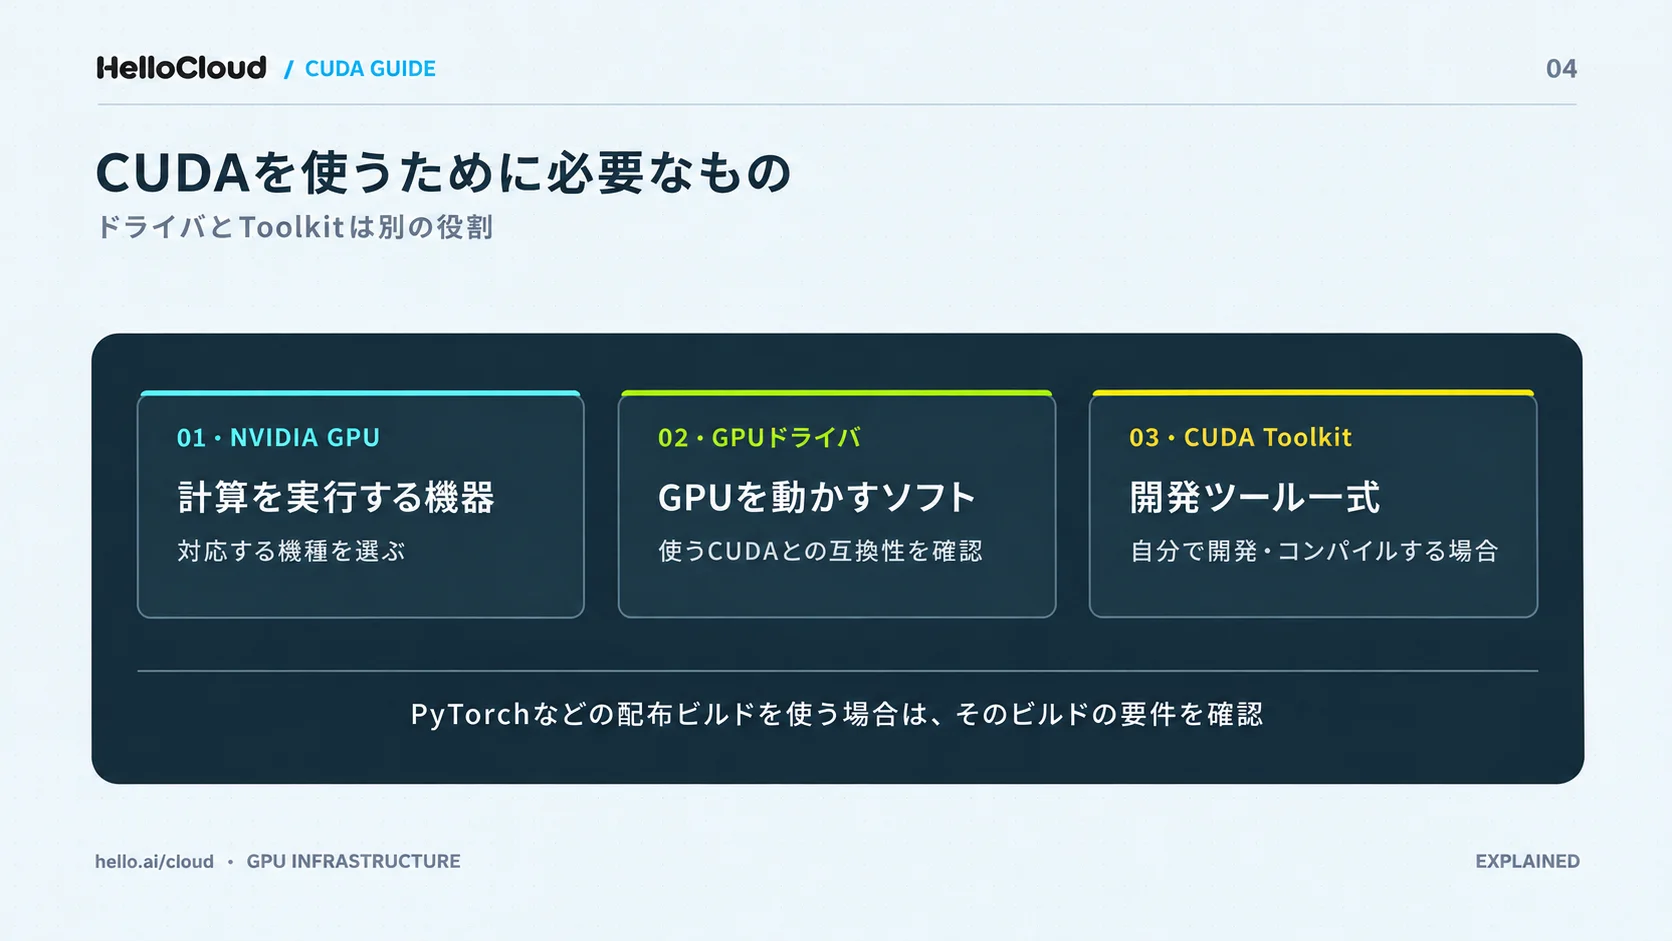
ドライバとCUDA Toolkitの役割の違い
ドライバはGPUを動かすソフトウェアで、CUDA ToolkitはCUDAのプログラムを作る開発ツール一式です。CUDA Toolkitには、GPU向けのライブラリ、デバッグと最適化のツール、C++コンパイラ、ランタイムライブラリが含まれます(NVIDIA CUDA、2026年11月確認)。
CUDA 13.1からは、WindowsのディスプレイドライバがCUDA Toolkitに同梱されなくなりました(CUDA 13.1 Update 2のリリースノート)。
Linuxでも、CUDA 13.4からはドライバがCUDA Toolkitに同梱されていません(CUDA Toolkit Release Notes、2026年11月確認)。
PyTorchなどのフレームワークからCUDAを使う場合
PyTorchでGPUを使うときは、どのCUDAの版に対応したビルドを入れるかを選びます。PyTorch 2.12の告知によると、CUDA 13.0.xのビルドの対象は、CC 7.5、8.0、8.6、9.0、10.0、12.0のGPUです(PyTorchの告知(Release 2.12)、2026年4月)。アーキテクチャでいえば、Turing、Ampere、Hopper、Blackwellにあたります。
CUDAが使えるOSはLinuxとWindows
CUDAが対応するOSは、LinuxとWindowsです(CUDA Toolkit Release Notes、2026年11月確認)。
注意: CUDA 13.1以降をWindowsで、CUDA 13.4以降をLinuxで使う場合は、ドライバをNVIDIAの公式サイトから別に入れてください。
ポイント: ドライバとCUDA Toolkitは別々に用意します。PyTorchでは、GPUのCCがビルドの対応範囲に入っているかも確かめます。
CUDAのバージョンとドライバの対応【2026年11月時点】
2026年11月時点のCUDA Toolkitの最新版は13.5で、NVIDIAは2026年11月4日の開発者ブログで公開を案内しました(NVIDIA開発者ブログ、2026年11月)。
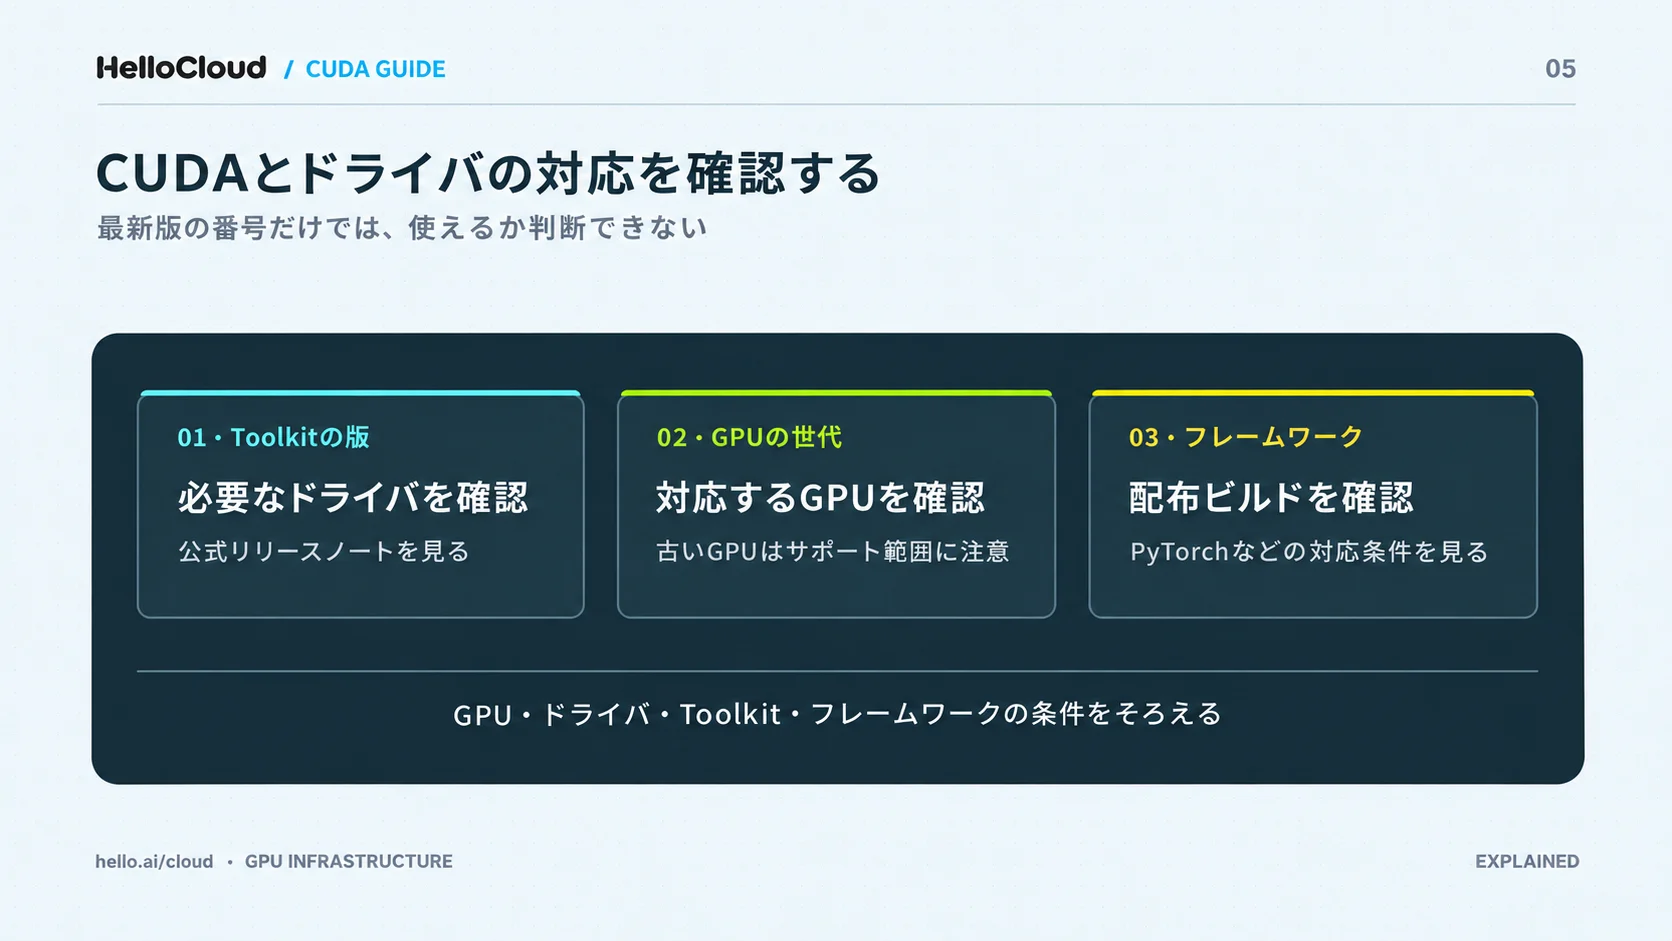
CUDA 13系を使うにはドライバ580以上が必要です(CUDA Toolkit Release Notes、2026年11月確認)。CUDAは13.0で新しいメジャーバージョンに切り替わり、古いGPUの扱いも変わりました。
最新版13.5とドライバの対応表
CUDA 13系の各版には、対応するドライバのブランチが決まっています。13.0から13.4までの対応は次のとおりです。
CUDA Toolkit | 対応するドライバのブランチ |
|---|---|
13.4 | R615 |
13.3 | R610 |
13.2 | R595 |
13.1 | R590 |
13.0 | R580 |
出典:CUDA Toolkit Release Notes(確認日 2026-11-17)
最新の13.5に対応するドライバのブランチは、13.5のリリースノートで確認してください。
CUDA 12と13の違い:必要なドライバ版とABI互換
CUDA 12系と13系の違いは、必要なドライバ版と、ビルドできるGPUの範囲です。CUDAは同じメジャー系列の中でABI(プログラム同士をつなぐ約束ごと)の安定性を保証しており、13系はR580以降のドライバとABI互換です(CUDA 13.0のリリースノート、2025年8月)。
ドライバ版が525以上580未満なら12系、580以上なら13系を選べます。ドライバ版ごとの範囲は、後半の「ドライバ版から使えるCUDAの版を判断する」の表にまとめています。
注意点:CC 7.5未満のGPUはCUDA 13でビルド不可
Compute Capability(CC)7.5未満のGPU向けのプログラムは、CUDA 13ではビルドできません。Maxwell、Pascal、Volta向けのオフラインコンパイルとライブラリのサポートは、CUDA Toolkit 13.0で削除されました(CUDA Features Archive、2026年11月確認)。
対象はCC 5.x、6.x、7.0、7.2のGPUです。NVIDIAの技術ブログによると、GPUが急に動かなくなるわけではありません(NVIDIA Technical Blog、2026年11月確認)。
注意: Maxwell・Pascal・Voltaの古いGPUは、CUDA 12系のToolkitなら引き続きビルドできます。ただしPyTorchは、2.15からCUDA 12.6のwheelを公開しないと告知しています(PyTorchの告知、2026年9月)。
ポイント: 2026年11月時点の最新版は13.5で、13系の動作にはドライバ580以上が必要です。CC 7.5未満のGPUでは12系のToolkitを選びます。
CUDA対応GPUとCompute Capabilityの確認方法
CUDAに対応しているかは、NVIDIAが公開するCompute Capability(CC)の一覧で確認できます。CC 7.5以上なら、CUDA 13でのビルドが可能です。クラウドでGPUを借りるときも、機種名からCCを調べると、使えるCUDAの版を絞り込めます。
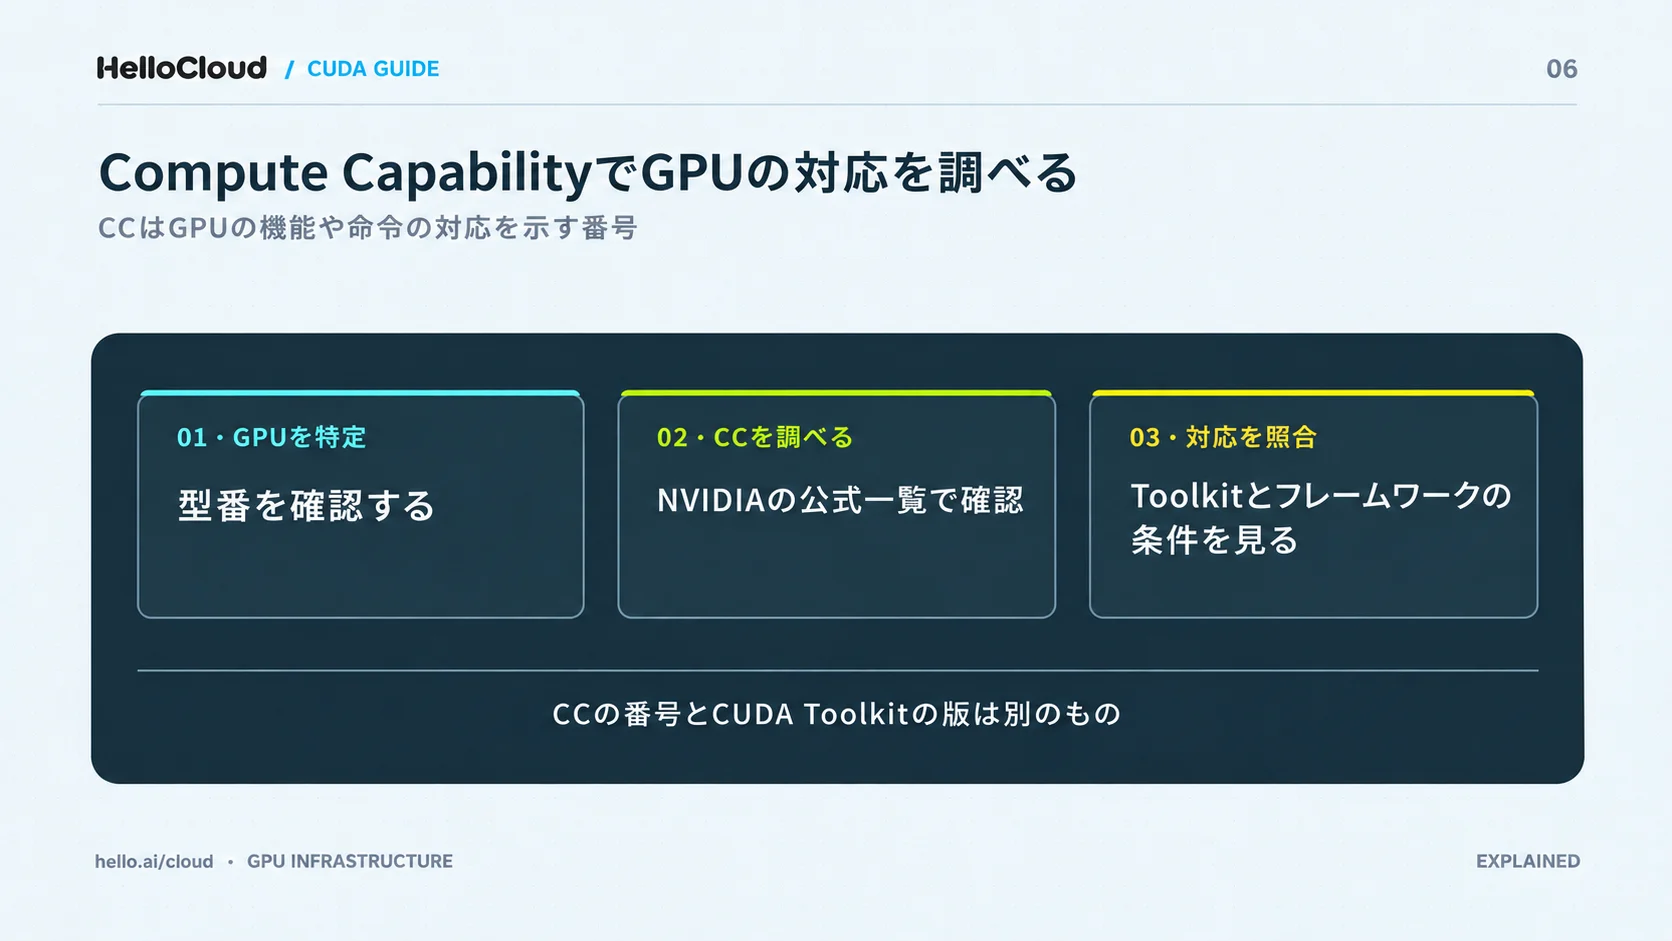
Compute Capability(CC)とは
Compute Capability(CC)は、NVIDIAのGPUアーキテクチャごとに、使えるハードウェア機能と命令を定めた番号です(CUDA GPUs - Compute Capability、2026年10月)。たとえばH100のCCは9.0、T4のCCは7.5で、CUDA 13系はCC 7.5以上を対象にしています。
代表的なGPUのCC一覧
表に挙げた9機種は、T4(CC 7.5)からRTX 5090(CC 12.0)まで、すべてCUDA 13でビルドできます。
GPU | Compute Capability | CUDA 13でのビルド |
|---|---|---|
B200 | 10.0 | 可 |
H200 | 9.0 | 可 |
H100 | 9.0 | 可 |
A100 | 8.0 | 可 |
L40S | 8.9 | 可 |
L4 | 8.9 | 可 |
RTX 5090 | 12.0 | 可 |
RTX 4090 | 8.9 | 可 |
T4 | 7.5 | 可 |
出典:CUDA GPUs - Compute Capability、CUDA Features Archive、NVIDIA Technical Blog(確認日 2026-11-17)
T4のCC 7.5は、CUDA 13でビルドできる範囲の下限です。一覧にないGPUは、NVIDIAのページで機種名から確認できます。
ポイント: CUDAに対応しているかは、NVIDIAのCompute Capabilityの一覧で確認します。CCが7.5以上ならCUDA 13系、7.5未満なら12系が候補です。
クラウドGPUでCUDAを使うときの確認手順
クラウドのGPUインスタンスでCUDAが使えるかは、①GPUのCC、②ドライバ版、③使うCUDAの版の3点を順に確認すれば判断できます。クラウドではGPUの機種を選んで借りるため、機種名からCCを先に調べられます。
ドライバとCUDAの版が合わないと、プログラムやPyTorchからGPUを使えません。
GPUクラウドの仕組みや使い方は、GPUクラウドの仕組みと使い方の解説で説明しています。
確認の順番:GPUのCC→ドライバ版→CUDAの版
クラウドGPUでCUDAを使う前の確認は、GPUのCC、ドライバ版、CUDAの版の順に進めます。
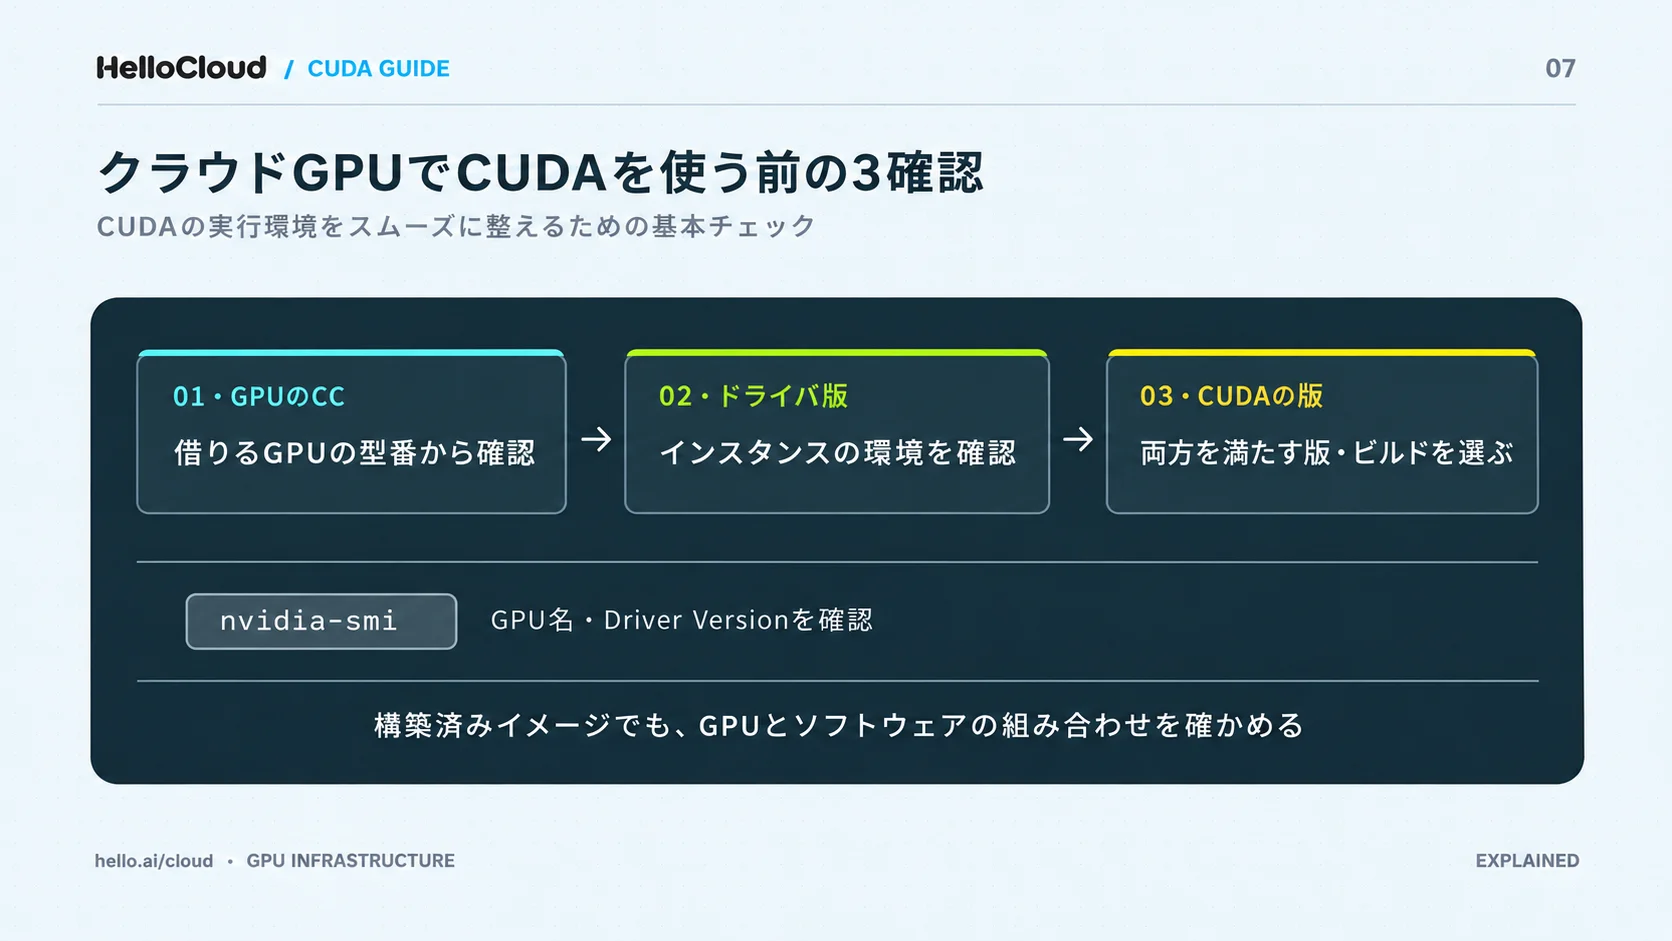
GPUのCCを調べる:GPUの機種名から、NVIDIAの一覧でCCを確認します。CC 7.5以上ならCUDA 13系、7.5未満なら12系が候補です。
ドライバ版を確認する:インスタンスのNVIDIAドライバの版を確認します。580以上なら13系、525以上580未満なら12系が使える範囲です。
使うCUDAの版を決める:1と2の両方を満たす版を選び、PyTorchなどはその版に合うビルドを入れます。
GPUのCCは、NVIDIAドライバに付属するnvidia-smiでも確認できます(CUDA Programming Guide、v13.5、2026年11月確認)。GPUの名前とCCを表示するコマンドは、次のとおりです。
nvidia-smi --query-gpu=name,compute_cap --format=csv
--format=csv は、nvidia-smiのドキュメントで必須と定められた指定です(nvidia-smi documentation、2026年11月確認)。
Linuxでの確認コマンド(CUDA 13.4のガイド)
CUDA 13.4のLinux向けインストールガイドでは、インストール前にGPU、ディストリビューション、gccを確認する手順が示されています(CUDA Installation Guide for Linux、v13.4、2026年11月確認)。
2026年11月時点で、CUDA Toolkitの最新版は13.5(NVIDIA開発者ブログ、2026年11月)、Linux向けインストールガイドは13.4です。
GPUを確認する:NVIDIAのGPUが認識されているかを見るコマンドです。
lspci | grep -i nvidia
ディストリビューションを確認する:Linuxのディストリビューションと版を確かめます。
hostnamectl
gccを確認する:gccが入っているかを確認するコマンドです。
gcc --version
PATHを追加する:CUDA Toolkitを入れた後、CUDA 13.4のコマンドの場所をPATHに加えます。
export PATH=${PATH}:/usr/local/cuda-13.4/bin
動作を確かめる:CUDA SamplesのdeviceQueryとbandwidthTestを実行します。
GPUに負荷をかけて安定して動くかまで確かめる場合は、目的別のGPUテストの方法を参考にしてください。
ドライバ版から使えるCUDAの版を判断する
インスタンスのドライバ版が580以上ならCUDA 13系、525以上580未満ならCUDA 12系を使えます。
CUDA Toolkit | 最低のドライバ版 | 上限 |
|---|---|---|
13.x | 580以上 | なし |
12.x | 525以上 | 580未満 |
11.x | 450以上 | 525未満 |
出典:CUDA Toolkit Release Notes(確認日 2026-11-17)
ドライバを入れ替えられるかどうかは、クラウド事業者の利用条件で確かめてください。
ドライバやCUDAが入った構築済みイメージから始める方法は、GPUクラウドの環境構築を簡単に進める方法で比べています。
国内でGPUクラウドを使う選択肢が広がった背景
経済産業省は2024年4月、AIの開発に必要な計算資源の整備に、5件合計で最大725億円を助成すると決めました(経済産業省のニュースリリース、2024年4月)。同じ発表によると、基盤的なクラウドサービスの国内市場で、国内に事業基盤を持つ事業者のシェアは約3割です。
認定一覧には、GMOインターネットグループ、さくらインターネット、KDDI、ハイレゾ・ハイレゾ香川などが載っています(経済産業省の認定一覧)。
ポイント: クラウドGPUで確認する順番は、GPUのCC、ドライバ版、CUDAの版です。コマンドは、NVIDIAの公式ガイドの版(2026年11月時点でLinux向けは13.4)を確かめて使います。
HelloCloudでGPU環境をクラウドに用意する場合
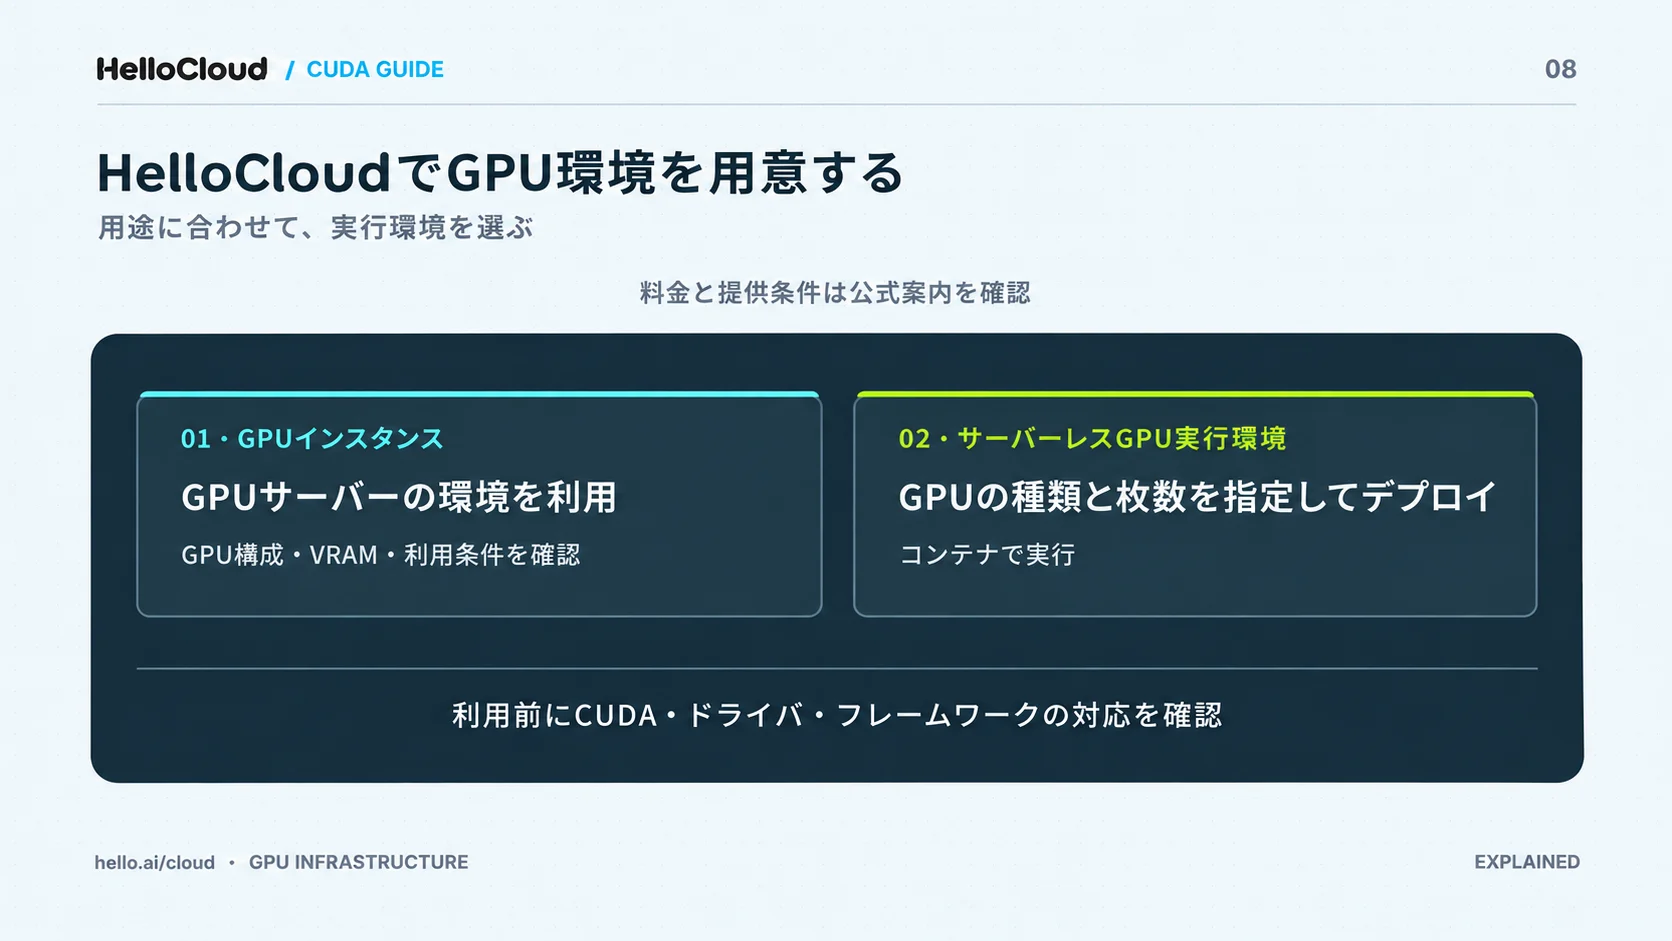
HelloCloudは、東京の2拠点でGPUインスタンスとサーバーレスGPU実行環境を提供する国内のGPUクラウドです(2026年11月5日確認)。GPUは従量課金で、申し込みの当日から使えます。
GPUインスタンスとサーバーレスGPU実行環境
HelloCloudの公式サイトに掲載されているGPUインスタンスは、RTX 6000とB300です。
GPU | VRAM | RAM | vCPU | 参考価格(1時間) |
|---|---|---|---|---|
RTX 6000 | 96GB | 96GB | 16 | ¥380 |
B300 | 288GB | 384GB | 24 | ¥1,480 |
出典:HelloCloud公式サイト(確認日 2026-11-05)。1インスタンスあたりの参考価格で、税込・税別の記載はありません。
サーバーレスGPU実行環境は、GPUの種類と枚数をコードに書いてデプロイすると、指定したGPUでコンテナが起動する仕組みで、サーバーの用意は不要です。詳しい条件は資料請求で確認できます。
導入事例:株式会社ラス恋・Aimy株式会社
公式サイトでは、2社の導入事例が紹介されています。
株式会社ラス恋(CEO 山口様):「会員の個人情報を扱うため、推論も国外のサーバーに出せないのが前提でした。処理まで国内に閉じられる点が決め手で、申し込んだ日のうちに検証を始められました。レコメンドのモデルも、調達を待たずに本番へ載せられています。」
Aimy株式会社(CEO 平野様):「AIキャラクターとの対話は、推論を止められないサービスです。国内のGPUで推論を常時動かしながら、同じ環境でモデルの学習まで進められるのが助かっています。」
出典:HelloCloud公式サイト(確認日 2026-11-17)
ポイント: HelloCloudのGPUインスタンスとサーバーレスGPU実行環境は、どちらも東京の2拠点で動き、従量課金で使えます。
CUDAを使う環境を国内で用意したい方へ
HelloCloudの特徴と料金、導入の進め方がわかる資料を配布しています。お申し込みの当日からGPUを使えます。
資料請求(HelloCloudの特徴と料金)
CUDAについてよくある質問
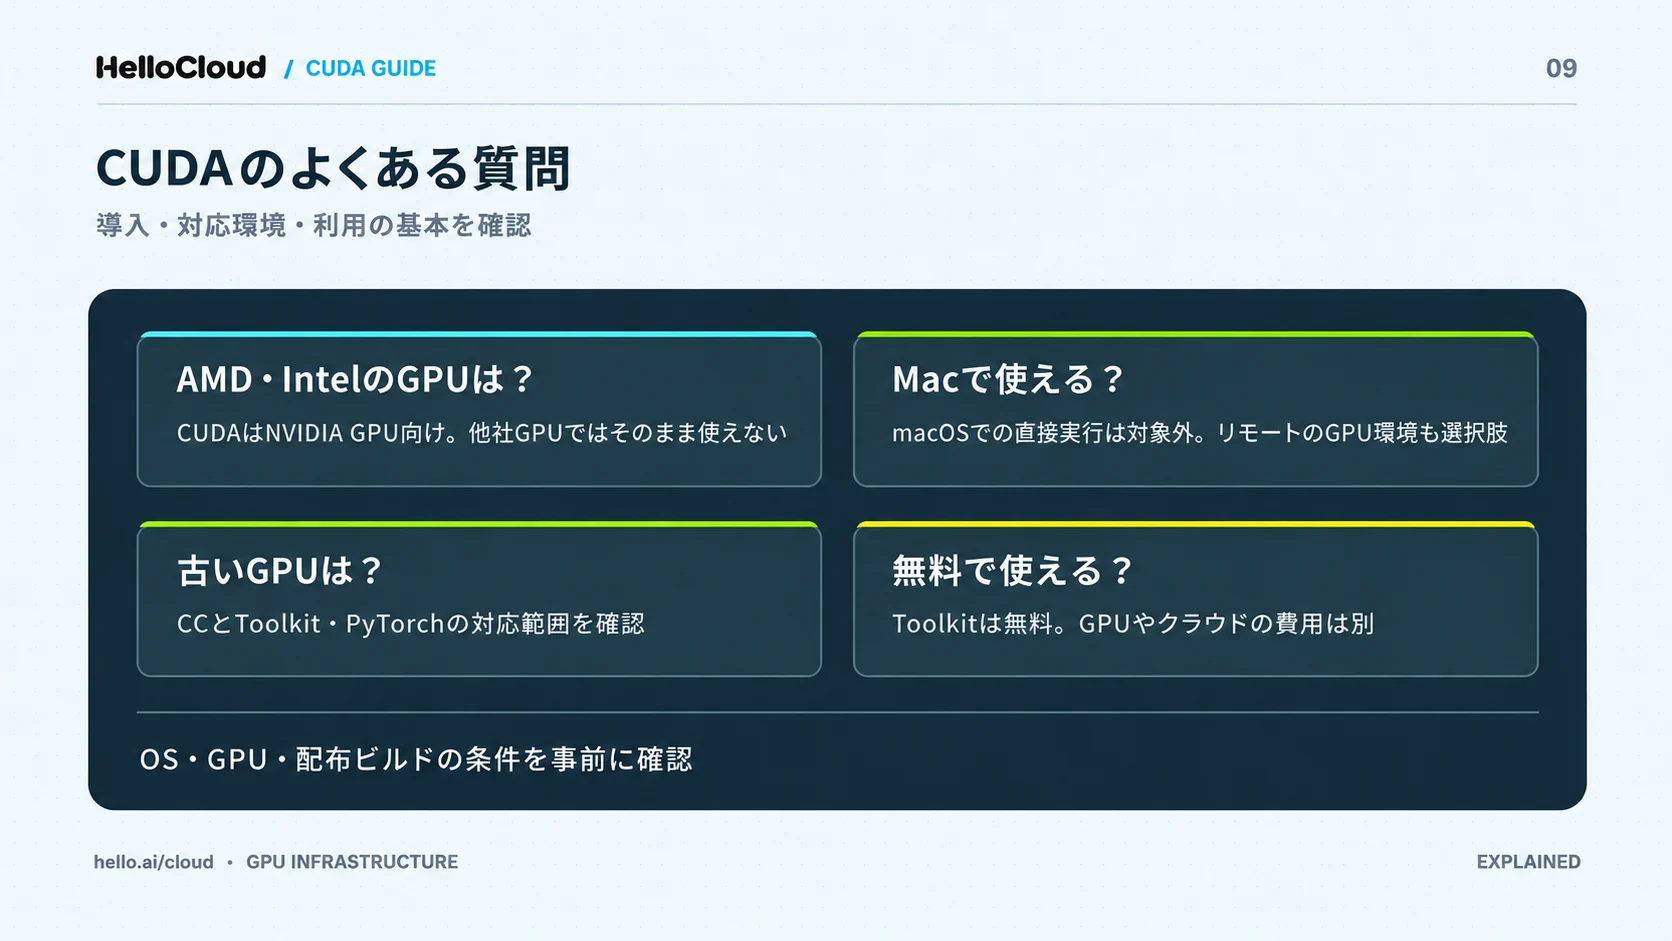
CUDAはNVIDIA以外のGPUではそのままでは使えず、macOSにも対応していません。CUDA Toolkit自体は無料です(2026年11月時点の公式資料で確認)。
CUDAはAMDやIntelのGPUで使えますか?
AMDやIntelのGPUでは、CUDAはそのままでは使えません。CUDAはNVIDIAのGPU向けで、対応するGPUはNVIDIAのCUDA対応GPUの一覧で確認できます(CUDA GPUs)。
AMDは、CUDAに近い書き方でAMDのGPU向けに書けるHIPを提供しています(HIP documentation)。
CUDAはMacで使えますか?
CUDAはmacOSに対応していません。CUDAのリリースノートが示す対応プラットフォームは、LinuxとWindowsです(CUDA Toolkit Release Notes)。Macからは、LinuxのGPUインスタンスに接続すれば使えます。
古いGPUで最新のPyTorchは使えますか?
PyTorch 2.15以降の公式ビルドは、Maxwell・Pascal・VoltaのGPUに対応しません。PyTorchは、2.15からCUDA 12.6のwheelを公開しないと告知しています(PyTorchの告知、2026年9月)。これらのGPUで使い続ける場合は、PyTorch 2.14以前を使うか、CUDA 12系のToolkitでソースからビルドします。
CUDAは無料で使えますか?
CUDA Toolkitは無料で入手できます(NVIDIA Get Started with CUDA)。GPUの購入費やクラウドの利用料は別にかかります。
ポイント: CUDAはNVIDIAのGPU向けで、CUDA Toolkitは無料です。GPUの費用は別にかかります。
まとめ:CUDAを使う前に確認する3つのこと
CUDAはNVIDIAのGPUで並列計算をするための開発基盤で、2026年11月時点の最新版は13.5です。使う前に次の3つを確認します。
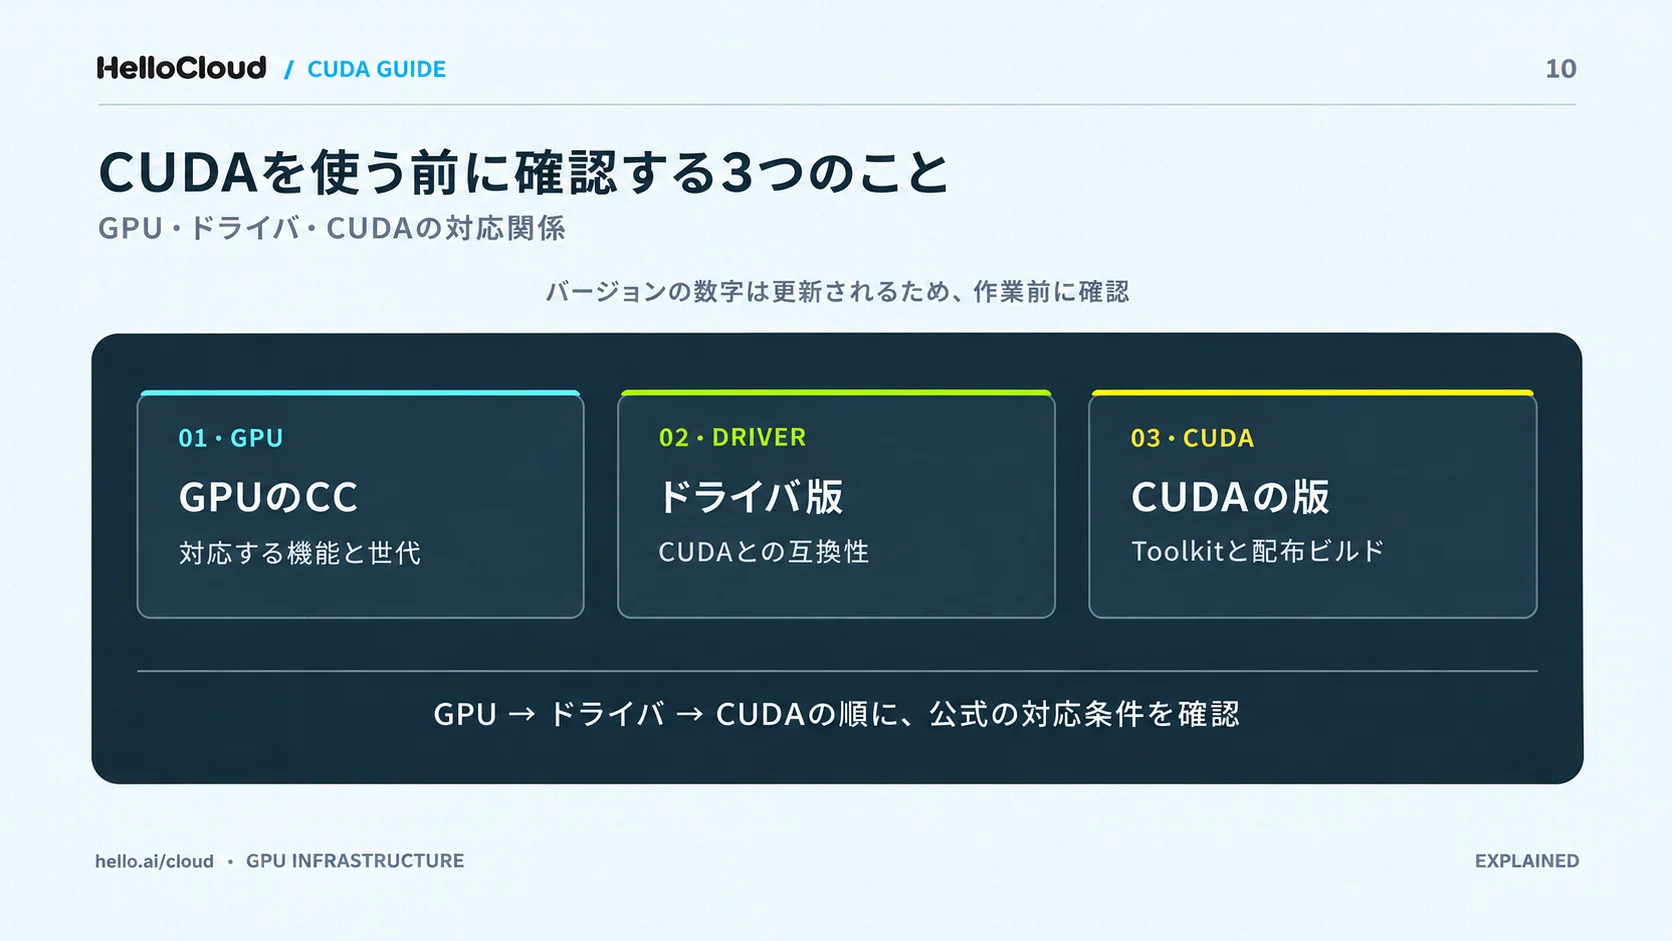
GPUのCCを確認する:CC 7.5以上ならCUDA 13系を選べます。
ドライバ版を確認する:580以上なら13系、525以上580未満なら12系です。
使うCUDAの版を決める:両方を満たす版と、それに合うPyTorchのビルドを選びます。
ポイント: 版の数字は更新されるため、作業の前にNVIDIAのリリースノートで最新の対応を確かめてください。
CUDAを使えるGPU環境を、クラウドで用意したい方へ
HelloCloudの特徴と料金、導入の進め方、LLM推論・モデル学習での活用方法がわかる資料を配布しています。東京の2拠点で、GPUインスタンスとサーバーレスGPU実行環境を提供しています。
資料請求(HelloCloudの特徴と料金)
参考文献
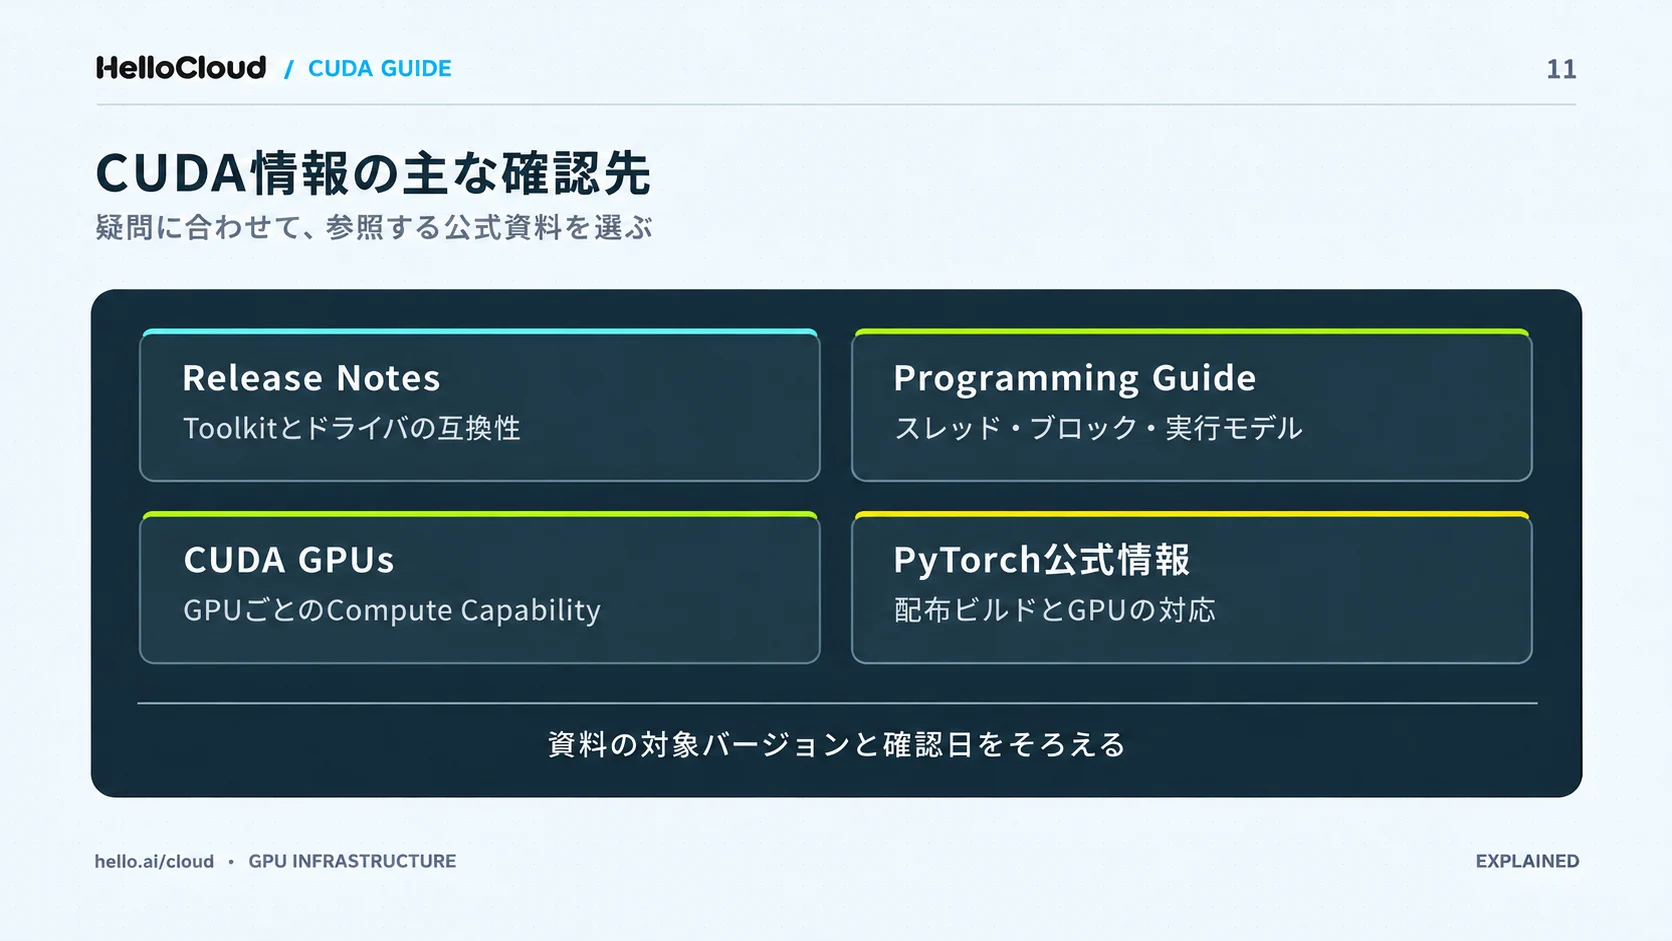
NVIDIA「CUDA Toolkit Release Notes」/発表年月の記載なし(2026-11-17確認)/https://docs.nvidia.com/cuda/cuda-toolkit-release-notes/
NVIDIA「CUDA Toolkit 13.0 Release Notes」/2025年8月(最終更新 2025-08-08)/https://docs.nvidia.com/cuda/archive/13.0.0/cuda-toolkit-release-notes/
NVIDIA「CUDA Toolkit 13.1 Update 2 Release Notes」/発表年月の記載なし(2026-11-17確認)/https://docs.nvidia.com/cuda/archive/13.1.2/cuda-toolkit-release-notes/index.html
NVIDIA「CUDA Features Archive」(13.4.3)/発表年月の記載なし(2026-11-17確認)/https://docs.nvidia.com/cuda/archive/13.4.3/cuda-features-archive/index.html
NVIDIA「CUDA Installation Guide for Linux」(v13.4)/発表年月の記載なし(2026-11-17確認)/https://docs.nvidia.com/cuda/cuda-installation-guide-linux/
NVIDIA「CUDA Programming Guide: Programming Model」/発表年月の記載なし(2026-11-17確認)/https://docs.nvidia.com/cuda/cuda-programming-guide/01-introduction/programming-model.html
NVIDIA「CUDA Programming Guide: Compute Capabilities」(v13.5)/発表年月の記載なし(2026-11-17確認)/https://docs.nvidia.com/cuda/cuda-programming-guide/05-appendices/compute-capabilities.html
NVIDIA「nvidia-smi documentation」/発表年月の記載なし(2026-11-17確認)/https://docs.nvidia.com/deploy/nvidia-smi/index.html
NVIDIA「CUDA GPUs - Compute Capability」/2026年10月(ページの公開日 2026-10-16)/https://developer.nvidia.com/cuda-gpus
NVIDIA「NVIDIA CUDA」/発表年月の記載なし(2026-11-17確認)/https://developer.nvidia.com/cuda
NVIDIA「Get Started with CUDA」/発表年月の記載なし(2026-11-17確認)/https://developer.nvidia.com/cuda/get-started-cuda-cc
NVIDIA Technical Blog「NVIDIA CUDA 13.5 Brings NVIDIA Vera Rubin GA Support」/2026年11月/https://developer.nvidia.com/blog/?p=124464
NVIDIA「NVIDIA Tensor コア」/発表年月の記載なし(2026-11-17確認)/https://www.nvidia.com/ja-jp/data-center/tensorcore/
NVIDIA Technical Blog「Navigating GPU Architecture Support: A Guide for NVIDIA CUDA Developers」/2025年8月/https://developer.nvidia.com/blog/navigating-gpu-architecture-support-a-guide-for-nvidia-cuda-developers
NVIDIA「NVIDIA RTX テクノロジ」/発表年月の記載なし(2026-11-17確認)/https://www.nvidia.com/ja-jp/design-visualization/technologies/rtx/
NVIDIA「NVIDIA の Turing アーキテクチャ、コンピューター グラフィックスを再創造」/2018年8月/https://www.nvidia.com/ja-jp/about-nvidia/press-releases/2018/reinvents-computer-graphics-turing-architecture-20180816/
NVIDIA Corporation「Form 10-K(2026年1月25日に終わる会計年度)」/2026年2月/https://www.sec.gov/Archives/edgar/data/1045810/000104581026000021/nvda-20260125.htm
John Nickolls, Ian Buck, Michael Garland, Kevin Skadron「Scalable Parallel Programming with CUDA」ACM Queue 6(2)/2008年/https://queue.acm.org/detail.cfm?id=1365500
TOP500「Highlights - June 2026」/2026年6月/https://www.top500.org/lists/top500/2026/06/highs
PyTorch「Introducing CUDA 13.2 and Deprecating CUDA 12.8 (Release 2.12)」/2026年4月/https://dev-discuss.pytorch.org/t/introducing-cuda-13-2-and-deprecating-cuda-12-8-release-2-12/3337
PyTorch「Notice: CUDA 12.6 wheels will no longer be published from PyTorch 2.15」/2026年9月/https://dev-discuss.pytorch.org/t/notice-cuda-12-6-wheels-will-no-longer-be-published-from-pytorch-2-15-drops-maxwell-pascal-volta/3432
AMD「HIP documentation」/発表年月の記載なし(2026-11-17確認)/https://rocm.docs.amd.com/projects/HIP/en/latest
総務省「令和7年版 情報通信白書」第Ⅱ部第1章第6節/2025年7月/https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/pdf/n2160000.pdf
経済産業省「経済安全保障推進法に基づくクラウドプログラムの安定供給確保に係る供給確保計画の認定等について」/2024年4月/https://www.meti.go.jp/press/2024/04/20240419002/20240419002.html
経済産業省「経済安全保障推進法に基づく認定供給確保計画 一覧」/発表年月の記載なし(2026-11-17確認)/https://www.meti.go.jp/policy/economy/economic_security/nintei.pdf
HelloCloud編集部 国内GPUクラウド「HelloCloud」を提供する株式会社HelloCloudの編集部です。GPUクラウドの仕組みや料金の見方、LLMの推論・学習に使う環境づくり、データの保存先や契約条件の確かめ方を、AI開発に関わるエンジニアや導入を判断する方に向けて解説しています。記事は調査会社や省庁の発表、各社の公式な料金ページ・利用規約などの一次情報をもとに作成し、料金や仕様の変更にあわせて内容を更新しています。


